Kimi Linear: An Expressive, Efficient Attention Architecture
首个在公平比较下超越全注意力的混合线性注意力架构,通过KDA实现75% KV缓存减少和6倍解码吞吐量提升
Kimi Linear: An Expressive, Efficient Attention Architecture
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Kimi Linear: An Expressive, Efficient Attention Architecture |
| 作者 | Kimi Team (Yu Zhang, Zongyu Lin, Xingcheng Yao, Jiaxi Hu, Fanqing Meng, Chengyin Liu, Xin Men, Songlin Yang, Zhiyuan Li, Wentao Li, Enzhe Lu, Weizhou Liu, Yanru Chen, Weixin Xu, Longhui Yu, Yejie Wang, Yu Fan, Longguang Zhong, Enming Yuan, Dehao Zhang, Yizhi Zhang, T.Y. Liu, Haiming Wang, Shengjun Fang, Weiran He, Shaowei Liu, Yiwei Li, Jianlin Su, Jiezhong Qiu, Bo Pang, Junjie Yan, Zhejun Jiang, Weixiao Huang, Bohong Yin, Jiacheng You, Chu Wei, Zhengtao Wang, Chao Hong, Yutian Chen, Guanduo Chen, Yucheng Wang, Huabin Zheng, Feng Wang, Yibo Liu, Mengnan Dong, Zheng Zhang, Siyuan Pan, Wenhao Wu, Yuhao Wu, Longyu Guan, Jiawen Tao, Guohong Fu, Xinran Xu, Yuzhi Wang, Guokun Lai, Yuxin Wu, Xinyu Zhou, Zhilin Yang, Yulun Du) |
| 机构 | Moonshot AI (Kimi Team) |
| 论文 | https://arxiv.org/abs/2510.26692 |
| 代码 | https://github.com/MoonshotAI/Kimi-Linear |
| 发布 | 2025-10-30 (v1), 2025-11-01 (v2) |
| 许可 | CC BY-NC-ND 4.0 |
二、核心思想
问题定义
随着大语言模型(LLM)演变为越来越强大的智能体,推理的计算需求——特别是在长视野和强化学习(RL)设置中——正在成为核心瓶颈。标准注意力机制存在根本性低效:softmax注意力的二次时间复杂度和线性增长的键值(KV)缓存引入了大量计算和内存开销,阻碍了吞吐量、上下文长度扩展和实时交互性。
解决方案概述
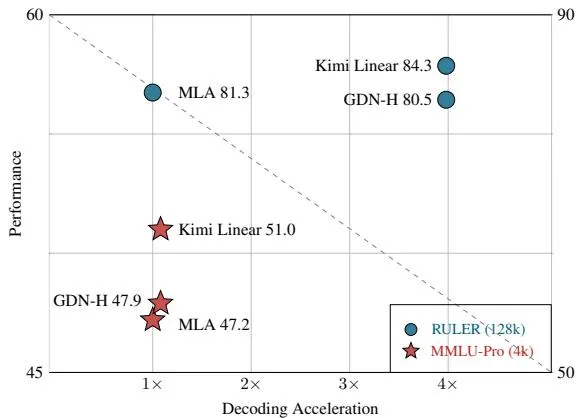
本文提出Kimi Linear,一种混合线性注意力架构,首次在公平比较下超越全注意力——涵盖短上下文、长上下文和强化学习(RL)扩展场景。其核心是Kimi Delta Attention (KDA),一种表达性强的线性注意力模块,扩展了Gated DeltaNet,具有更细粒度的门控机制,能够更有效地利用有限的有限状态RNN内存。
三、技术架构
整体框架图
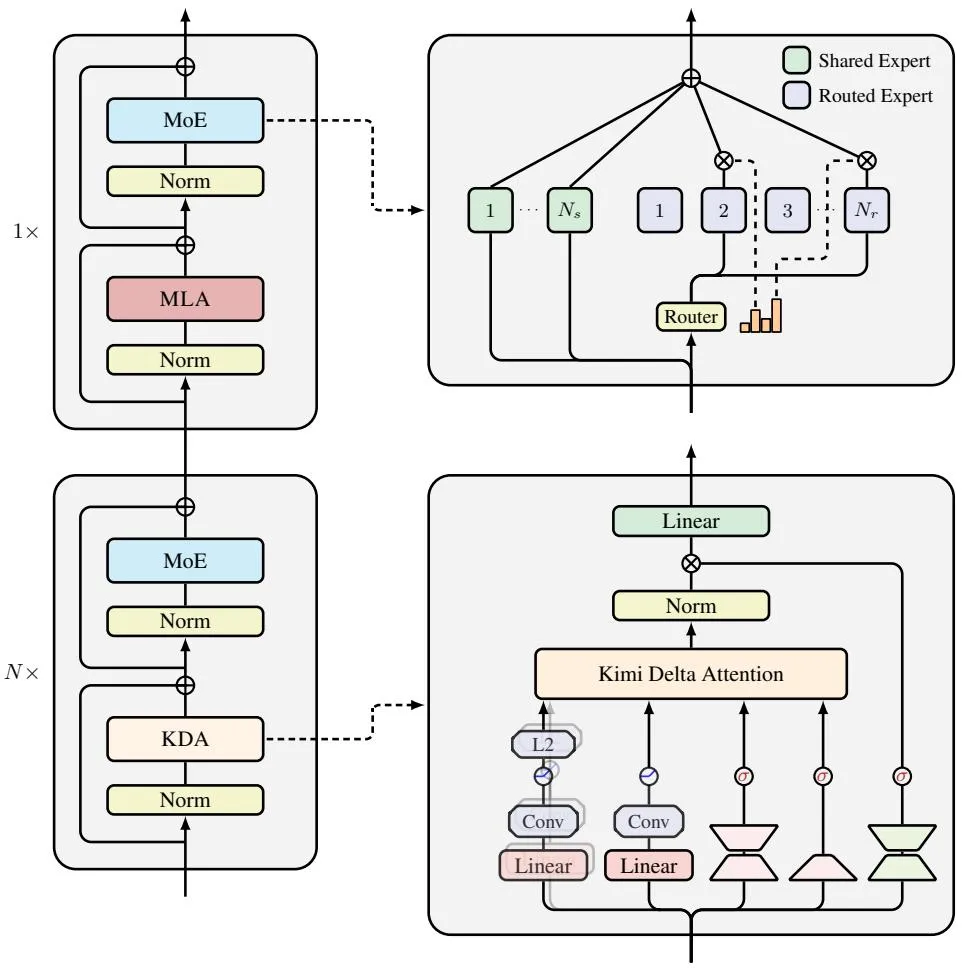
Kimi Linear架构由以下组件组成:
- Kimi Delta Attention (KDA):核心线性注意力模块
- Multi-Head Latent Attention (MLA):全注意力层
- 混合比例:3:1(3层KDA + 1层MLA)
- MoE通道混合:每个token混合层后跟MoE层
核心公式
KDA状态更新(Delta Rule + 细粒度门控):
其中:
- 是矩阵值循环状态
- 是通道级衰减(细粒度门控,区别于GDN的标量门控)
- 是学习率
- 是键值向量
分块并行算法(Chunkwise Algorithm):
其中WY表示将一系列秩-1更新打包为紧凑表示:
UT变换(减少非矩阵乘法FLOPs):
输出计算(块间循环 + 块内并行):
神经参数化:
输出门控:
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| KDA | Kimi Delta Attention,细粒门控线性注意力 | 通道级衰减 α ∈ [0,1]^d_k |
| MLA | Multi-Head Latent Attention,全注意力 | NoPE(无位置编码) |
| ShortConv | 深度可分离卷积,捕获局部token依赖 | 核大小=4 |
| 输出门 | Sigmoid门控,缓解Attention Sink | 低秩参数化 |
| MoE | 混合专家通道混合 | 256专家,激活8个 |
模型配置
- 激活参数:3B
- 总参数:48B(MoE架构)
- 专家数:256(激活8个,含1个共享专家)
- 混合比例:3:1(KDA:MLA)
- 上下文长度:最高1M tokens
- 训练tokens:1.4T(对比实验)/ 5.7T(最终模型)
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 细粒度门控 | 通道级衰减 Diag(α_t) 替代标量门控 | 更精确的内存遗忘控制 |
| DPLR特化 | 绑定a=b=k的特化DPLR变体 | 比通用DPLR减少约50%计算 |
| 3:1混合比例 | 3层KDA + 1层MLA的最佳平衡 | 消融实验验证最优 |
| NoPE for MLA | 全注意力层不使用位置编码 | KDA负责位置信息编码 |
| UT变换 | 减少非矩阵乘法FLOPs | 提高硬件利用率 |
五、实验结果
合成任务
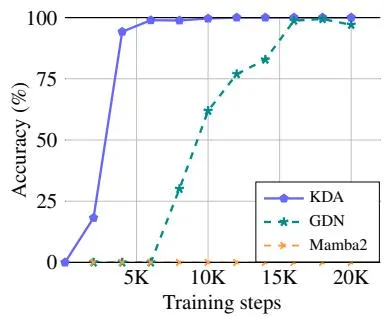
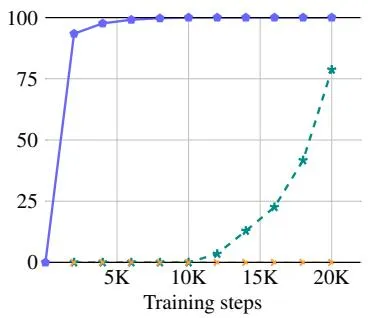
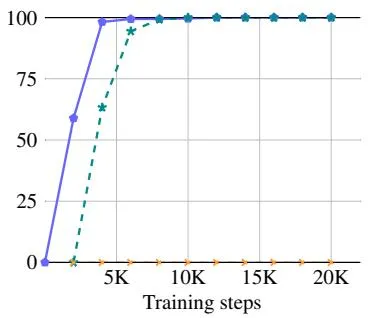
KDA在所有合成任务上表现最佳:
- Palindrome:序列长度2048时仍保持100%准确率(GDN 35%,Mamba2 0%)
- MQAR:收敛速度显著快于GDN
- Stack:状态跟踪能力优于GDN和Mamba2
缩放定律
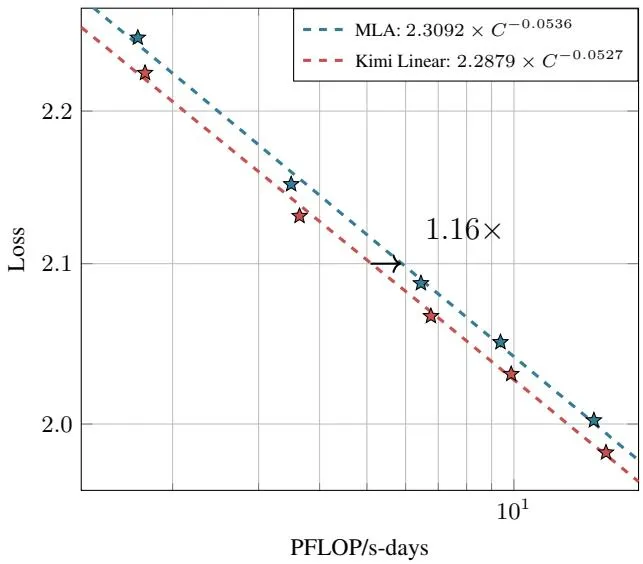
- Kimi Linear相比MLA实现约1.16倍计算效率
- 相同计算预算下,Kimi Linear损失更低
短上下文预训练结果(1.4T tokens)
| 基准 | MLA | GDN-H | Kimi Linear |
|---|---|---|---|
| HellaSwag | 81.7 | 82.2 | 82.9 |
| ARC-challenge | 64.6 | 66.5 | 67.3 |
| MMLU | 71.6 | 72.2 | 73.8 |
| MMLU-Pro | 47.2 | 47.9 | 51.0 |
| BBH | 71.6 | 70.6 | 72.9 |
| GSM8K | 83.7 | 81.7 | 83.9 |
| CEval | 79.3 | 79.1 | 79.5 |
短上下文SFT结果
| 基准 | MLA | GDN-H | Kimi Linear |
|---|---|---|---|
| MMLU | 75.7 | 75.6 | 77.0 |
| MMLU-Pro | 65.7 | 64.8 | 67.4 |
| GPQA-Diamond | 57.1 | 58.6 | 62.1 |
| AIME 2025 | 20.6 | 21.1 | 21.3 |
| HMMT 2025 | 11.3 | 11.3 | 12.5 |
| LiveCodeBench v6 | 25.1 | 25.4 | 26.0 |
长上下文结果(128k context)
| 基准 | MLA | GDN-H | Kimi Linear (RoPE) | Kimi Linear |
|---|---|---|---|---|
| RULER | 81.3 | 80.5 | 78.8 | 84.3 |
| MRCR | 22.6 | 23.9 | 22.0 | 29.6 |
| HELMET-ICL | 88.0 | 85.5 | 88.0 | 90.0 |
| RepoQA | 63.0 | 63.0 | 66.5 | 68.5 |
| Long Code Arena (Lib) | 32.8 | 34.7 | 31.3 | 37.1 |
| 平均 | 52.2 | 51.2 | 51.8 | 54.5 |
RL扩展结果
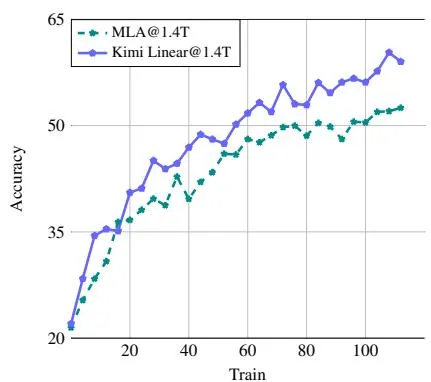
Kimi Linear在Math RL训练中持续优于MLA:
- 训练集准确率增长速度显著快于MLA
- 在MATH500和AIME2025测试集上实现更快更好的提升
效率提升
- KV缓存减少:最多75%
- 解码吞吐量:1M上下文时提升最多6倍
- TPOT:1M tokens时1.84ms vs MLA的11.48ms(6.3倍更快)
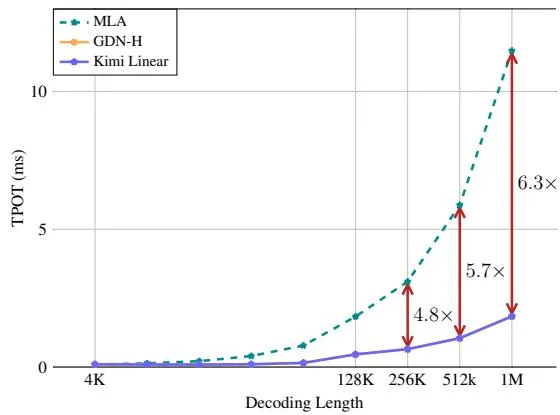
预填充与解码性能
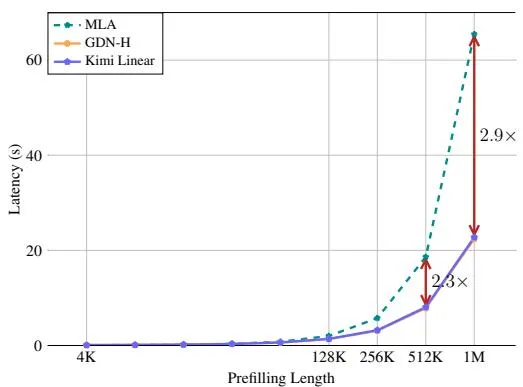
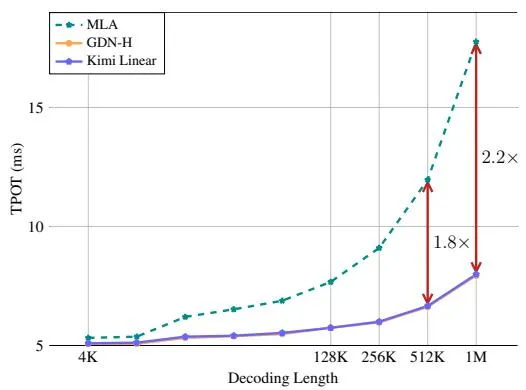
- 预填充:128k序列长度起Kimi Linear显著快于MLA,1M序列快2.9倍
- 解码:1M上下文时Kimi Linear比全注意力快6倍
内核执行时间
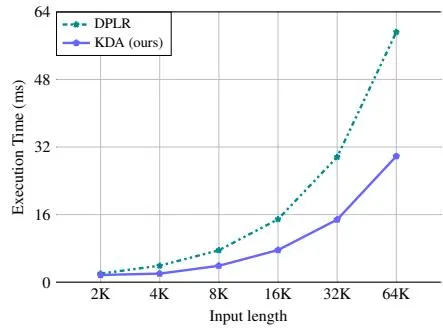
KDA相比通用DPLR显著减少计算:
- 64K输入长度:KDA 32ms vs DPLR 64ms(2倍加速)
六、相关工作
| 方向 | 代表工作 | 与Kimi Linear的关系 |
|---|---|---|
| 线性注意力 | Linear Attention, GLA, Mamba2 | KDA扩展了这些方法 |
| Delta规则 | DeltaNet, GDN | KDA引入细粒度门控 |
| 混合架构 | Jamba, Griffin, RWKV | Kimi Linear采用3:1混合比例 |
| 高效推理 | FlashAttention, PagedAttention | KDA减少KV缓存需求 |
七、总结
核心贡献
- Kimi Delta Attention (KDA):改进delta规则的细粒度门控线性注意力机制
- Kimi Linear架构:3:1 KDA-to-MLA混合设计,减少内存占用同时超越全注意力质量
- 公平实验验证:1.4T token训练,Kimi Linear在短/长上下文和RL评估中均优于全注意力
技术影响
- 效率突破:KV缓存减少75%,解码吞吐量提升6倍
- 质量提升:首次在线性注意力架构中超越全注意力
- 开源贡献:KDA内核、vLLM集成、预训练和指令微调模型检查点
局限性
- 纯线性注意力在极长序列检索上仍有挑战
- 3:1混合比例需要至少25%的全注意力层
- 当前实现基于特定硬件(NVIDIA GPU)
八、参考资源
- 论文:https://arxiv.org/abs/2510.26692
- 代码:https://github.com/MoonshotAI/Kimi-Linear
- 模型:预训练和指令微调检查点已开源