HybridEP: Scaling Expert Parallelism to Cross-Datacenter Scenario
Hybrid Expert/Data Transmission for MoE Training
HybridEP: Scaling Expert Parallelism to Cross-Datacenter Scenario via Hybrid Expert/Data Transmission
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | HybridEP: Scaling Expert Parallelism to Cross-Datacenter Scenario via Hybrid Expert/Data Transmission |
| 作者 | Weihao Yang, Hao Huang, Donglei Wu, Ningke Li, Yanqi Pan, Qiyang Zheng, Wen Xia, Shiyi Li, Qiang Wang |
| 机构 | 南方科技大学、鹏城实验室 |
| 论文 | arXiv:2510.19470 |
| 代码 | 无公开代码 |
| 发布 | 2025-10-22 |
| 许可 | arXiv 非独占分发许可 |
二、核心思想
问题定义
Mixture-of-Experts (MoE) 架构的模型规模快速增长,已超出单数据中心(DC)的训练能力,需要跨数据中心训练。然而,Expert Parallelism (EP) 在跨 DC 场景面临严重的可扩展性问题:
- 带宽受限:跨 DC 带宽远低于 DC 内带宽,EP 的通信开销急剧增加
- 现有优化失效:传统 EP 优化(如计算-通信重叠)在低带宽场景下效果有限,因为数据传输时间远长于计算时间
- 通信模式不匹配:标准 EP 使用 All-to-All (A2A) 通信传输数据,通信量随 token 数线性增长
解决方案概述
HybridEP 提出混合专家/数据传输框架,核心思想是动态转换数据和专家的空间放置,通过将部分 A2A 数据通信转换为 All-Gather (AG) 专家通信,减少通信流量和频率。
关键创新:
- 流式建模:建立数学模型确定最优的数据/专家传输比例
- 域级分区:在 GPU 级别构建混合通信拓扑
- 参数高效迁移:通过 SR 压缩减少专家传输开销,扩大专家域
三、技术架构
整体框架图
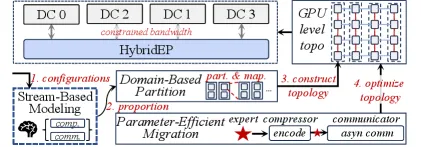
HybridEP 工作流程:
- 环境配置 → 流式建模 → 确定最优传输比例
- 域级分区 → 构建 GPU 级通信拓扑
- 参数高效迁移 → 优化通信拓扑
核心公式
计算延迟建模:
其中 为 MoE 块前的 transformer 块数, 为每个 GPU 上的专家数。
A2A 通信建模:
A2A 通信量与参与 GPU 数几乎无关()。
AG 通信建模:
AG 通信量随 GPU 数线性增长()。
A2A 与 AG 的关系:
当 GPU 通过 AG 从 收集专家 时:
- A2A 流量减少
- AG 流量增加
延迟最小化目标:
其中 为数据通过 A2A 传输的比例, 为转换为专家通过 AG 传输的比例。
最优解:
通信拓扑构建
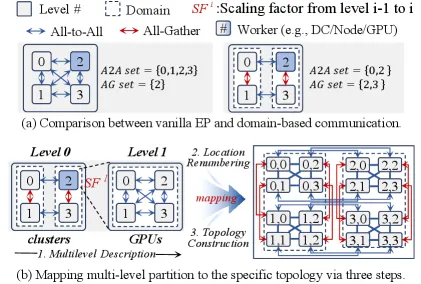
专家域 (Expert Domain):
- 定义:仅使用 AG 通信的 DC 集合
- 域大小 :域内 DC 数量
- 规则:域内 AG,域间 A2A
多级描述 (Multilevel Description):
- Worker:物理实体(DC、节点、GPU)
- Level:同构带宽连接的 Worker 集合
- 缩放因子 :level 的 Worker 扩展为 level 的子 Worker 数
位置重编号:
将全局 GPU 索引 映射到多级位置。
参数高效迁移
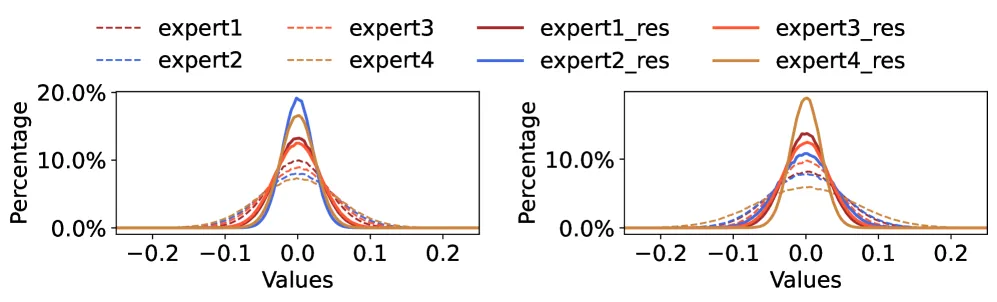
SR-Based 专家压缩:
- 共享专家:所有专家的平均值,全 GPU 共享
- 残差专家:目标专家 - 共享专家,稀疏且可压缩
- 编码:Top-k 压缩残差 → value-index 格式传输
- 解码:恢复残差 + 共享专家 → 目标专家
异步通信器:
- 初始化阶段:SREncode + 融合上次迭代参数更新
- 异步通信阶段:Send Queue/Recv Queue + 与 pre-expert 计算重叠
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 流式建模 | 确定最优数据/专家传输比例 | |
| 域级分区 | GPU 级通信拓扑构建 | (各级域大小) |
| SR 压缩 | 专家残差 Top-k 压缩 | CR=50x 压缩比 |
| 异步通信器 | 两阶段流水线 | Send/Recv Queue |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 混合传输范式 | 动态转换 A2A 数据通信为 AG 专家通信 | 流式建模确定最优比例 |
| 域级分区 | 多级层次化通信拓扑,GPU 级别精确控制 | 位置重编号 + 拓扑构建算法 |
| SR 专家压缩 | 共享专家 + 残差 Top-k,50x 压缩比 | 专家间冗余性分析 |
| 异步通信器 | SREncode/SRDecode 融合计算,减少开销 | 30%/45% 开销降低 |
| 通用 EP 框架 | 标准 EP 是 HybridEP 的特例 () | 理论证明 + 实验验证 |
五、代码实现分析
- 实现基础: 基于 Tutel 和 PyTorch v1.12.1
- 环境: Ubuntu 18.04, CUDA 11.3, cuDNN 7.6, NCCL 2.10
- 无公开代码: 论文未提供开源实现
六、实验结果
实验环境
| 集群 | GPU 数 | DC 数 | DC 内带宽 | DC 间带宽 |
|---|---|---|---|---|
| Cluster-S | 8× A800 | 1 | PCIe 3.0 x16 (128 Gbps) | - |
| Cluster-M | 16× A800 | 2 | PCIe 3.0 x16 (128 Gbps) | Ethernet (10 Gbps) |
| Cluster-L | 32× A800 | 4 | PCIe 3.0 x16 (128 Gbps) | Ethernet (10 Gbps) |
建模验证
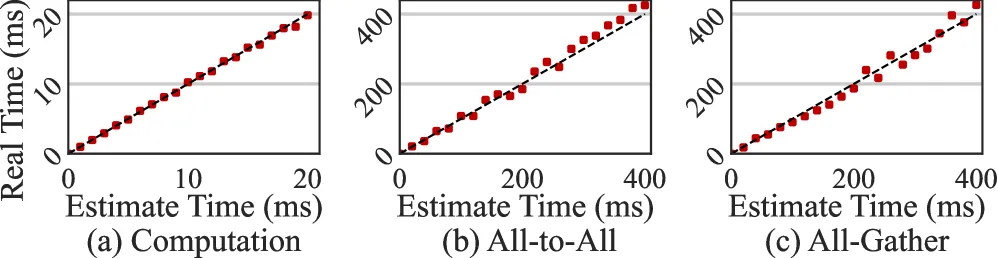
计算和通信延迟估计与实际值高度吻合。
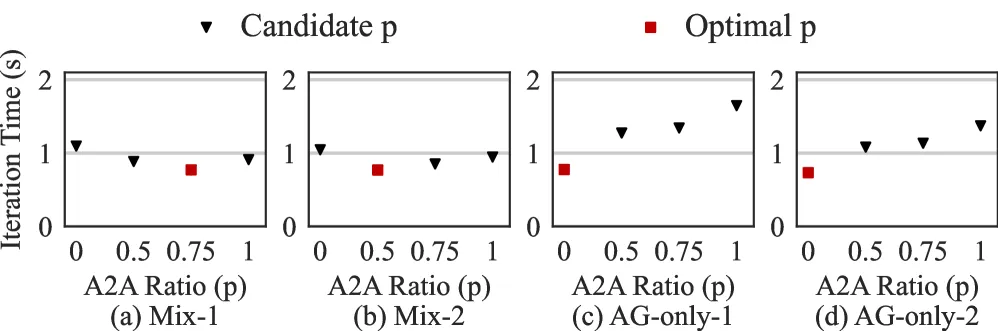
建模能找到最优 值(红点),在候选配置中实现最低迭代延迟。
端到端加速
不同数据流量 (专家大小固定 0.36 MB):
| 方法 | 6 MB | 12 MB | 24 MB | 48 MB | 96 MB | 192 MB |
|---|---|---|---|---|---|---|
| Tutel | 2.52s | 4.26s | 5.82s | 7.62s | 12.65s | 20.35s |
| FasterMoE | 2.58s | 4.37s | 5.90s | 7.81s | 12.80s | 20.82s |
| SmartMoE | 2.59s | 4.34s | 5.97s | 7.80s | 12.68s | 20.91s |
| HybridEP | 2.48s | 2.63s | 2.74s | 2.82s | 3.01s | 3.78s |
| 加速比 | 1.03x | 1.64x | 2.15x | 2.75x | 4.22x | 5.47x |
Cluster-L (4 DC) 下最高加速比达 5.60x。
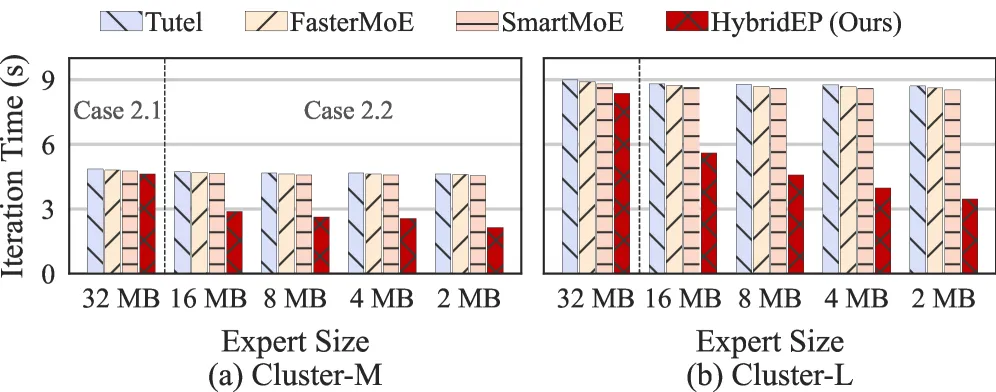
不同专家大小 (数据流量固定 16 MB):
- 专家大小从 32 MB 减小到 2 MB
- HybridEP 加速比 1.18x ~ 2.57x
- 现有方法迭代延迟几乎不变
消融实验
| 集群 | 数据&专家 | 分区 | +迁移 |
|---|---|---|---|
| Cluster-S | 24&8 MB | 0.76s | 0.61s |
| Cluster-M | 24&8 MB | 3.41s | 2.54s |
| Cluster-L | 24&8 MB | 6.12s | 3.48s |
| Cluster-S | 48&2 MB | 1.06s | 0.74s |
| Cluster-M | 48&2 MB | 6.21s | 2.81s |
| Cluster-L | 48&2 MB | 10.89s | 3.86s |
参数高效迁移在域级分区基础上实现 1.25x ~ 2.82x 额外加速。
精度分析
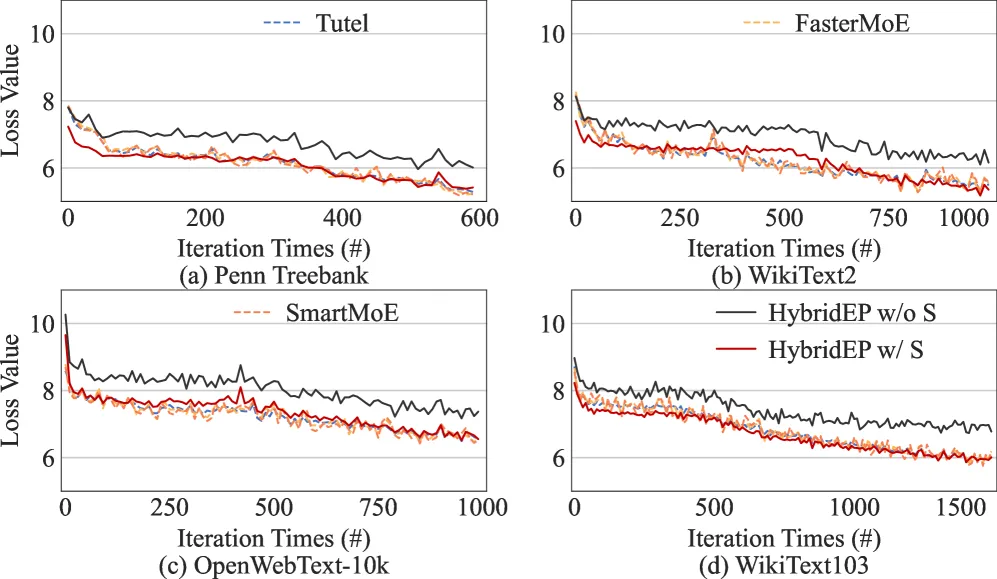
HybridEP w/ S (带共享专家) 的损失值与 Tutel/FasterMoE/SmartMoE 接近,50x 压缩比下保持精度。HybridEP w/o S (无共享专家) 损失明显偏高。
通信特性对比
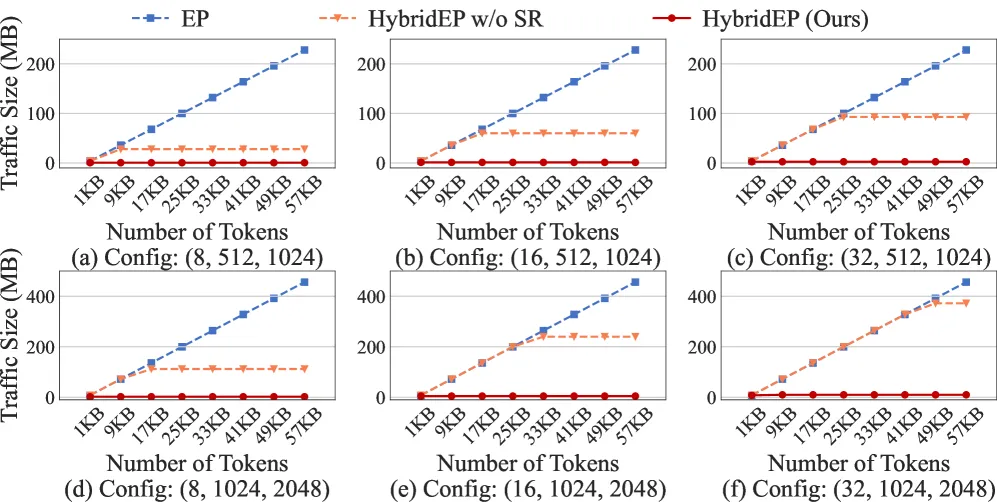
- 标准 EP:通信量随 token 数线性增长
- HybridEP:固定且与输入无关的通信量上限
大规模模拟
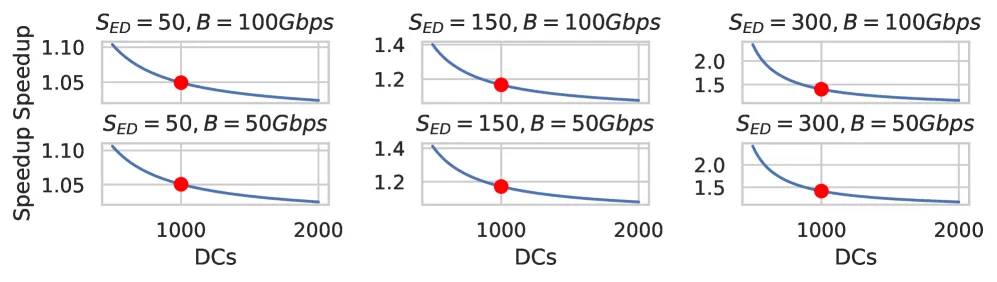
1000 DC 模拟结果:
- 固定域大小,扩展 DC 数:1.05x ~ 1.45x 加速
- 固定比例,扩展 DC 数:1.31x ~ 3.76x 加速
- 带宽越低,加速越显著
与现有方法对比
| 方法 | 类型 | 优化维度 | 跨 DC 适应性 |
|---|---|---|---|
| Tutel | EP 优化 | 数据传输 | 弱 |
| FasterMoE | EP 优化 | 专家传输 | 中 |
| SmartMoE | EP 优化 | 流水线 | 中 |
| HybridEP | 混合传输 | 数据+专家+拓扑 | 强 |
七、相关工作
MoE 训练系统
- Tutel:自适应 EP,动态切换 A2A/AG
- FasterMoE:专家预取和拓扑感知通信
- SmartMoE:流水线并行 + EP 优化
- SE-MoE:语义感知专家放置
跨 DC 训练
- 现有工作主要关注 DC 内优化
- 跨 DC 场景带宽受限是核心挑战
- HybridEP 首次系统性解决跨 DC EP 可扩展性
八、总结
核心贡献
- 提出 HybridEP 框架,通过混合专家/数据传输优化跨 DC EP 训练
- 建立流式模型确定最优数据/专家传输比例
- 设计域级分区算法构建 GPU 级通信拓扑
- 提出 SR 专家压缩(50x 压缩比)和异步通信器
- 在受限带宽下实现最高 5.6x 加速,大规模模拟 1.45x 加速
技术影响
- 为跨 DC MoE 训练提供可扩展的 EP 解决方案
- 混合传输范式可推广到其他分布式训练场景
- SR 压缩技术可应用于其他专家通信优化
局限性
- 实验规模受限于实际环境(最多 4 DC)
- 大规模模拟结果需要真实环境验证
- SR 压缩引入额外存储和计算开销
- 后向传播的 All-Reduce 通信未完全建模
九、参考资源
- 论文: arXiv:2510.19470
- 相关工作:
- Tutel (Hwang et al., 2022) - 自适应 EP
- FasterMoE (He et al., 2022) - 专家预取
- SmartMoE (Jia et al., 2023) - 流水线 EP
- Zero-Offload (Ren et al., 2021) - CPU Offloading