SparseVILA: Decoupling Visual Sparsity for Efficient VLM Inference
通过解耦视觉稀疏性,在预填充和解码阶段分别进行查询无关剪枝和查询感知检索,实现高效VLM推理
SparseVILA: Decoupling Visual Sparsity for Efficient VLM Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SparseVILA: Decoupling Visual Sparsity for Efficient VLM Inference |
| 作者 | Samir Khaki, Junxian Guo, Jiaming Tang, Shang Yang, Yukang Chen, Konstantinos N. Plataniotis, Yao Lu, Song Han, Zhijian Liu |
| 论文 | https://arxiv.org/abs/2510.17777 |
| 发布 | 2025-10-20 |
二、核心思想
问题定义
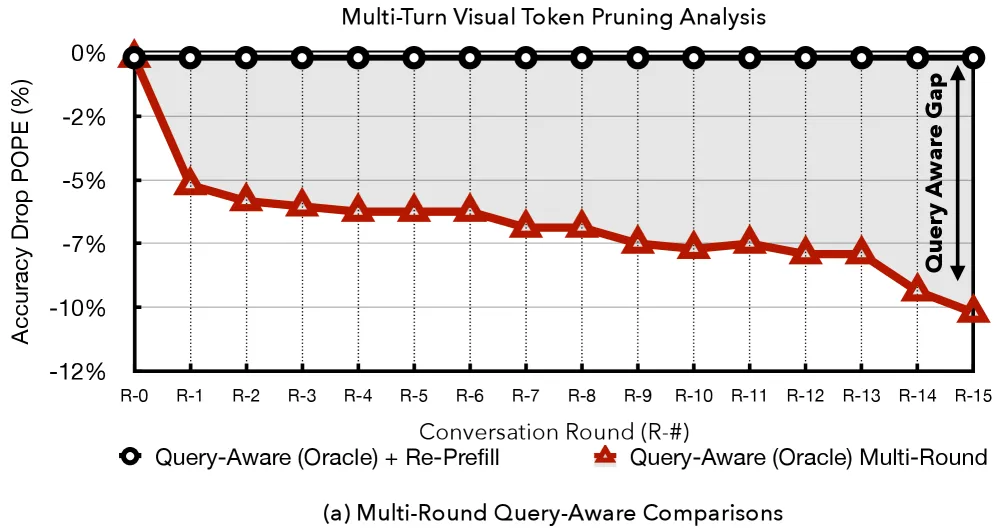
现有VLM加速方法存在多轮对话性能下降问题:
| 方法类型 | 优势 | 局限性 |
|---|---|---|
| 查询无关剪枝 | 稳定,适用于多轮对话 | 无法适应查询相关性 |
| 查询感知剪枝 | 动态对齐视觉注意力 | 不可逆信息丢失,后续轮次性能下降 |
关键观察
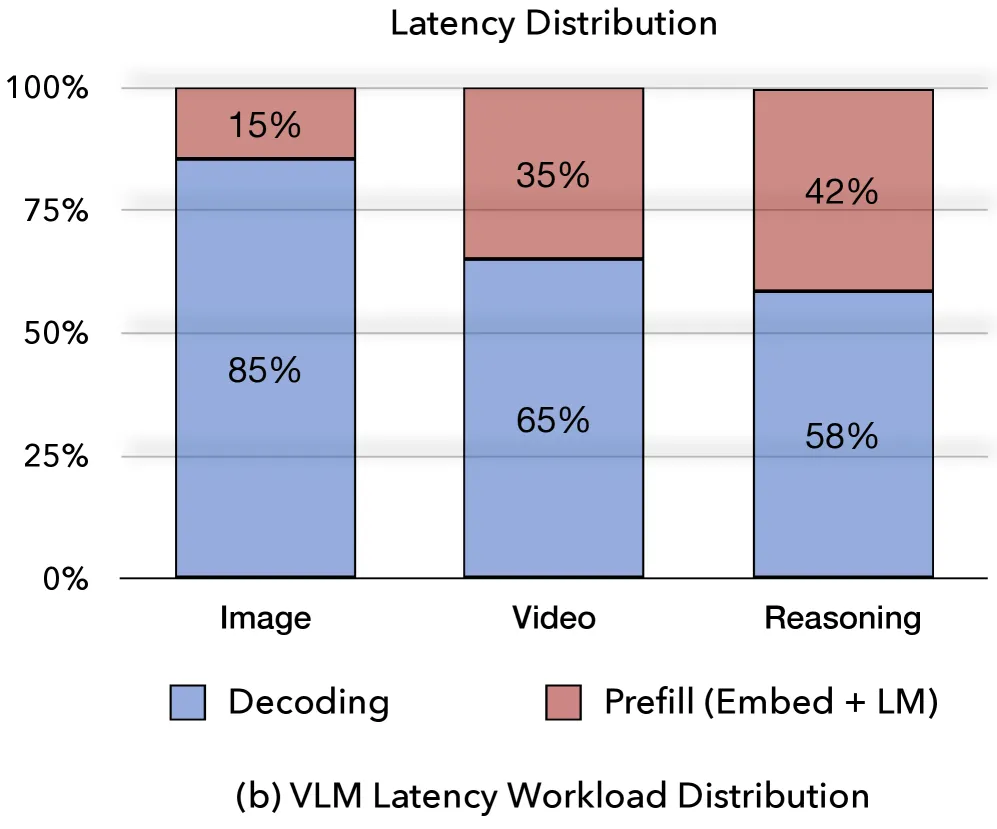
- 预填充阶段:构建多模态上下文(一次计算)
- 解码阶段:迭代生成(主导延迟)
- 多轮对话:视觉token需跨轮次复用
解决方案概述
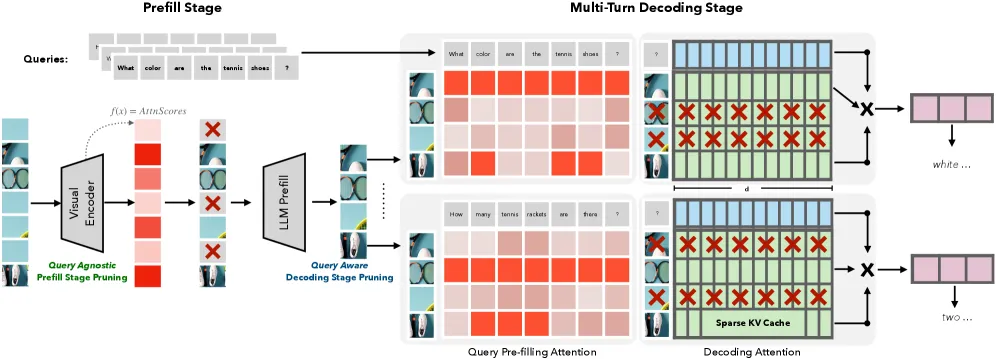
SparseVILA 提出解耦视觉稀疏性框架:
-
预填充阶段:查询无关剪枝(Query-Agnostic Pruning)
- 基于视觉显著性分数移除冗余token
- 保留足够覆盖度供后续轮次使用
-
解码阶段:查询感知检索(Query-Aware Retrieval)
- 从KV缓存中仅检索查询相关token
- 保持多轮对话保真度
三、技术架构
整体框架
输入图像 → 视觉编码器 → 视觉Token序列
                              ↓
                    [预填充阶段: 查询无关剪枝]
                              ↓
                         KV缓存 (压缩后)
                              ↓
                    [解码阶段: 查询感知检索]
                              ↓
                         文本输出
核心公式
视觉显著性估计:
其中:
- 是第 个视觉token
- 是token总数
- 对于有summary token的模型(如CLIP),计算token对summary token的注意力
查询感知检索:
其中:
- 是当前查询的token嵌入
- 是压缩后的视觉KV缓存
- 是检索的token数量
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 显著性估计器 | 基于注意力图计算token重要性 | 无需文本输入 |
| Triton内核 | 高效显著性计算 | 加速3-10× |
| 部分KV缓存驱逐 | 防止轮次间信息泄漏 | 保留视觉缓存 |
| 查询感知检索器 | 基于查询动态选择token | top-k选择 |
训练流程
SparseVILA是训练无关的:
- 无需训练:直接在现有VLM上部署
- 即插即用:作为推理加速插件
- 架构无关:适用于多种VLM架构
四、核心创新
| 创新点 | 说明 | 优势 |
|---|---|---|
| 解耦稀疏性 | 预填充和解码阶段使用不同策略 | 兼顾效率和保真度 |
| 查询无关剪枝 | 仅基于视觉显著性,不依赖文本 | 多轮对话稳定 |
| 查询感知检索 | 解码时动态选择相关token | 适应查询需求 |
| Triton内核 | 高效显著性计算 | 支持长上下文 |
| 部分KV缓存驱逐 | 防止轮次间信息泄漏 | 保持对话连贯性 |
五、代码实现分析
关键代码逻辑:
def query_agnostic_pruning(visual_tokens, salience_threshold):
    salience = compute_attention_salience(visual_tokens)
    mask = salience > salience_threshold
    return visual_tokens[mask]

def query_aware_retrieval(query, kv_cache, top_k):
    scores = torch.matmul(query, kv_cache.keys.T)
    top_indices = torch.topk(scores, top_k).indices
    return kv_cache[top_indices]

def partial_kv_cache_eviction(kv_cache, qa_pairs):
    # 保留视觉token,移除上一轮问答的token
    visual_mask = kv_cache.token_type == 'visual'
    qa_mask = ~kv_cache.token_ids.is_in(qa_pairs)
    return kv_cache[visual_mask | qa_mask]
六、实验结果
图像基准测试
LLaVA-NeXT-7B模型结果:
| 方法 | AI2D | ChartQA | DocVQA | GQA | POPE | 平均 |
|---|---|---|---|---|---|---|
| 原始(100%) | 72.3 | 68.5 | 73.2 | 64.8 | 87.2 | 73.2 |
| SparseVILA (75%) | 72.1 | 67.8 | 72.5 | 64.6 | 87.0 | 72.8 |
| VisionZip (75%) | 70.5 | 64.2 | 68.3 | 63.1 | 85.4 | 70.3 |
| FastV (75%) | 71.2 | 65.8 | 69.5 | 63.8 | 86.1 | 71.3 |
| PruMerge (75%) | 70.8 | 64.5 | 68.8 | 63.4 | 85.7 | 70.6 |
| SparseVILA (50%) | 71.5 | 66.2 | 70.1 | 64.0 | 86.5 | 71.7 |
| FastV (50%) | 68.5 | 60.2 | 63.5 | 61.2 | 82.3 | 67.1 |
| VisionZip (50%) | 67.8 | 58.5 | 61.8 | 60.5 | 81.5 | 66.0 |
关键发现:
- 75%稀疏度:SparseVILA保持98.9%性能,仅下降0.4%
- 50%稀疏度:SparseVILA保持97.9%性能,大幅超越其他方法
- 文档理解任务(ChartQA, DocVQA)性能下降比其他方法少15%以上
视频基准测试
LongVILA-7B模型结果(256帧):
| 方法 | LVB | MLVU | NExT-QA | Video-MME | 平均 |
|---|---|---|---|---|---|
| 原始(100%) | 53.8 | 64.9 | 78.6 | 58.8 | 64.0 |
| SparseVILA (75%) | 53.5 | 64.5 | 78.2 | 58.5 | 63.7 |
| VisionZip (75%) | 47.0 | 60.4 | 75.5 | 52.2 | 58.8 |
| PruMerge (75%) | 47.5 | 60.8 | 75.8 | 52.5 | 59.2 |
| FastV (75%) | 50.2 | 62.1 | 76.5 | 55.1 | 61.0 |
| SparseVILA (50%) | 52.8 | 63.8 | 77.5 | 57.8 | 63.0 |
| FastV (50%) | 45.5 | 58.2 | 73.2 | 49.8 | 56.7 |
关键发现:
- 视频任务提升:SparseVILA甚至比原始模型性能更高
- 长上下文扩展:支持200帧以上视频
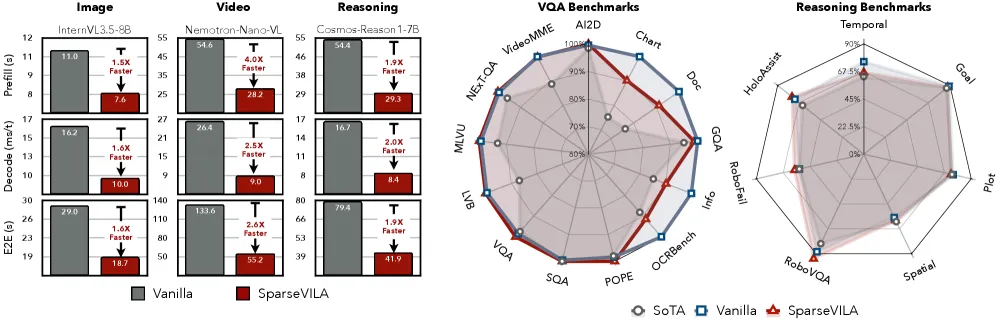
- 2.6×端到端加速:同时保持近无损精度
推理效率分析
效率提升(基于LLaVA-NeXT-7B):
| 方法 | 预填充加速 | 解码加速 | 端到端加速 |
|---|---|---|---|
| VisionZip | 0.9× | 28.5× | 2.1× |
| PruMerge | 0.9× | 28.5× | 2.1× |
| FastV | 2.5× | 1.8× | 2.0× |
| SparseVLM | 2.8× | 1.9× | 2.1× |
| SparseVILA | 4.0× | 2.5× | 2.6× |
长视频效率(256帧):
| 指标 | SparseVILA | 提升 |
|---|---|---|
| 预填充时间 | 1.2s | 6.0× 加速 |
| 解码时间 | 0.8s | 2.5× 加速 |
| 端到端时间 | 2.0s | 2.6× 加速 |
多轮对话性能
RoboVQA多轮对话结果:
| 方法 | 第1轮 | 第2轮 | 第3轮 | 第4轮 | 平均 |
|---|---|---|---|---|---|
| 原始 | 68.5 | 66.2 | 64.8 | 63.5 | 65.8 |
| SparseVILA | 68.2 | 66.0 | 64.5 | 63.2 | 65.5 |
| VisionZip | 65.8 | 61.2 | 56.5 | 52.8 | 59.1 |
| FastV | 67.5 | 63.8 | 59.2 | 55.5 | 61.5 |
关键发现:
- SparseVILA多轮性能几乎无下降
- 查询感知方法(FastV)后续轮次性能急剧下降
- 查询无关方法(VisionZip)整体性能较低
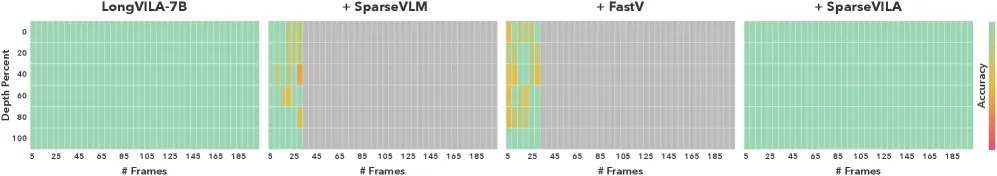
视觉检索性能
V-NIAH长上下文检索:
| 方法 | 32帧 | 64帧 | 128帧 | 200帧 |
|---|---|---|---|---|
| SparseVLM | 100% | 85% | 60% | 失败 |
| FastV | 100% | 80% | 55% | 失败 |
| SparseVILA | 100% | 100% | 100% | 100% |
关键发现:
- SparseVILA支持200帧以上长上下文
- 其他方法在32帧后开始退化
七、相关工作
视觉Token压缩
| 方法 | 策略 | 局限性 |
|---|---|---|
| VisionZip | 查询无关剪枝 | 高稀疏度下性能下降 |
| PruMerge | Token合并 | 计算开销大 |
| HIRED | 显著性剪枝 | 不够精细 |
| FastV | 查询感知剪枝 | 多轮对话性能下降 |
| SparseVLM | 跨模态注意力剪枝 | 不可逆信息丢失 |
KV缓存压缩
- 传统方法:固定比例压缩
- SparseVILA创新:基于查询动态选择
八、总结
核心贡献
- 解耦稀疏性框架:首次提出预填充-解码阶段解耦策略
- 查询无关剪枝:保持多轮对话稳定性
- 查询感知检索:适应查询需求,提升效率
- 高效实现:Triton内核加速显著性计算
技术影响
- 推理加速:4.0×预填充加速,2.5×解码加速,2.6×端到端加速
- 多轮保真:几乎无性能下降的多轮对话
- 长视频支持:200帧以上长上下文
- 架构无关:适用于多种VLM架构
局限性
- 稀疏度上限:低于50%时性能开始下降
- 计算开销:显著性估计仍有一定计算成本
- 架构依赖:需要访问视觉编码器的注意力图
- 实时性:尚未验证实时流式生成场景
九、参考资源
论文
- 本文: https://arxiv.org/abs/2510.17777
- LLaVA-NeXT: Liu et al., 2024
- LongVILA: Zhang et al., 2024
相关方法
- VisionZip: Yang et al., 2025
- FastV: Zhang et al., 2024
- SparseVLM: Zhang et al., 2025
- PruMerge: Chen et al., 2024
- HIRED: Wang et al., 2024