FlexLink: Boosting your NVLink Bandwidth by 27%
通过聚合异构互连(NVLink、PCIe、RDMA NIC)提升节点内集合通信带宽
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FlexLink: Boosting your NVLink Bandwidth by 27% without accuracy concern |
| 作者 | Ao Shen, Rui Zhang, Junping Zhao |
| 机构 | Asystem@Ant Group |
| 论文 | arXiv:2510.15882 |
| 代码 | 未公开 |
| 发布 | 2025-08-30 |
| 领域 | Hardware Architecture (cs.AR), AI, Distributed Computing |
二、核心思想
问题定义
随着大语言模型(LLM)规模持续增长,多节点部署已成为必需,通信成为关键性能瓶颈。当前的节点内通信库(如NCCL)通常仅使用单一互连(如NVLink),导致性能天花板,特别是在H800 GPU等硬件上,主互连带宽成为瓶颈,而PCIe和RDMA NIC等其他硬件资源在密集工作负载期间基本闲置。
关键观察:
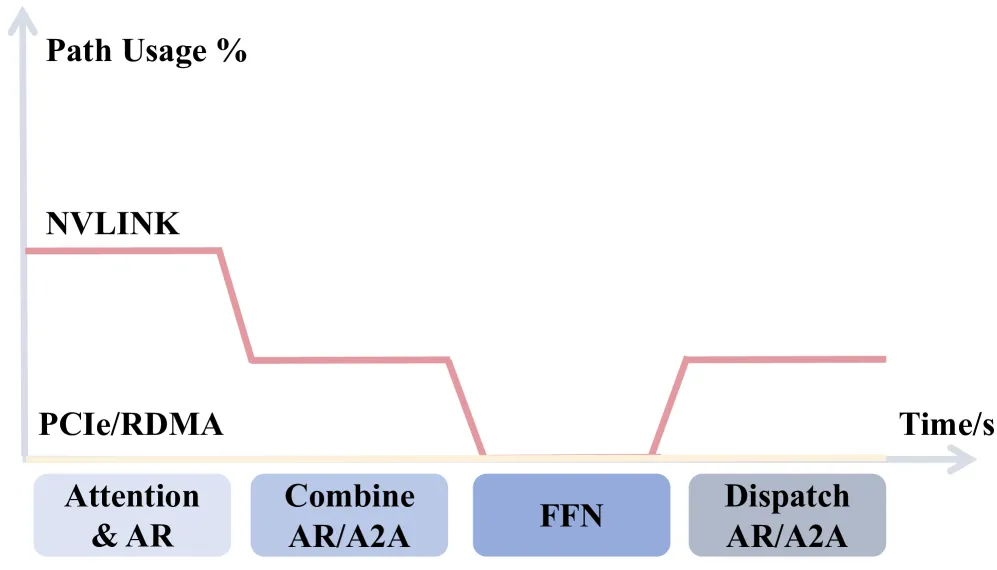
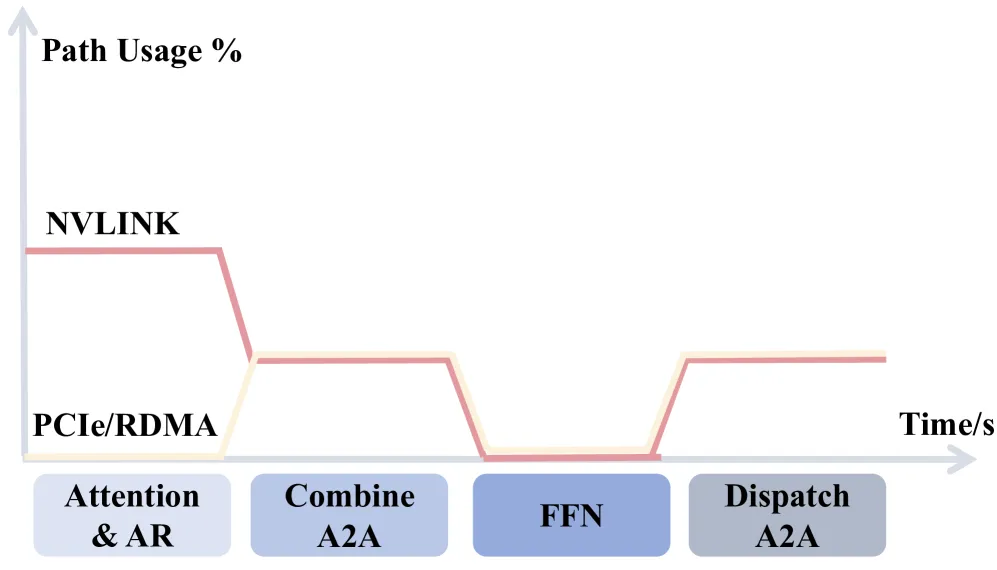
- MoE模型训练中,通信开销可占前向传播时间的43.6%
- 长序列推理中,通信开销可达65.9%
- H800 GPU的NVLink带宽仅为400 GB/s(H100的900 GB/s的一半不到)
解决方案概述
FlexLink是首个系统性地将异构互连(NVLink、PCIe、RDMA NIC)聚合为统一高性能通信结构的集合通信框架。核心创新:
- 异构链路聚合:将NVLink、PCIe和RDMA NIC整合为统一资源池
- 两阶段自适应负载均衡:初始粗粒度调优 + 运行时细粒度调整
- 无损、即插即用:兼容NCCL API,无需修改应用代码
三、技术架构
整体框架图
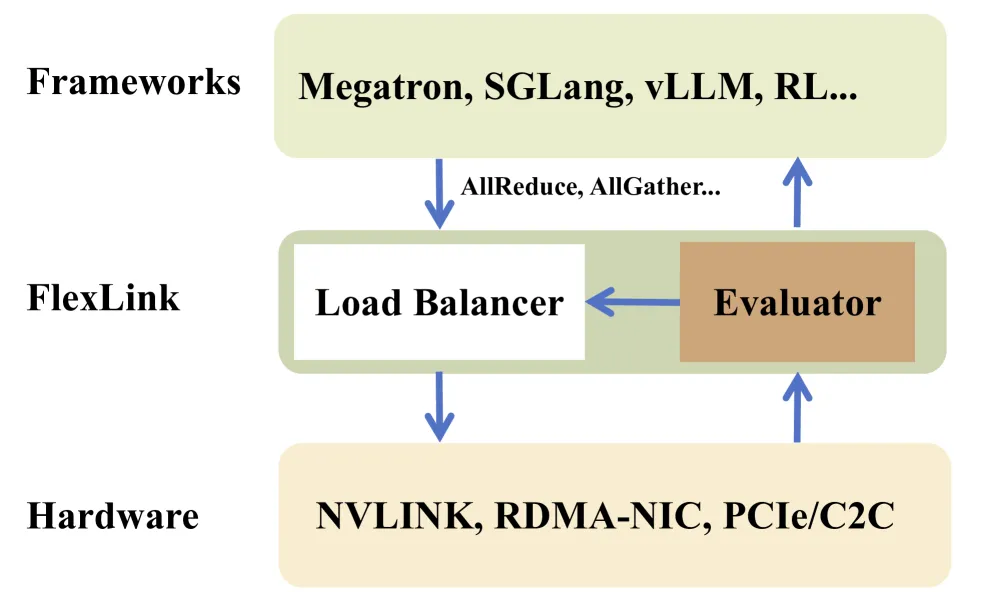
FlexLink的架构由以下核心组件构成:
| 组件 | 说明 | 关键特点 |
|---|---|---|
| Communicator | 通信后端接口 | 抽象异构互连为统一资源池 |
| Evaluator | 运行时监控 | 持续监控链路性能指标 |
| Load Balancer | 负载均衡器 | 动态调整流量分配 |
| NCCL Communicator | NVLink路径 | 处理GPU-to-GPU直接通信 |
| NVSHMEM Context | RDMA路径 | GPU发起的低延迟通信 |
核心设计
双缓冲流水线:
为管理数据流并隐藏PCIe延迟,FlexLink实现了双缓冲流水线,将数据传输解耦为两个阶段:
- PD2H (Producer-Device-to-Host):生产者GPU到主机内存
- H2CD (Host-to-Consumer-Device):主机内存到消费者GPU
专用固定内存缓冲区允许一个块的PD2H传输与另一个块的H2CD传输重叠,最大化PCIe总线利用率。
低延迟同步机制:
避免使用昂贵的内存栅栏或CPU锁,而是使用CUDA的流序内存操作:
cuStreamWaitValue32和cuStreamWriteValue32- GPU直接轮询内存位置,最小化CPU参与
- 使用单调递增计数器确保跨迭代的正确性
迭代同步协议:
生产者: 等待 semEmpty==i → 写入数据 → 设置 peer 的 semFull 为 i+1
消费者: 等待 semFull==i+1 → 读取数据 → 设置 semEmpty 为 i+1
两阶段负载均衡策略
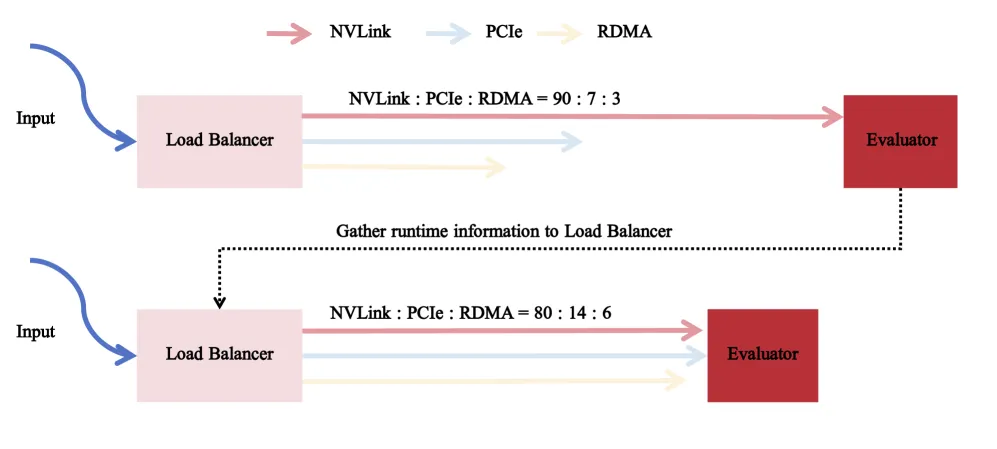
Stage 1: 初始粗粒度调优
初始化时执行简短的一次性性能分析(约10秒),找到接近最优的静态负载分配:
- 目标:所有链路在大致相同时间内完成数据传输
- 保守策略:从较小的辅助路径份额开始
- 逐步增加:直到辅助路径成为瓶颈
Algorithm 1: Initial Coarse-Grained Load Tuning
输入: 辅助链路带宽 B_aux, NVLink带宽 B_nvlink
输出: 初始负载份额 α_init

1. 计算理论最优份额: α_theory = B_aux / (B_aux + B_nvlink)
2. 从保守值开始: α = α_theory * 0.5
3. 逐步增加 α,测量实际带宽
4. 当辅助路径成为瓶颈时停止
5. 返回最优 α_init
Stage 2: 运行时细粒度调整
运行时Evaluator持续监控链路性能,Load Balancer动态调整:
- 监控指标:链路完成时间、吞吐量、延迟
- 调整策略:如果辅助路径完成更快,增加其份额;反之减少
- 响应时间:实时调整,适应动态变化的消息大小
硬件架构分析
| GPU服务器 | NVLink (GB/s) | PCIe/C2C (GB/s) | RDMA NIC (Gb/s) | 路径竞争 | 闲置带宽机会 |
|---|---|---|---|---|---|
| H800 | 400 | 128 | 800 | 是 | 32% |
| H100/H200/H20 | 900 | 128 | 800 | 是 | 14% |
| A800 | 400 | 64 | 400 | 是 | 16% |
| GB200 | 1800 | 400 | 1600 | 是 | 22% |
| GB300 | 1800 | 400 | 1600 | 否 | 33% |
关键洞察:
- 当前硬件存在路径竞争(GPU-to-NIC和GPU-to-CPU共享PCIe链路)
- GB300将解耦I/O路径,消除竞争,闲置带宽机会增至33%
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 异构链路聚合 | 首个系统性聚合NVLink、PCIe、RDMA NIC的框架 | 填补32%闲置带宽机会 |
| 两阶段负载均衡 | 初始粗粒度调优 + 运行时细粒度调整 | 防止慢链路拖累快链路 |
| 双缓冲流水线 | PD2H和H2CD重叠执行 | 隐藏PCIe延迟 |
| 低延迟同步 | CUDA流序内存操作,避免CPU锁 | 最小化同步开销 |
| NUMA感知优化 | CPU绑定到最近NUMA节点,内存分配NUMA感知 | 提升缓存性能 |
| 无损即插即用 | 兼容NCCL API,无需修改应用代码 | 易于集成 |
五、实现细节
PCIe路径实现
- 经典环形模型:GPU-to-GPU传输通过指定主机内存缓冲区中转
- 双缓冲流水线:PD2H和H2CD阶段重叠
- NUMA优化:CPU进程绑定到最近物理核,缓冲区NUMA感知分配
RDMA路径实现
- 基于NVSHMEM实现
- GPU发起的通信(put/get操作)
- 类似的NUMA感知优化
- 轻量级同步机制
同步机制
// 生产者侧
cuStreamWaitValue32(stream, semEmpty, i, CU_STREAM_WAIT_VALUE_EQ);
cuMemcpyAsync(peerBuffer, localBuffer, size, stream);
cuStreamWriteValue32(stream, peerSemFull, i+1, 0);

// 消费者侧
cuStreamWaitValue32(stream, semFull, i+1, CU_STREAM_WAIT_VALUE_EQ);
cuMemcpyAsync(localBuffer, peerBuffer, size, stream);
cuStreamWriteValue32(stream, peerSemEmpty, i+1, 0);
六、实验结果
带宽提升
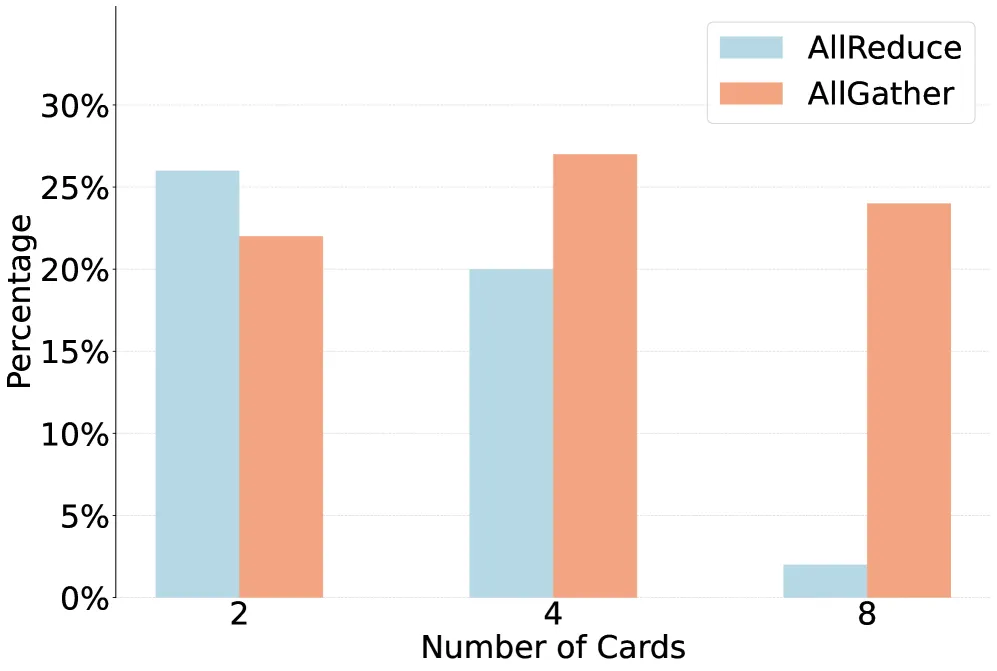
8-GPU H800服务器上的结果:
| 操作 | NCCL基线 | FlexLink (PCIe) | FlexLink (PCIe+RDMA) | 提升 |
|---|---|---|---|---|
| AllReduce | 基线 | +18% | +26% | 最高26% |
| AllGather | 基线 | +19% | +27% | 最高27% |
负载分布:
- 将2-22%的总通信流量卸载到之前闲置的PCIe和RDMA NIC
- 更快的互连不受慢速链路限制
端到端有效算法带宽
Table 2: 不同消息大小下的有效带宽 (GB/s)和负载分布
| 消息大小 | NCCL | FlexLink (PCIe) | FlexLink (PCIe+RDMA) |
|---|---|---|---|
| 小消息 | 基线 | 轻微提升 | 轻微提升 |
| 中等消息 | 基线 | 显著提升 | 显著提升 |
| 大消息 (256MB) | 基线 | +18% | +27% |
关键优势
- 无损保证:不损失精度,完全兼容现有代码
- 即插即用:兼容NCCL API,无需修改应用
- 自适应:动态适应不同消息大小和工作负载
- 可扩展:适用于未来硬件(如GB300,闲置带宽机会33%)
七、相关工作
| 方向 | 代表工作 | FlexLink的优势 |
|---|---|---|
| 通信压缩 | Flash Communication, TensorRT-LLM | 正交,可组合使用 |
| 计算-通信重叠 | FlashOverlap, Comet, ConCCL | 正交,FlexLink可作为后端 |
| 编译器优化 | TileLink | FlexLink可集成增强 |
| 节点间多路径 | FuseLink, Nezha | FlexLink专注节点内 |
关键区别:
- 压缩方法是有损的,FlexLink是无损的
- 重叠方法关注调度,FlexLink关注带宽聚合
- 多路径方法针对节点间,FlexLink针对节点内
八、总结
核心贡献
- 首个异构互连聚合框架:系统性地将NVLink、PCIe和RDMA NIC聚合为统一通信结构
- 两阶段自适应负载均衡:初始粗粒度调优 + 运行时细粒度调整,确保最优资源利用
- 无损即插即用:兼容NCCL API,无需修改应用代码
- 显著性能提升:8-GPU H800服务器上AllReduce提升26%,AllGather提升27%
技术影响
- 即时价值:解决H800等带宽受限GPU的通信瓶颈
- 未来价值:GB300等下一代硬件将提供更多闲置带宽机会(33%)
- 组合价值:与压缩、重叠等技术正交,可组合使用
- 易用性:作为NCCL的drop-in replacement,降低采用门槛
局限性
- 论文未公开代码实现
- 主要针对节点内通信,节点间通信需其他方案
- 性能提升依赖于硬件配置(H800上最显著)
- 需要RDMA NIC支持才能获得最大收益
九、参考资源
- 论文: arXiv:2510.15882
- 相关技术: NCCL, NVSHMEM, PCIe, RDMA
- 应用场景: MoE训练、长序列推理、大规模分布式训练