Tawa: Automatic Warp Specialization for Modern GPUs with Asynchronous References
基于异步引用的现代 GPU 自动 Warp 特化编译器
Tawa: Automatic Warp Specialization for Modern GPUs with Asynchronous References
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Tawa: Automatic Warp Specialization for Modern GPUs with Asynchronous References |
| 作者 | (未在摘要中列出) |
| 机构 | (未在摘要中列出) |
| 论文 | arXiv:2510.14719 |
| 代码 | 基于 Triton 构建,约 4K 行 C++ 代码 |
| 发布 | 2025年10月 |
| 许可 | 未明确 |
二、核心思想
问题定义
现代 GPU 架构已从同构处理器演变为复杂的异构系统,集成了多个专用硬件单元(如 Tensor Core 用于密集矩阵计算,TMA 用于异步数据移动)以最大化性能。然而,主流的 SIMT(单指令多线程)编程模型与这种异构、任务并行的硬件现实存在根本性的不匹配。
SIMT 模型假设一个 warp 内的所有线程在不同数据上执行相同指令,适用于统一控制流的问题。但它不适合管理需要由不同并发任务驱动的多样化硬件单元。例如,一个任务可能涉及生成地址并用 TMA 启动批量拷贝,而另一个任务在 Tensor Core 上执行矩阵乘法。这造成了范式不匹配:硬件能够进行异步、任务并行的执行,但软件模型是为同步、数据并行执行构建的。
解决方案概述
Tawa 是一个自动化编译器,系统性地从高级、基于 tile 的程序生成高性能、warp 特化的代码。核心是引入了一种新的 IR 抽象——异步引用(asynchronous references, aref),它表达 warp 级通信而不暴露底层硬件细节。
使用这种抽象,Tawa 自动将程序划分为生产者-消费者角色,并管理复杂的数据流流水线,将开发者从侵入式的内核重写中解放出来。
核心优势
- 在 NVIDIA H100 GPU 上评估,Tawa 在代表性 LLM 内核上实现了高硬件利用率
- GEMM 性能:达到 1.1× 加速超越高度优化的 cuBLAS
- 注意力性能:比 Triton 快 1.2×,匹配手写 CUTLASS C++ FlashAttention-3 内核性能,但编程工作量大幅减少
三、技术架构
整体框架图
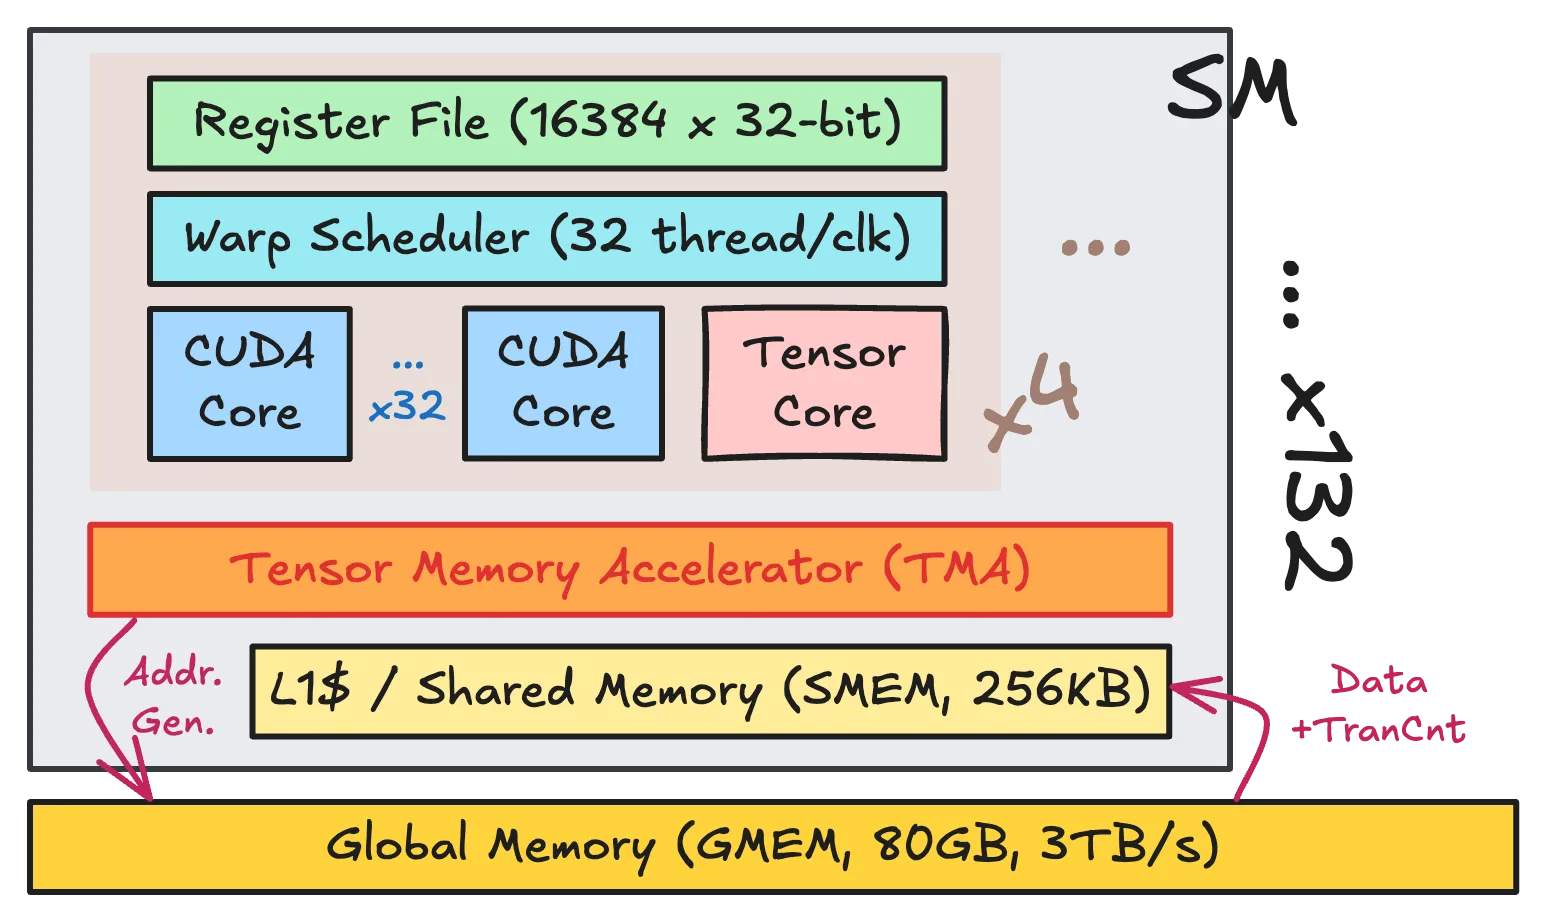
Figure 1: 简化的 NVIDIA H100 SXM5 GPU 架构
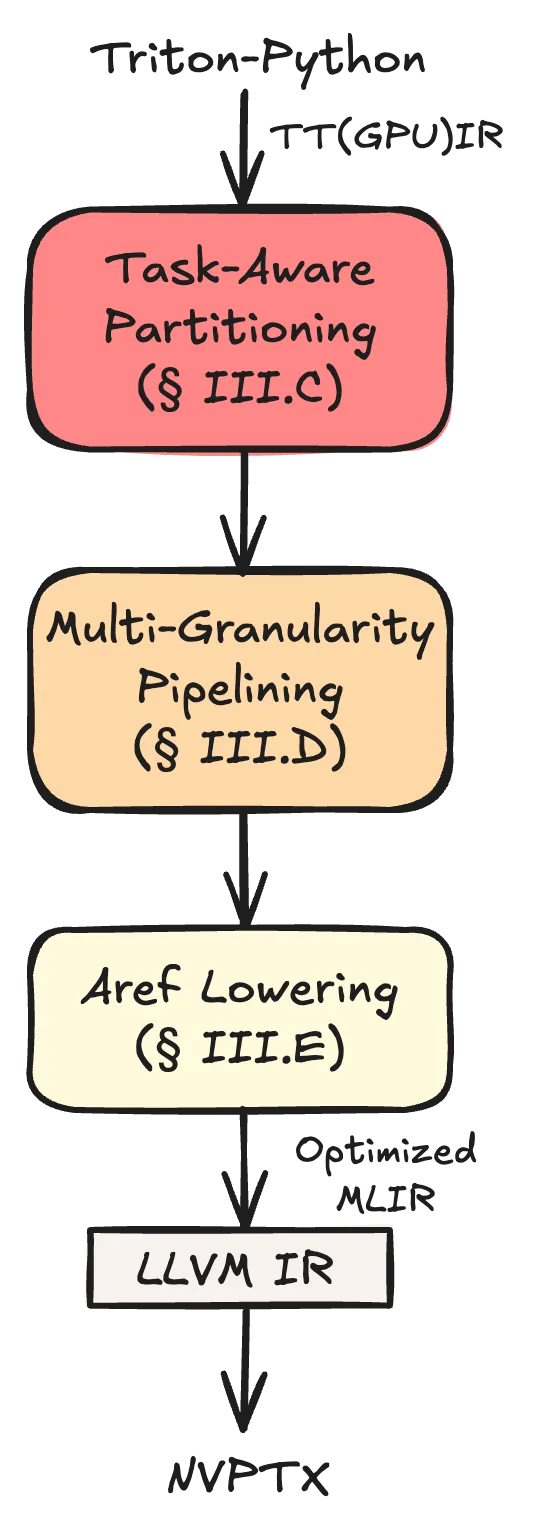
Figure 2(a): Tawa 编译流程
编译流程
Tawa 选择 Triton 作为前端接口。程序员在 CTA 中用 Triton-Python 编写带有 tiled 计算和 TMA 通信的内核,首先翻译为标准 Triton-MLIR 表示。在此基础上,Tawa 引入一系列编译器 pass,自动化从高级 Python 代码生成 warp 特化程序。
Tawa 应用三个关键变换:
- 任务感知分区(Task-aware partitioning):引入新算法将程序划分为生产者和消费者 warp 组,确保正确的角色分配和通信边界
- 异步引用抽象(Asynchronous reference abstraction):设计 aref 中间表示,显式捕获 warp 间数据流
- 多粒度软件流水线(Multi-granularity software pipelining):在 aref 程序之上应用软件流水线 pass,协调通信和计算在多个粒度上的重叠
核心抽象:异步引用(aref)
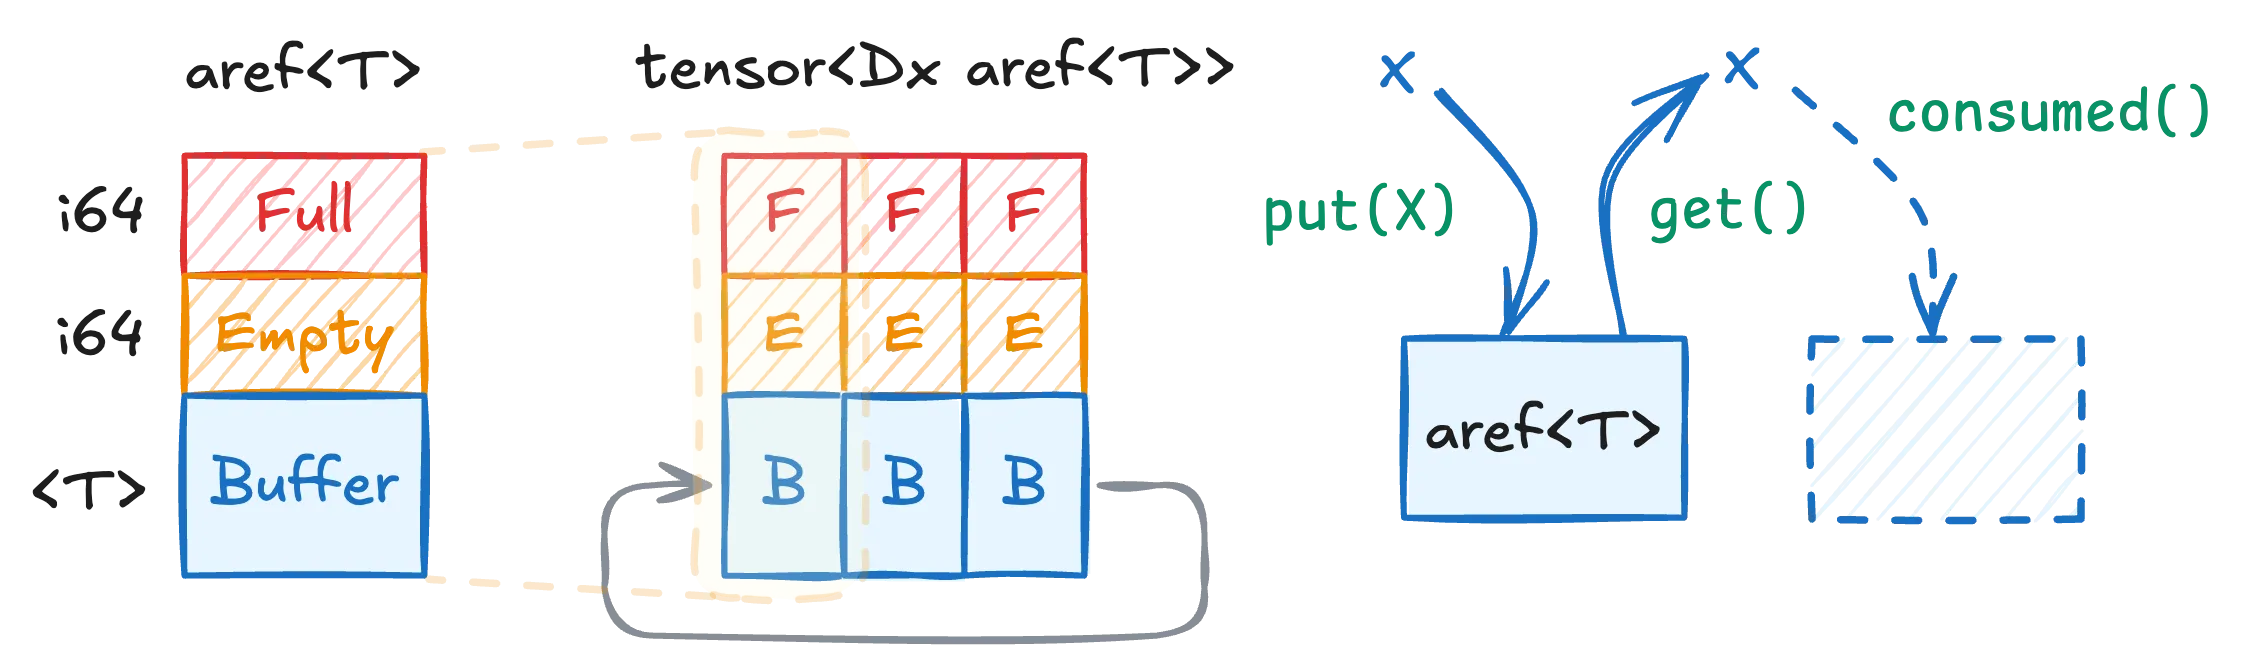
Figure 3: aref 抽象及相关操作
aref 是一种新的 IR 抽象,表达 warp 级通信而不暴露底层硬件细节。通过在 IR 级别表达通信意图,aref 允许编译器自动插入和协调必要的同步和数据移动操作。
Warp 特化实现
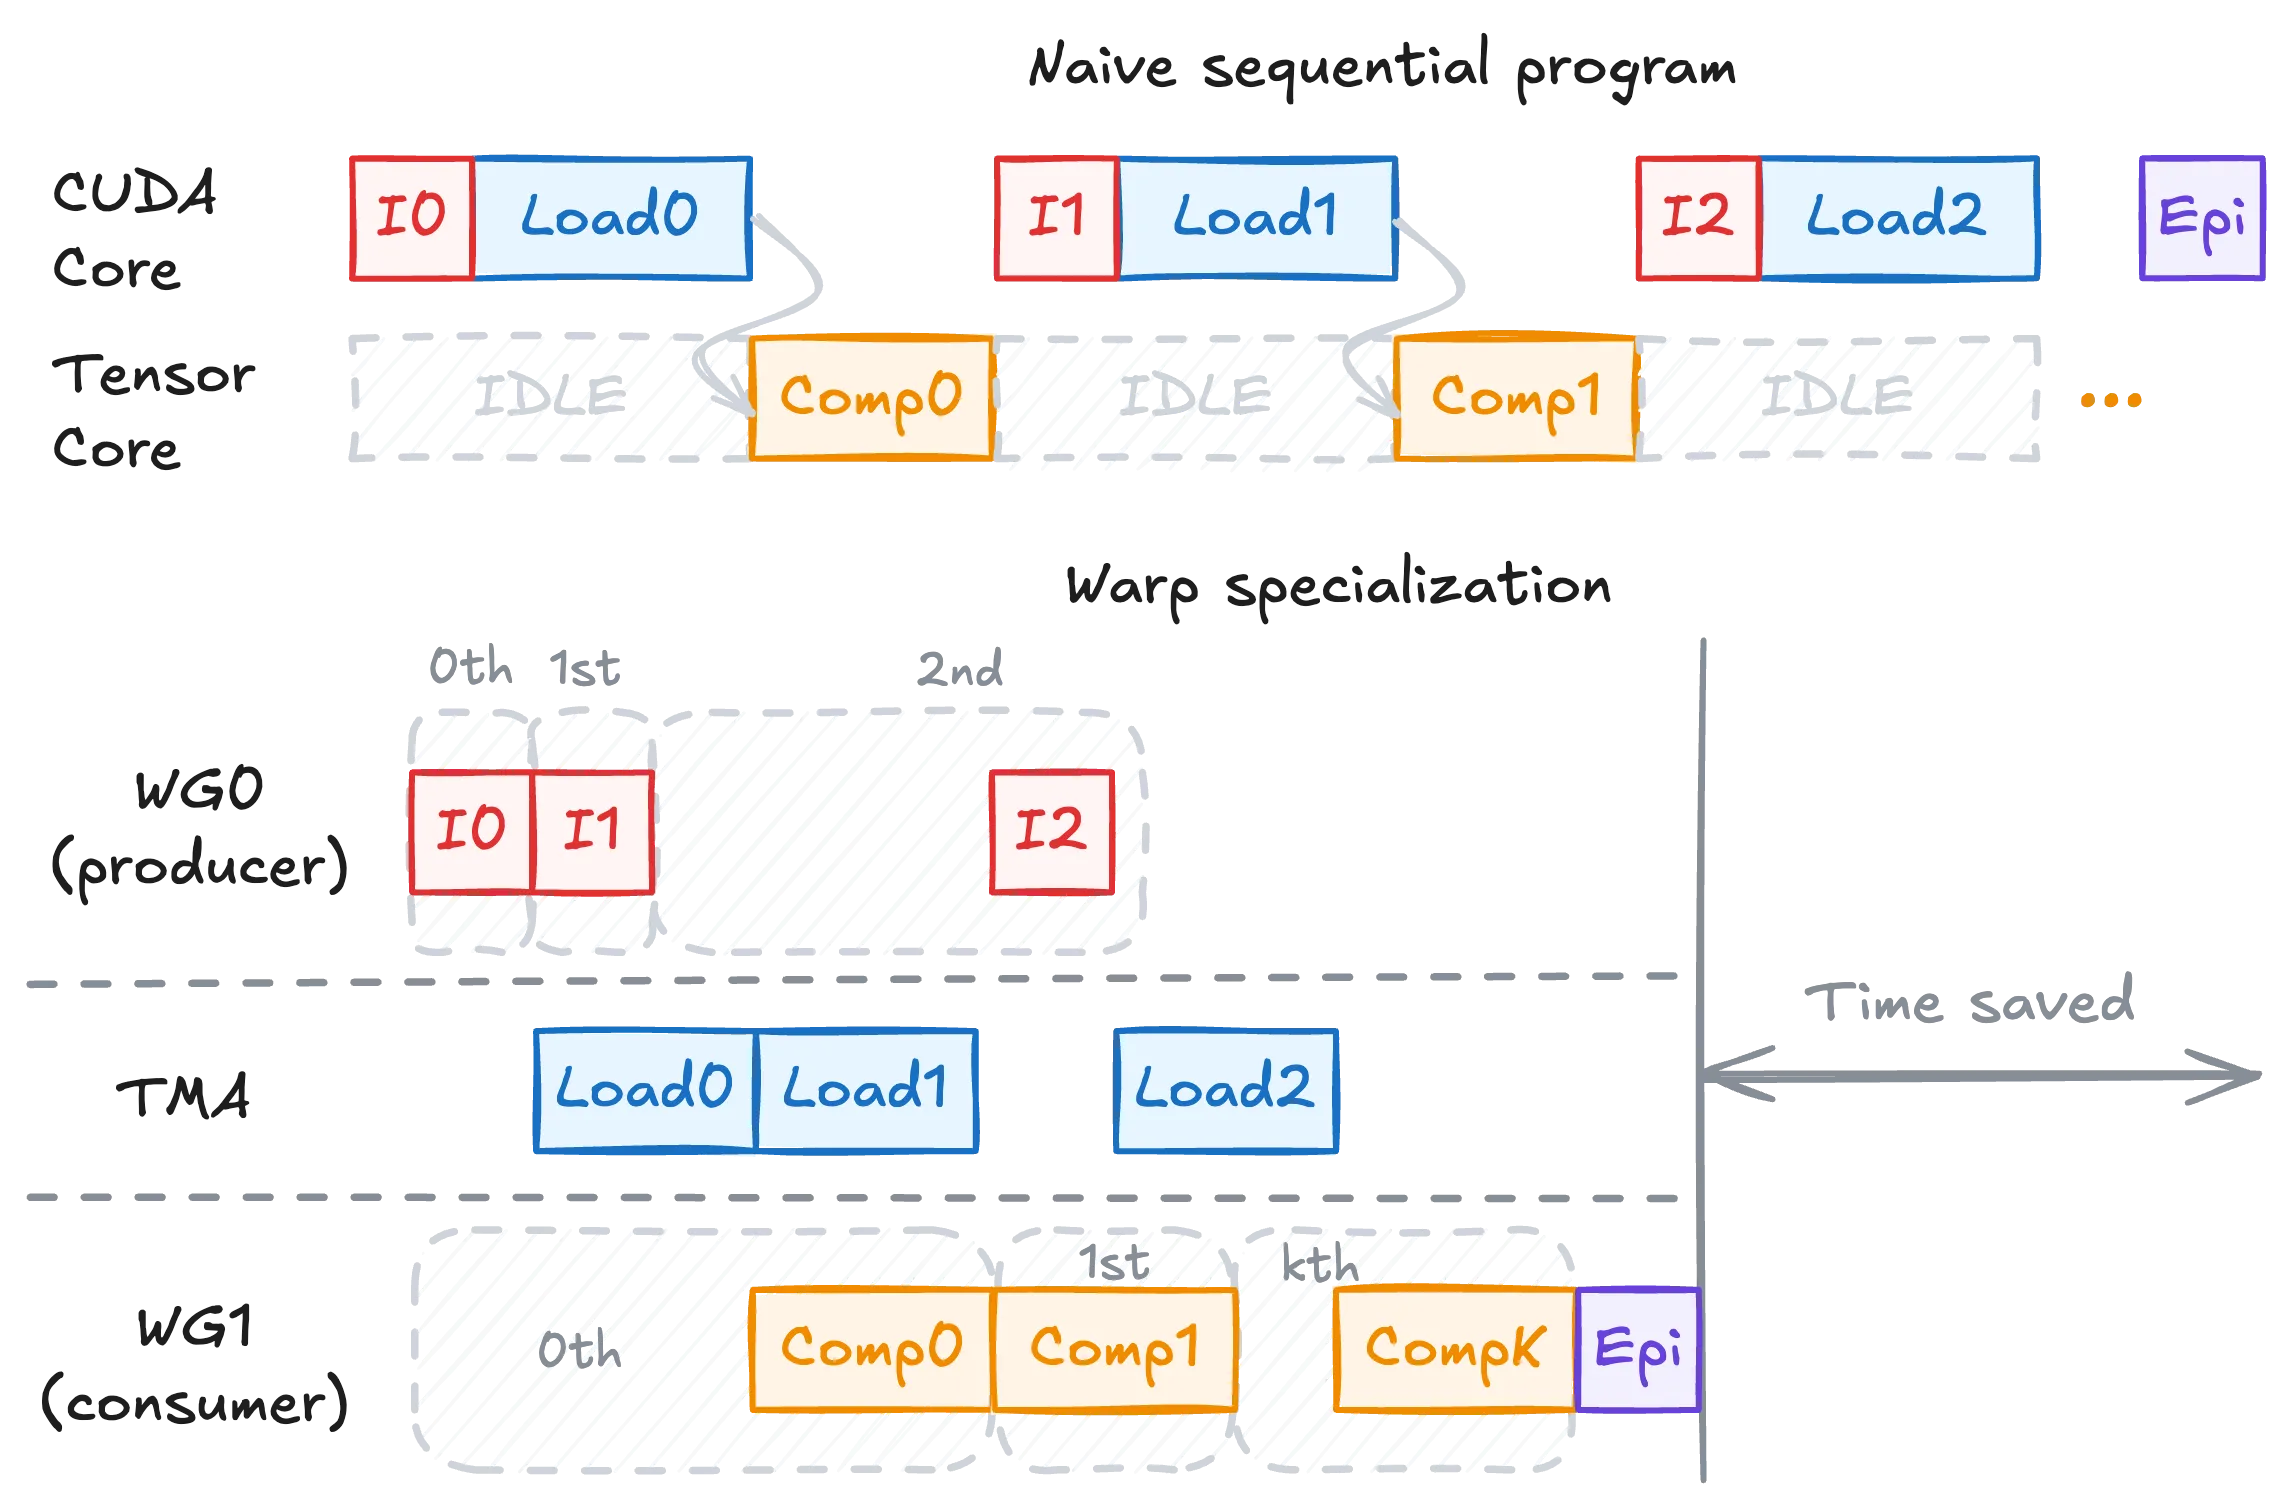
Figure 5(c): 实现的 warp 特化(假设 D=2)
编译示例
Triton 输入(简化):
@triton.jit
def matmul(a_desc, b_desc, c_ptr, M, N, K, ...):
    pid = tl.program_id(axis=0)
    # ...
    for k in range(0, tl.cdiv(K, Kt)):
        # Data loading
        a = tl.tma_load(a_desc, [o_am, o_k], [Mt, Kt])
        b = tl.tma_load(b_desc, [o_bn, o_k], [Nt, Kt])
        # Computation
        acc = tl.dot(a, b.T, acc=acc)
Tawa MLIR 输出(简化):
module attributes {"num-warps" = 8 : i32} {
  tt.func public @matmul(...) -> tensor<2x!tawa.aref<...>> {
    tawa.warp_group { /* producer */ } {partition = 0 : i32}
    tawa.warp_group { /* consumer */ } {partition = 1 : i32}
  }
}
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 异步引用(aref) | 新 IR 抽象,表达 warp 级通信而不暴露硬件细节 | 自动管理生产者-消费者数据流 |
| 任务感知分区 | 自动将程序划分为生产者和消费者 warp 组 | 确保正确的角色分配和通信边界 |
| 多粒度软件流水线 | 协调通信和计算在多个粒度上的重叠 | 提高 Tensor Core 利用率 |
| 协作 Warp 组 | 多个 warp 组协作计算同一 tile | 增加算术强度,提高数据重用 |
| 持久内核 | 减少 CTA 启动开销 | 保持 SM 驻留,减少重复启动 |
进一步优化
协作计算 Warp 组
Warp 特化执行的一个关键限制是每个 warp 组可用的寄存器预算有限,这限制了最大 tile 大小并可能限制整体计算强度。协作 warp 组优化通过允许多个 warp 组协作计算同一 tile 来缓解此瓶颈。
如图 7(a) 所示,两个消费者 warp 组(WG1 和 WG2)共同消费由 TMA warp 组(WG0)生产的数据。通过汇集寄存器,协作 warp 可以形成更大的 tile,增加算术强度、提高数据重用并减少内存流量。
持久内核
GPU 流水线中的另一个主要低效来源是重复的内核启动,每次都引入显著的 CTA 启动开销。持久内核通过仅启动与 SM 数量相同的 CTA 并在整个执行期间保持它们驻留来减少此开销。
五、实验结果
实验设置
- 硬件: NVIDIA H100 SXM5 GPU,80GB HBM3e 内存
- 软件: CUDA 12.7
- 基线: cuBLAS v12.7, CUTLASS 4.0.0, Triton, ThunderKittens, TileLang
- 测量: 25 次预热 + 1000 次测量运行取平均
GEMM 性能
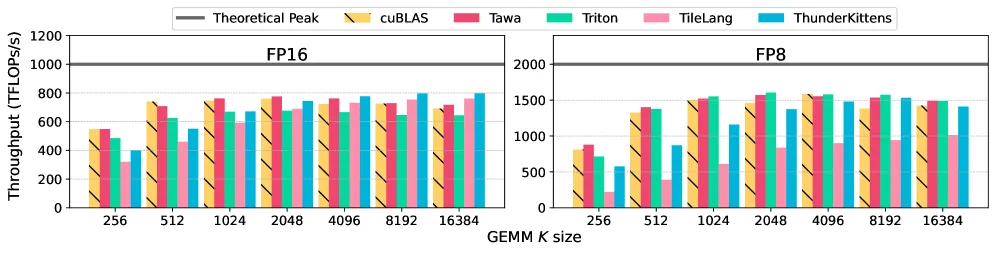
Figure 8: 不同框架的 GEMM 性能结果(M=N=8192,变化 K)
- Tawa 在 FP16 GEMM 上达到 1.1× 加速超越 cuBLAS
- 在 FP8 GEMM 上同样表现出色
注意力性能
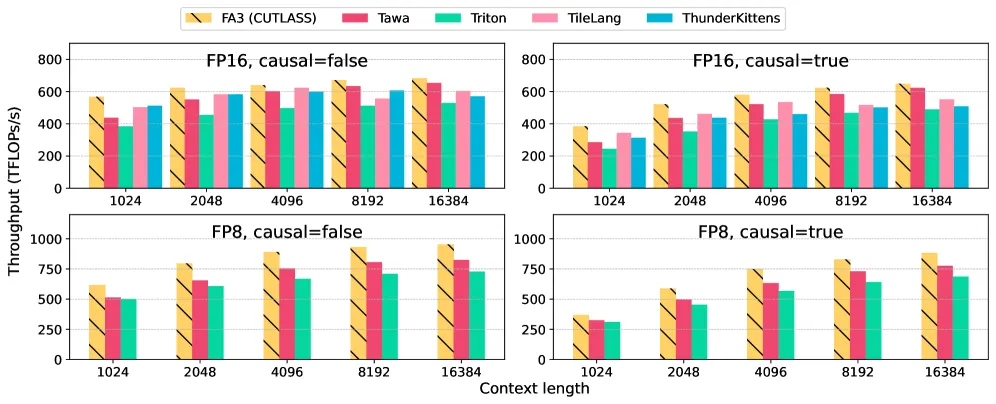
Figure 10: FP16 和 FP8 MHA 性能结果
- Tawa 在注意力工作负载上比 Triton 快 1.2×
- 匹配手写 CUTLASS C++ FlashAttention-3 内核性能
- 编程工作量大幅减少
批量和分组 GEMM
- FP16 批量 GEMM 和分组 GEMM 结果显示 Tawa 在各种变体上均表现优异
- 在不同序列长度的注意力内核上保持一致的性能优势
消融实验
- aref 和 MMA 管道大小的影响
- 不同优化对 FP16 内核的影响
六、与现有方法对比
| 框架 | 类型 | 编程工作量 | GEMM 性能 | 注意力性能 |
|---|---|---|---|---|
| Tawa | 自动编译器 | 低(Triton-Python) | 1.1× vs cuBLAS | 匹配 CUTLASS |
| cuBLAS | 闭源库 | 无(预编译) | 基准 | N/A |
| CUTLASS | CUDA 库 | 高(C++ 模板) | 高 | 高(手写) |
| Triton | DSL | 中(Python) | 中 | 中 |
| ThunderKittens | CUDA 库 | 高 | 高 | 高 |
| TileLang | TVM DSL | 中 | 中 | 中 |
关键优势: Tawa 以最低的编程工作量(Triton-Python)实现了与手写 C++ 内核相当的性能。
七、总结
核心贡献
- 提出 异步引用(aref) 抽象,表达 warp 级通信而不暴露硬件细节
- 实现 自动化编译器 Tawa,从高级 Triton 代码生成 warp 特化内核
- 在 H100 GPU 上验证,GEMM 达到 1.1× cuBLAS 加速,注意力达到 1.2× Triton 加速
- 匹配手写 CUTLASS FlashAttention-3 性能,但编程工作量大幅减少
技术影响
- 弥合了 SIMT 编程模型与现代 GPU 异步硬件之间的差距
- 为自动化的 warp 特化编译提供了 principled 的方法
- 降低了高性能 GPU 内核开发的门槛
局限性与未来工作
- 当前主要针对基于双缓冲的生产者-消费者流水线
- 未来方向:ping-pong 内核、多播通信
- 扩展到 Blackwell 架构(tensor memory 支持)
- 支持更复杂的图分区算法,考虑负载均衡、寄存器压力和内存占用
八、参考资源
- 论文: arXiv:2510.14719
- PDF: arXiv PDF
- HTML: arXiv HTML
- 技术栈: 基于 Triton 构建,约 4K 行 C++ 代码 + MLIR dialect