xLLM Technical Report
xLLM 是面向企业级大规模服务的 LLM 推理框架,采用解耦服务-引擎架构,通过动态 PD 分离、EPD 分离和多层流水线优化,吞吐量达到 MindIE 的 1.7x 和 vLLM-Ascend 的 2.2x
xLLM Technical Report
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | xLLM Technical Report |
| 作者 | Tongxuan Liu, Tao Peng, Peijun Yang, Xiaoyang Zhao, Xiusheng Lu, Weizhe Huang, Zirui Liu, Xiaoyu Chen, Zhiwei Liang, Jun Xiong, et al. |
| 机构 | JD Technology (京东科技) |
| 论文 | arXiv:2510.14686 |
| 代码 | github.com/jd-opensource/xllm |
| 发布 | 2025-10-16 (v1), 2026-03-03 (v2) |
| 许可 | 未明确 |
二、核心思想
问题定义
企业级 LLM 服务面临四大挑战:
| 挑战 | 说明 | 现有框架的局限 |
|---|---|---|
| 在线/离线混合部署 | 在线请求潮汐特征,离线任务需利用空闲资源 | 无法同时满足在线 SLO 和离线吞吐 |
| PD 分离静态分配 | Prefill 和 Decode 阶段资源固定 | 无法适应动态变化的请求负载 |
| 多模态请求处理 | 图像/视频编码与文本生成混合 | 缺乏统一的多模态调度策略 |
| 异构加速器优化 | 不同硬件(Ascend 910B/C)特性不同 | 缺乏针对性的系统和算法优化 |
解决方案概述
xLLM 采用解耦服务-引擎架构:
-
xLLM-Service:智能调度层
- 动态 PD 分离策略
- 混合 EPD 分离策略(多模态)
- 在线/离线协同调度
- 全局多级 KV Cache 管理
-
xLLM-Engine:高效推理引擎
- 多层流水线执行
- 自适应图模式
- xTensor 内存管理
- 优化推测解码
三、技术架构
整体框架图
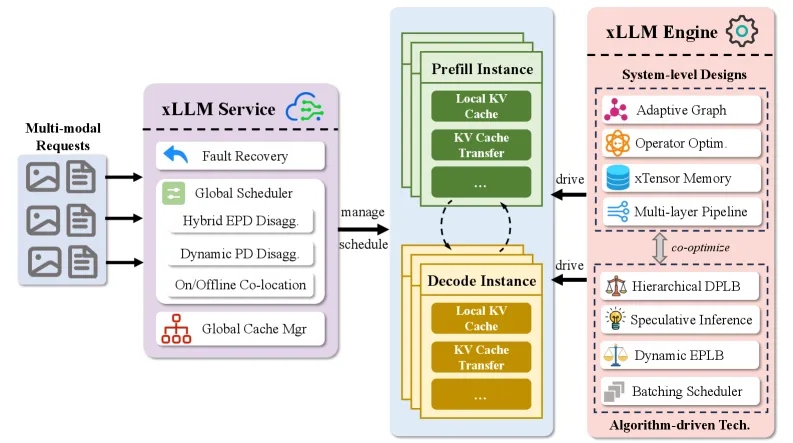
xLLM Architecture
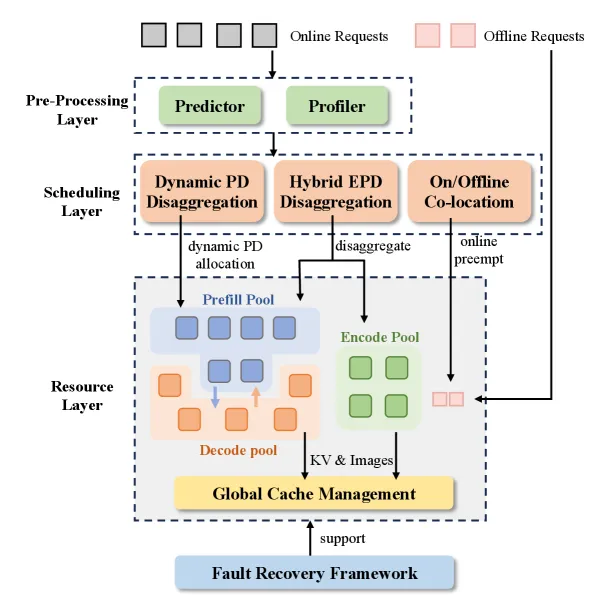
├── xLLM-Service (智能调度层)
│   ├── 预处理层
│   │   ├── TTFT Predictor (文本请求)
│   │   └── EPD Profiler (多模态请求)
│   ├── 调度层
│   │   ├── Dynamic PD Disaggregation Policy
│   │   ├── Hybrid EPD Disaggregation Policy
│   │   └── Online-Offline Co-location Policy
│   └── 资源层
│       ├── Prefill Instance Pool
│       ├── Decode Instance Pool
│       └── Encode Instance Pool
├── xLLM-Engine (高效推理引擎)
│   ├── 计算系统层
│   │   ├── Multi-layer Pipeline Execution Engine
│   │   ├── Graph Optimization for Dynamic Inputs
│   │   └── xTensor Memory Management
│   └── 算法驱动层
│       ├── Optimized Speculative Decoding
│       ├── Dynamic EPLB (Expert Parallel Load Balancing)
│       └── KV Cache-aware Scheduling
└── Global KV Cache Management
    ├── HBM-DRAM-SSD 混合存储
    ├── 智能路由策略
    └── 分布式容错
服务层工作流
动态 PD 分离策略
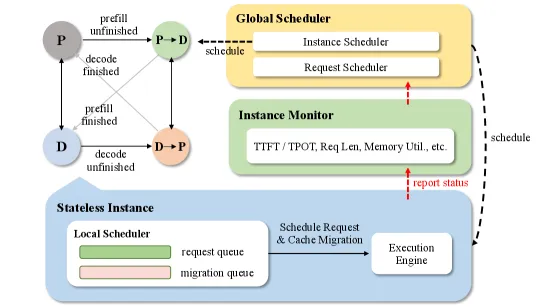
核心思想:根据请求负载动态调整 Prefill 和 Decode 实例比例
调度流程:
- TTFT Predictor 预测请求的 TTFT
- 启发式算法分配请求到合适的实例
- 持续收集性能数据,反馈调整分配决策
混合 EPD 分离策略
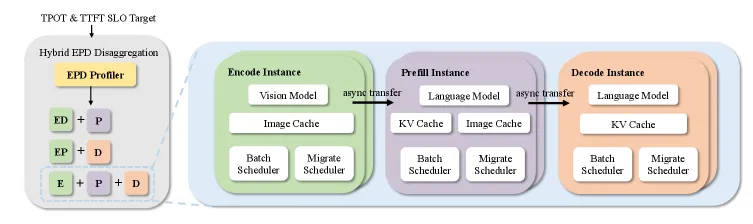
三种多模态分离策略:
| 策略 | 编码阶段 | 预填充阶段 | 解码阶段 | 适用场景 |
|---|---|---|---|---|
| EP-D | E+P 融合 | (与 E 融合) | D 独立 | 编码开销小 |
| ED-P | E+D 融合 | P 独立 | (与 E 融合) | 编码开销大 |
| E-P-D | E 独立 | P 独立 | D 独立 | 三阶段均衡 |
全局多级 KV Cache 管理
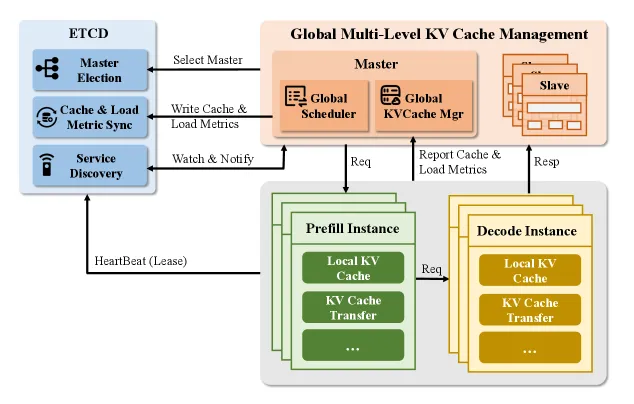
存储架构:HBM → DRAM → SSD 三级存储
智能路由:
- KV Cache 跨实例路由和复用
- 嵌入式智能路由策略
- 异步上传和卸载
多层流水线执行引擎
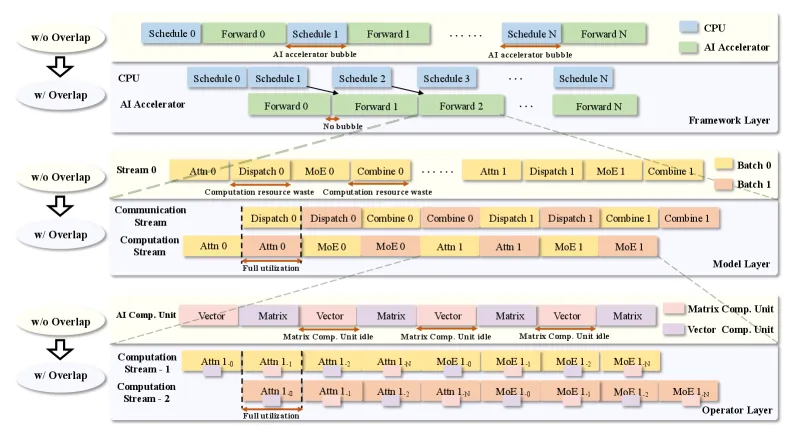
三层流水线:
| 层级 | 优化内容 | 效果 |
|---|---|---|
| 框架层 | CPU 任务异步调度 | 减少计算气泡 |
| 模型图层 | 微批次间流水线 | 计算与通信重叠 |
| 算子核层 | 不同计算单元流水线 | 计算与内存访问重叠 |
xTensor 内存管理
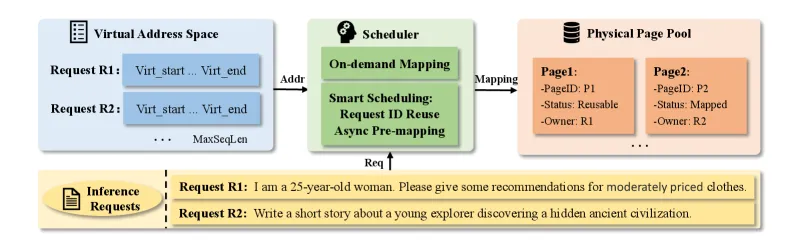
核心设计:逻辑连续、物理离散的 KV 存储
- 按需分配物理内存
- 异步预测和智能映射下一页
- 请求完成后物理内存复用
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 动态 PD 分离 | 根据负载动态调整 P/D 实例比例 | 图 4,表 3 |
| 混合 EPD 分离 | 三种多模态分离策略自动选择 | 图 5,图 22 |
| 在线/离线协同 | 抢占式调度,最大化集群利用率 | 图 3,图 23 |
| 多层流水线 | 框架/模型图/算子核三层流水线 | 图 7 |
| 自适应图模式 | 动态输入的图优化,多图缓存 | 图 8 |
| xTensor 内存 | 逻辑连续物理离散的 KV 存储 | 图 9 |
| 优化推测解码 | 异步流水线自适应推测解码 | 图 10 |
| 动态 EPLB | 实时专家负载均衡 | 图 11-12 |
五、实验结果
基准测试 - Qwen3 系列
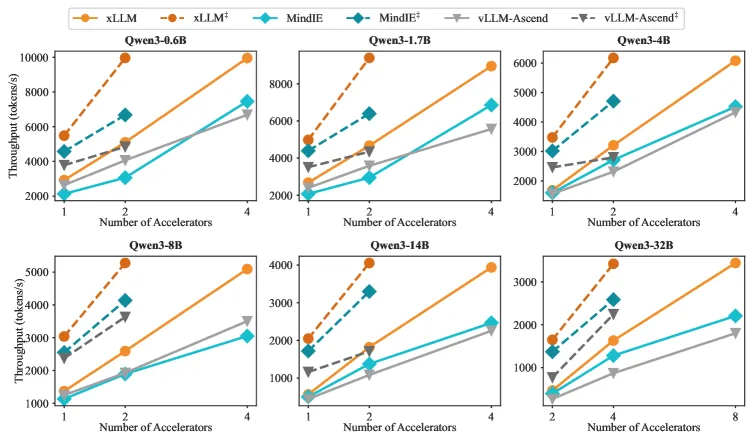
| 模型 | xLLM vs vLLM-Ascend | xLLM vs MindIE |
|---|---|---|
| Qwen3-0.6B | +1.5x | +1.3x |
| Qwen3-1.7B | +1.7x | +1.5x |
| Qwen3-4B | +1.9x | +1.6x |
| Qwen3-8B | +1.8x | +1.7x |
| Qwen3-14B | +1.7x | +1.6x |
| Qwen3-32B | +1.6x | +1.5x |
发现:xLLM 在所有 Qwen3 模型上一致超越 vLLM-Ascend (最高 1.9x) 和 MindIE (最高 1.7x)
基准测试 - DeepSeek-R1
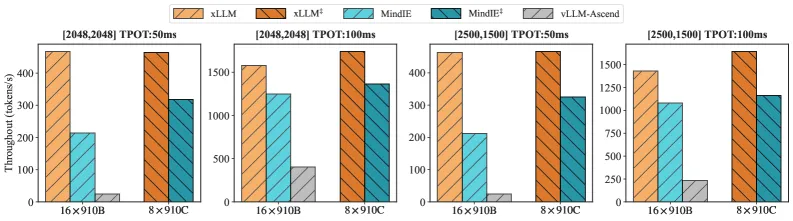
| 配置 | MindIE | xLLM | 提升 |
|---|---|---|---|
| 输入 2048, 输出 2048 | 8476.44 tokens/s | 11351.58 tokens/s | +1.34x |
PD 分离配置:xLLM 在 DeepSeek-R1 上也显著超越 MindIE
真实业务场景
| 场景 | 模型 | xLLM vs MindIE | xLLM vs vLLM-Ascend |
|---|---|---|---|
| 京东搜索 | Qwen2/3 | +1.5x | +1.8x |
| 客服助手 | Qwen3 | +1.4x | +1.7x |
| 商家助手 | Qwen3 | +1.3x | +1.6x |
| 生成式推荐 | DeepSeek-R1 | +1.7x | N/A (vLLM 不支持) |
消融实验
| 模块 | 吞吐量提升 |
|---|---|
| Multi-layer Pipeline | +25% |
| Graph Optimization | +15% |
| xTensor Memory | +10% |
| Speculative Decoding | +20% |
| Dynamic EPLB | +12% |
| 全部组合 | +70% |
六、系统配置
硬件环境
| 组件 | 配置 |
|---|---|
| AI 加速器 | Ascend 910B / 910C |
| 节点配置 | 单节点 / 多节点 PD 分离 |
| 存储 | HBM + DRAM + SSD 混合 |
模型配置
| 模型系列 | 参数规模 | 任务类型 |
|---|---|---|
| Qwen2 系列 | 7B-72B | 文本生成 |
| Qwen3 系列 | 0.6B-32B | 文本生成 |
| DeepSeek-R1 | 671B (MoE) | 推理/文本生成 |
调度配置
| 策略 | 参数 |
|---|---|
| PD 分离 | 动态调整 P/D 比例 |
| EPD 分离 | 自动选择 EP-D/ED-P/E-P-D |
| 在线/离线 | 抢占式调度 |
| KV Cache | 三级存储 (HBM-DRAM-SSD) |
七、相关工作
| 工作 | 方法 | 与 xLLM 的差异 |
|---|---|---|
| vLLM | PagedAttention | 单节点,无 PD 分离 |
| SGLang | 结构化生成优化 | 无动态调度 |
| TensorRT-LLM | 图优化 | 无服务层 |
| MindIE | Ascend 优化 | 静态 PD 分离 |
| Mooncake | KV Cache 存储 | 仅存储层 |
| DistServe | PD 分离 | 静态分配 |
八、总结
核心贡献
- 解耦架构:服务-引擎解耦,职责清晰
- 动态 PD 分离:根据负载动态调整 P/D 实例比例
- 混合 EPD 分离:三种多模态分离策略自动选择
- 在线/离线协同:抢占式调度最大化集群利用率
- 多层流水线:框架/模型图/算子核三层流水线优化
- xTensor 内存:逻辑连续物理离散的 KV 存储
- 显著性能:吞吐量达 MindIE 1.7x,vLLM-Ascend 2.2x
- 开源发布:完整框架开源
技术影响
- 企业级服务:为大规模 LLM 部署提供完整解决方案
- 异构加速器:针对 Ascend 系列深度优化
- 多模态支持:统一处理文本和多模态请求
- 资源效率:通过智能调度显著提升集群利用率
局限性
- 硬件依赖:主要针对 Ascend 加速器优化
- 部署复杂度:解耦架构增加运维复杂度
- 成本:完整部署需要较多资源
- 评估范围:主要在京东内部场景验证
- 开源成熟度:作为新开源项目,社区生态待建设
九、参考资源
- 论文: arXiv:2510.14686
- 代码: github.com/jd-opensource/xllm
- 相关工作: