LMCache: An Efficient KV Cache Layer for Enterprise-Scale LLM Inference
首个面向企业级LLM推理的开源高效KV缓存层,支持跨查询复用和PD分离架构
LMCache: An Efficient KV Cache Layer for Enterprise-Scale LLM Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LMCache: An Efficient KV Cache Layer for Enterprise-Scale LLM Inference |
| 作者 | Yuhan Liu, Yihua Cheng, Jiayi Yao, Yuwei An, Xiaokun Chen, Shaoting Feng, Yuyang Huang, Samuel Shen, Rui Zhang, Kuntai Du, Junchen Jiang |
| 论文 | arXiv:2510.09665 |
| 代码 | GitHub: LMCache/LMCache |
| 发布 | 2025-10-08 (v1), 2025-12-05 (v3) |
| 主题 | cs.DC (Distributed, Parallel, and Cluster Computing); cs.PF (Performance); cs.SE (Software Engineering) |
| 评论 | Accepted to NeurIPS 2025 |
二、核心思想
问题定义
传统LLM推理系统存在两个关键问题:
- 跨查询冗余计算:每个用户查询独立处理,相同前缀(prompt template、检索文档)被重复prefill,导致高TTFT和GPU资源浪费
- 资源利用率低:Prefill(计算密集型)和Decode(内存密集型)共存于同一引擎,GPU必须过度配置以保证解码延迟
解决方案概述
LMCache是首个也是目前最高效的开源KV缓存解决方案,支持:
- 上下文缓存(Context Caching):跨查询的KV缓存卸载和复用
- PD分离(Prefill-Decode Disaggregation):跨引擎/GPU的KV缓存传输
核心设计原则:将KV缓存视为一等数据结构(first-class data structure),而非推理的内部副产品
企业级KV缓存增长趋势
论文展示了真实的KV缓存使用统计:
- 用户存储的KV缓存总量快速增长,远超GPU内存容量
- 需要将KV缓存存储在GPU之外,实现跨查询和跨引擎复用
三、技术架构
整体架构图
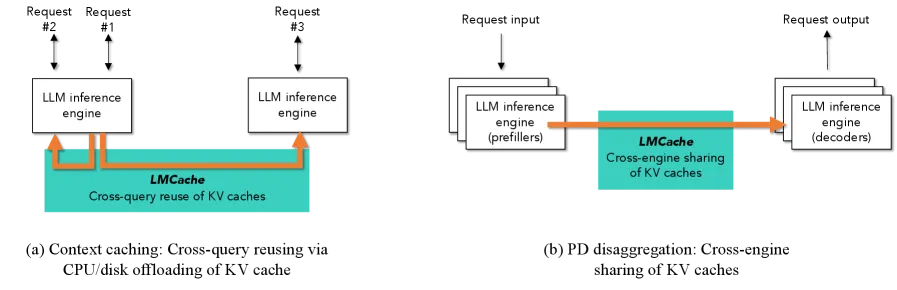
Figure 1: LMCache支持两种模式:上下文缓存(跨查询KV缓存卸载和共享)和PD分离(跨引擎KV缓存传输)。
系统层次
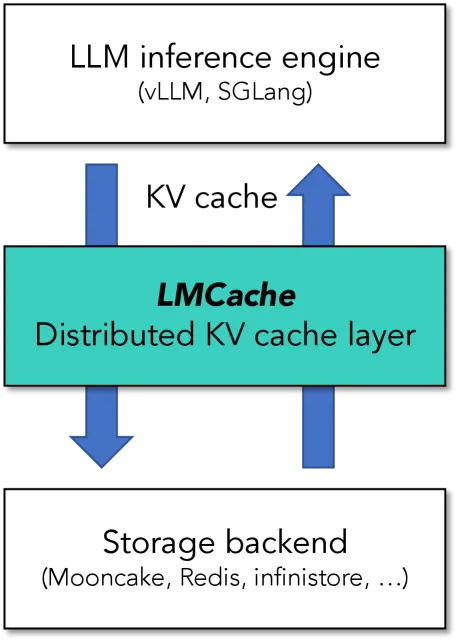
Figure 2: LMCache位于LLM推理引擎和异构存储/网络设备之间。
端到端工作流
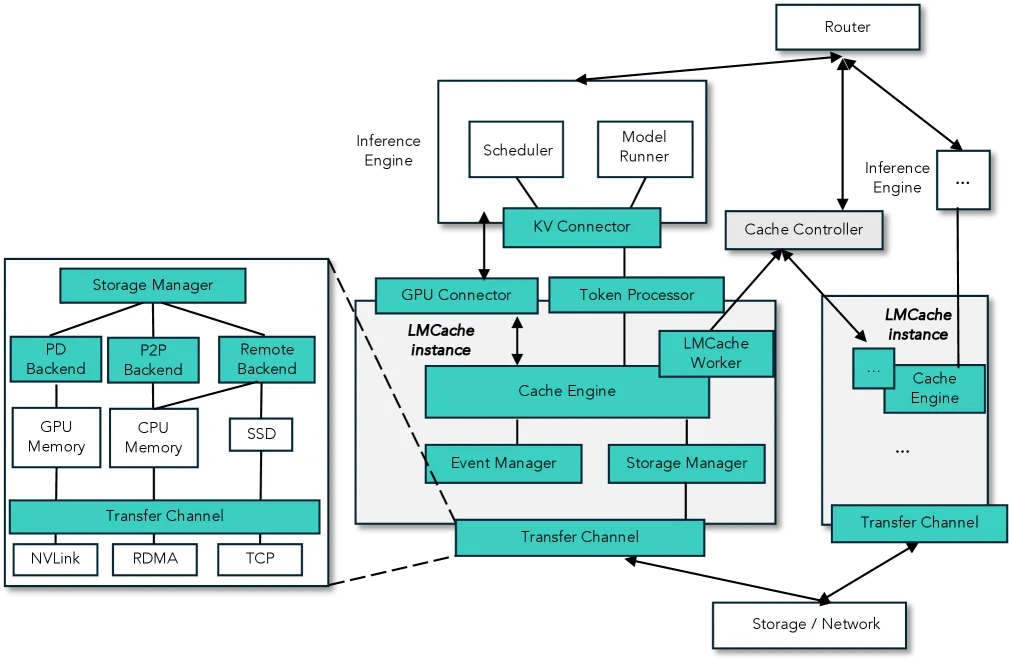
Figure 3: LMCache端到端系统工作流。
Store流程:
- 查询通过KV Connector,准备元数据(tokenized输入、GPU内存地址)
- Token Processor确定需要存储的新token数量
- Storage Manager通过Transfer Channel将KV缓存保存到后端
Retrieve流程:
- KV Connector准备元数据
- Token Processor识别已存在于后端的前缀匹配token数量
- Event Manager检查是否已缓存该查询ID
- GPU Connector将KV缓存加载回GPU内存
Lookup流程:
- Cache Controller维护token pool,记录所有存储的token
- LMCache Worker在存储/驱逐时更新token pool
核心组件
| 组件 | 功能 | 关键特性 |
|---|---|---|
| KV Connector | 引擎接口,准备元数据 | 兼容vLLM、SGLang |
| Token Processor | 确定需要存储/加载的token数量 | 前缀匹配 |
| Storage Manager | 管理后端存储操作 | 支持多级存储 |
| Event Manager | 管理异步加载事件 | 层级化加载 |
| Transfer Channel | 处理数据传输逻辑 | 批量化操作 |
| Cache Controller | 维护token pool | 全局查询接口 |
动态卸载
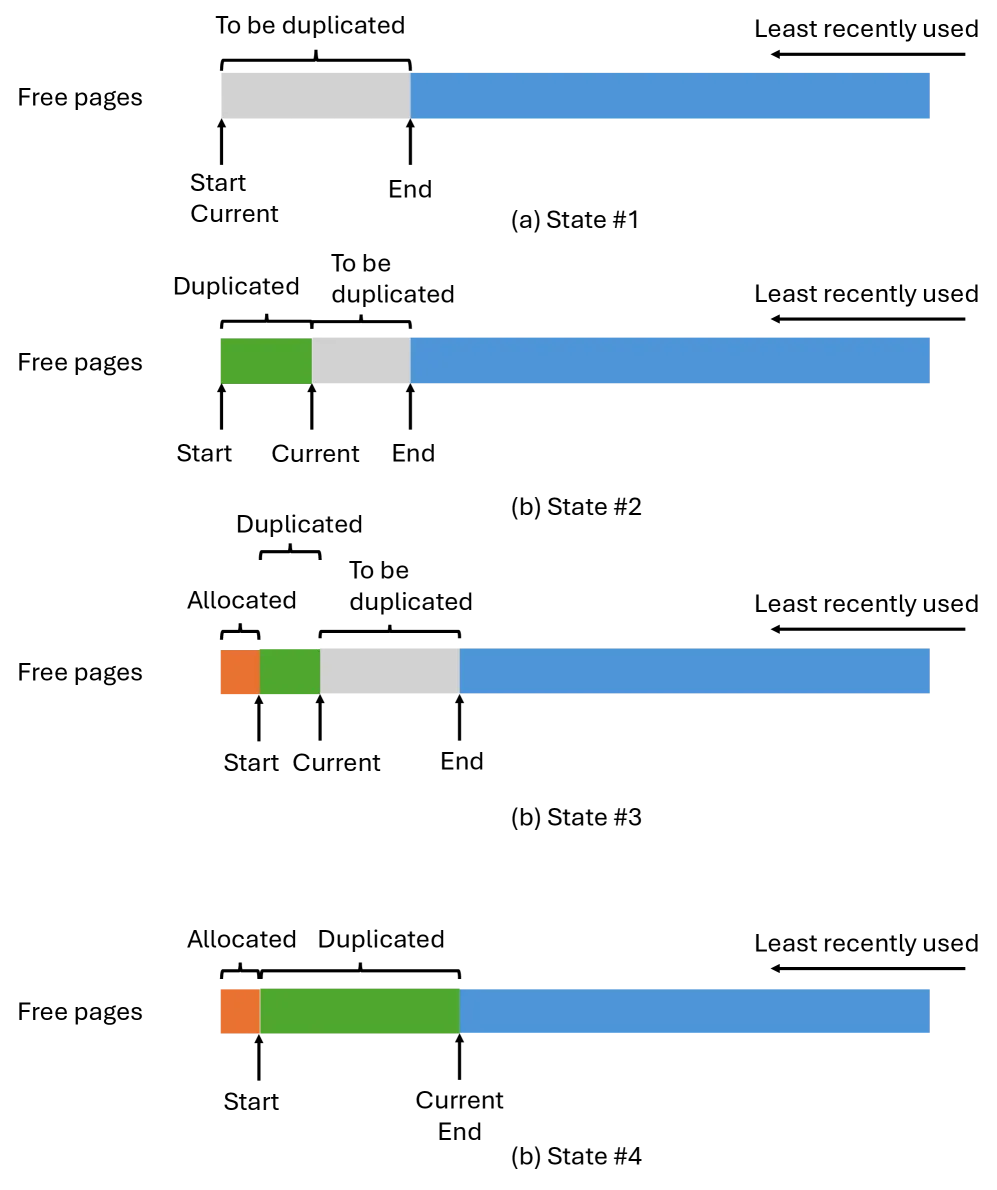
Figure 4: LMCache动态卸载示意图。
四、核心优化
1. 批量化操作(Batched Operations)
挑战:现代引擎以page粒度管理KV缓存(每page 16 tokens,20-63KB),小粒度传输效率低。
解决方案:
- 可配置Chunk大小:将多个page(默认16个)从多个层合并为更大chunk(默认256 tokens)
- 中间GPU缓冲区:存储时先复制到缓冲区,再批量卸载;加载时先获取到缓冲区,再拆分为page
- 自定义CUDA kernel:加速内存复制
批量化Store/Load:
- 支持并行传输到不同存储层(CPU内存 + 本地磁盘)
- 聚合操作,充分利用GPU到多级存储的带宽
延迟Decode KV存储:
- 聚合多个page后批量存储,避免频繁小写入
2. 计算与I/O流水线(Compute and I/O Pipelining)
挑战:KV缓存传输需要与推理并发执行。
解决方案:
- 使用独立CUDA stream执行传输,避免阻塞推理
- 层级化异步加载:逐层加载KV缓存,与计算重叠
请求异步化:
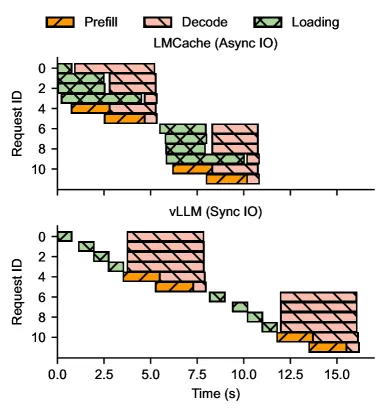
Figure 10: 通过请求异步化,LMCache将KV缓存加载与推理计算重叠。
3. 模块化KV缓存Connector
挑战:推理引擎快速演进,需要保持兼容性。
解决方案:
- 将LMCache与推理引擎解耦
- 标准化Connector接口
Connector接口:
| 函数 | 功能 |
|---|---|
insert_kv | 存储KV缓存到后端 |
load_kv | 从后端加载KV缓存 |
check_kv | 检查KV缓存是否存在 |
evict_kv | 驱逐KV缓存 |
4. 一级控制API
功能:
- 灵活的缓存编排,跨GPU、CPU、存储和网络层
- 全局token pool查询
- 容错KV缓存检索:部分失败时报告成功部分,不影响推理正确性
五、实验结果
实验设置
- 硬件:8×H100 GPU服务器(GMI Cloud提供)
- 模型:
- Llama-3.1-8B-Instruct
- Llama-3.1-70B-Instruct
- Qwen2.5-Coder-32B-Instruct
- Qwen3-Coder-480B-A35B-Instruct-FP8
- Qwen2.5-72B-Instruct
- 数据集:模拟多轮QA、LongBench、vLLM官方benchmark
- 基线:vLLM prefix caching、商业API(A、B、C)
评估场景
| 场景 | 缩写 | 网络介质 | 实际应用示例 |
|---|---|---|---|
| CPU卸载 | CPU Offload | N/A | 单节点CPU卸载 |
| 中心存储 | Central Storage | Ethernet | 集中式存储服务器 |
| PD分离 | PD | NVLink | PD分离架构 |
单节点评估
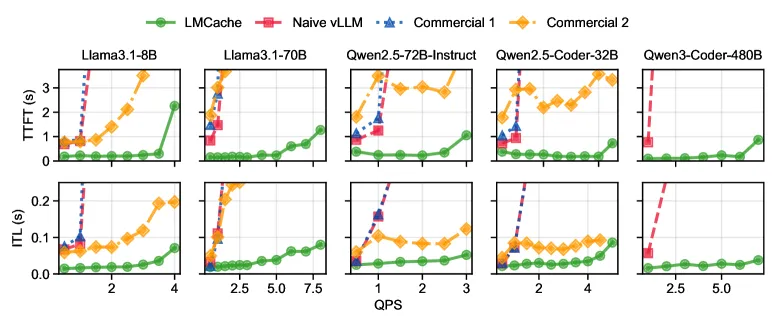
Figure 5: 单节点评估结果。
真实trace评估
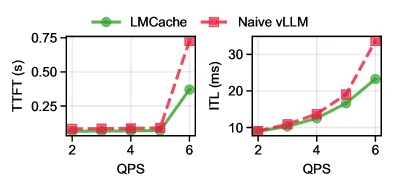
Figure 6: 真实trace评估结果。
远程后端评估
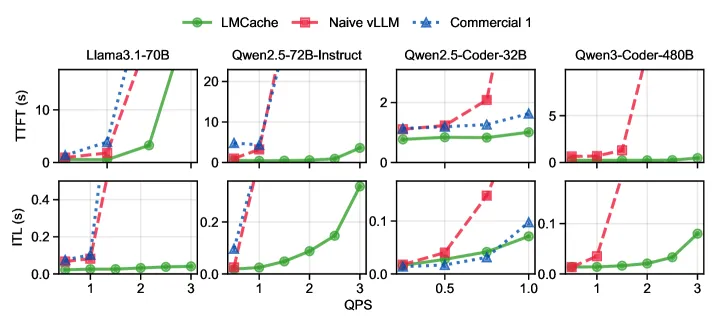
Figure 7: 远程后端评估结果。
PD分离性能
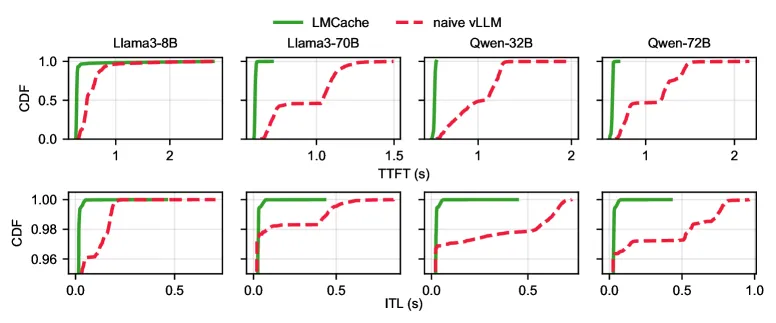
Figure 8: PD分离的TTFT和ITL CDF对比。
关键结果:
- LMCache相比vLLM原生PD分离:
- 平均TTFT降低1.53-1.84倍
- 平均ITL降低1.12-1.66倍
- 显著改善尾部延迟(95th percentile)
与SGLang CPU卸载对比
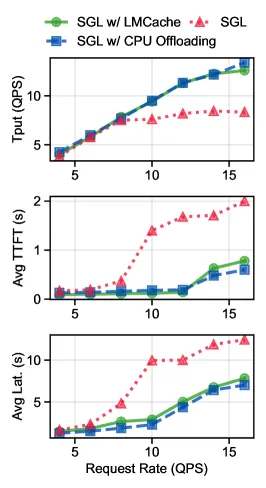
Figure 9: 与SGLang CPU卸载结果对比。
PD延迟分解
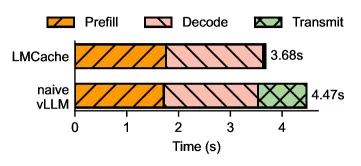
Figure 11: PD延迟分解。
上下文长度影响
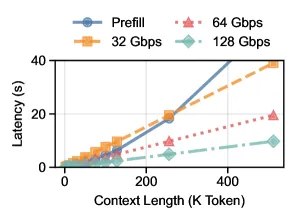
Figure 12: 不同上下文长度的影响。
吞吐量提升
关键结果:LMCache + vLLM在多轮QA和文档分析工作负载上实现高达15倍吞吐量提升。
加载带宽对比
| 方案 | 加载带宽 |
|---|---|
| vLLM原生CPU卸载 | 基准 |
| LMCache | 显著更高 |
六、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 批量化数据移动 | 合并小粒度page为大chunk传输 | 充分利用带宽 |
| 计算与I/O流水线 | 层级化异步加载与计算重叠 | 隐藏传输延迟 |
| 模块化Connector | 解耦LMCache与推理引擎 | 兼容vLLM、SGLang |
| 一级控制API | 灵活的多级缓存编排 | 跨GPU/CPU/磁盘/网络 |
| 容错检索 | 部分失败不影响推理 | 生产级可靠性 |
七、真实部署经验
KV缓存存储趋势
- 用户KV缓存总量快速增长,远超GPU内存容量
- 需要将KV缓存存储在GPU之外
远程存储的可行性
- 远程数据获取比GPU内存访问慢数个数量级
- 但实际测试表明仍能获得加速和成本节省
- 关键:远程加载可以与推理计算流水线化
上下文截断的代价
- 滑动窗口截断会降低生成质量
- 截断会将前缀缓存命中率减半
- 最佳实践:保留完整对话历史,将KV缓存卸载到更大内存层
前缀缓存命中率
- 实际生产环境中前缀缓存命中率远超预期
- 企业用户接受有损优化(如KV缓存压缩)以提升系统性能
部署挑战
- 容器化部署(Docker)是首选
- 容错和透明性至关重要
- 需要清晰分离模型服务引擎和缓存引擎
八、相关工作对比
| 方法 | 特点 | LMCache优势 |
|---|---|---|
| vLLM prefix caching | 仅GPU内存内缓存 | 支持多级存储 |
| vLLM PD分离 | page-by-page传输 | 批量化chunk传输 |
| SGLang CPU卸载 | 单一卸载路径 | 流水线化+多级存储 |
| 商业API | 专用端点 | 开源、灵活 |
九、总结
核心贡献
- 首个开源生产级KV缓存层:支持跨查询复用和PD分离
- 高性能优化:批量化操作、计算与I/O流水线、自定义CUDA kernel
- 模块化设计:与推理引擎解耦,兼容vLLM和SGLang
- 一级控制API:灵活的多级缓存编排
- 生产级可靠性:容错检索、透明故障处理
性能总结
| 指标 | 提升 |
|---|---|
| 吞吐量(多轮QA) | 最高15倍 |
| PD平均TTFT | 1.53-1.84倍降低 |
| PD平均ITL | 1.12-1.66倍降低 |
| 尾部延迟 | 显著改善 |
技术影响
LMCache展示了将KV缓存作为一等数据结构的重要性:
- 跨查询复用:避免冗余prefill计算
- PD分离:提高GPU利用率
- 多级存储:利用异构存储层次
- 流水线化:隐藏I/O延迟
生产价值
- 已被多家企业大规模采用
- 支持万亿token级部署
- 揭示了新的应用场景(推荐系统、金融分析)
十、参考资源
- 论文: arXiv:2510.09665
- 代码: GitHub: LMCache/LMCache
- 相关框架: