Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications
面向真实世界部署的 VLA 全栈综述。系统梳理 VLA 三大挑战(数据稀缺 / 具身迁移 / 算力成本)、架构演进(CNN→Transformer→VLM→Diffusion/Flow→分层控制),并给出三类核心架构(sensorimotor 7 变体 / world model 3 模式 / affordance 3 模式)、模态处理(视觉/语言/动作/音频/触觉/3D)、训练范式(SL/SSL/RL + 预训练/后训练/梯度隔离/LoRA)、数据采集(遥操作/代理设备/人类视频)、公开数据集(Ego4D/OXE/DROID/AgiBot World)、机器人平台与评测基准(LIBERO/CALVIN/ManiSkill/SIMPLER/RoboArena)。最后给出面向实践者的 6 条建议与 8 个未来方向。
Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications |
| 作者 | Kento Kawaharazuka 等(东京大学 JSK 等) |
| 通讯 | Kento Kawaharazuka(kawaharazuka@jsk.imi.i.u-tokyo.ac.jp) |
| arXiv | 2510.07077(v1) |
| 项目主页 | https://vla-survey.github.io(附按训练方法/评测/模态/数据集分类的完整引用表) |
| 分类 | 综述(cs.RO / cs.AI) |
| 定位 | 首个全栈(软件+硬件) VLA 综述,覆盖架构、模态、训练、数据、机器人平台、评测 |
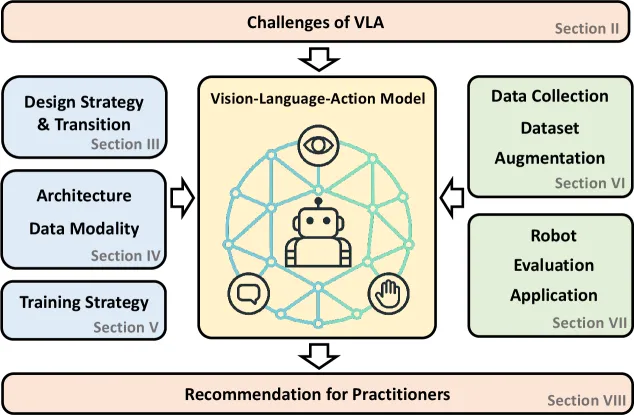
二、核心思想
问题定义:LLM/VLM 的成功正被迁移到机器人领域。Vision-Language-Action (VLA) 模型通过在规模化数据上统一视觉、语言、动作三种此前被分开研究的模态,目标是学习能在多样任务、物体、具身(embodiment)与环境间泛化的通用策略,让机器人以极少甚至零额外任务数据完成新任务,从而实现更灵活可扩展的真实世界部署。
VLA 定义(Def. I.1):以视觉观测 + 自然语言指令为必需输入(可选加入本体感受 / 深度等),直接生成控制指令产生动作的系统。仅用视觉-语言做高层推理 / 任务规划、然后从预训练技能库里选索引的方法不算 VLA。
本综述与既有综述的差异:既有综述聚焦动作 tokenization 或高层架构;本文提供全栈视角——除架构外,还系统覆盖机器人平台、数据采集策略、公开数据集、数据增强、评测基准,并给出面向实践者的落地指南。
三、三大核心挑战(§II)
| 挑战 | 说明 |
|---|---|
| 数据需求与稀缺(§II-A) | 同时对齐 视觉-语言-动作 三模态的数据规模与多样性都有限。视觉-语言数据(COCO/网络语料)缺动作 grounding;机器人示范数据语言多样性低、任务分布窄。两大瓶颈:网络/视频预训练难迁移(缺运动 grounding + 域差异);高质量遥操作示范昂贵难扩展。加入触觉/声学/3D 会进一步加剧。 |
| 具身迁移(§II-B) | 机器人具身千差万别(臂/轮/腿、关节配置、传感器、外形),各自动作空间与本体感受空间不同,跨具身迁移困难。用人类动作数据训练也非平凡——缺显式动作标签,且人类动作在形式与语义上都与机器人动作不同。 |
| 算力与训练成本(§II-C) | 多模态高维输入 + Transformer 对序列长度/输入维度的差扩展性,使适配与微调都算力密集;长时序、高分辨率、3D 点云更甚。推理端在资源受限机器人平台上还有延迟与内存约束,推动高效架构与蒸馏研究。 |
四、VLA 设计策略与演进(§III)
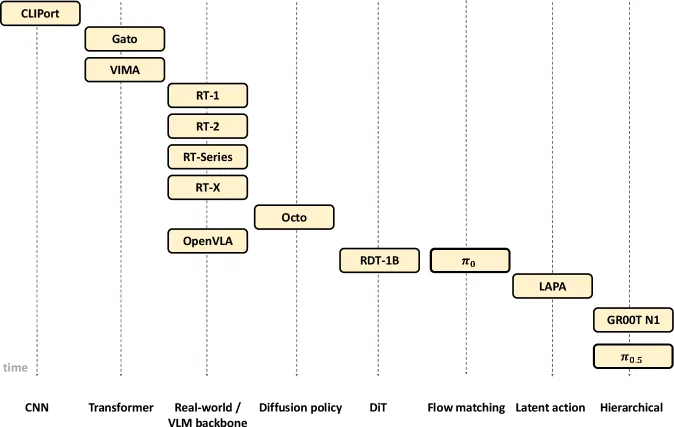
按历史进程梳理「视觉+语言 → 动作」的接口策略,每一代对应一类系统:
- 早期 CNN 端到端:CLIPort(CLIP + Transporter Network),验证了三模态联合训练可行,但 CNN/MLP 难统一多模态、难扩展。
- Transformer 序列模型:Gato(decoder-only,SentencePiece + ViT,自回归动作)、VIMA(encoder-decoder,多模态 prompt,但仅仿真)。
- 基于预训练 VLM 的真实世界统一策略:RT-1(EfficientNet + FiLM + USE + TokenLearner,非自回归离散动作,700 任务/13 万 episode,首个统一广泛任务的 VLA)→ RT-2(PaLM-E/PaLI-X 骨干,网络+机器人数据联合微调,成为主流范式)→ RT-X(多机器人数据训练更通用)→ OpenVLA(开源,Prismatic VLM / LLaMA2-7B + DINOv2 + SigLIP,OXE 全微调,成主流架构)。
- Diffusion Policy:Octo(首个用 Diffusion Policy 的 VLA,全开源)。
- Diffusion Transformer:RDT-1B(DiT 骨干,扩散过程直接嵌入 transformer,Alternating Condition Injection 交替注入图文)。
- Flow Matching:π₀(PaliGemma + action expert,flow matching,50Hz,并行输出动作 chunk)。
- 从视频学隐动作:LAPA(VQ-VAE 学离散隐动作 token,可用无标签人类视频)。
- 分层策略(最新一代):RT-H(高层预测「language motion」+ 低层动作)、π₀.₅(FAST token 高层 + flow matching 低层)、GR00T N1(融合 LAPA 隐动作 + RDT 扩散 + π₀ flow matching)。
五、核心架构与构建块(§IV)
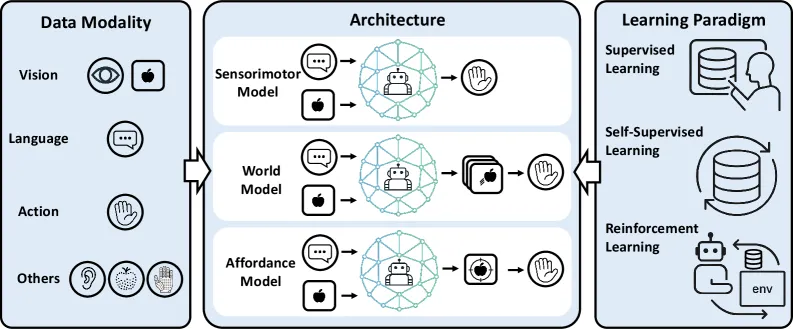
三类核心架构:sensorimotor(感知运动)、world model(世界模型)、affordance-based(可供性)。
5.1 Sensorimotor 模型 —— 7 种架构变体(§IV-A)
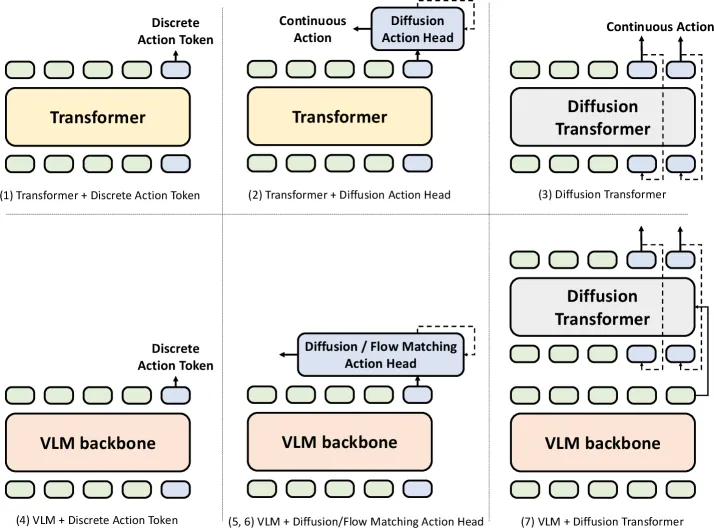
| # | 架构 | 说明 | 代表模型 |
|---|---|---|---|
| 1 | Transformer + 离散动作 token | 图文 token 进 transformer,预测离散动作(或 CLS+MLP 出连续动作) | VIMA、Gato、RT-1、Robocat、RoboFlamingo |
| 2 | Transformer + Diffusion 动作头 | 在 (1) 后接 diffusion policy,得平滑连续动作 | Octo、NoMAD、TinyVLA |
| 3 | Diffusion Transformer | 扩散过程直接在 transformer 内、以图文 token 为条件 | RDT-1B、LBM、Dita |
| 4 | VLM + 离散动作 token | 用预训练 VLM 替换 (1) 的 transformer,引入常识 + in-context 能力 | RT-2、OpenVLA、ECoT、3D-VLA |
| 5 | VLM + Diffusion 动作头 | VLM 泛化 + diffusion 平滑连续控制 | DexVLA、ChatVLA、GO-1、PointVLA |
| 6 | VLM + Flow Matching 动作头 | 以 flow matching 替换 (5) 的 diffusion,提升实时性 | π₀、GraspVLA、Hume |
| 7 | VLM + Diffusion Transformer | VLM 为高层(system 2)、DiT 为低层(system 1) | GR00T N1、CogACT、SmolVLA |
HybridVLA 结合 (4)+(5);π₀.₅ 结合 (4)+(6),在单一网络内统一离散/连续。
5.2 World Model —— 3 种模式(§IV-B)
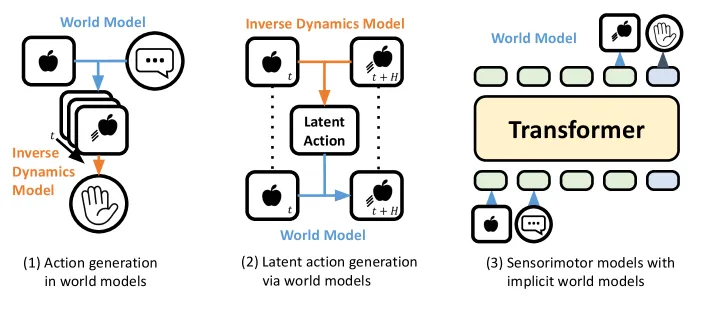
- 世界模型 + 逆动力学生成动作:先生成未来视觉观测(图/视频),再由 IDM 转低层动作。UniPi(视频 U-Net + IDM)、DreamGen、SuSIE(子目标图像)、AVDC/ATM/Track2Act(光流 / 特征点轨迹,具身无关,利于用人类视频)。
- 经世界模型学隐动作:LAPA、GO-1、Moto、UniVLA、UniSkill——从当前/未来帧对学隐动作表征,可用无动作标签的人类视频预训练。
- 隐式世界模型的 sensorimotor:同时输出动作 + 未来观测预测。GR-1(Ego4D 预训练预测未来帧)、GR-2、GR-3、3D-VLA、WorldVLA。
5.3 Affordance-based 模型 —— 3 种模式(§IV-C)
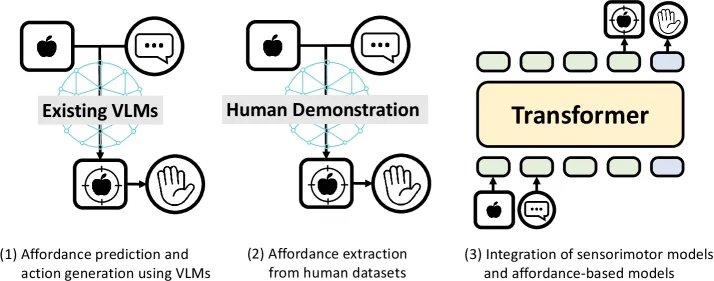
Affordance = 环境相对智能体提供的「动作可能性」(可操作属性)。
- VLM 预测 affordance 再生成动作:VoxPoser(GPT-4 + OWL-ViT + SAM 生成 Affordance/Constraint Map → MPC)、LERF-TOGO、Splat-MOVER。
- 从人类数据集提取 affordance:VRB(EPIC-KITCHENS 学接触点/手轨迹)、HRP(Ego4D)、VidBot(2D→3D,零样本部署)。
- sensorimotor 与 affordance 融合:CLIPort、RoboPoint(affordance 点)、RoboGround(mask)、RT-Affordance(关键末端位姿)、Chain-of-Affordance(自回归预测 affordance 序列)。
5.4 模态处理(§IV-D)
- 视觉:ResNet/ViT(ImageNet/LAION/MAE 预训练);CLIP/SigLIP/DINOv2(SigLIP 与 DINOv2 已成首选);VQ-GAN/VQ-VAE 离散化;Perceiver Resampler / Q-Former / TokenLearner 压缩 token;object-centric 特征(Mask R-CNN、OWL-ViT、SAM、GroundingDINO)。
- 语言:沿用骨干 tokenizer(T5/LLaMA)或 BPE/SentencePiece;文本编码 USE/CLIP Text/Sentence-BERT;VLM 骨干 LLaMA2/Vicuna/Gemma/Qwen2/Phi 等。
- 动作表征 4 类:① 分箱离散 token(常 256 bin,RT-2/OpenVLA;FAST 用 DCT+BPE 压缩);② token→MLP 连续动作(L1/L2,OpenVLA-OFT 建议 L1 + 多步 chunk);③ diffusion/flow matching 连续建模(Octo/π₀,DDPM/DDIM);④ 从网络视频学隐动作(LAPA/Moto/UniVLA/UniSkill)。
- 跨具身动作:OXE 首次标准化(单相机 + 语言 + 7-DoF);CrossFormer(模态专属 tokenizer + 共享 decoder + 具身专属动作头);UniAct(Universal Action Space 离散码本)。
- 额外模态:音频(Unified-IO 2、FuSe、VLAS;spectrogram + AST/Whisper,或 ASR 转文本);触觉(DIGIT/GelStereo 图像式,TVL 模型;ForceVLA 用 6 轴力矩 + force-aware MoE);3D(深度图 Depth Anything/ZoeDepth + SpatialVLA Ego3D 编码;多视图 3D-VLA/Evo-0/RoboUniView;体素 OccLLaMA;点云 PointNet++ / Uni3D ViT)。
5.5 新兴技术(§IV-E)
- 分层架构:Atomic Skill/LMM-3DP(VLM 高层拆子任务 → VLA 低层执行)、Hi Robot(训练自定义高层)、RT-H/LoHoVLA(单网络联合训练高低层,靠切换 prompt)、π₀.₅(统一拆解+离散+连续);FiS-VLA/OpenHelix/DP-VLA 用隐空间连接高低层。
- Chain-of-Thought 推理:ECoT(自回归预测任务描述/子任务/物体位置再出动作)、CoT-VLA(生成子目标图像);ECoT-Lite / Fast ECoT 降低推理延迟。
六、训练策略与实现(§V)
6.1 监督学习(§V-A)
多为「图-语-动」三元组上的监督学习,常表述为 next-token 预测;动作损失依动作头(MLP/diffusion/flow)而定。通常两阶段:预训练(预训练 VLM 骨干 + 全微调,人类示范/异构机器人示范/规划 VQA)→ 后训练(任务/机器人专属高质量小数据,全微调 or 仅动作头)。ICRT 展示 in-context VLA(1–3 条遥操作示范做 prompt 零样本推断)。
6.2 自监督学习(§V-B)
三用途:模态对齐(TRA 对比学习对齐当前/未来状态)、视觉表征学习(MAE/CLIP/DINOv2 作视觉编码器)、隐动作表征学习(从初始/目标图像抽隐动作,重建目标图像,可扩展到无标注数据)。
6.3 强化学习(§V-C)
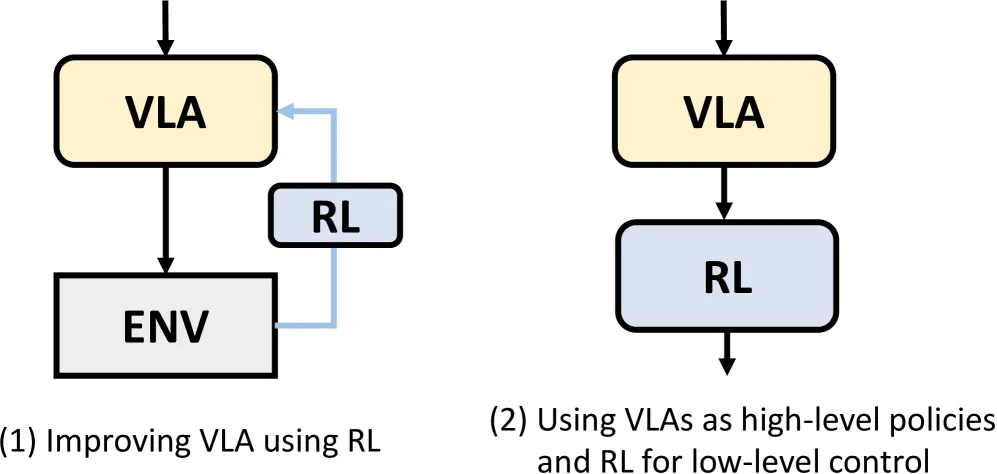
- 用 RL 提升 VLA:iRe-VLA(SFT + 在线 RL + 再 SFT 循环)、ConRFT、VLA-RL(RPRM 稠密伪奖励)、RLDG、MoRE(MoE + RL)、RLRC(剪 90% 参数 + SFT + RL)。DSRL 在 diffusion policy 的隐噪声空间做 RL,不更新底层 VLA 参数,仅用 10K 样本把 π₀ 成功率从约 20%→近 100%。
- VLA 做高层 + RL 做低层控制:Humanoid-VLA、NaVILA(RL 转速度指令为力矩)、SLIM(RL 教师蒸馏为 student VLA)、RPD(VLA 引导 RL 探索)。
局限:多数 RL 工作仍限于仿真或简化真实场景(样本低效、不安全探索、算力低效)。
6.4 训练阶段与稳定性技巧(§V-D)
- 数据规模与来源:π₀(数百万真实轨迹)、π₀.₅(+ COCO/VQA + 多任务辅助损失)、GR00T N1(OWL-ViT 弱监督 bbox + 人类第一视角视频隐动作 + COSMOS 世界模型合成轨迹)。
- VLM 骨干谱系:PaLM-E/PaLI-X(RT-2)、PaliGemma(π₀/π₀.₅)、PrismaticVLM(OpenVLA/CogACT)、Qwen2.5-VL、LLaVA、Gemini 2.0(Gemini Robotics)等——骨干高度多样化。
- 梯度隔离(gradient insulation):阻断动作头梯度流入 VLM 骨干,防止随机初始化动作头破坏预训练表征,显著提升稳定性与效率(GR00T N1.5 直接冻结整个 VLM;RevLA 渐进反转权重防遗忘)。
- 冻结 vs 全微调权衡:算力效率、域适配、性能-资源、知识保留四维取舍;LoRA 是折中方案(OpenVLA 证明 LoRA 可在消费级 GPU 上达到有竞争力性能);BitVLA 蒸馏量化视觉编码器至 1.58 bit。
6.5 推理加速(§V-E)
- Real-Time Chunking (RTC):异步动作生成,固定已执行动作 + soft masking 保时序一致 + 动态重规划。
- DeeR-VLA:逐层预测动作,相邻层差异小则跳过剩余层。
- VLA-Cache:识别静态 token 复用早期特征。
七、数据集(§VI)
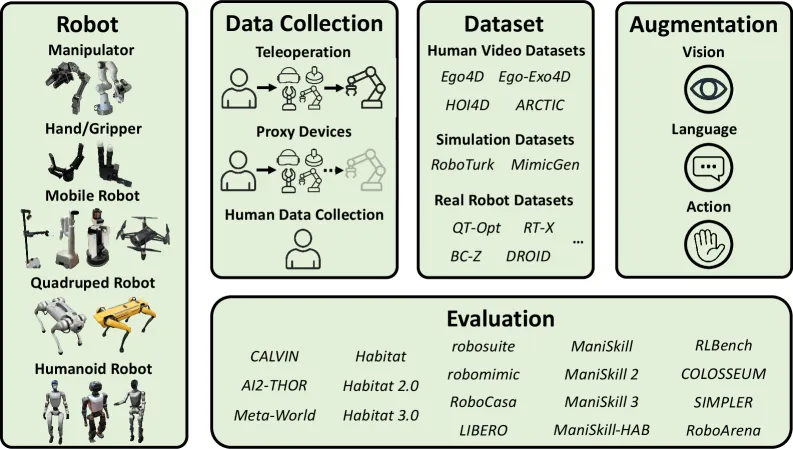
7.1 数据采集(§VI-A)
- 遥操作:ALOHA(leader-follower 双臂)、Mobile ALOHA、ALOHA 2/Unleashed、GELLO;AnyTeleop(单 RGB + MediaPipe)、Open-Television/Bunny-VisionPro(Apple Vision Pro)。
- 代理设备:UMI(手持 GoPro 夹爪 + 视觉 SLAM)、DexUMI(五指手 + 外骨骼手套)、Dobb-E/RUMs、DexCap/DexWild。
- 人类数据采集:头戴 GoPro/Project Aria 采集第一视角(Ego4D、EPIC-KITCHENS、Ego-Exo4D);EgoMimic/EgoZero 直接从人类示范学控制。
- 采集管线:RT-1 大规模真机采集、RoboTurk(iPhone 众包);语言标注 Language Table(约 60 万条)、DROID(18 机构 7.6 万轨迹);VLM 自动标注(ECoT/EMMA-X/NILS/RoboMIND)。
7.2 公开数据集(§VI-B)
- 人类数据集:Ego4D(3000+ 小时,800+ 人,9 国 74 城)、EPIC-KITCHENS、HOI4D、OAKINK2、Aria Everyday Activities,多经 LAPA 式隐动作预训练使用。
- 仿真数据集:RoboTurk(MuJoCo)、MimicGen/DexMimicGen(少量示范生成大规模)、COSMOS 视频世界模型。
- 真机数据集:MIME、QT-Opt(58 万抓取)、RoboNet(16.2 万,7 种机器人)、BridgeData/V2、RT-1(13 万,13 台 Google Robot,17 个月)、RH20T(多模态含力矩/音频)、OXE(21 机构 173 作者,RLDS 统一格式,最广泛采用)、DROID(7.6 万,标准化硬件)、FuSe(多模态含触觉)、RoboMIND(10.7 万,多具身)、AgiBot World(100 万轨迹,100+ AgiBot G1)。
7.3 数据增强(§VI-C)
- 视觉:具身感知增强(CACTI/GenAug/ROSIE 用 Stable Diffusion 改纹理/背景/干扰物)、DreamGen(视频世界模型 + IDM)、BYOVLA(运行时 inpaint 无关区域)。
- 语言:DIAL(VLM + LLM 生成/匹配指令改写)。
- 动作:DAgger(迭代收集专家动作)、CCIL(学局部平滑动力学生成纠正数据)。
八、真实世界机器人应用(§VII)
8.1 机器人平台(§VII-A)
- 机械臂(最常用):Franka Panda、UR5/5e、Kinova、Sawyer、KUKA iiwa、xArm、WidowX/ViperX、SO-100/101(多为 5/6/7 DoF;ALOHA/ARX 等双臂;WidowX/ViperX/ALOHA/SO-100 全开源硬件)。
- 手/夹爪:Shadow Hand、LEAP Hand(4 指)、Robotiq 2F/UMI(2 指)、Inspire RH56(5 指);两指宜抓取、四五指宜工具使用与手内操作。
- 移动机器人:Jackal/TurtleBot(纯轮式)、Hello Stretch/Google Robot/LoCoBot、Mobile ALOHA/PR2/AgiBot G1(移动操作)。
- 四足:Unitree A1/Go1/Go2/B1、Boston Dynamics Spot、ANYmal(RL 控制,可加装机械臂)。
- 人形:Fourier GR-1、Unitree G1/H1、Booster T1(human-like 形态利于人类环境与人类动作数据集)。
8.2 评测基准(§VII-B)
| 引擎 | 代表基准 |
|---|---|
| MuJoCo | robosuite、robomimic、RoboCasa、LIBERO(4 套件 130 任务,最广泛使用)、Meta-World |
| PhysX | IsaacLab、LeVERB-Bench(人形全身)、ManiSkill(SAPIEN)、RoboTwin(双臂 50 任务) |
| Bullet | Ravens、VIMA-BENCH、CALVIN(长时序语言指令 34 任务)、Habitat 1/2/3 |
| V-REP | RLBench(100 任务)、THE COLOSSEUM(14 类扰动) |
| Unity | AI2-THOR(iTHOR/RoboTHOR/ProcTHOR)、SPOC |
真实化与可扩展评测:SIMPLER(缩小仿真-真实视觉/控制差,高相关性)、RoboArena(7 所大学分布式真机成对比较,中心服务器聚合全局排名,基于 DROID)。评测指标在真实场景仍定义不清(具身差异、安全、可复现性差)。
8.3 真实应用示例(§VII-C)
- 机械臂:Shake-VLA(双臂调酒)、RoboNurse-VLA(手术器械交接)。
- 手/夹爪:GraspVLA(两指抓取)、DexGraspVLA(多指精细抓取)。
- 移动/空中/自驾:RT-1(臂+底盘)、UAV-VLA/RaceVLA(无人机)、OpenDriveVLA/CoVLA(自动驾驶)。
- 四足:TrackVLA/NaVILA(野外导航)、SLIM(Go1 + WidowX 越野抓取)。
- 人形:EgoVLA、GO-1(家务:拾放/倒/折叠)。
九、面向实践者的建议(§VIII)
- 优先多样化高质量数据集:广任务覆盖 + 环境多样 + 具身多样,是泛化与迁移的基础。
- 偏好生成式连续动作(diffusion / flow matching):优于离散 token,得平滑精确控制。
- 预训练时尝试梯度隔离:冻结骨干或阻断动作头梯度,保护常识表征、提升效率与最终性能。
- 从轻量适配起步:无 GPU 集群时先只微调动作头 / 用 LoRA。
- 引入世界模型或隐动作学习提升可扩展性:人形机器人尤其可用人类视频(学隐动作作代理目标);世界模型利于长时序规划。
- 拥抱多任务学习增强动作生成表征:辅助任务(affordance 估计、关键点检测、未来状态预测、分割)让表征更贴合控制需求。
十、未来研究方向(§IX)与总结
8 个未来方向:
- 数据模态:音频/触觉/3D 大规模数据仍稀缺;触觉传感器缺标准化亟需统一。
- 推理:长时序任务需记忆维持与检索(如「先记货架位置,绕路取杯,再返回放置」)。
- 持续学习:模型训练后即冻结,需在线/持续学习,但面临灾难性遗忘与安全部署难题(RLHF、主动学习可能是路径)。
- 强化学习:多限仿真;在学到的世界模型内微调 + real-to-sim 数字孪生是更安全高效的方向。
- 安全:非结构化环境缺人类闯入检测;需与 model-based 控制混合架构。
- 失败检测与恢复:多数系统把失败当终止事件;SAFE / Agentic Robot / LoHoVLA(分层重规划)/ FOREWARN(世界模型预测选最优行为模式)开始填补。
- 评测:缺统计严谨性(LBM 强调足够试验数 + 置信区间)。
- 应用:医疗/助老/工业/自驾潜力大,但鲁棒性与可靠性尚不足以实际部署。
核心结论(§X):
- 大规模数据集与预训练基础模型是泛化关键;
- 分层架构(高层推理 / 低层控制分离)兴起;
- 视觉-语言之外的多模态愈发重要;
- sim-to-real 迁移与跨具身泛化仍是持续挑战。
- 世界模型、affordance 推理、RL 有望支撑下一代 VLA,实现持续学习、复杂任务推理与真实环境鲁棒适配。
十一、参考资源
- arXiv 论文:https://arxiv.org/abs/2510.07077
- 项目主页(分类引用表):https://vla-survey.github.io
- 图片索引:
figures/2510.07077-vla-robotics-survey/README.md