TetriServe: Efficiently Serving Mixed DiT Workloads
TetriServe 针对异构分辨率、紧 SLO 的 Diffusion Transformer 在线服务,首创 step-level sequence parallelism:把连续时间轴离散为固定长度轮次,先用剖析驱动的成本模型为每个请求求最小 GPU-hour 分配以满足 deadline,再以'避免必迟到'为目标做请求打包。相较固定 SP baseline,SLO Attainment Ratio 最高提升 32%,覆盖 FLUX.1-dev 与 SD3、H100 与 A40,稳定应对突发流量。
TetriServe: Efficiently Serving Mixed DiT Workloads
一、论文概述
| 字段 | 内容 |
|---|---|
| 标题 | TetriServe: Efficiently Serving Mixed DiT Workloads |
| 作者 | Runyu Lu, Shiqi He, Wenxuan Tan, Shenggui Li, Ruofan Wu, Jeff J. Ma, Ang Chen, Mosharaf Chowdhury |
| 机构 | University of Michigan (SymbioticLab / UsesysLab);共同作者含 Mosharaf Chowdhury(Michigan) |
| 论文链接 | https://arxiv.org/abs/2510.01565 |
| HTML | https://arxiv.org/html/2510.01565v1 |
| https://arxiv.org/pdf/2510.01565 | |
| 发布 | 2025-10-02(v1),2026-06-18(v4,本次分析基于 v1) |
| 分类 | cs.LG(primary)、cs.DC |
| 系统别名 | TetriServe |
二、核心思想
问题定义
Diffusion Transformer(DiT)是 SD3、FLUX.1-dev、Sora 等文生图/视频服务的骨干。DiT 推理与 LLM 有三大不同:
- 无状态:不需要 KV cache。
- 计算受限:多步 denoising 每步作用于完整 latent 序列。
- 模型小:最大开源 DiT ~12B 参数,单张 H100 装得下。
在线服务下 (i) 请求分辨率异构(256/512/1024/2048),(ii) SLO 严格且不同(1.5–5 秒),(iii) 高分辨率单卡耗时可达分钟级 — 依赖并行才能达标。主流 xDiT 使用 固定度 sequence parallelism (SP):小图 SP=1/2 效率高但大图慢;大图 SP=4/8 加速但小图通信开销过大。DiT 又是非抢占,一旦以某 SP 启动就占据 GPU 到结束。
论文观察:step-level scheduling(在同一 request 的不同 denoising step 之间调整并行度)可显著提高效率;但作者证明该问题为 NP-hard。
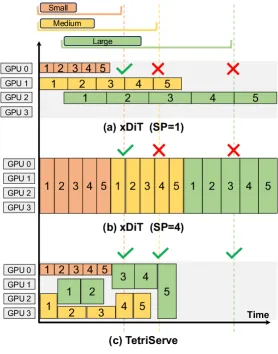
解决方案概述
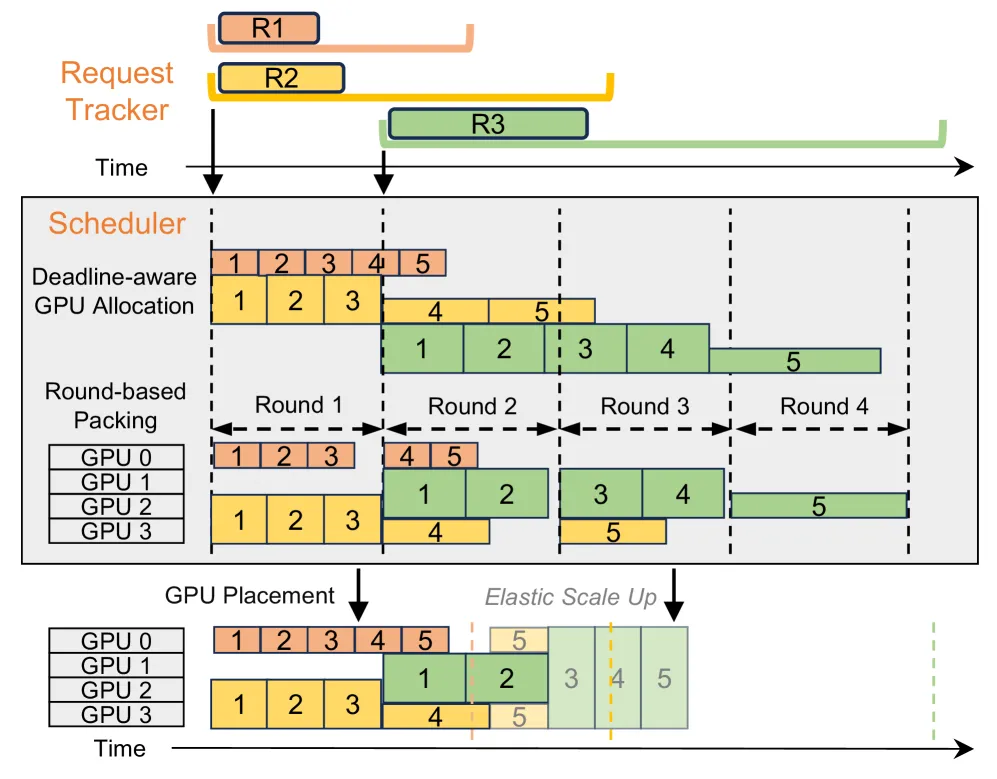
TetriServe 使用 round-based deadline-aware scheduler:
- 把连续时间离散为固定长度 的轮次;
- 每轮内 (i) 用离线剖析的成本模型为每个待处理请求求”最小 GPU-hour 且满足 deadline”的 step 分配;(ii) 以”避免必迟到”为目标做请求打包,最大化幸存到下一轮的请求数。
三、技术架构/方法
DiT 工作负载特性
- 分辨率离散:{256, 512, 1024, 2048},latent tokens 对应 {1024, 4096, 16384, 65536},TFLOPs 从 556 到 24964,跨度 45×。
- 执行高度稳定:100 次运行的 CV 均 < 0.7%(即使不同 SP)——可预测。
- SP 采用 Ulysses attention(NVLink 高带宽下最优)或 Ring attention。
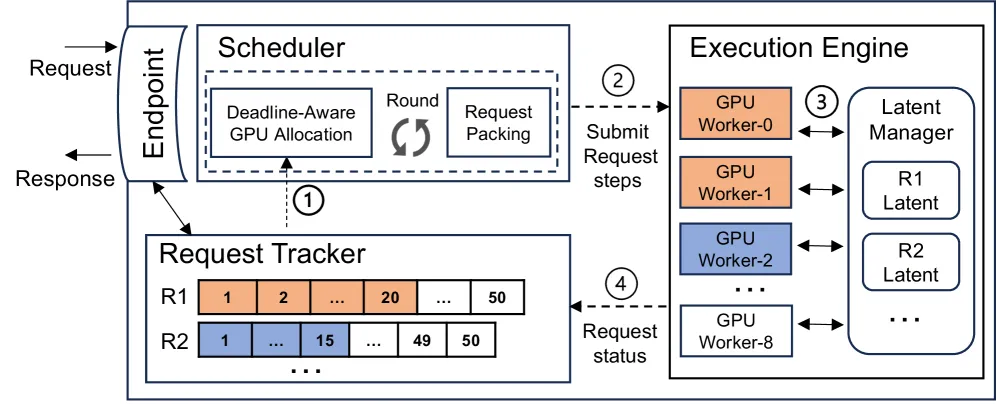
系统组件(Figure 4)
- Request Tracker:分辨率、deadline、剩余步数元数据。
- Scheduler:deadline-aware GPU 分配 + round-based 请求打包(C++ 实现毫秒级 control-plane)。
- Execution Engine:分布式 GPU worker 池,执行 diffusion step。
- Latent Manager:跨步 latent tensor 异步 Future 传输,忽略计入 deadline。
问题形式化(Section 4.1)
GPU 集群、 个请求,每个请求 个依赖 step;step 用 (2 的幂)个 GPU 执行时间 。完成时间:
目标:
受 (1) step 依赖、(2) 任意 t 时刻总 GPU 分配 约束。作者将单步特例 () 转化为 Zero-one ILP 证明 NP-hard;因此多步 DiT serving 亦 NP-hard。
Round-Based Scheduling(Section 4.2)
将时间离散为固定 的轮次。每轮:
Deadline-Aware GPU Allocation
对每个 request,最小化总 GPU-hour 同时满足 deadline:
- 用 离线剖析 的 建 lookup table;
- 输出每 request 一组 pairs:以分配 执行 步。
Request Packing
给每个 request 选择一个选项 ,本轮可完成的 step 数:
更新剩余步:。
必迟到判定:用最快步时 ,估下界
request 在下轮开始 后仍可存活当且仅当 。
选项 占用 GPU 数 ( none 时为 0)。轮内规划问题:为每个 request 至多选一个 option,,最大化幸存 request 数。
工程实现要点
- 5033 行 Python+C++,复用 xDiT / vLLM / MuxServe / SGLang 组件。
- VAE Decoder 顺序执行:VAE 时间小但激活内存大,串行避免 concurrent activation。
- 通信组预热:为 组合仅预热常用重叠子集(如 [0,1,2,3]、[0,2,3,4]),其他按需,平衡启动延迟与 HBM 压力。
- Selective Continuous Batching:仅当 SLO 不受损时才批同分辨率小图。
四、核心创新
| # | 创新点 | 说明 |
|---|---|---|
| 1 | Step-level Sequence Parallelism | 首次把 SP degree 变成 step 级动态量,在同一 request 内部改变并行度 |
| 2 | Round-Based Scheduler | 把连续时间离散为 τ 轮次,让 NP-hard 问题在毫秒级 tractable |
| 3 | 最小 GPU-hour 分配 | 用剖析 lookup + deadline 约束找每 request 最省 GPU-hour 的 (step, SP) 序列 |
| 4 | ”避免必迟到” 打包目标 | 用 下界筛选,把 packing 变成幸存最大化的规划 |
| 5 | 系统工程亮点 | VAE 串行、process group 预热子集、Latent Future、C++ 控制面 |
五、实验结果
环境
- 测试床:8× H100-80GB HBM3 (NVLink 4.0, 900 GB/s);4× A40-48GB (NVLink pair + PCIe 4.0)。
- 软件:CUDA 12.5、NCCL 2.22.3、PyTorch 2.4.0、xDiT。
- 模型:FLUX.1-dev(H100)、SD3 Medium(A40)。
- 数据:DiffusionDB 抽 300 prompts;Poisson 到达,默认 12 rpm。
- Workload:Uniform(各分辨率等概率)与 Skewed(按 偏向大图)。
- SLO:分辨率相关 baseline (256=1.5s, 512=2s, 1024=3s, 2048=5s),扫描 1.0×–1.5× SLO scale。
- Baseline:xDiT with SP∈{1,2,4,8}。
End-to-End SLO Attainment (Section 6.2)
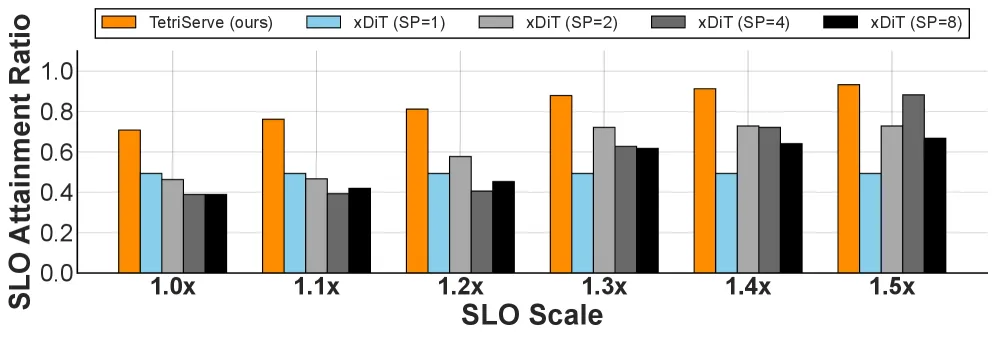
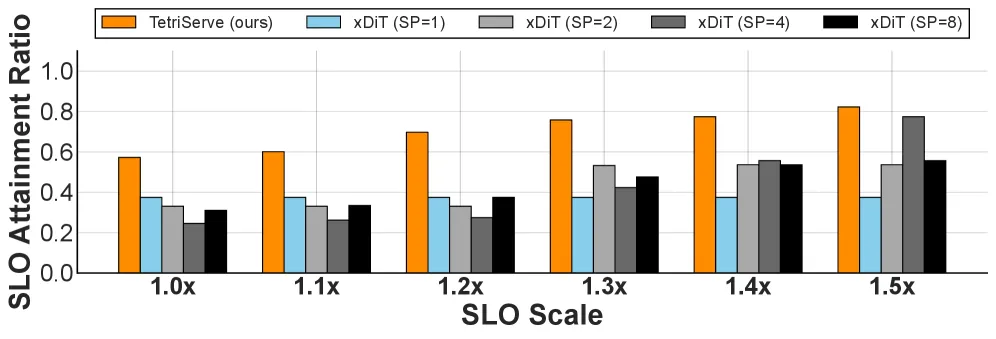
Uniform 混合:TetriServe 平均比最优固定 SP 高 10%;SLO scale 1.1× 时高 28%。
Skewed 混合:平均高 15%;SLO scale 1.2× 时高 32%(最大提升)。
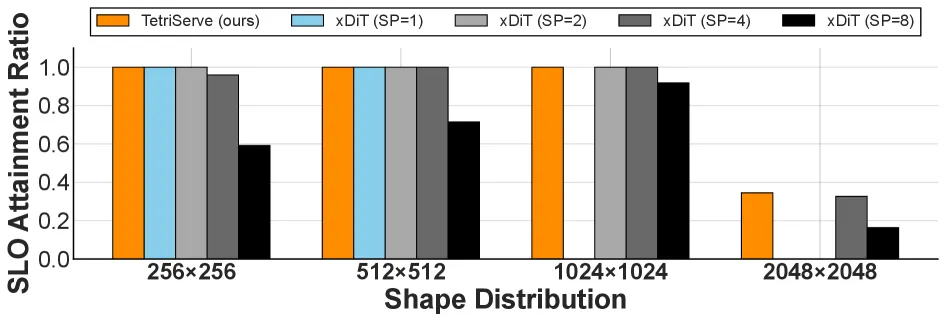
- 松 SLO(1.5×):TetriServe 全分辨率接近 100% SAR。
- 紧 SLO(1.0×):TetriServe 在总体最优;固定 SP 在个别分辨率上略优但其他分辨率大幅落后。
Burst 稳定性 (Section 6.3)
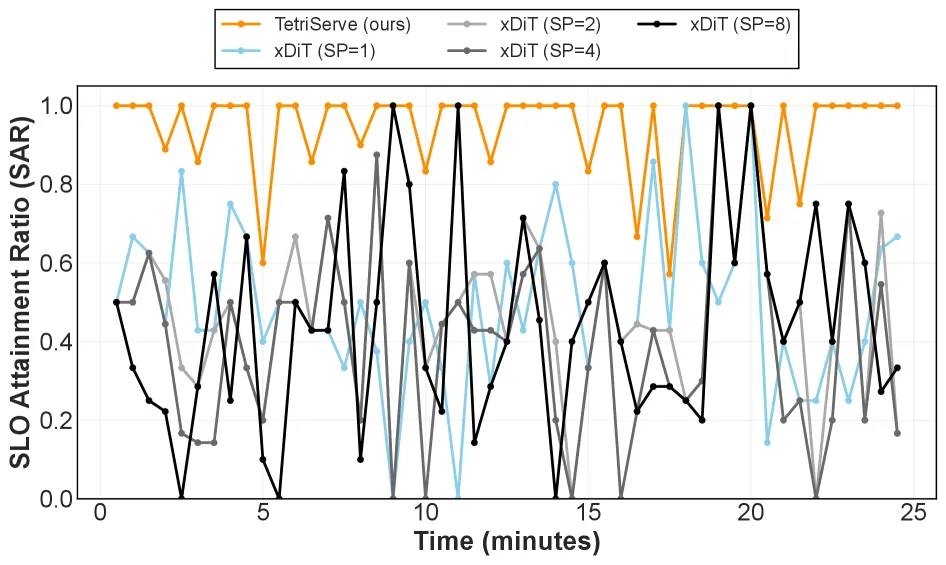
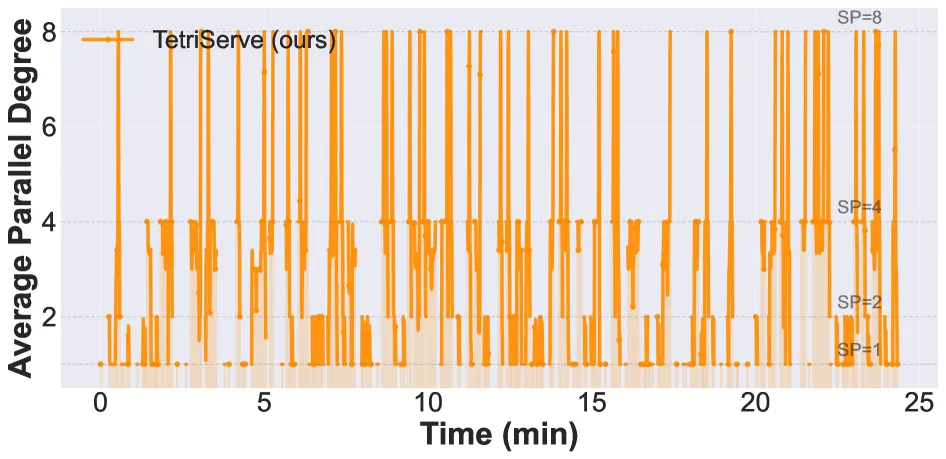
Uniform 12 rpm、1.5× SLO 下:TetriServe SAR 时序平稳;固定 SP 出现周期性掉落(utilization bubbles)。Figure 9 显示 TetriServe 在拥塞时动态提升紧急请求的 SP,非紧急请求降低 SP。
敏感性分析 (Section 6.4)
- 不同模型/GPU:SD3 on A40:Uniform / Skewed 上 TetriServe 均领先;A40 pair NVLink 导致 SP=4 通信跨 PCIe,固定 SP 表现更差。
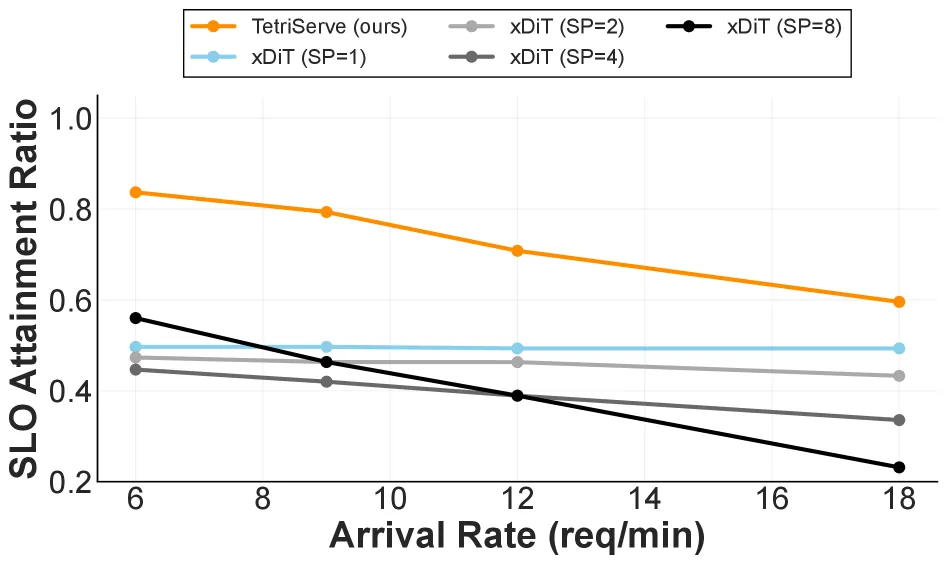
- 到达速率:6–18 rpm 全范围 TetriServe 优于 baseline,具有 graceful degradation。
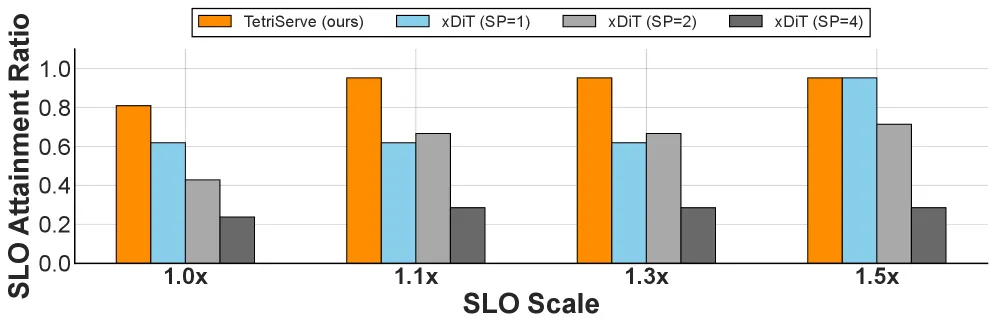
- 同质工作负载:单分辨率也依然领先(Figure 12),说明 step-level 动态性对同分辨率场景亦有效。
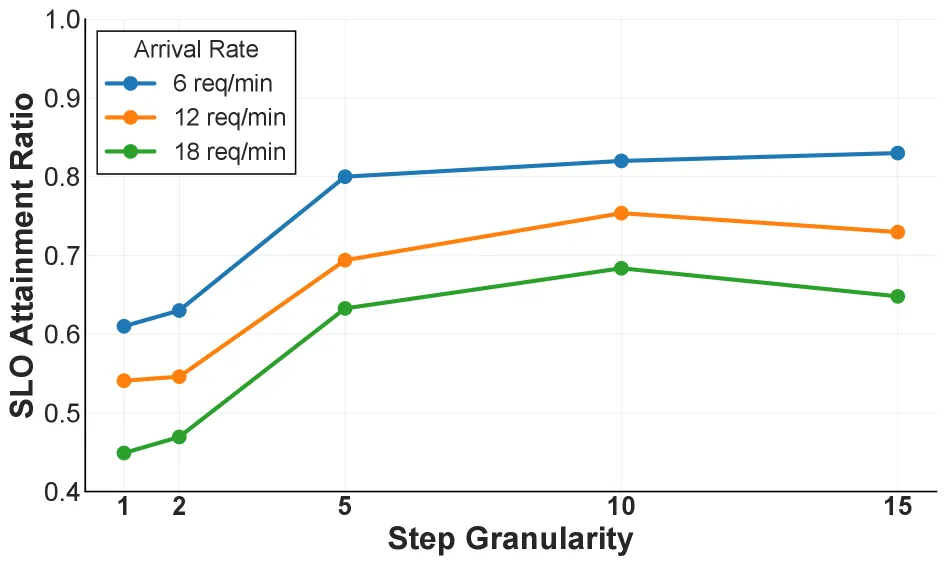
- Step 粒度:太细(1 step)overhead 高,太粗(10 step)非抢占块过长;5 step 折中最鲁棒。
DiT 缩放稳定性
Table 1 显示 100 次运行的 CV 全部 < 0.7%,剖析驱动的成本模型可行。
六、总结
核心贡献
- 观察并证明 DiT 在线服务下 step-level SP 调度是 NP-hard,但通过 round-based 离散化可在毫秒级 tractable。
- 提出 deadline-aware GPU allocation:在每轮为每 request 求最小 GPU-hour 且满足 deadline 的 (step, SP) 序列,基于离线剖析 lookup。
- 提出 request packing 以”最小化必迟到 request 数量”为目标,用 下界筛选每轮幸存者。
- 在 FLUX.1-dev/H100 与 SD3/A40 两个平台、Uniform 与 Skewed 两种 workload 下,SAR 最高提升 32%(Skewed 1.2× SLO),Uniform 1.1× 提升 28%,平均 10–15%。
- 系统层面:VAE 串行、process group 预热、Latent Future、C++ 控制面等工程细节使系统实用可复现(5033 LOC)。
技术影响
- 首次把 “step 级” 变量引入 DiT serving 的调度决策空间,为后续视频扩散、混合分辨率生成服务提供框架。
- 与 caching 类系统(Nirvana、MoDM)正交,可组合。
- Round-based + “必迟到”下界 是通用的 SLO-aware 调度模板,可迁移到其他多步、可变并行度的工作负载(例如未来的 chunked prefill、long-context batch)。
局限性
- 依赖离线剖析 ;模型或硬件变化需重新剖析。
- 目前 SP degree 限定为 2 的幂,未探索非 2 幂子集或异构 GPU 组。
- VAE 串行策略在真正高负载/高并发时可能成为潜在瓶颈。
- 尚未评估视频生成 (Sora 类) 与更高分辨率 (4096²) 场景。
- 调度粒度 τ / 步粒度是配置参数,最佳值仍需按负载经验选择。
七、参考资源
- arXiv 摘要页:https://arxiv.org/abs/2510.01565
- HTML 全文:https://arxiv.org/html/2510.01565v1
- PDF:https://arxiv.org/pdf/2510.01565
- 图表索引:
figures/2510.01565-tetriserve/README.md - 相关工作:xDiT (2024)、DDiT (2025)、Nirvana (NSDI’24)、MoDM (2025)、vLLM (SOSP’23)、SGLang、MuxServe (ICML’24)、DeepSpeed Ulysses、Ring Attention