SLA: Beyond Sparsity in Diffusion Transformers via Fine-Tunable Sparse-Linear Attention
将稀疏注意力与线性注意力融合的 trainable attention 方法,用于加速 DiT 视频生成模型
SLA: Beyond Sparsity in Diffusion Transformers via Fine-Tunable Sparse-Linear Attention
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SLA: Beyond Sparsity in Diffusion Transformers via Fine-Tunable Sparse–Linear Attention |
| 作者 | Jintao Zhang, Haoxu Wang, Kai Jiang, Shuo Yang, Kaiwen Zheng, Haocheng Xi, Ziteng Wang, Hongzhou Zhu, Min Zhao, Ion Stoica, Joseph E. Gonzalez, Jun Zhu, Jianfei Chen |
| 机构 | Tsinghua University, UC Berkeley |
| 论文 | arXiv:2509.24006 |
| 代码 | https://github.com/thu-ml/SLA |
| 发布 | 2025-09-29 |
| 许可 | arXiv 非独占分发许可 |
二、核心思想
问题定义
Diffusion Transformer(DiT)模型中,尤其是视频生成场景,注意力延迟是主要瓶颈——序列长度通常从 10K 到 100K。现有高效注意力方法面临两类局限:
- 线性注意力:在视频扩散模型上严重降级质量,目前仅停留在图像生成预训练阶段
- 稀疏注意力:难以达到极高稀疏度,实践中通常只能达到 40–60% 稀疏度(序列长度 <50K),近期工作报告 80–85% 但基于极长序列(100K–300K)
解决方案概述
SLA(Sparse-Linear Attention)是一种可训练的混合稀疏-线性注意力方法,核心思想是:
- 将注意力权重分类为三类:critical(关键)、marginal(边缘)、negligible(可忽略)
- Critical 部分使用稀疏 FlashAttention 精确计算(O(N²))
- Marginal 部分使用线性注意力近似(O(N))
- Negligible 部分直接跳过
- 通过少量微调步骤使模型适应这种混合模式
关键发现:注意力权重可以分解为两个矩阵——一小部分高秩的大权重和其余极低秩的权重。这自然暗示对第一部分应用稀疏加速,对第二部分应用低秩加速。
三、技术架构
整体框架图
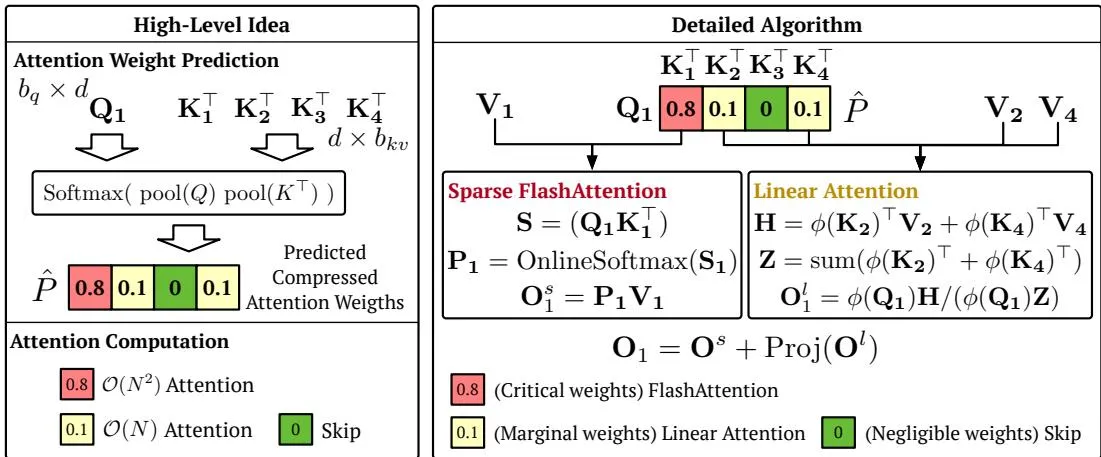
核心公式
注意力权重分解 — 稀疏+低秩组件:
P = \underbrace{P \odot M}_{\text{sparse component}} + \underbrace{P \odot (1 - M)}_{\text{low-rank component}} \tag{1}
其中 是稀疏掩码, 是完整的注意力权重矩阵。
压缩注意力权重预测:
P_c = \text{Softmax}(\text{pool}(Q) \text{pool}(K)^T / \sqrt{d}) \tag{2}
其中 是沿 token 维度的均值池化操作符。
三类分类掩码:
M_c[i,j] = \begin{cases} 1 & (\text{top } k_h\%) \\ -1 & (\text{bottom } k_l\%) \\ 0 & (\text{otherwise}) \end{cases} \tag{3}
稀疏注意力输出(FlashAttention):
\mathbf{S}_{ij} = \mathbf{Q}_i \mathbf{K}_j^T / \sqrt{d}, \quad \mathbf{P}_{ij} = \text{OnlineSoftmax}(\mathbf{S}_{ij}), \quad \mathbf{O}_i^s = \mathbf{O}_i^s + \mathbf{P}_{ij} \mathbf{V}_j \tag{4}
线性注意力输出(补偿 marginal 部分):
\mathbf{H}_i = \sum_{j: M_c[i,j]=0} \phi(\mathbf{K}_j)^T \mathbf{V}_j, \quad \mathbf{Z}_i = \sum_{j: M_c[i,j]=0} \text{rowsum}(\phi(\mathbf{K}_j)^T), \quad \mathbf{O}_i^l = \frac{\phi(\mathbf{Q}_i) \mathbf{H}_i}{\phi(\mathbf{Q}_i) \mathbf{Z}_i} \tag{5}
最终 SLA 输出:
O = O^s + \text{Proj}(O^l) \tag{6}
其中 是可学习的线性变换 ,用于减少 softmax 和线性注意力之间的分布不匹配。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Compressed Mask () | 基于池化后注意力权重的三类分类 | , |
| Sparse Component | 对 critical 块使用 FlashAttention | O() 复杂度 |
| Linear Component | 对 marginal 块使用线性注意力 | O() 复杂度,<0.5% 全注意力成本 |
| Projection Layer | 可学习线性变换,补偿分布不匹配 | |
| Activation Function | 线性注意力的特征映射 | softmax(消融实验最优) |
训练流程
Fine-tuning 配置:
- 数据集:20,000 个 5 秒 480p 视频(来自 Pexels 和 Common Crawl)
- 模型:Wan2.1-1.3B
- 训练步数:2,000 steps(batch size=64)
- 训练成本:<0.1% 预训练成本(典型预训练 10⁵–10⁶ steps)
- 超参数:,,
前向传播算法(Algorithm 1):
- 预计算线性注意力的 和
- 对每个 query block,根据 决定计算路径:
- :执行稀疏 FlashAttention
- :累加预计算的 和 (单次矩阵加法)
- :跳过
反向传播算法(Algorithm 2):
- 稀疏注意力梯度:遵循 FlashAttention 推导
- 线性注意力梯度:通过链式规则计算
- 两者融合到单个 GPU kernel 中
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
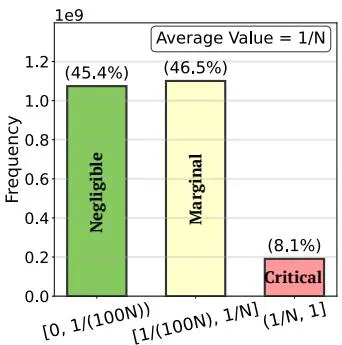
| 注意力权重分解发现 | 首次系统展示 DiT 注意力权重可分解为高秩稀疏部分和低秩密集部分 | Wan2.1 采样:仅 8.1% 权重 > 平均值,45% 权重 < 1/(100N) |
| 稀疏+线性混合范式 | 用线性注意力作为稀疏注意力的可学习补偿,而非替代 | 线性注意力单独使用导致视频质量崩溃(VA 0.042 vs 76.78) |
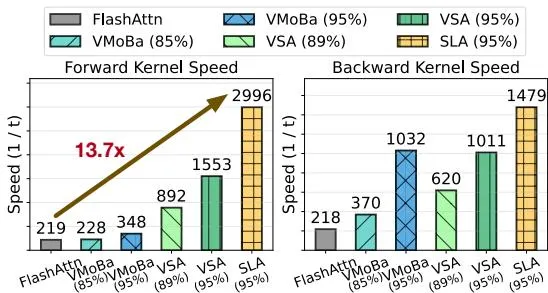
| 单一 GPU Kernel 融合 | 前向和后向传播都融合到单个 kernel 中,避免内存开销 | 前向 13.7× 加速,反向 6.8× 加速 |
| 极小微调开销 | 仅需 2,000 步微调即可适应新注意力模式 | <0.1% 预训练成本,batch size=64 |
| 95% 稀疏度保持质量 | 在 95% 稀疏度下视频质量与全注意力相当 | VA 76.96 vs 76.78,VT 83.92 vs 82.88 |
五、实验结果
视频生成质量与效率对比(Table 1)
| 方法 | VA↑ | VT↑ | IQ↑ | OC↑ | AQ↑ | SC↑ | VR↑ | FLOPs↓ | Sparsity↑ |
|---|---|---|---|---|---|---|---|---|---|
| Full Attention | 76.78 | 82.88 | 62.5 | 23.3 | 56.1 | 93.0 | 0.059 | 52.75T | 0% |
| Sparge-F | 0.002 | 0.026 | 26.0 | 4.6 | 35.7 | 85.1 | -0.216 | 7.91T | 85% |
| Sparge-T | 73.83 | 77.87 | 61.9 | 22.7 | 55.4 | 93.1 | 0.014 | 7.38T | 84% |
| VMoBa | 32.33 | 35.79 | 58.0 | 18.8 | 46.2 | 89.9 | -0.175 | 7.91T | 85% |
| VSA | 55.37 | 64.61 | 60.6 | 22.4 | 51.9 | 83.6 | -0.069 | 5.92T | 89% |
| SLA | 76.96 | 83.92 | 62.2 | 23.6 | 55.9 | 93.1 | 0.048 | 2.74T | 95% |
关键发现:
- SLA 在 95% 稀疏度下质量超越全注意力(VA 76.96 vs 76.78,VR 0.048 vs 0.059)
- 相比 Sparge-T(84% 稀疏度),SLA 稀疏度更高且质量更好
- 95% SLA 比 85% VSA/VMoBa 实际快约 3×,且质量显著更好
消融实验(Table 2)
| 方法 | VA↑ | VT↑ | IQ↑ | OC↑ | AQ↑ | SC↑ | VR↑ | FLOPs↓ | Sparsity↑ |
|---|---|---|---|---|---|---|---|---|---|
| Full Attention | 76.78 | 82.88 | 62.5 | 23.3 | 56.1 | 93.0 | 0.059 | 52.75T | 0% |
| Linear Only | 0.042 | 0.099 | 39.5 | 3.6 | 28.8 | 90.7 | -0.213 | 0.10T | 100% |
| Sparse Only | 64.00 | 70.50 | 57.2 | 21.8 | 51.7 | 88.7 | -0.073 | 7.91T | 85% |
| L+S | 29.65 | 41.15 | 58.6 | 18.8 | 45.3 | 87.1 | -0.105 | 5.37T | 90% |
| SLA (softmax) | 76.96 | 83.92 | 62.2 | 23.6 | 55.9 | 93.1 | 0.048 | 2.73T | 95% |
| SLA (elu+1) | 75.50 | 81.01 | 62.8 | 23.5 | 55.3 | 92.9 | 0.034 | 2.74T | 95% |
| SLA (hedgehog) | 74.59 | 82.62 | 61.9 | 22.5 | 54.3 | 93.2 | 0.035 | 3.11T | 95% |
| SLA (Top 5%) | 76.96 | 83.92 | 62.2 | 23.6 | 55.9 | 93.1 | 0.048 | 2.73T | 95% |
| SLA (Top 10%) | 75.29 | 82.20 | 62.5 | 22.6 | 55.8 | 93.5 | 0.057 | 5.38T | 90% |
| SLA (Top 20%) | 75.81 | 83.82 | 62.7 | 22.4 | 54.5 | 92.6 | 0.059 | 10.65T | 80% |
消融结论:
- Linear Only 完全失败:VA 0.042(vs 76.78),证明纯线性注意力无法用于视频生成
- Sparse Only 质量不足:VA 64.00(vs 76.78),85% 稀疏度下仍有明显降级
- L+S 简单相加无效:VA 29.65,证明需要可学习投影层 Proj
- softmax 激活最优:优于 elu+1 和 hedgehog
- Top 5% 最佳平衡:节省一半计算量(vs Top 10%),质量无损失
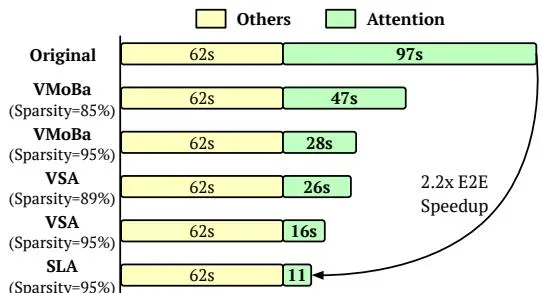
效率分析(Figure 6)
| 指标 | 全注意力 | SLA | 加速比 |
|---|---|---|---|
| 前向 Kernel | 1× | 13.7× | 13.7× |
| 反向 Kernel | 1× | 6.8× | 6.8× |
| Attention 延迟 | 97s | 11s | 8.8× |
| 端到端生成 | 1× | 2.2× | 2.2× |
| Attention FLOPs | 52.75T | 2.74T | 95% 减少 |
对比基线:
- 比 VSA(95% 稀疏度)快 1.93×
- 比 VMoBa(95% 稀疏度)快 3.36×
- 注意力时间几乎可忽略(11s vs 其他操作)
图像生成实验(Appendix Table 3)
| 方法 | FID↓ | FLOPs↓ | Sparsity↑ |
|---|---|---|---|
| Full Attention | 31.87 | 12.88G | 0% |
| SpargeAttn-F | 206.11 | 3.66G | 71.57% |
| SpargeAttn-T | 46.05 | 3.16G | 75.45% |
| VSA (2D) | 35.75 | 3.62G | 75.00% |
| VMoBA (2D) | 39.45 | 3.22G | 75.00% |
| SLA | 31.49 | 1.73G | 87.50% |
SLA 在图像生成上甚至超越全注意力(FID 31.49 vs 31.87),且稀疏度达 87.5%。
六、动机与分析
注意力权重分布观察(Figure 1)
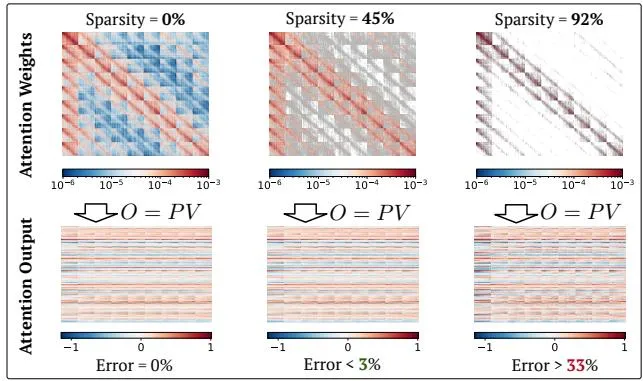
关键发现:
- 仅约 8.1% 的权重大于平均值
- 约 45% 的权重极小,低于
- 跳过最小的 45% 权重引入的 L1 误差 <3%
- 仅保留最大的 8.1% 权重(稀疏度 92%)导致误差升至 33%
- 这解释了为什么现有稀疏注意力方法难以超过 90% 稀疏度
注意力权重分解(Figure 3)
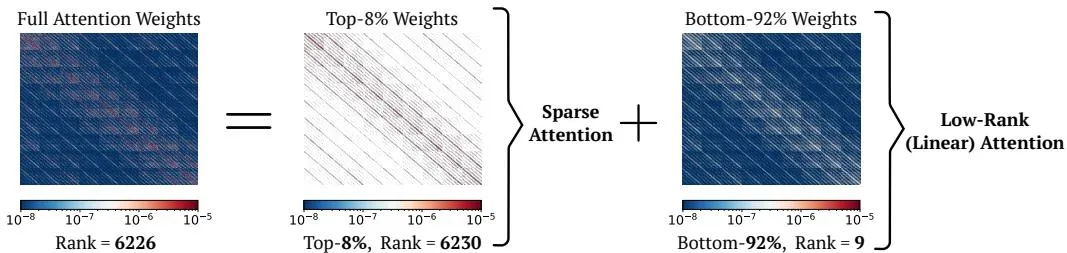
观察:
- 全注意力权重可解耦为两部分:
- 小部分(<10%):秩接近全注意力,高秩
- 大部分(>90%):极低秩
- 移除顶部值后,剩余矩阵变得极低秩
- 这解释了为什么线性注意力单独失败(全注意力秩太高),而稀疏注意力单独不够(边际权重不能忽略)
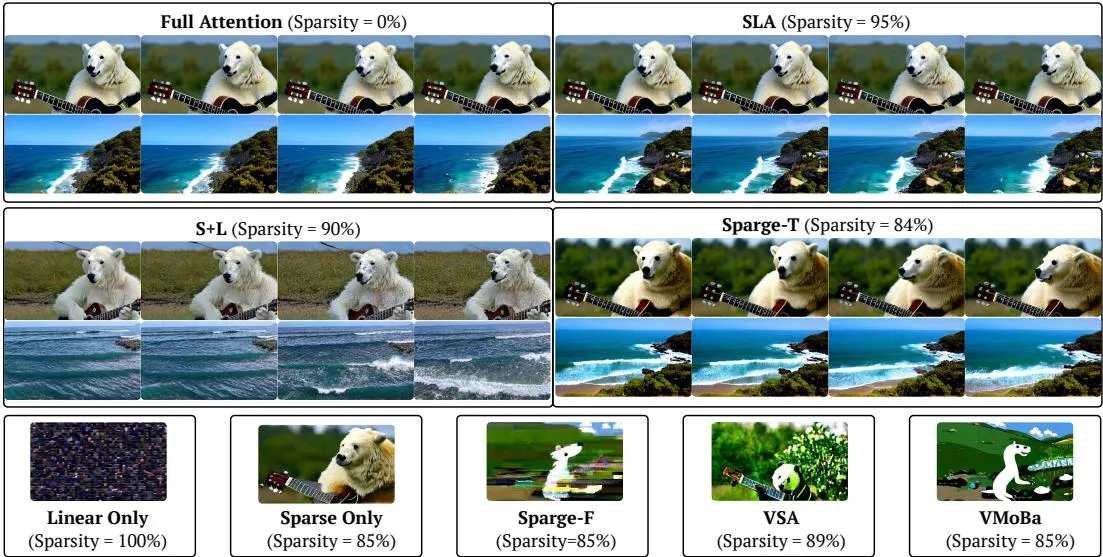
视频生成定性对比(Figure 2)
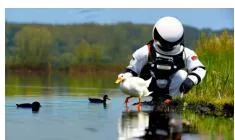 Full Attention (Sparsity = 0%)
 Linear Only (Sparsity = 100%)
 Sparse Only (Sparsity = 90%)
 SLA (Sparsity = 95%)
结论:SLA 在 95% 稀疏度下实现无损视频质量,而线性注意力单独使用和 90% 稀疏度的稀疏注意力都有明显降级。
视频对比示例(Figure 5 & 7)
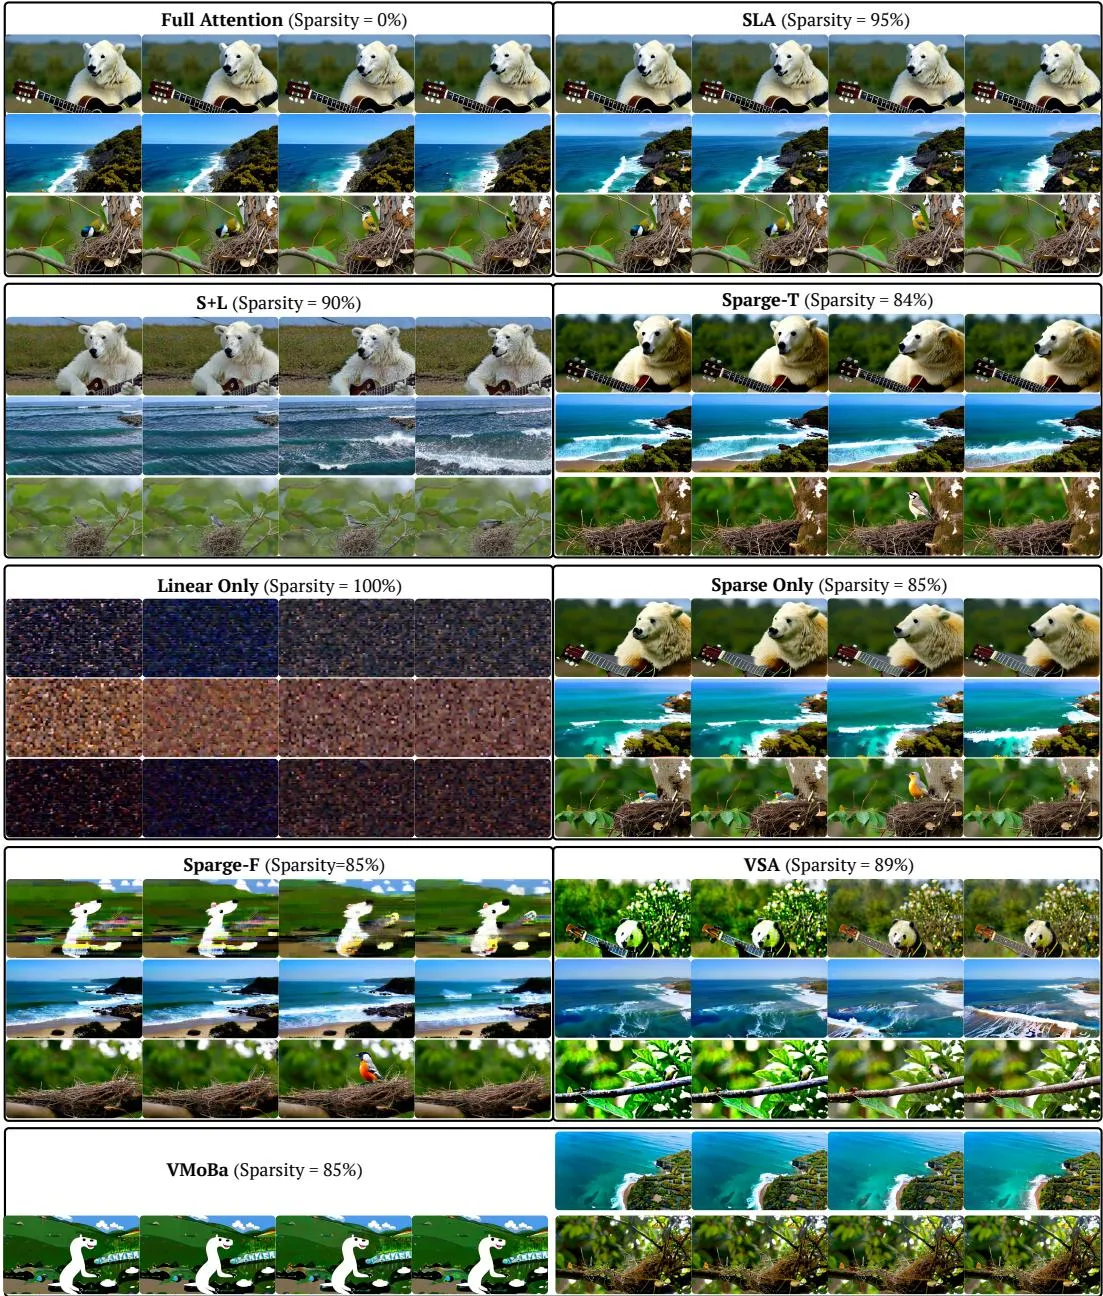
SLA 生成的视频与全注意力相当,而其他方法(Linear Only, Sparse Only, Sparge-F, VSA, VMoBa)即使低于 90% 稀疏度也出现明显失真。
七、相关工作
稀疏注意力
- Training-free:SparseAttn(Zhang et al., 2025a)、Radial Attention(Li et al., 2025)、SparseVideoGen(Xi et al., 2025)
- Trainable:VSA(Zhang et al., 2025c)、VMoBa(Wu et al., 2025)、FPSAttention(Liu et al., 2025)
- LLM 场景:MInference(Jiang et al., 2024)、MoA(Fu et al., 2024)、InfLLM(Xiao et al., 2024)
线性注意力
- LLM 场景:Performer(Choromanski et al., 2020)、Linformer(Wang et al., 2020)、RetNet(Sun et al., 2023)、CosFormer(Qin et al., 2022)
- DiT 图像生成:SANA(Xie et al., 2024)、Dig(Zhu et al., 2025)
- 视频生成:尚无成功应用(本文核心洞察)
硬件高效注意力
- FlashAttention-2/3(Dao, 2023; Shah et al., 2024)、SageAttention(Zhang et al., 2024c,b)
八、总结
核心贡献
- 注意力权重分解洞察:首次系统展示 DiT 注意力权重可分解为高秩稀疏部分和低秩密集部分,解释了稀疏和线性注意力各自失败的原因
- SLA 混合架构:提出稀疏+线性注意力的可训练融合方法,通过少量微调(2,000 steps)实现 95% 稀疏度
- GPU Kernel 优化:前向和后向传播都融合到单个 kernel 中,实现 13.7× 前向加速和 6.8× 反向加速
- 视频生成质量保持:在 95% 稀疏度下视频质量与全注意力相当甚至略优(VA 76.96 vs 76.78)
- 端到端加速:Wan2.1-1.3B 视频生成加速 2.2×,注意力延迟从 97s 降至 11s
技术影响
SLA 证明了稀疏注意力和线性注意力不是互斥的替代方案,而是互补的组件。线性注意力在 SLA 中的角色不是近似 marginal 权重的输出,而是作为增强稀疏注意力有效性的可学习补偿。这一洞察解决了线性注意力在视频扩散模型上长期失败的问题。
局限性
- 当前仅在 Wan2.1-1.3B 上验证,未扩展到更大模型(如 6B 版本)
- 微调数据集为 20,000 个私有视频,未公开复现
- 图像生成实验使用 LightningDiT-1B,未在更多 DiT 变体上验证
- 激活函数选择(softmax)的泛化性需进一步研究
九、参考资源
- arXiv: 2509.24006
- GitHub: https://github.com/thu-ml/SLA
- Wan2.1: arXiv:2503.20314
- VSA: arXiv:2505.13389
- VMoBa: arXiv:2506.23858