HunyuanImage 3.0 Technical Report
腾讯混元原生多模态模型:在自回归框架内统一多模态理解与生成,80B MoE(激活 13B),当前最大最强开源图像生成模型
HunyuanImage 3.0 Technical Report:统一理解与生成的原生多模态 MoE 大模型
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | HunyuanImage 3.0 Technical Report |
| 作者 | Tencent Hunyuan Foundation Model Team(腾讯混元基础模型团队) |
| 机构 | 腾讯(Tencent Hunyuan) |
| 论文 | https://arxiv.org/abs/2509.23951 |
| 发布 | 2025-09-28(v1),2026-06-26(v3) |
| 主题 | Computer Vision and Pattern Recognition (cs.CV) |
| 基座 | Hunyuan-A13B(MoE LLM,80B 总参 / 13B 激活) |
| 代码/权重 | 开源(当前仅发布文生图能力) |
HunyuanImage 3.0 是一个原生多模态(native multimodal)模型,在单一自回归框架内统一多模态理解与生成。它以预训练 MoE LLM(Hunyuan-A13B)为基座,扩展视觉编码器 + VAE,采用类 Transfusion/JanusFlow 的方式将扩散式图像建模嵌入 LLM。总参数超 80B,每 token 激活 13B,是迄今最大、最强的开源图像生成模型。
Figure 1:HunyuanImage 3.0 的多宽高比文生图样本,展示强大的 prompt 遵循能力。
二、核心思想
问题定义
现有统一多模态模型常将视觉特征按任务分离(理解用 vision encoder 特征、生成用 VAE 特征),需在理解与生成两条流水线间切换,难以支持交错对话、生成、编辑的连续交互。同时,纯 DiT 路线缺乏 LLM 的推理与语义理解能力。
解决方案概述
以预训练 MoE LLM 为骨干,将图像理解与生成统一到自回归下一 token 预测 + 扩散图像建模的单一序列中:
- 双编码器策略:拼接 VAE 潜特征与 vision encoder 特征,实现理解与生成共用同一序列表示;
- 原生 CoT(Chain-of-Thought):借助 LLM 框架,模型可自主”思考”——从解读 prompt、到中间概念精炼与改写、再到合成图像;
- 渐进式预训练 + 激进后训练:四阶段渐进预训练 + SFT/DPO/MixGRPO/SRPO/ReDA 多阶段后训练;
- 高效基建:支持 80B 级大规模训练/推理,并通过蒸馏(MeanFlow,NFE 降至 4-8)与剪枝(TMP,80B→20B)实现单张 RTX 4090(24GB)部署。
三、技术架构
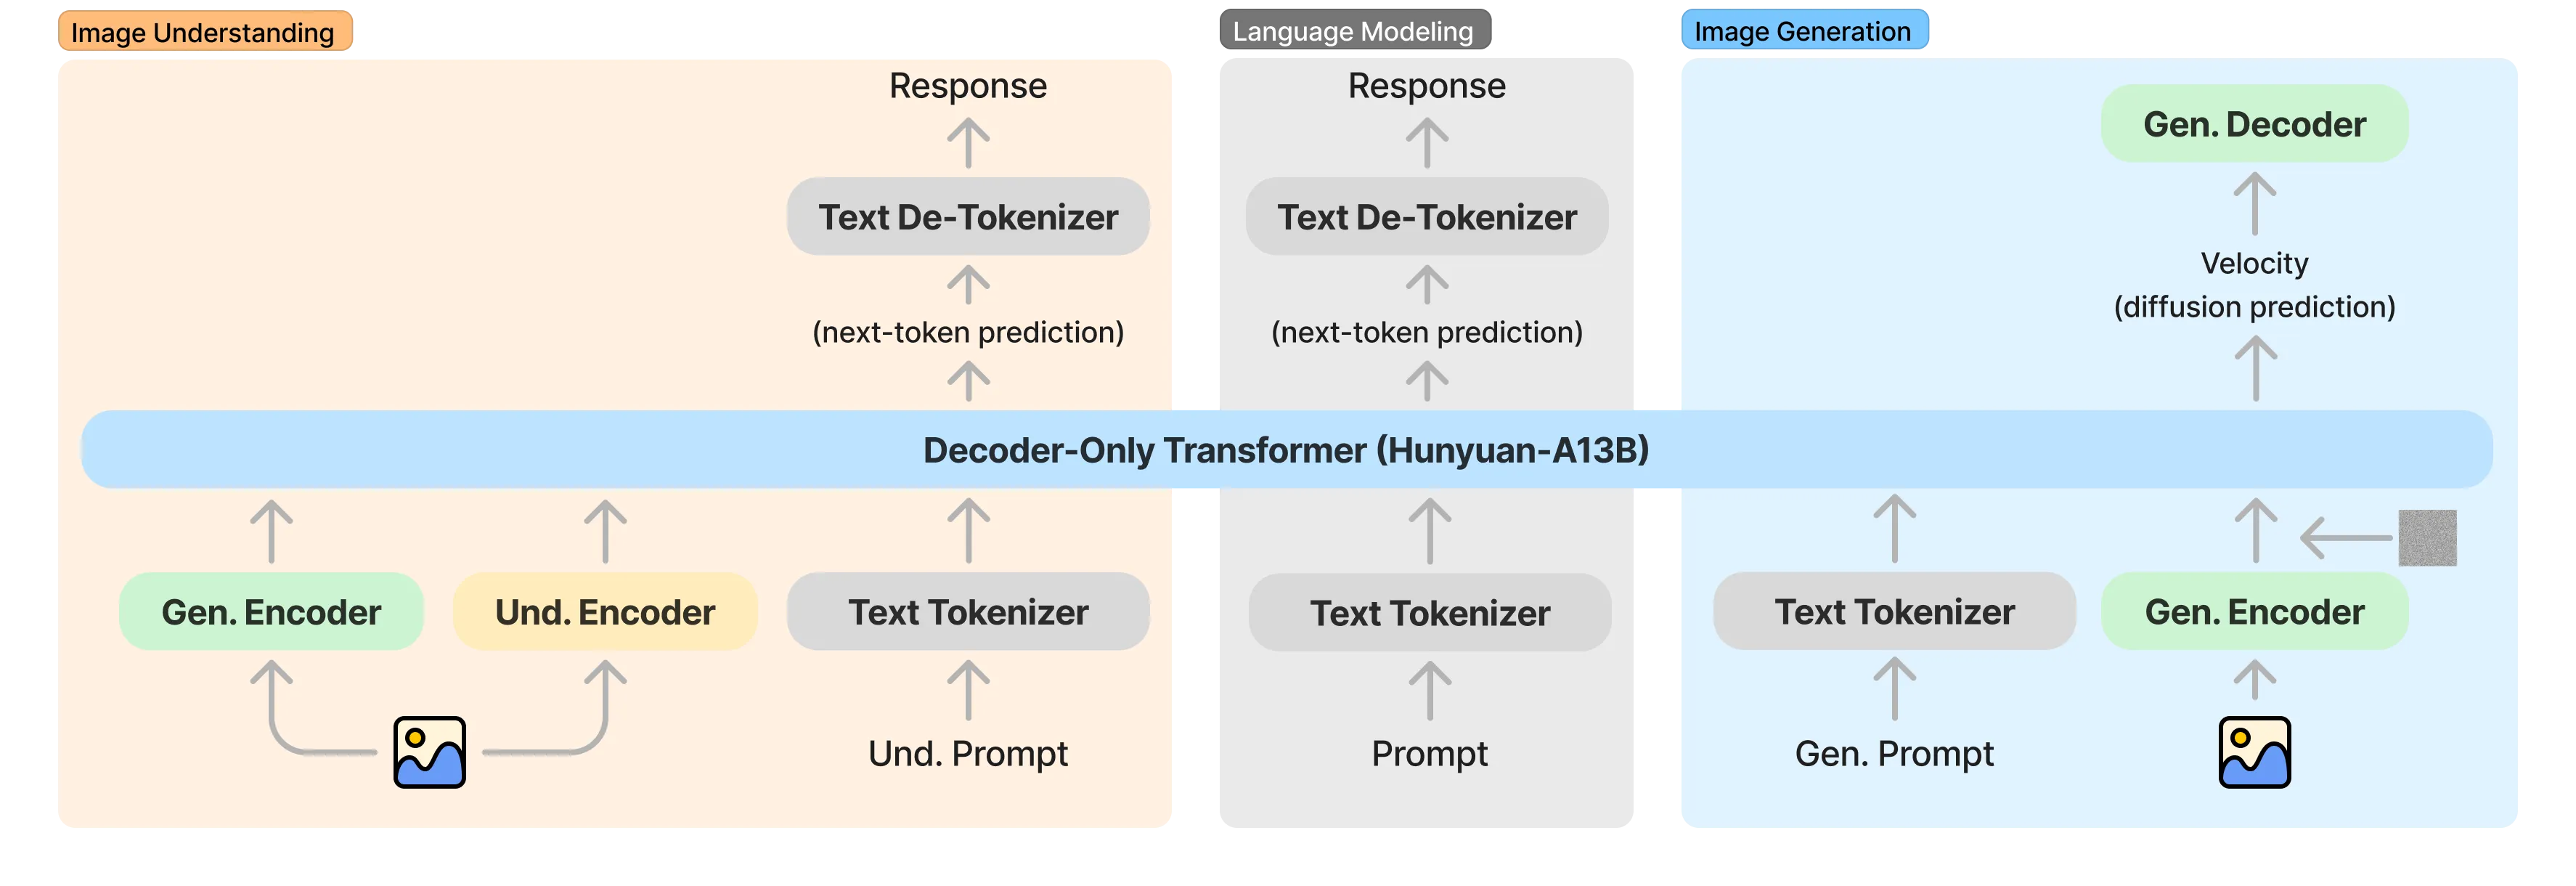
Figure 3:HunyuanImage 3.0 整体框架——LLM 骨干 + vision encoder + VAE,双编码器进入统一序列。
3.1 基座与骨干
- 骨干:Hunyuan-A13B,decoder-only LLM,80B 总参;MoE 配置 64 个专家、每 token 激活 8 个 + 1 个共享 MLP,约 13B 激活参数;
- 文本 tokenizer:Hunyuan Tokenizer,扩展自定义特殊 token 以支持图像生成/理解;
- 图像理解:LLM 基于 vision encoder + VAE 联合特征做自回归下一 token 预测生成回复;
- 图像生成:在 VAE 图像特征上做扩散式图像建模,方式同 Transfusion / JanusFlow 嵌入 LLM。
3.2 VAE 与双编码器
- VAE:内部 VAE,将像素投影到 32 维潜空间、16× 下采样。相比 DiT 路线常用的 “8× VAE + 2× patchify”,单个 16× 下采样 VAE 更简单有效,图像质量更优;
- 双编码器:对条件图像输入,拼接 VAE 潜特征与 vision encoder 特征,形成统一多模态表示,同时支持生成与理解——区别于以往按任务分离视觉特征的统一模型,可在连续上下文中完成交错文本对话、图像生成、图像理解与图像编辑;
- 两个投影器:VAE 特征经时间步调制的残差块投影,vision encoder 特征经两层 MLP 变换;额外注入时间步嵌入以增强扩散条件。
3.3 广义因果注意力(Generalized Causal Attention)
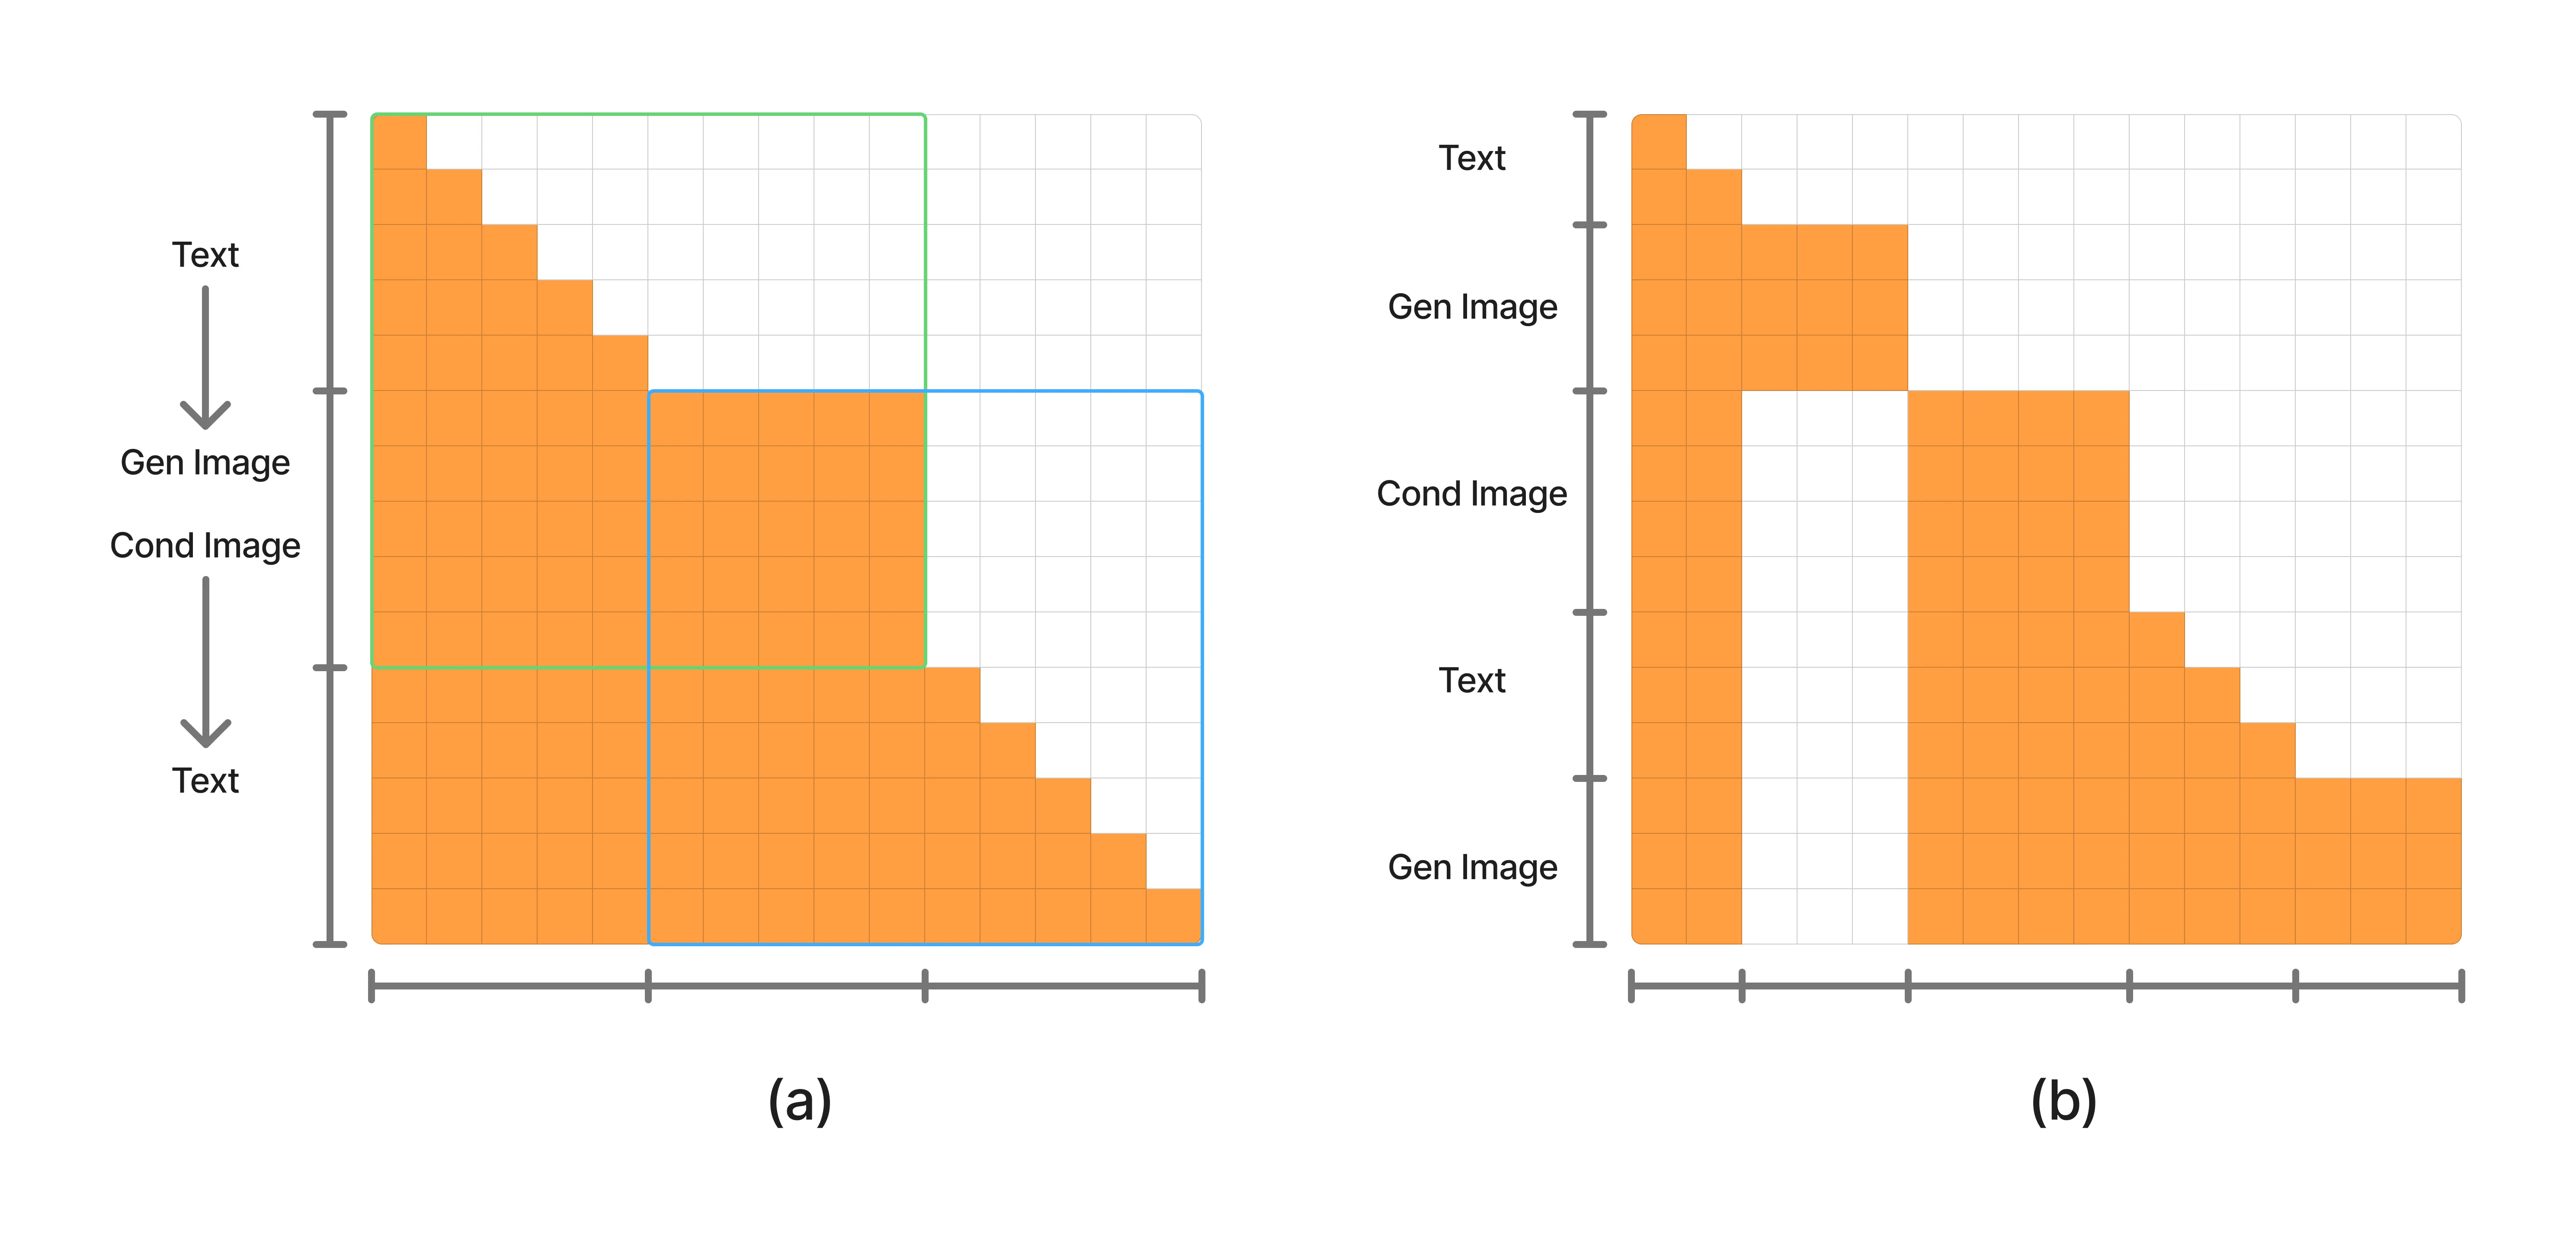
Figure 4:两种注意力实现方式。
融合 LLM 的因果注意力与 DiT 的全注意力:
- 文本 token:仅注意序列中在前的多模态 token(保持自回归特性);
- 图像 token:可注意所有在前的多模态 token,以及同一图像段内所有后续图像 token(利用全注意力捕获全局空间依赖)。
3.4 广义 2D RoPE(向后兼容)
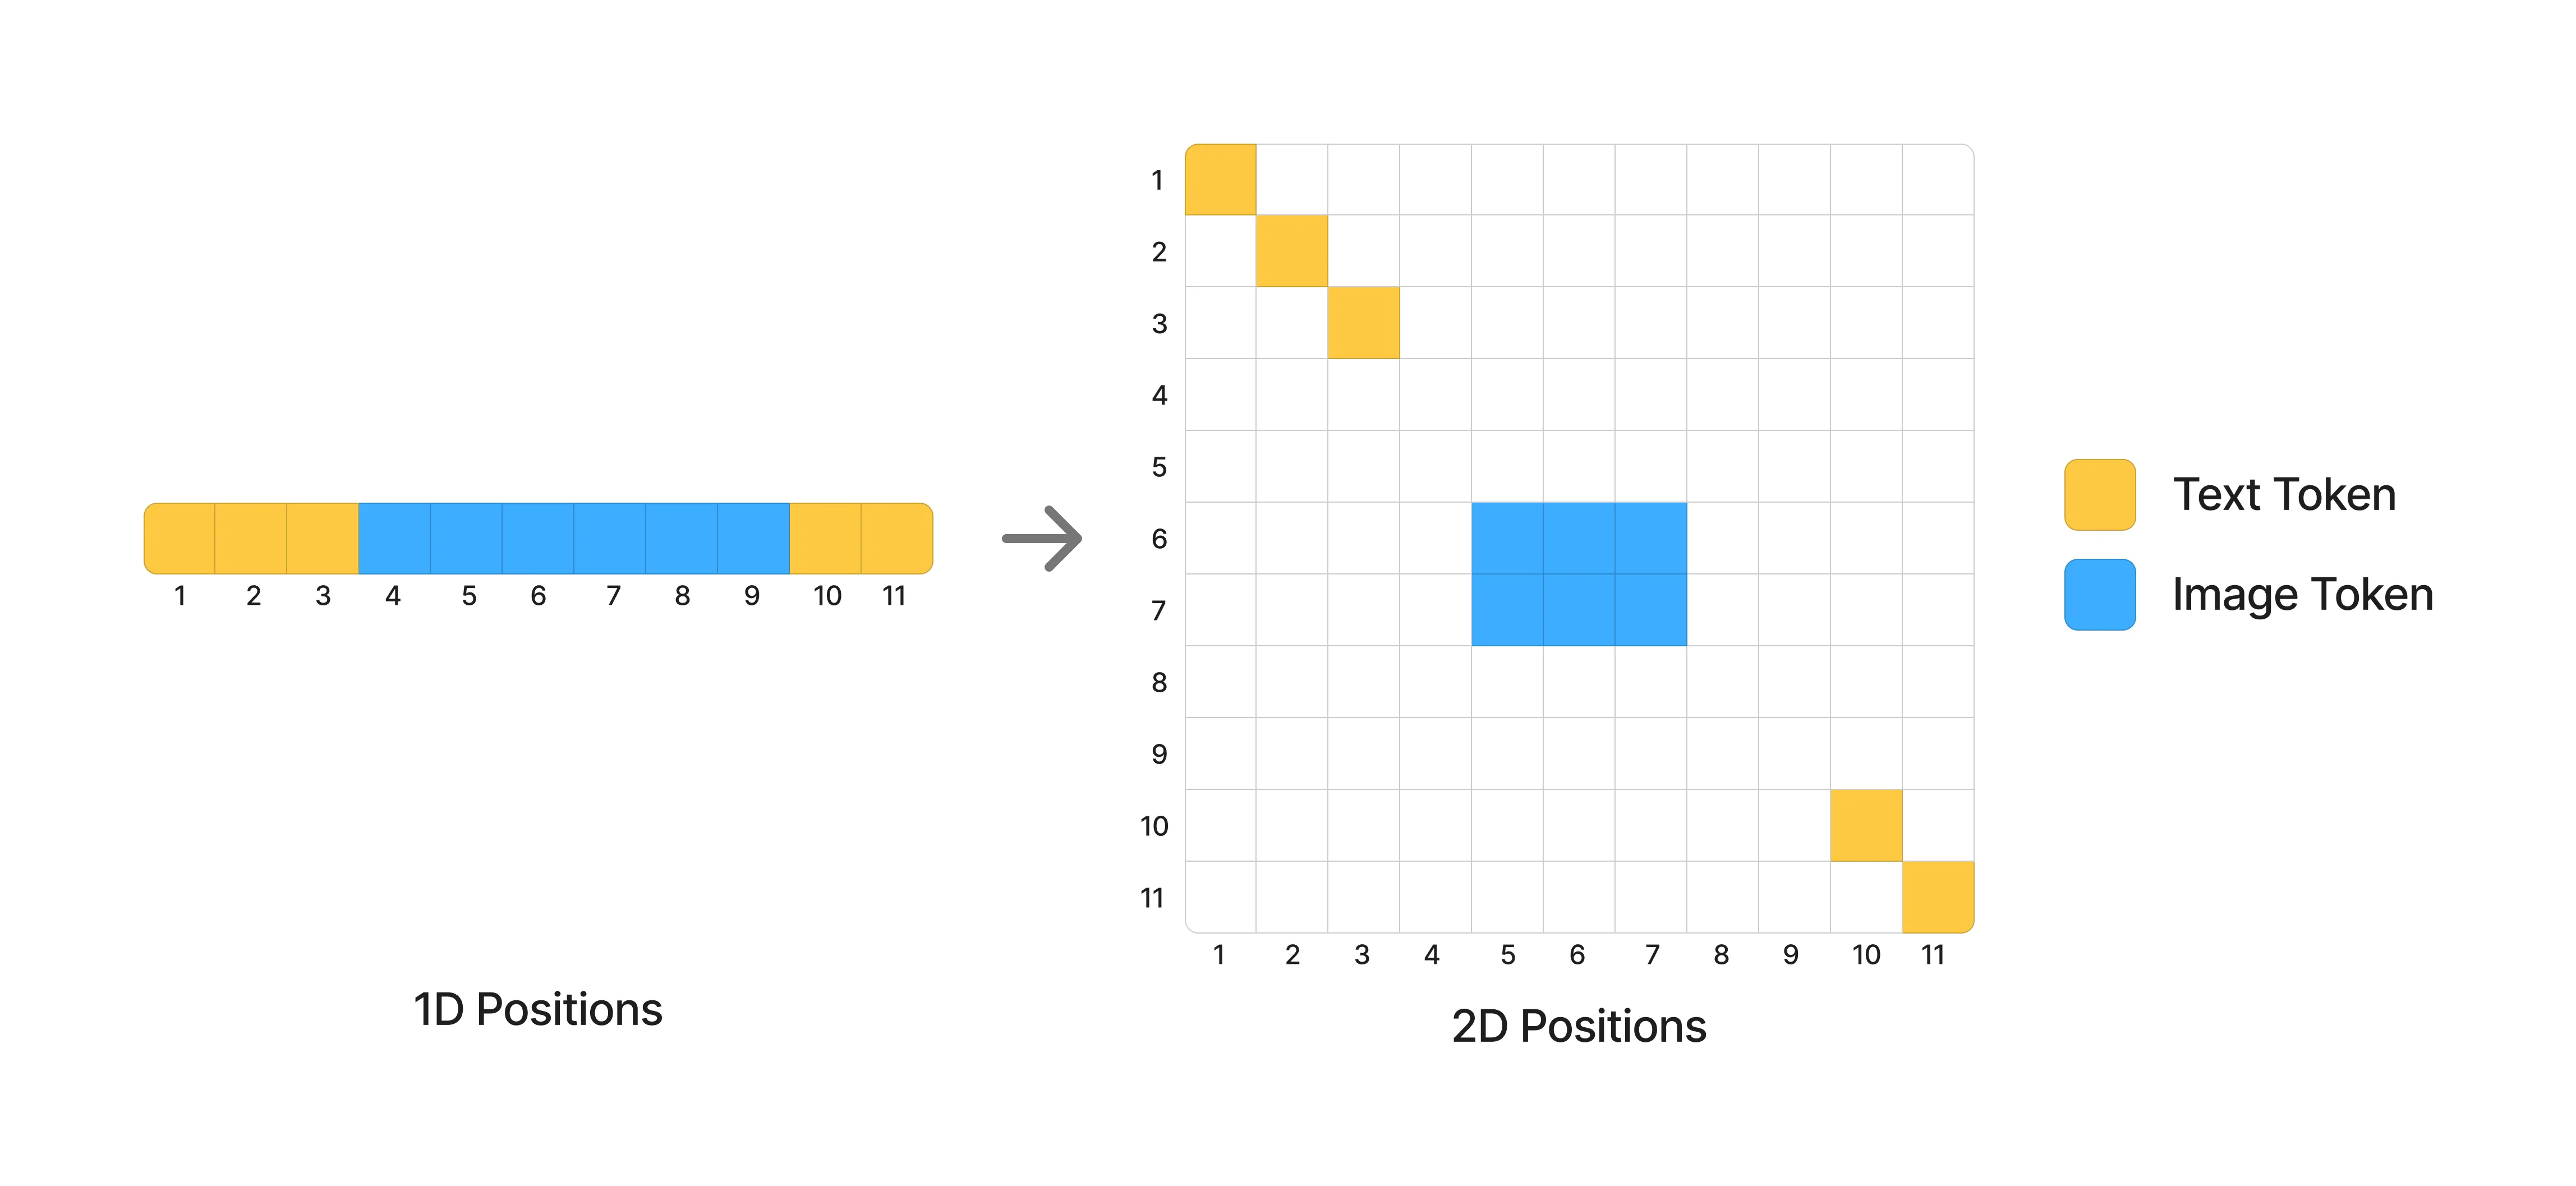
Figure 5:1D RoPE 与广义 2D RoPE 对比。文本 token 位置与 2D RoPE 完全一致——直觉上是把 1D 图像位置 reshape 为 2D 并置于两段文本之间。
对 1D 文本位置 与频率 ,标准 RoPE 为:
推广到 2D 坐标 ,各向异性地解释同一嵌入结构:
图像 token(从 1D reshape 为 2D)用此广义 2D 编码;文本 token 保留标准 1D RoPE(可视为对角位置的 2D RoPE)。关键:无图像 token 时编码退化为精确的 1D RoPE,从而完全保留预训练 LLM 的语言能力。
3.5 自动图像尺寸/比例预测
DiT 通常需用户指定尺寸/比例。本模型引入自动模式:扩展词表加入两组特殊 token——{<img_size_256>, <img_size_512>, <img_size_768>, …}(分辨率锚点)与 {<img_ratio_0>…<img_ratio_32>}(1:4 到 4:1 宽高比)。模型可根据上下文预测合适尺寸/比例 token,也支持用户显式提示(如 “3:4”、“vertical”),再据此为图像 token 施加 2D RoPE。
四、原生 Chain-of-Thought
本模型的一个关键贡献是为图像生成引出自动化 CoT 推理,通过在小规模专门数据上微调激活。模型可自主执行完整流程:解读输入 prompt → 中间”思考”阶段(概念精炼与改写)→ 合成目标图像。构造了两类训练数据:
- T2T(Text-to-Text)推理数据:增强逻辑推理;
- T2TI(Text-to-Text-to-Image)推理数据:显式建模从抽象概念到视觉呈现的完整工作流。
推理部分的 token 同样通过自回归下一 token 预测建模。
五、模型训练
5.1 数据
- 从 100 亿+ 原始图像出发,三阶段过滤保留 <45%;embedding 聚类去重再去掉约 0.5%;补充知识增强、文本相关、风格化、平面设计等专门数据,最终约 50 亿张高质量图像;
- 图像描述(Captioning)流水线:见 Figure 2。
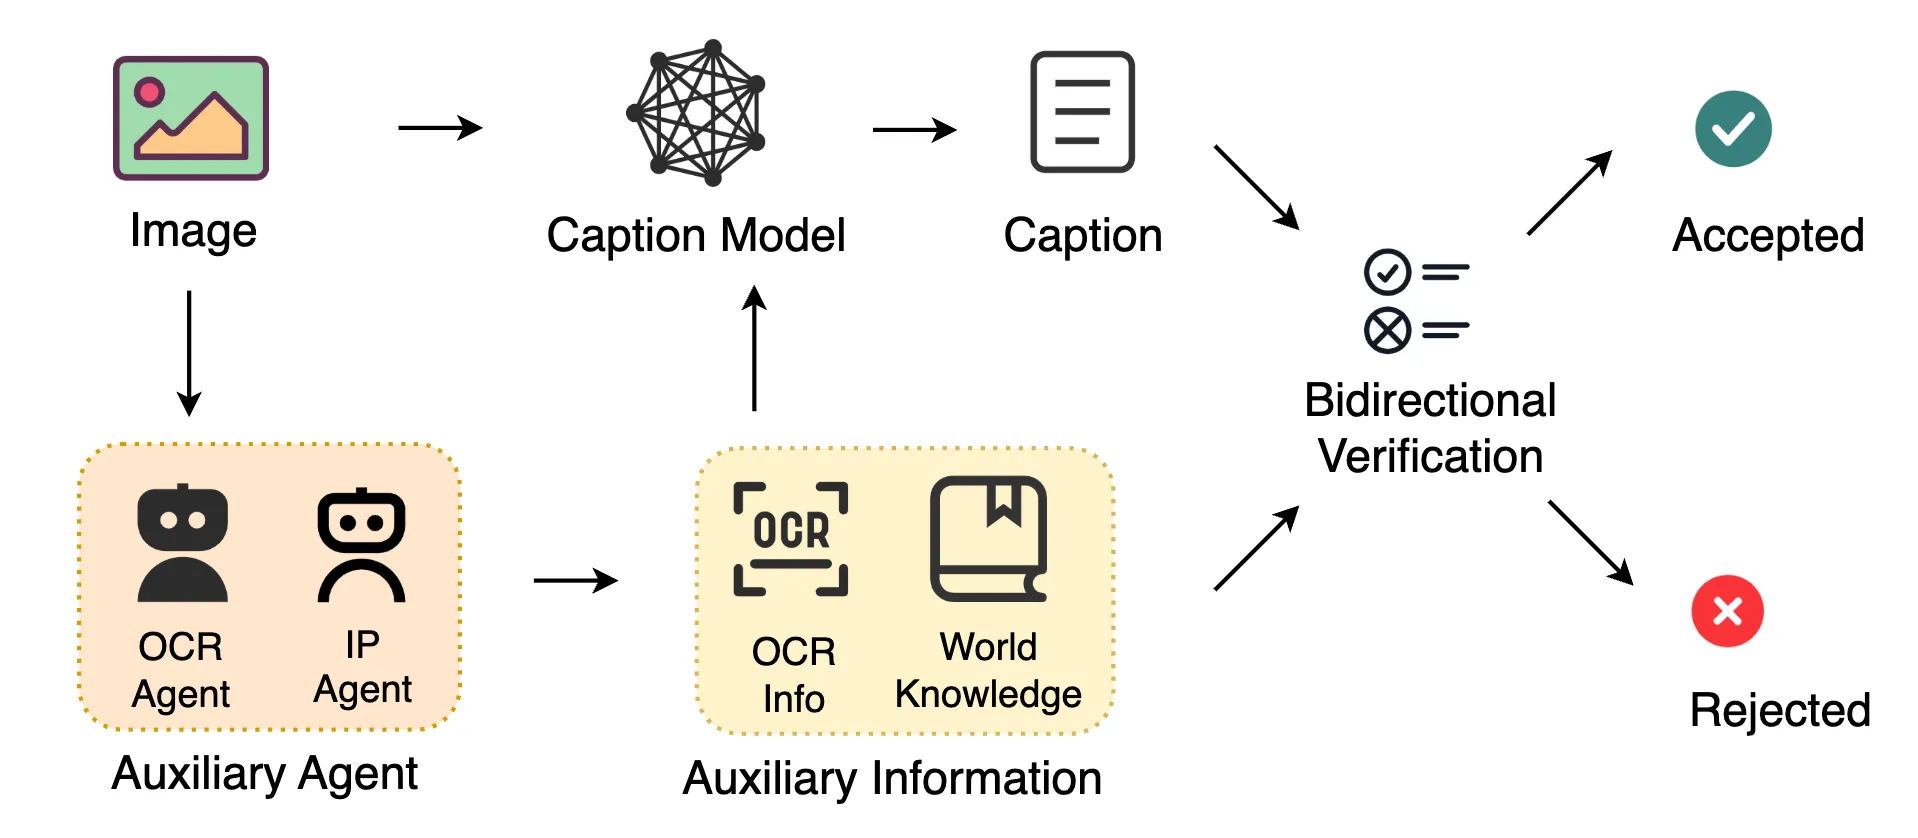
Figure 2:图像描述(Captioning)流水线。
5.2 四阶段渐进预训练
数据由粗到细过滤,VAE 分辨率逐步提高,ViT 固定 512px:
| 阶段 | VAE 分辨率锚点 | ViT 分辨率 | 训练部分 | 任务 |
|---|---|---|---|---|
| I | 256px | 512px | Transformer(ViT 冻结) | T2I, LM, MMU |
| II | 256px | 512px | ViT + aligner(Transformer 冻结) | MMU |
| III | 512px | 512px | ViT + Transformer | T2I, LM, MMU, INTL |
| IV | 1024px | 512px | ViT + Transformer | T2I, LM, MMU, INTL, CoT |
- 阶段 I:Transformer 骨干训练(ViT 冻结),256px 大 batch,同时优化 T2I/LM/MMU,对齐文图潜表示;
- 阶段 II:冻结骨干,仅微调 ViT + aligner(MMU 数据),增强视觉理解;
- 阶段 III:ViT 与 Transformer 联合训练(>512px),引入交错文图数据(图像编辑、图生图);
- 阶段 IV:高分辨率子集(短边≥1024px),引入 CoT 推理数据,推理 token 也用自回归建模;
- 指令微调:预训练后针对 T2I 做指令微调,T2I/LM/CoT 数据用指令模板联合优化。
5.3 激进后训练(多阶段)
| 阶段 | 方法 | 作用 |
|---|---|---|
| SFT | 高质量人工标注数据(风景/人像/OCR + 编辑数据),多阶段递进高保真 | 提升指令遵循 |
| DPO | 两阶段:先稳采样/编辑一致性,再精炼视觉真实感 | 抑制结构失真与合成伪影 |
| MixGRPO | 扩展 GRPO 到 flow 模型的混合 ODE-SDE 采样在线 RL | 提升文图对齐、真实感、美学 |
| SRPO | 梯度引导在线 RL,注入噪声先验单步去噪,优化去噪轨迹初始区间 | 缓解过饱和、光色不协调、皮肤质感差 |
| ReDA(自研) | Reward Distribution Alignment:最小化与高奖励先验的散度,任务特定投影器 + 基于 transition 的目标 | 提升身份一致性与真实感 |
5.4 蒸馏与剪枝
- 蒸馏:扩展 MeanFlow 蒸馏 80B 模型,引入轨迹分布对齐,将 NFE 降至 4-8 步仍保持竞争力;
- 剪枝:TMP(Tree-structured Mixed-policy Pruning)——启发式剪枝 + 分层局部混合策略蒸馏,将 80B 压缩到 20B(-75%),配合内存优化可部署于单张 24GB RTX 4090。
六、实验结果
6.1 SSAE(结构化语义对齐评测)
针对 T2I-CompBench/GenEval 的局限(prompt 单一、CLIP 指标与人类判断脱节),提出 SSAE:收集 500 个多样 prompt,用 LLM 结构化语义点解析器抽取 3500 个关键点,归入 12 个细粒度字段;再用带 CoT 的 MLLM 对生成图做 0-1 匹配打分,计算 Mean Image Accuracy 与 Global Accuracy。
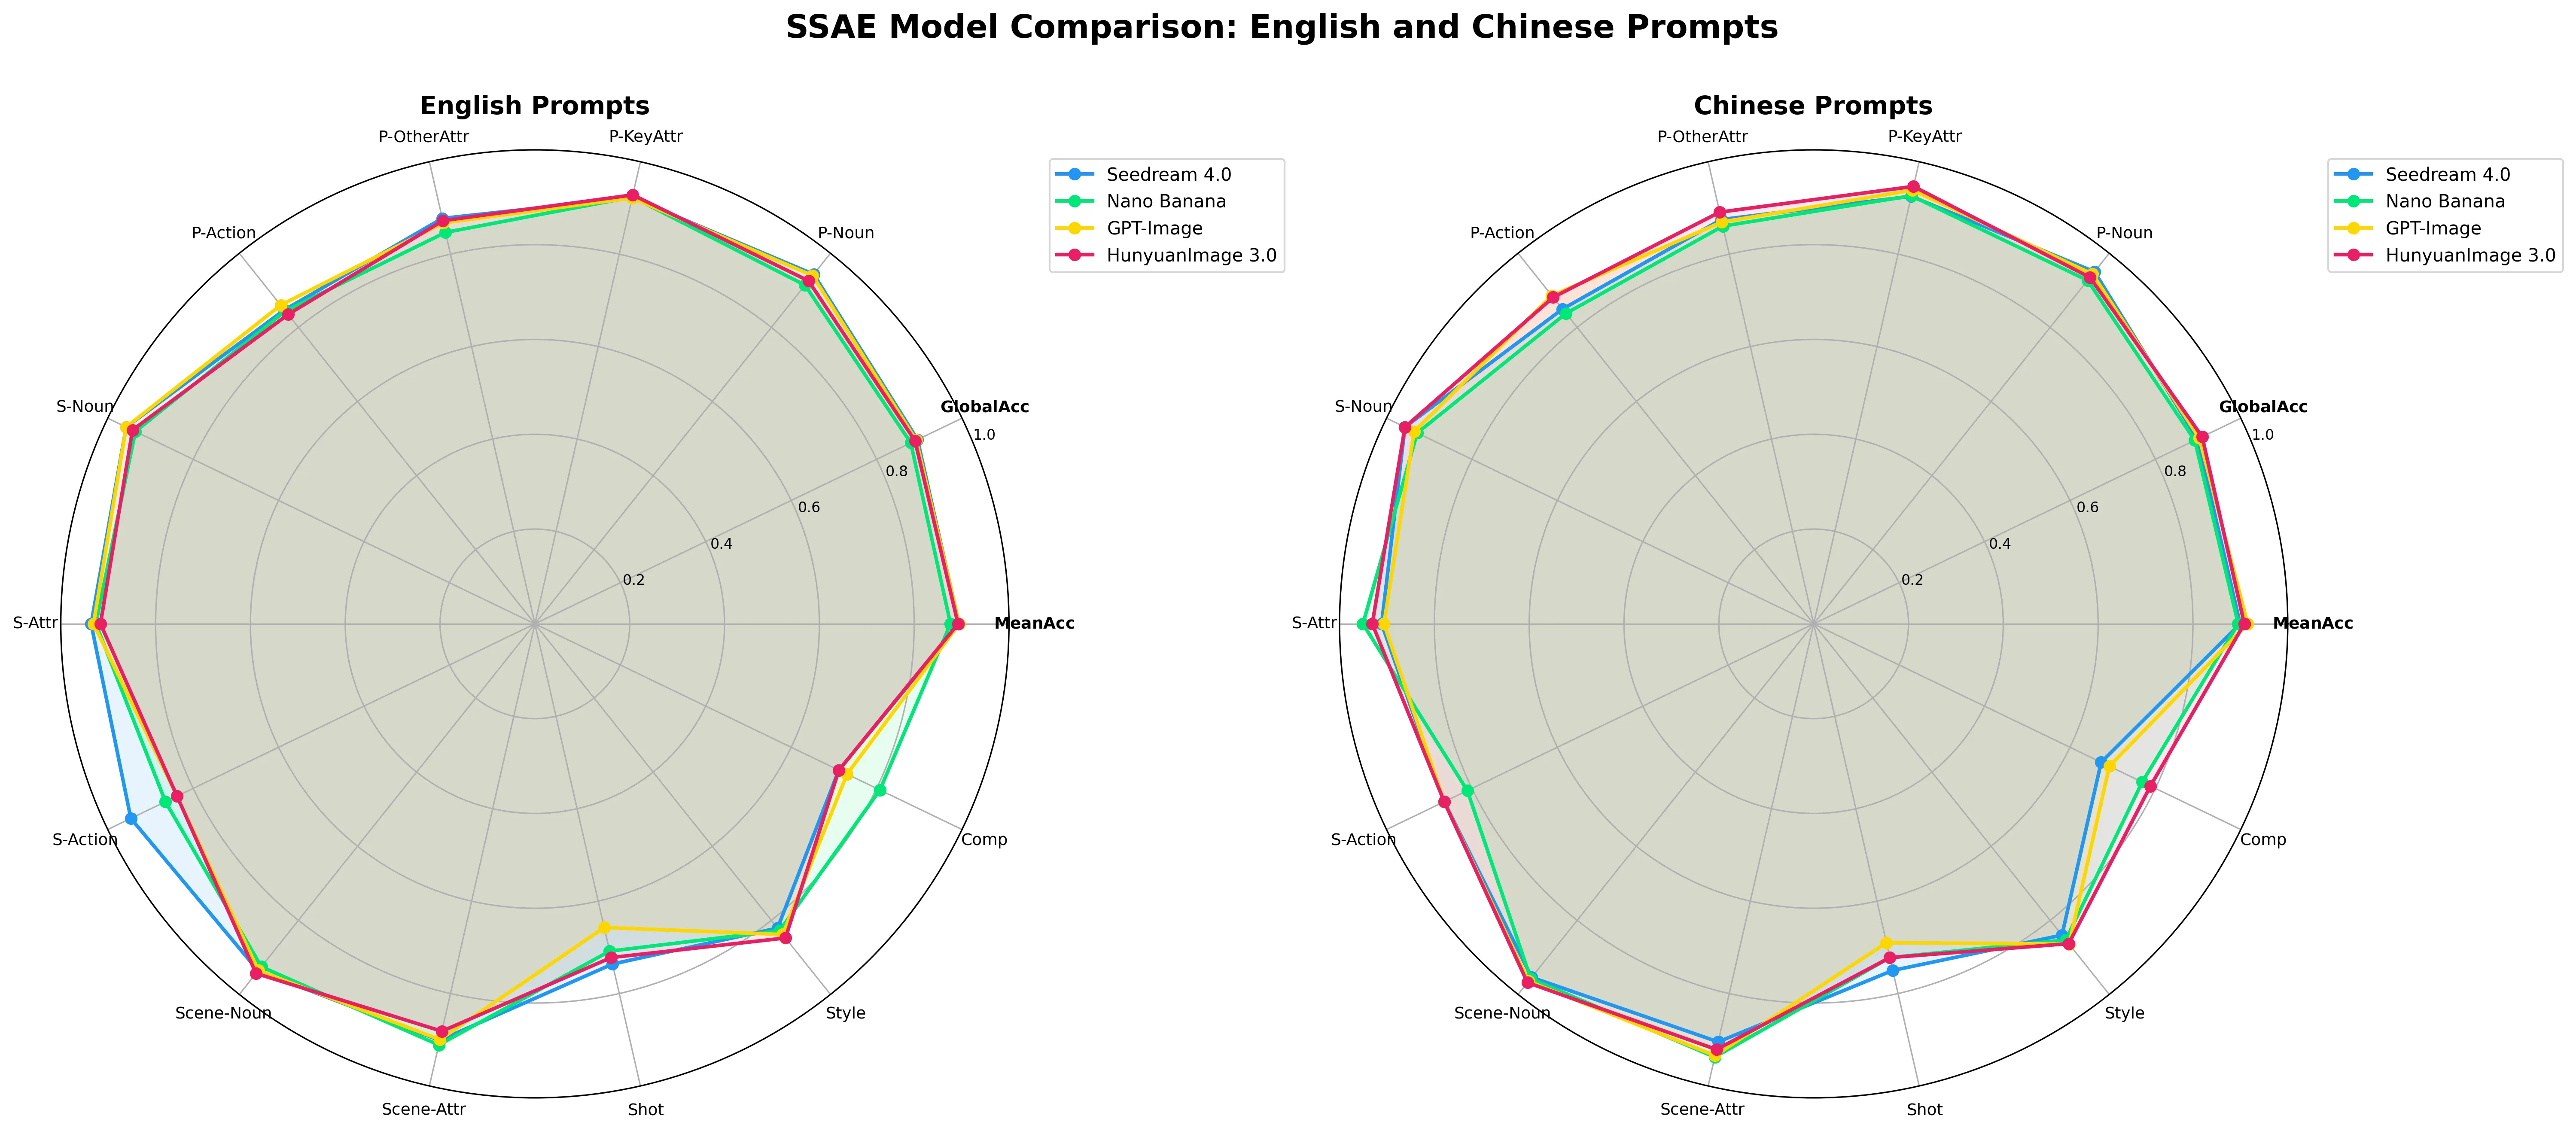
Figure 6:SSAE 评测结果——HunyuanImage 3.0 在所有细粒度字段上与领先模型持平。
6.2 GSB(Good/Same/Bad 人类评测)
1000 条平衡 prompt,每模型单次推理不 cherry-pick,100+ 专业评测者。
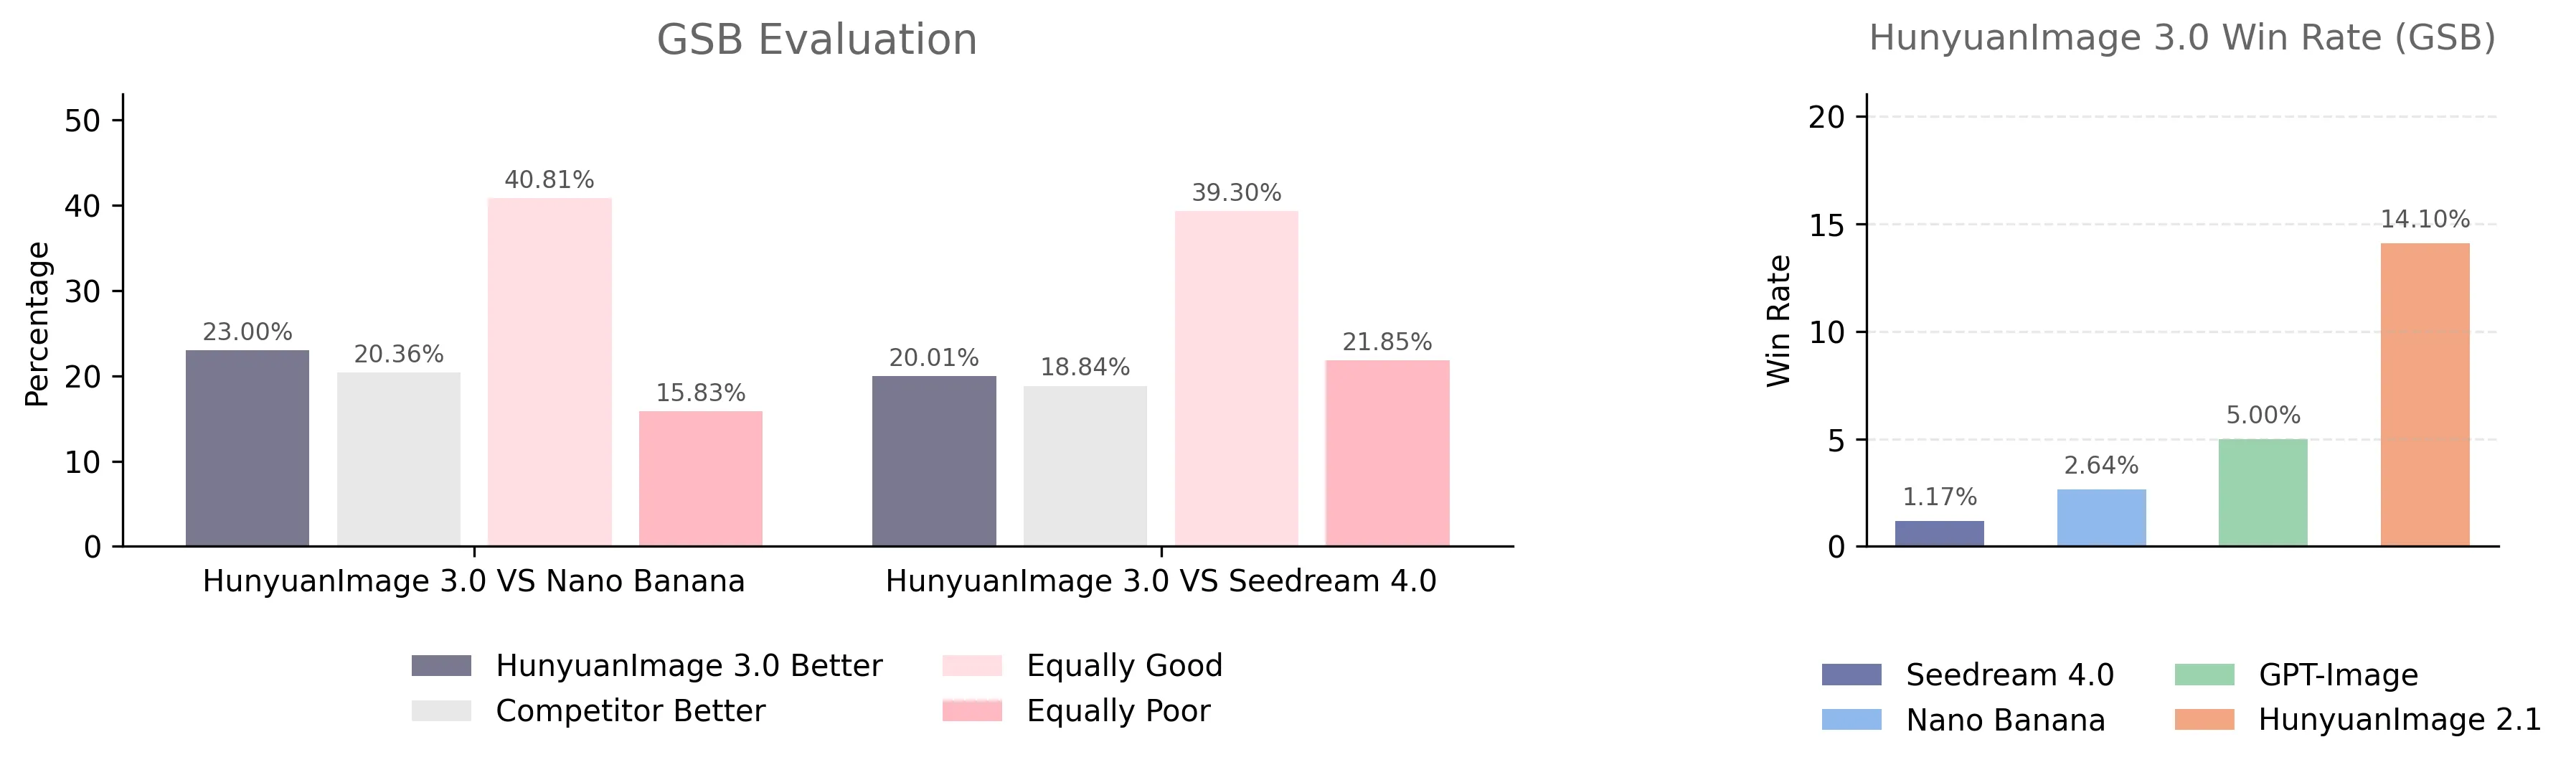
Figure 7:GSB 评测结果。
- 相对 HunyuanImage 2.1(此前最强开源)相对胜率 +14.10%,确立为最强开源文生图模型;
- 相对 Seedream 4.0 / Nano Banana / GPT-Image 相对胜率 +1.17% / +2.64% / +5.00%——开源模型达到与领先闭源商业模型相当的水平。
6.3 专家激活分析(发现)
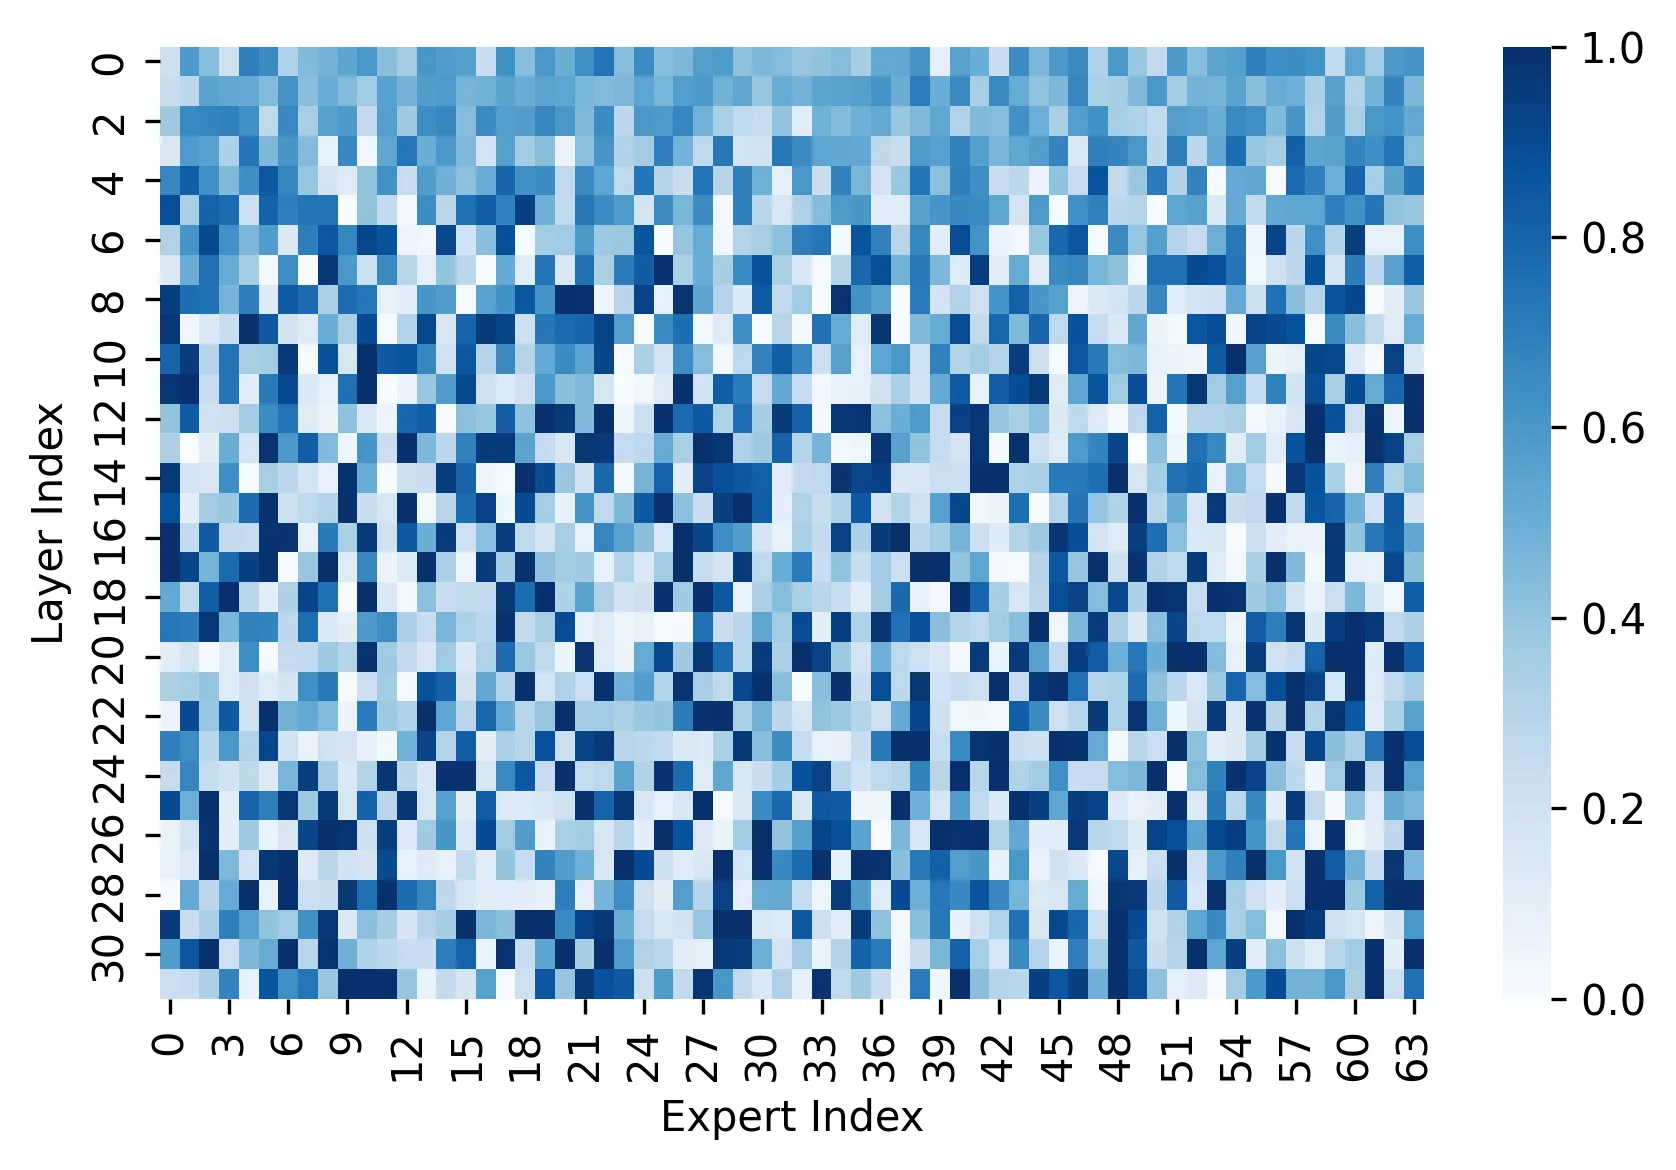
Figure 8:左:专家的图像 token 偏好热图(越深越专于图像 token);右:各层图/文激活专家分布的 KL 散度——层越深散度越大,专家跨模态分化越明显。
随机选 1000 prompt 做文生图统计发现:专家逐渐专门化于各自模态,层越深图/文专家激活分布 KL 散度越大。说明 MoE 可通过将不同模态职责分散给专门专家来增强多模态建模。
七、总结
核心贡献
- 原生多模态统一框架:以 MoE LLM 为基座,在单一自回归序列内统一多模态理解与生成(类 Transfusion 嵌入扩散);
- 双编码器统一表示:拼接 VAE + vision encoder 特征,支持交错对话/生成/理解/编辑,无需切换流水线;
- 原生 CoT 图像生成:T2T + T2TI 数据激活自动化”思考-改写-生成”流程;
- 关键架构设计:16× 下采样 VAE、广义因果注意力、向后兼容的广义 2D RoPE、自动尺寸/比例 token;
- 系统训练与部署:四阶段渐进预训练 + SFT/DPO/MixGRPO/SRPO/ReDA 后训练;MeanFlow 蒸馏(NFE 4-8)+ TMP 剪枝(80B→20B,单卡 4090 部署);
- 最大开源图像生成模型:80B/13B-激活 MoE,GSB 上超越 HunyuanImage 2.1 并媲美 GPT-Image、Nano Banana 等闭源模型。
技术影响
HunyuanImage 3.0 验证了”以强 LLM 为基座、原生统一理解与生成”路线的可行性与优越性,将 CoT 推理引入图像生成,并开源了迄今最大的图像生成模型,为多模态生态提供了 SOTA 基础模型。
局限性
- 当前仅发布文生图能力,图生图(编辑/ID 保持)训练进行中;
- 80B 规模部署成本高(虽经蒸馏+剪枝可降至单卡 4090);
- SSAE/GSB 为自研评测,与既有公开基准的横向可比性有待社区验证。
八、参考资源
- 论文:https://arxiv.org/abs/2509.23951
- 相关:Hunyuan-A13B、Transfusion、JanusFlow、DiT、MeanFlow、MixGRPO、SRPO