MinerU2.5: A Decoupled Vision-Language Model for Efficient High-Resolution Document Parsing
解耦视觉语言模型,通过粗到细两阶段策略实现高效高分辨率文档解析
MinerU2.5: A Decoupled Vision-Language Model for Efficient High-Resolution Document Parsing
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MinerU2.5: A Decoupled Vision-Language Model for Efficient High-Resolution Document Parsing |
| 作者 | Junbo Niu, Zheng Liu, Zhuangcheng Gu, Bin Wang, … Conghui He |
| 机构 | Shanghai AI Laboratory, OpenDataLab |
| 论文 | arXiv:2509.22186 |
| 发布 | 2025-09-26 |
| 主题 | cs.CV (Computer Vision) |
| 代码 | GitHub - opendatalab/MinerU |
| 模型 | MinerU2.5-2509-1.2B |
二、核心思想
问题定义
文档解析是多模态理解的基础任务,支撑信息提取、RAG和智能文档分析等下游应用。与自然图像相比,文档图像具有更高分辨率、更密集内容和更复杂布局的特点。
现有方法的挑战:
| 方法类型 | 代表 | 问题 |
|---|---|---|
| Pipeline方法 | Marker, MinerU | 工作流繁琐,错误累积 |
| 端到端VLM | GOT, olmOCR | 高分辨率token冗余,计算开销大 |
| 多阶段VLM | Dolphin | 固定分辨率限制裁剪解析 |
核心观察
高分辨率文档解析的困境:
- 裁剪方法:减少计算但牺牲语义一致性和布局信息
- 原生分辨率方法:保留细节但token数量呈复杂度
解决方案概述
MinerU2.5:1.2B参数的解耦文档解析VLM。
核心创新:粗到细的两阶段解析策略,解耦全局布局分析和局部内容识别。
关键改进:
- 全面精细的布局分析(包含页眉页脚等)
- 公式解析突破(复杂长公式、中英混合公式)
- 表格解析鲁棒性增强(旋转、无框、部分边框表格)
- 高效推理(2.12 pages/s on A100)
三、技术架构
整体框架
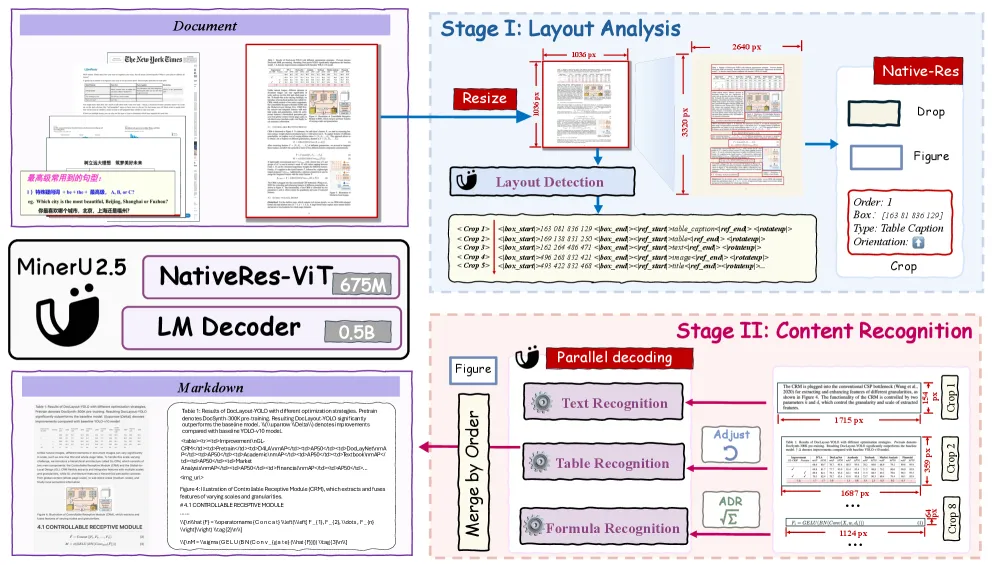
Figure 2: MinerU2.5框架示意图。
架构组件:
- 视觉编码器:675M NaViT(从Qwen2-VL初始化),支持动态分辨率,2D-RoPE
- Patch Merger:Pixel-unshuffle处理相邻2×2视觉token
- 语言模型:0.5B Qwen2-Instruct,M-RoPE位置编码
两阶段解析策略
Stage I:全局布局分析
输入:图像统一缩放至1036×1036缩略图
目标:高效识别结构化元素,控制计算成本
关键设计:
- 固定缩略图尺寸确保稳定的计算量
- 避免原生宽高比缩略图导致的分辨率波动
- 预测四个关键属性:类别标签、边界框、旋转角度、阅读顺序
Stage II:局部内容识别
输入:根据布局裁剪的原生分辨率区域(上限2048×28×28像素)
目标:精细粒度解析,保留密集文本、复杂公式和表格的细节
优势:
- 避免过小裁剪的细节丢失
- 防止过大裁剪的冗余计算
- 准确率和效率的鲁棒权衡
性能亮点
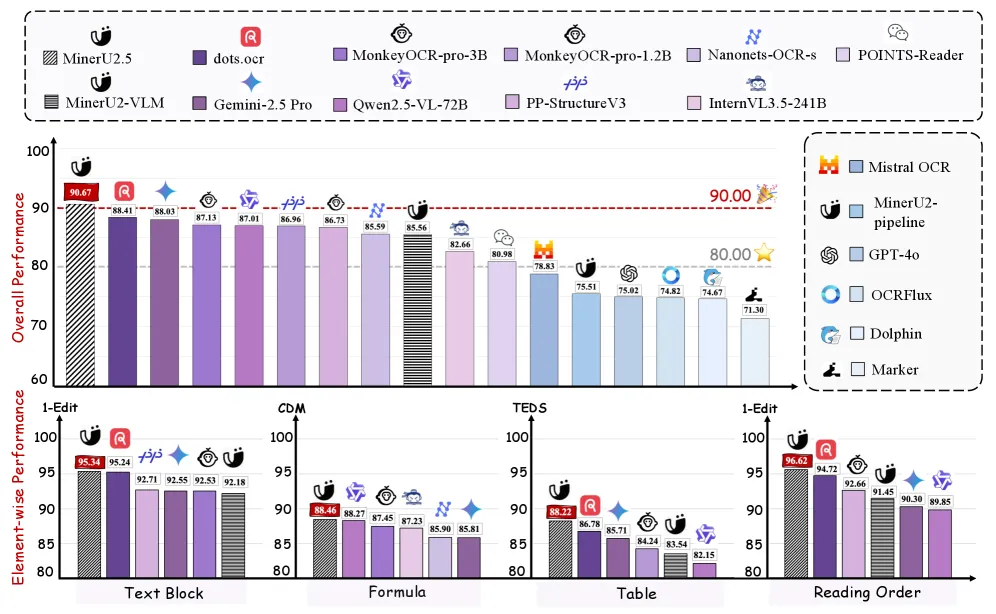
Figure 1: MinerU2.5在OmniDocBench上的性能亮点。
四、数据引擎
整体流程
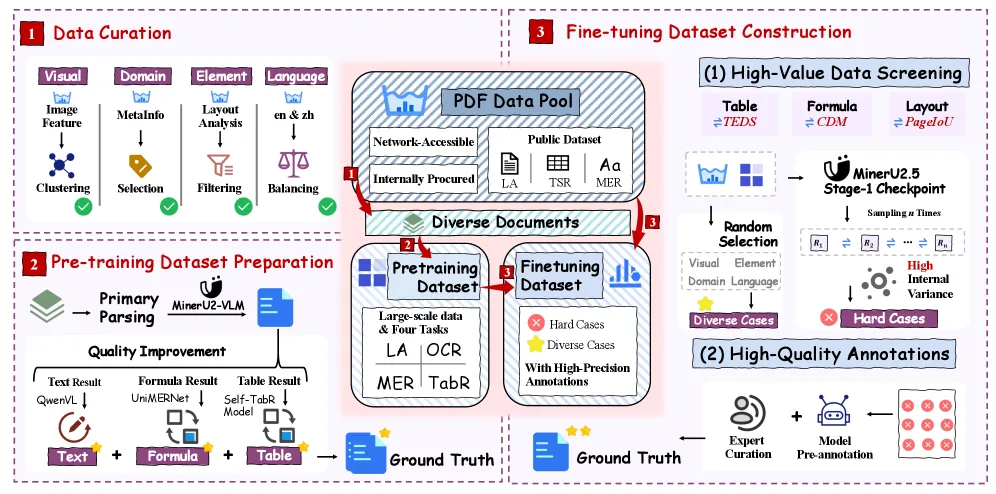
Figure 3: 数据引擎概述。
三个核心阶段:
- 数据整理:大规模多样化文档池构建
- 自动化标注:高质量预训练数据生成
- IMIC策略:迭代挖掘难例进行微调
数据整理策略
| 维度 | 方法 |
|---|---|
| 布局多样性 | 页面级图像聚类选择 |
| 文档类型多样性 | 元数据分层抽样 |
| 元素平衡 | 初步检测模型确保类别平衡 |
| 语言平衡 | 中英文文档数量可比 |
标注精炼流程
| 内容类型 | 精炼方法 |
|---|---|
| 文本内容 | Qwen2.5-VL-72B-Instruct验证纠正 |
| 公式内容 | 内部UniMERNet模型替换 |
| 表格内容 | 内部高性能表格解析模型重新生成 |
IMIC策略
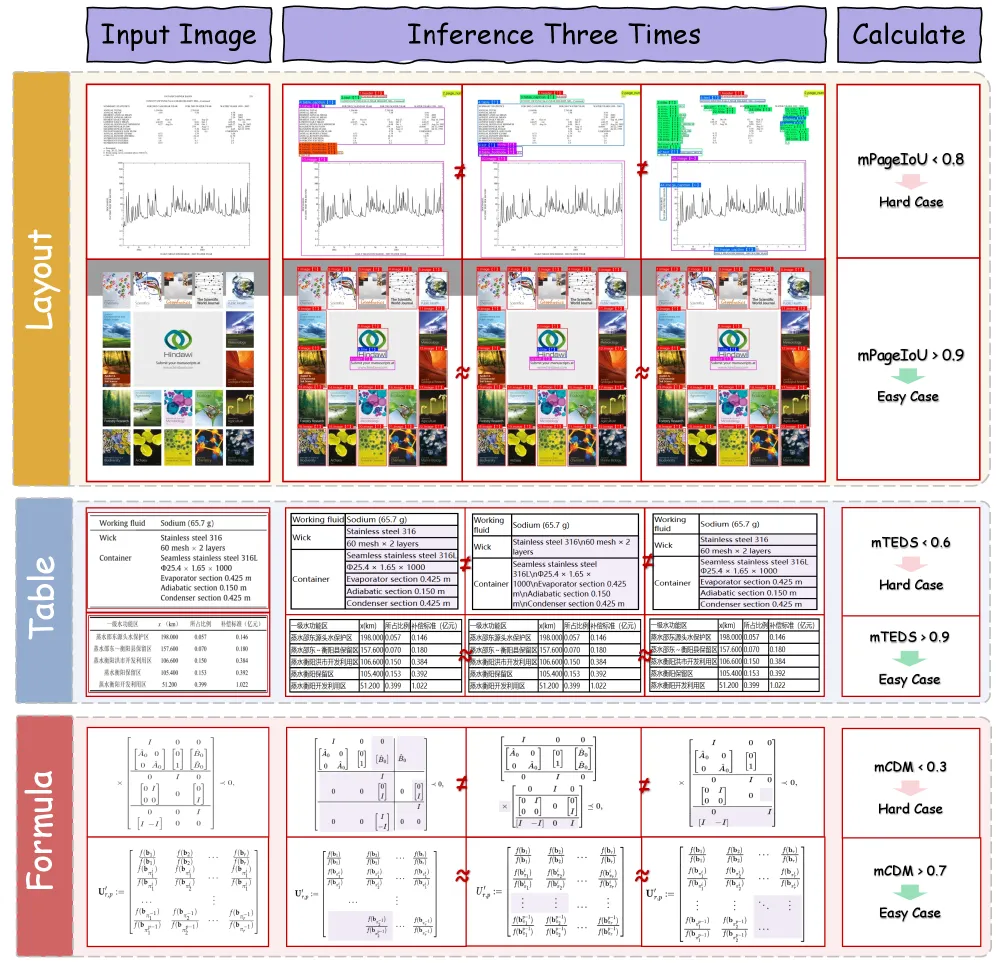
Figure 7: IMIC(迭代推理一致性挖掘)策略示意图。
核心原理:如果模型已充分学习样本特征,多次随机采样推理应产生高度一致的输出。输出差异大的样本为”难例”,最有价值进行人工标注。
各任务一致性评估:
| 任务 | 一致性指标 |
|---|---|
| 布局分析 | 成对PageIoU |
| 公式识别 | 成对CDM |
| 表格识别 | TEDS分数 |
五、技术创新
5.1 统一标签系统
设计原则:
- 全面覆盖:包含页眉、页脚、页码等非正文元素
- 精细粒度:图像细分为image/chart/chemical_structure
- 语义区分:代码、算法、参考文献、列表独立分类
Table 4: 标签系统对比
| 类别 | MinerU2-pipeline | PaddleOCR | MinerU2.5 |
|---|---|---|---|
| 文本 | text | text, toc, abstract | text |
| 标题 | title | title, page_title | title |
| 代码 | ✗ | code | code |
| 算法 | ✗ | ✗ | algorithm |
| 参考文献 | ✗ | ref_text, ref_block | reference |
| 列表 | ✗ | ✗ | list |
5.2 PageIoU指标
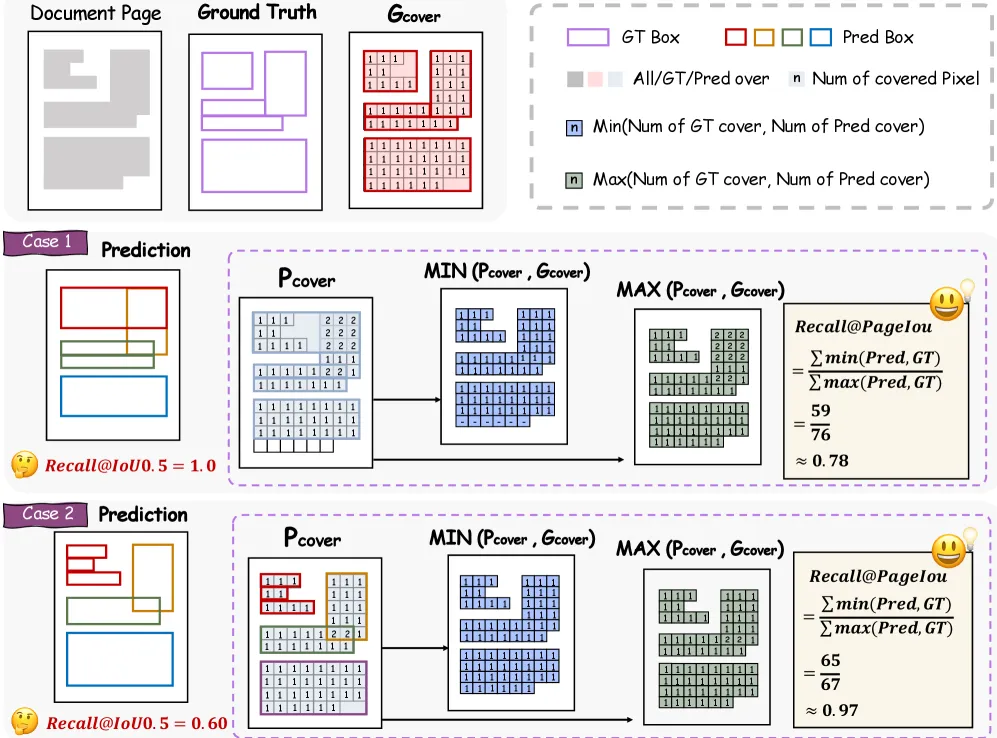
Figure 4: PageIoU指标示意图。
问题:传统IoU阈值评估不适合文档布局(文本块边界模糊)。
PageIoU定义:页面级覆盖度量,测量预测布局与真注的空间一致性。
优势:与人类感知对齐,粗略覆盖0.78分,精确匹配0.97分。
5.3 ADR框架(原子分解与重组)
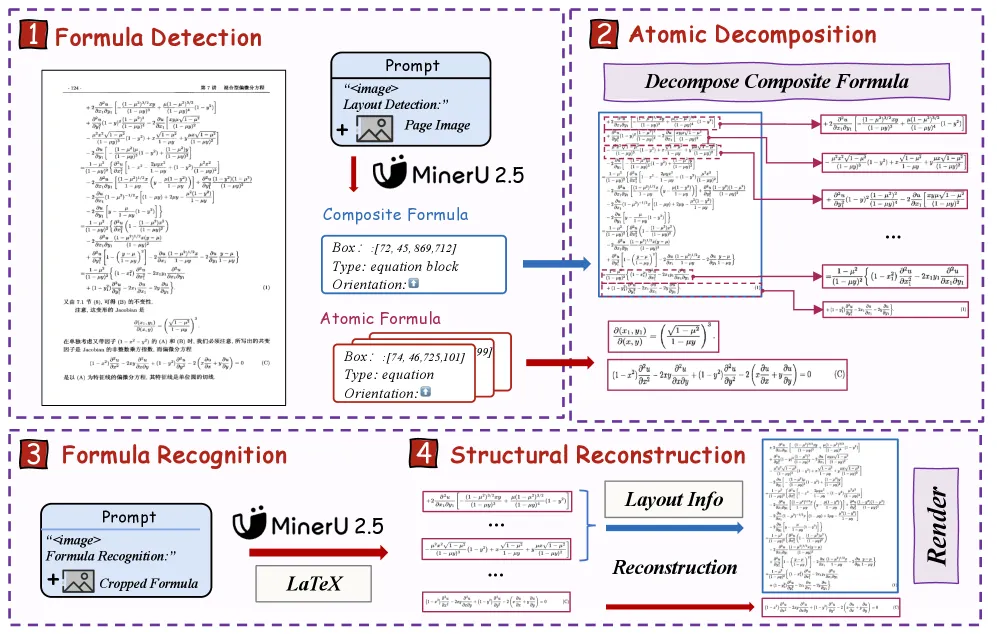
Figure 5: ADR框架示意图。
公式分类:
- 原子公式:最小不可分语义单元,紧密2D拓扑(如单个分数、矩阵)
- 复合公式:垂直排列的原子公式集合(如多行推导)
ADR流程:
- 初始布局分析,识别复合公式区域
- 分解为原子公式行
- 独立识别每个原子公式
- 重组为完整公式
优势:克服VLM处理长/多行公式时的结构幻觉问题。
5.4 OTSL表格识别
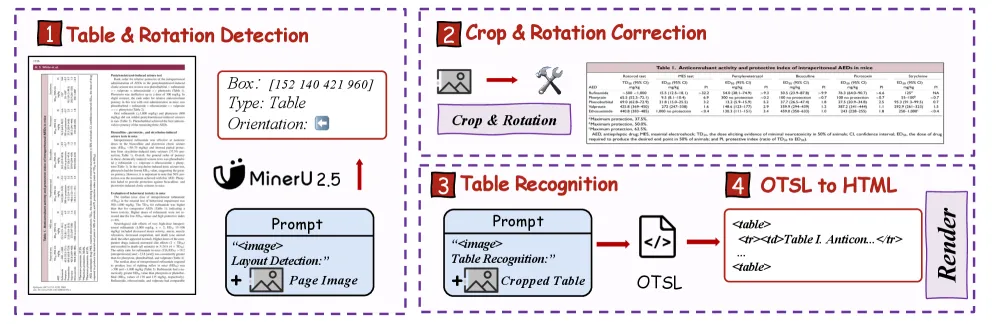
Figure 6: 表格识别流程。
四阶段流程:
- 检测表格边界框和旋转角度
- 裁剪和旋转校正
- 使用OTSL(优化表格结构语言)识别
- 转换为目标格式
OTSL优势:
- 比HTML更简洁的中间表示
- 减少token冗余
- 更好处理复杂长表格
六、实验结果
推理性能
Table 3: 推理性能对比
| 模型 | 参数 | 后端 | 硬件 | Tokens/s | Pages/s |
|---|---|---|---|---|---|
| MinerU2-VLM | 0.9B | SGLang | A100 80G | 3091.23 | 2.84 |
| dots.ocr | 3.0B | vLLM | - | 311.06 | 0.28 |
| MonkeyOCR-pro-3B | 3.7B | - | - | 520.16 | 0.47 |
| MinerU2.5 | 1.2B | vLLM | RTX 4090 | 1875.82 | 1.70 |
| A100 80G | 2337.25 | 2.12 | |||
| H200 141G | 4938.31 | 4.47 |
关键结果:
- 1.2B参数实现2.12 pages/s(A100)
- 比3B+模型快4-8倍
OmniDocBench结果
Table 5: OmniDocBench全面评估
| 模型 | 参数 | Overall↑ | TextEdit↓ | FormulaCDM↑ | TableTEDS↑ | ReadOrderEdit↓ |
|---|---|---|---|---|---|---|
| MinerU2-pipeline | - | 75.51 | 0.209 | 76.55 | 70.90 | 0.225 |
| Qwen2.5-VL-72B | 72B | 87.02 | 0.094 | 88.27 | 82.15 | 0.102 |
| Gemini-2.5 Pro | - | 88.03 | 0.075 | 85.82 | 85.71 | 0.097 |
| dots.ocr | 3B | 87.19 | 0.069 | 89.12 | 83.37 | 0.088 |
| MonkeyOCR-pro-3B | 3.7B | 88.24 | 0.062 | 89.98 | 84.16 | 0.083 |
| MinerU2.5 | 1.2B | 88.58 | 0.060 | 90.46 | 85.86 | 0.073 |
关键结果:
- 1.2B参数超越72B通用VLM和3B+专用VLM
- 文本编辑距离最低(0.060)
- 公式CDM最高(90.46)
- 表格TEDS最高(85.86)
文本解析详细结果
Table 6: 不同文档类型文本编辑距离
| 模型 | Slides | Academic | Book | Textbook | Exam | Magazine | Newspaper | Notes | Financial |
|---|---|---|---|---|---|---|---|---|---|
| GPT-4o | 0.1019 | 0.1203 | 0.1288 | 0.1599 | 0.1939 | 0.142 | 0.6254 | 0.2611 | 0.3343 |
| Gemini-2.5 Pro | 0.0326 | 0.0182 | 0.0694 | 0.1618 | 0.0937 | 0.0161 | 0.1347 | 0.1169 | 0.0169 |
| Qwen2.5-VL-72B | 0.0422 | 0.0801 | 0.0586 | 0.1146 | 0.0681 | 0.0964 | 0.238 | 0.1232 | 0.0264 |
| MinerU2.5 | 0.0122 | 0.0120 | 0.0189 | 0.0650 | 0.0448 | 0.0161 | 0.1050 | 0.0462 | 0.0113 |
关键发现:MinerU2.5在所有9种文档类型上均达到最低编辑距离。
Ocean-OCR结果
Table 7: Ocean-OCR基准测试
| 模型 | 英文Edit↓ | 中文Edit↓ | 英文F1↑ | 中文F1↑ |
|---|---|---|---|---|
| Gemini-2.5 Pro | 0.080 | 0.204 | 0.922 | 0.927 |
| Qwen2.5-VL-72B | 0.093 | 0.140 | 0.923 | 0.940 |
| Ocean-OCR | 0.057 | 0.062 | 0.937 | 0.962 |
| MinerU2.5 | 0.045 | 0.059 | 0.944 | 0.964 |
关键结果:
- 英文和中文均达到最低编辑距离
- 中文解析能力显著提升
olmOCR-bench结果
Table 8: olmOCR-bench详细结果
| 模型 | Overall | AR | OSM | TA | OS | HF | MC | LTT | Base |
|---|---|---|---|---|---|---|---|---|---|
| Qwen2.5-VL-72B | 64.8 | 72.2 | 51.1 | 67.3 | 38.6 | 73.6 | 68.3 | 49.1 | 98.3 |
| olmOCR | 71.8 | 63.9 | 41.0 | 72.9 | 43.9 | 95.1 | 77.3 | 81.2 | 98.9 |
| dots.ocr | 73.6 | 66.3 | 35.8 | 88.3 | 40.9 | 94.1 | 82.4 | 81.2 | 99.5 |
| MinerU2.5 | 75.2 | 76.6 | 54.6 | 84.9 | 33.7 | 96.6 | 78.2 | 83.5 | 93.7 |
关键结果:
- 总体准确率75.2%,超越所有基线
- arXiv数学(76.6%)和旧扫描数学(54.6%)显著领先
- 表格识别(84.9%)仅次于dots.ocr
布局分析性能
Table 9: 布局分析性能(OmniDocBench)
| 方法 | Textual F1↑ | Image F1↑ | Table F1↑ | Equation F1↑ | Full Page F1↑ |
|---|---|---|---|---|---|
| DocLayout-YOLO | 96.5 | 94.7 | 98.4 | 93.8 | 94.1 |
| PP-StructureV3 | 96.6 | 92.9 | 98.2 | 96.7 | 94.6 |
| MinerU2.5 | 97.5 | 95.0 | 98.4 | 94.7 | 95.9 |
表格识别性能
Table 10: 表格识别TEDS分数
| 方法 | PubTabNet↑ | FinTabNet↑ | CC-OCR↑ | OCRBench v2↑ |
|---|---|---|---|---|
| Qwen2.5-VL-72B | 84.39 | 82.90 | 81.22 | 81.33 |
| MiniCPM-V 4.5 | 80.30 | 85.41 | 68.49 | 80.28 |
| MinerU2.5 | 88.64 | 87.91 | 82.22 | 83.88 |
关键结果:在大多数基准上达到SOTA。
训练配置
Table 1: 训练阶段和超参数
| 阶段 | 数据 | 样本数 | 训练参数 | Epoch |
|---|---|---|---|---|
| Stage-0a | Image Caption | 558K | MLP Adaptor | 1 |
| Stage-0b | VQA | 665K | All | 1 |
| Stage-1 | Layout & OCR | 6.9M | All | 2 |
| Stage-2 | Layout & OCR (难例) | 630K | All | 3 |
七、核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| 两阶段解耦 | 布局分析+内容识别分离 | 效率和准确性双赢 |
| PageIoU指标 | 页面级覆盖度量 | 与人类感知对齐 |
| ADR框架 | 原子分解与重组 | 复杂公式解析突破 |
| OTSL表示 | 优化表格结构语言 | 复杂表格识别提升 |
| IMIC策略 | 迭代推理一致性挖掘 | 高效难例挖掘 |
| 统一标签系统 | 全面精细分类 | 布局分析标准化 |
八、与相关方法对比
| 方法 | 参数 | 特点 | MinerU2.5优势 |
|---|---|---|---|
| GPT-4o | - | 通用VLM | 更高精度,更低成本 |
| Gemini-2.5 Pro | - | 通用VLM | 更高精度,开源可用 |
| Qwen2.5-VL-72B | 72B | 通用VLM | 60×更小,更高精度 |
| dots.ocr | 3B | 专用VLM | 2.5×更小,更高精度 |
| MonkeyOCR | 3.7B | 多阶段VLM | 3×更小,更高精度 |
| olmOCR | 7B | 专用VLM | 6×更小,更高精度 |
九、局限性
- 模型规模:1.2B参数仍有一定推理开销
- 旋转文档:极端旋转角度处理仍有挑战
- 手写文档:未专门优化手写体识别
- 多语言:主要验证中英文,其他语言效果待验证
十、总结
核心贡献
- 解耦架构:首次在VLM中实现布局分析和内容识别的有效解耦
- 两阶段策略:粗到细解析,效率和准确性双赢
- 数据引擎:系统化的高质量数据生成流程
- 技术创新:PageIoU、ADR、OTSL等多项创新
- SOTA性能:1.2B参数超越72B通用VLM
性能总结
| 指标 | 数值 | 对比 |
|---|---|---|
| OmniDocBench Overall | 88.58 | vs Gemini-2.5 Pro 88.03 |
| olmOCR-bench | 75.2 | vs dots.ocr 73.6 |
| 推理速度 | 2.12 pages/s | vs dots.ocr 0.28 pages/s |
| 参数量 | 1.2B | vs Qwen2.5-VL-72B 72B |
技术影响
MinerU2.5展示了专用小模型超越通用大模型的可能性:
- 解耦设计:复杂任务分解为简单子任务
- 数据质量:系统化数据引擎比模型规模更重要
- 效率优先:实际部署中速度和成本是关键
- 开源可用:推动文档解析技术普及
十一、参考资源
- 论文: arXiv:2509.22186
- 代码: GitHub - opendatalab/MinerU
- 模型: MinerU2.5-2509-1.2B
- 相关工作:
- Qwen2-VL - 基础VLM架构
- UniMERNet - 公式识别
- OmniDocBench - 评估基准