Elastic MoE: Unlocking the Inference-Time Scalability of Mixture-of-Experts
通过随机共激活采样和层次化路由器损失,实现MoE模型推理时弹性扩展,有效扩展范围达训练时k的2-3倍
Elastic MoE: Unlocking the Inference-Time Scalability of Mixture-of-Experts
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Elastic MoE: Unlocking the Inference-Time Scalability of Mixture-of-Experts |
| 作者 | Naibin Gu, Zhenyu Zhang, Yuchen Feng, Yilong Chen, Peng Fu, Zheng Lin, Shuohuan Wang, Yu Sun, Hua Wu, Weiping Wang, Haifeng Wang |
| 机构 | 未明确标注(推测为百度/哈工大) |
| 论文 | arXiv:2509.21892 |
| 发布 | 2025-09-26 (v1), 2026-05-11 (v2) |
| 领域 | 计算与语言 (cs.CL) |
| 投稿 | NeurIPS |
二、核心思想
问题定义
MoE模型通常在训练和推理时固定激活专家数量 。然而,实际部署面临异构硬件、波动工作负载和多样化质量-延迟需求,为每种场景训练单独模型成本高昂。考虑到MoE模型 already operates with sparse activation,调整激活专家数量提供了一条自然路径来服务不同预算。
核心问题:能否通过在推理时激活更多专家来释放MoE模型的潜力?
核心发现
推理时扩展墙(Inference-Time Scaling Wall):
标准MoE模型无法支持弹性推理。当模型用 个专家训练时,推理时的有效扩展范围极其狭窄——将 增加到略大于 时,性能会迅速下降。
根本原因:专家之间缺乏 learned collaboration。通过专家共现矩阵分析发现,训练时和推理时的专家激活模式存在显著差异。
解决方案概述
Elastic MoE (EMoE) 是一个新颖的训练框架,使MoE模型能够在推理时弹性变化激活专家数量:
- 随机共激活采样(Stochastic Co-activation Sampling):将训练预算 与组合覆盖 解耦,通过从更大候选池中采样来暴露模型于多样化的专家组合
- 层次化路由器损失(Hierarchical Router Loss):鼓励路由器产生稳定、果断的专家排名,确保在不同推理预算下的可靠性能
核心结果:
- 有效扩展范围达训练时 的 2-3×
- 性能随推理预算单调递增
- 无需额外训练开销
- 适用于4种MoE架构(7B-21B)和9个基准测试
三、技术架构
推理时扩展墙现象
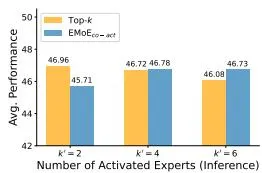
关键观察:
- 当推理时激活专家数 超过训练预算 时,性能短暂保持后迅速下降
- 更大的训练预算(如 )虽然移动了峰值,但计算成本 prohibitive
- 回到原始推理预算时性能崩溃
专家共现分析
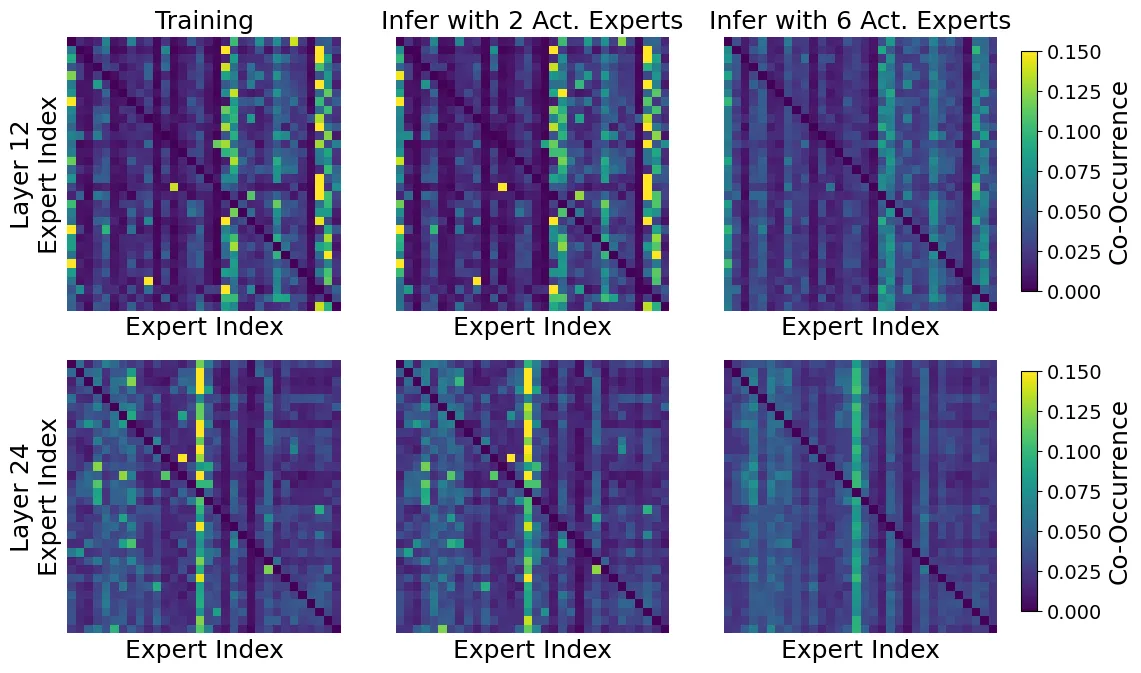
专家共现矩阵 :
- 训练时 的专家共现模式与推理时 存在巨大差异
- 共现距离与模型性能强相关
EMoE架构
EMoE vs 标准Top-k MoE:
| 组件 | 标准Top-k MoE | EMoE |
|---|---|---|
| 专家选择 | 固定top-k | 候选池 + 随机采样 |
| 训练预算 | (相同) | |
| 组合覆盖 | 仅top-k组合 | 多样化组合() |
| 路由器损失 | 标准 + 负载均衡 | + 层次化损失 |
| 推理弹性 | 无 | 2-3× 扩展范围 |
随机共激活采样
核心思想:将训练预算与组合覆盖解耦。
算法流程:
-
确定候选池大小:
-
选择候选专家:
-
采样子集用于计算:
-
计算MoE输出:
关键创新:
- 训练时只计算 个专家(保持训练效率)
- 但从大小为 的候选池中采样(覆盖多样化组合)
- 多个训练步骤提供随机近似,捕捉多样化专家组合
层次化路由器损失
问题:路由器在低推理预算下无法做出有效选择,因为专家权重接近均匀分布。
解决方案:鼓励路由器分布远离均匀分布。
其中 , 为均匀分布。
为什么用反向KL而非前向KL:
- 前向KL梯度:,当 很小时梯度爆炸
- 反向KL梯度:,更平滑
效果:
- 产生清晰、层次化的专家排名
- 少量专家或大量专家激活时都能可靠工作
- 熵从7.09降至5.78(数学),从8.63降至7.87(常识)
总损失函数
其中:
- :交叉熵损失
- :负载均衡损失
- :层次化路由器损失
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 推理时扩展墙 | 首次发现标准MoE无法弹性扩展的现象 | 共现矩阵分析 |
| 随机共激活采样 | 解耦训练预算与组合覆盖 | 蒙特卡洛采样思想 |
| 层次化路由器损失 | 鼓励果断的专家排名 | 反向KL正则化 |
| 零额外训练开销 | EMoE与标准Top-k训练成本相同 | 仅在非密集计算部分引入 |
| 通用性 | 适用于LoRA和FFN两种MoE场景 | 4种架构验证 |
五、实验结果
实验设置
模型:
- LoRA-based:LLaMA2-7B + 32 LoRA专家,
- FFN-based:
- OLMoE-1B-7B-0924:
- DeepSeek-V2-Lite:(含共享专家)
- ERNIE-4.5-21B-A3B
基准测试(9个): ARC-c, ARC-e, GSM8K, HellaSwag, HumanEval, NQ, TriviaQA, WinoGrande, MMLU
基线:
- 标准Top-k MoE
- Top-p routing
- AdaMoE
主要结果
Table 1: EMoE vs Top-k 在不同模型上
| 模型 | 方法 | k’=1 | k’=2 | k’=4 | k’=6 |
|---|---|---|---|---|---|
| LoRAMoE | Top-k | 45.48 | 47.88 | 48.05 | 47.57 ↓ |
| LoRAMoE | EMoE | 45.68 | 48.22 | 49.00 | 49.50 ↑ |
| OLMoE | Top-k | - | - | 35.31 | - |
| OLMoE | EMoE | - | - | 37.81 | - |
关键发现:
- Top-k模型在 时性能下降(推理时扩展墙)
- EMoE性能随 单调递增
- 在所有模型架构上一致有效
动态路由方法对比
Table 2: 与Top-p和AdaMoE对比
| 方法 | k’=1 | k’=2 | k’=4 | k’=6 |
|---|---|---|---|---|
| Top-k | 45.48 | 47.88 | 48.05 | 47.57 |
| Top-p | 46.09 | 47.04 | 48.10 | 47.48 |
| AdaMoE | 41.34 | 47.18 | 48.54 | 48.52 |
| EMoE | 45.68 | 48.22 | 49.00 | 49.50 |
关键发现:
- 动态路由方法(Top-p, AdaMoE)在固定预算内优化,但无法突破扩展墙
- EMoE专为可变和可扩展计算资源设计
消融实验
Table 3: EMoE组件消融
| 方法 | k’=1 | k’=2 | k’=4 | k’=6 |
|---|---|---|---|---|
| Top-k | 45.48 | 47.88 | 48.05 | 47.57 |
| EMoE | 45.68 | 48.22 | 49.00 | 49.50 |
| w/o co-act. | 45.83 | 48.03 | 48.68 | 48.15 |
| w/o | 45.19 | 47.79 | 48.81 | 49.08 |
关键发现:
- 去掉co-activation sampling: 时性能下降(协作失败)
- 去掉 : 时性能下降(排名不稳定)
- 两者缺一不可
超参数分析
关键发现:
- 已能获得显著增益
- 最佳范围:
- 过大的 导致收益递减
训练效率
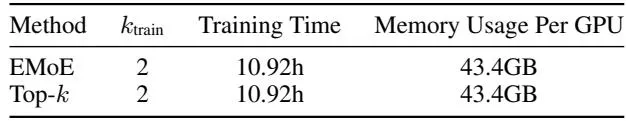
Table 9: 训练开销对比
| 方法 | 训练时间 | GPU内存 | |
|---|---|---|---|
| EMoE | 2 | 10.92h | 43.4GB |
| Top-k | 2 | 10.92h | 43.4GB |
关键发现:EMoE训练开销与标准Top-k完全相同。
与大 训练对比
Table 4: EMoE vs 大 训练
| 方法 | k’=1 | k’=2 | k’=4 | k’=6 | GPU内存 |
|---|---|---|---|---|---|
| Top-k () | 42.87 | 46.26 | 48.30 | 49.14 | 76.0GB |
| EMoE () | 45.68 | 48.22 | 49.00 | 49.50 | 43.4GB |
关键发现:
- 大 训练缺乏弹性( 时性能下降)
- 训练成本高3×
- EMoE在更低成本下实现更好性能
六、相关工作
| 方法 | 特点 | EMoE优势 |
|---|---|---|
| 标准Top-k MoE | 固定激活专家数 | 无弹性 |
| 动态路由 (Top-p, AdaMoE) | token间重分配计算 | 固定预算内优化 |
| 专家剪枝 | 提取子网络 | 精度损失大 |
| 推理时深度扩展 | 增加推理链长度 | 不同维度 |
| EMoE | 弹性专家激活 | 2-3×扩展范围 |
七、总结
核心贡献
- 发现推理时扩展墙:首次揭示标准MoE模型无法弹性扩展的现象,并通过专家共现分析诊断根因
- 随机共激活采样:将训练预算与组合覆盖解耦,用标准训练成本覆盖多样化专家组合
- 层次化路由器损失:通过反向KL正则化鼓励果断的专家排名,确保不同预算下的可靠性能
- 零额外训练开销:EMoE与标准Top-k训练成本完全相同
- 广泛验证:在4种MoE架构(7B-21B)和9个基准测试上一致有效
技术影响
- 为MoE模型在异构硬件和波动工作负载下的部署提供了实用解决方案
- 单个训练模型可服务多种推理预算,无需维护多个变体
- 与现有MoE优化技术(量化、蒸馏等)正交,可进一步结合
- 为MoE模型的推理时scaling研究开辟了新方向
局限性
- 弹性范围有界: 过大时收益递减
- 在超大规模模型(>100B)上的验证有限
- 极端情况下()退化为随机选择
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 专家共现矩阵(k=2 vs k=6) | expert-cooccurrence-k2.jpg, expert-cooccurrence-k6.jpg |
| Figure 2 | 推理时扩展墙现象 | performance-scaling-wall.jpg |
| Figure 3 | 共现距离与性能关系 | cooccurrence-distance.jpg |
| Figure 4 | EMoE架构对比 | architecture-overview.jpg |
| Figure 5 | 超参数分析 | effect-of-k-ideal.jpg |
| Figure 7 | OLMoE性能与延迟 | olmoe-performance-latency.jpg |
| Figure 8 | 不同训练预算 | training-budgets.jpg |
| Figure 9 | DeepSeek-V2的 分析 | deepseek-k-ideal.jpg |
| Figure 10 | 对专家选择稳定性影响 | cooccurrence-math.jpg, cooccurrence-commonsense.jpg |
| Figure 11 | 训练动态(epoch 1-4) | training-dynamics-epoch{1,2,3,4}.jpg |