RollPacker: Mitigating Long-Tail Rollouts for Fast, Synchronous RL Post-Training
通过尾部批处理和全栈系统优化解决RL训练中长尾rollout导致的GPU利用率低问题
RollPacker: Mitigating Long-Tail Rollouts for Fast, Synchronous RL Post-Training
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | RollPacker: Mitigating Long-Tail Rollouts for Fast, Synchronous RL Post-Training |
| 作者 | Wei Gao†, Yuheng Zhao†, Dakai An†, Tianyuan Wu†, Lunxi Cao†, Shaopan Xiong‡, Ju Huang‡, Weixun Wang§, Siran Yang‡, Wenbo Su§, Jiamang Wang‡, Lin Qu‡, Bo Zheng‡, Wei Wang† |
| 机构 | 香港科技大学†, 阿里巴巴集团‡, 淘宝天猫集团§ |
| 论文 | https://arxiv.org/abs/2509.21009 |
| 发布 | 2025年9月25日 |
| 代码 | 基于ROLL框架,将开源 |
二、核心思想
问题定义
同步RL后训练中,长尾响应分布导致严重的GPU利用率问题:
- Rollout阶段占总训练时间~70%,是主要瓶颈
- 响应长度呈长尾分布:最长响应比中位数长25-32倍
- 所有GPU必须等待最长响应完成,短响应GPU空闲等待(“气泡”)
- 现有解决方案要么效果有限(阶段重叠),要么损害训练精度(放松同步)
解决方案概述
Tail Batching(尾部批处理):一种新的rollout调度策略,核心思想是将产生长尾响应的prompt集中到少数专门的rollout步骤(long rounds)中,确保大多数步骤(short rounds)只包含平衡的短响应。
RollPacker系统:通过三个阶段的全栈优化实现tail batching的全部潜力:
- 弹性并行适配:动态调整rollout阶段的TP配置
- 动态资源调度:异步奖励计算 + GPU共享
- 流式训练:rollout和训练的细粒度重叠
核心成果:相比veRL实现2.03×-2.56×端到端训练加速,相比RLHFuse实现最高2.24×加速。
三、技术架构
整体框架图
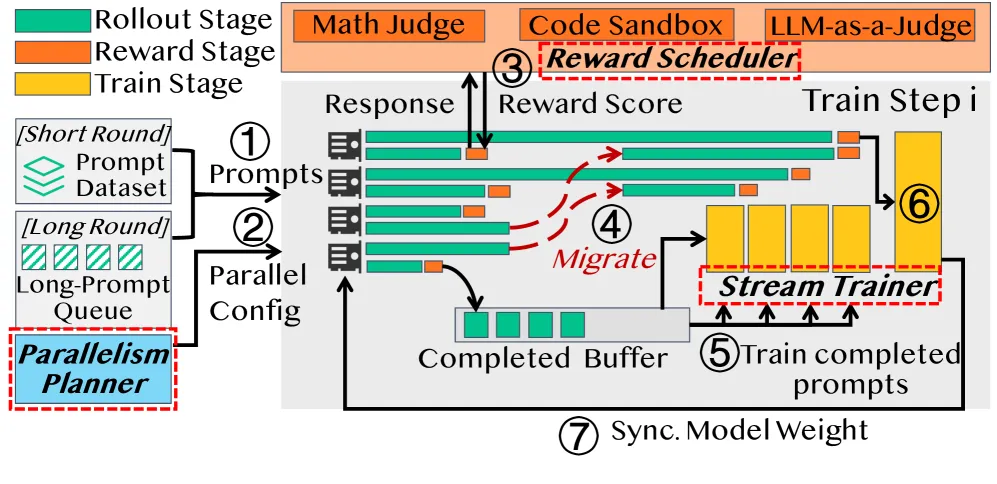
RL训练时间分解
| 任务 | Rollout | Reward | Training |
|---|---|---|---|
| Math | 72% | 5% | 23% |
| Code | 66% | 13% | 21% |
| LLM-as-a-Judge | 71% | 7% | 22% |
关键观察:Rollout阶段占总时间66-72%,是主要瓶颈。
Tail Batching 核心算法
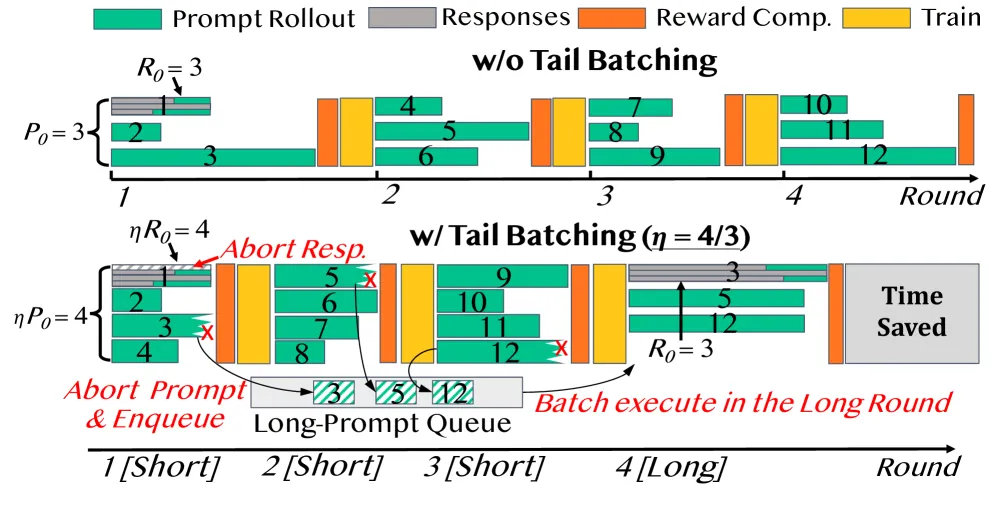
问题P1:排除长尾响应后,batch中prompt数量不足
解决方案:投机执行(Speculative Execution)
- 启动ηP₀个prompt(η=1.25),每个生成ηR₀个response
- 只保留最先完成的P₀个prompt和R₀个response
- 自然过滤掉长响应,产生平衡的短batch
问题P2:系统性排除长prompt会扭曲训练样本分布
解决方案:长prompt队列(Long-prompt Queue)
- 被投机执行中止的prompt加入队列
- 队列积累到P₀个时,执行专门的long round(禁用投机执行)
- 确保所有prompt最终都被包含
核心公式
投机执行因子:
每个short round启动的prompt数:
每个prompt生成的response数:
自适应超时公式:
其中:
- :正确响应的最大执行时间
- :松弛因子
- :最小超时
- :最大超时
训练精度保证:
Tail batching仅改变训练样本顺序,不改变样本分布或放松同步。梯度计算数学等价于标准on-policy训练:
四、系统设计
4.1 并行规划器(Parallelism Planner)
问题:Short rounds因投机执行产生更高GPU内存压力,固定TP配置无法适应。
解决方案:动态TP选择
Short Round: 高内存压力 → 增大TP (减少每GPU内存)
Long Round: 低内存压力 → 减小TP (减少通信开销)自适应策略:
- 抢占次数突然增加(>1.05×)→ TP翻倍
- 连续4步零抢占 → TP减半
- TP组限制在单节点内(避免跨节点通信)
效果:
- 减少抢占次数21.1%(short rounds)
- Rollout时间减少最高21.9%
- 平均1.9×加速(vs固定TP=1)
4.2 奖励调度器(Reward Scheduler)
问题:Rollout成本降低后,奖励计算成为新瓶颈。
三个优化:
1. 异步奖励计算
- 完成的response立即分发给reward worker
- 与ongoing rollout并行执行
- 加速比:1.18×-1.48×
2. 代码沙箱自适应超时
- 5%的prompt触碰30秒超时,但最终奖励为0
- 跟踪正确响应的最大执行时间T_anchor
- 超过阈值的执行提前终止
- 平均加速1.6×
3. LLM-as-a-Judge GPU共享
- 传统方式:固定25% GPU专门用于judge LLM,利用率仅22.6%
- RollPacker:judge LLM与actor LLM共置同一GPU
- 使用MPS(Multi-Process Service)实现warp级资源共享
- 加速比1.25×
- 层级流水线:judge LLM大部分层offload到CPU,与GPU计算重叠
4.3 流式训练器(Stream Trainer)
问题:Long rounds中,响应完成不均匀导致GPU气泡。
解决方案:GPU再分配 + 流式梯度计算
Rollout进度监控
    ↓
完成比例达到阈值 (20%-50%)
    ↓
检查KV Cache峰值是否在内存限制内
    ↓
将部分GPU从rollout重新分配给training
    ↓
异步获取已完成response,流式计算梯度
    ↓
Rollout完成 → 梯度同步更新关键设计:
- GPU选择:保持通信组完整性(TP组不能拆分)
- 缩放时机:基于KV Cache使用量预测,避免内存溢出
- 梯度缩放:已完成replica的梯度按样本数重新归一化
- 延迟更新:stream阶段只计算梯度,不更新参数,保持on-policy语义
效果:
- 自适应缩放:1.08×加速(vs无缩放)
- 异步获取:14%步时间减少(vs固定获取比例)
五、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| Tail Batching | 将长尾prompt集中到少数long rounds | 最长响应长度减少8.9×(short rounds) |
| 投机执行 | 启动更多prompt,保留最快完成 | Rollout时间减少最高3.9× |
| 动态TP选择 | 根据内存压力自适应调整TP | Rollout时间减少21.9% |
| 自适应超时 | 基于正确响应时间动态调整超时 | 奖励计算加速1.6× |
| MPS GPU共享 | Actor和Judge LLM共置GPU | 步时间减少25% |
| 层级流水线 | Judge LLM权重offload+流水线 | 奖励计算加速1.4×(32k序列) |
| 流式训练 | Rollout和训练细粒度重叠 | 保持on-policy语义,减少气泡 |
| 梯度归一化 | 按样本数重新归一化梯度 | 数学等价于标准on-policy |
六、实验结果
实验设置
- 集群:16节点 × 8×H800 = 128 GPU,400Gbps InfiniBand
- 模型:Qwen2.5-7B/14B/32B
- 最大响应长度:8k/16k/32k
- 训练配置:P₀=128, R₀=8, GRPO算法
- 数据集:数学+代码+多学科QA混合
端到端性能对比
| 方法 | Qwen2.5-7B/8k | Qwen2.5-14B/16k | Qwen2.5-32B/32k |
|---|---|---|---|
| veRL Baseline | 1.00× | 1.00× | 1.00× |
| + Tail Batching | 1.30× | 1.48× | 2.21× |
| + Reward | 2.01× | 1.99× | 2.48× |
| + Parallelism | 2.01× | 2.02× | 2.52× |
| + Trainer | 2.03× | 2.22× | 2.56× |
与RLHFuse对比
| 模型 | RollPacker vs RLHFuse |
|---|---|
| Qwen2.5-7B | 1.14× |
| Qwen2.5-14B | 1.68× |
| Qwen2.5-32B | 2.24× |
训练精度验证
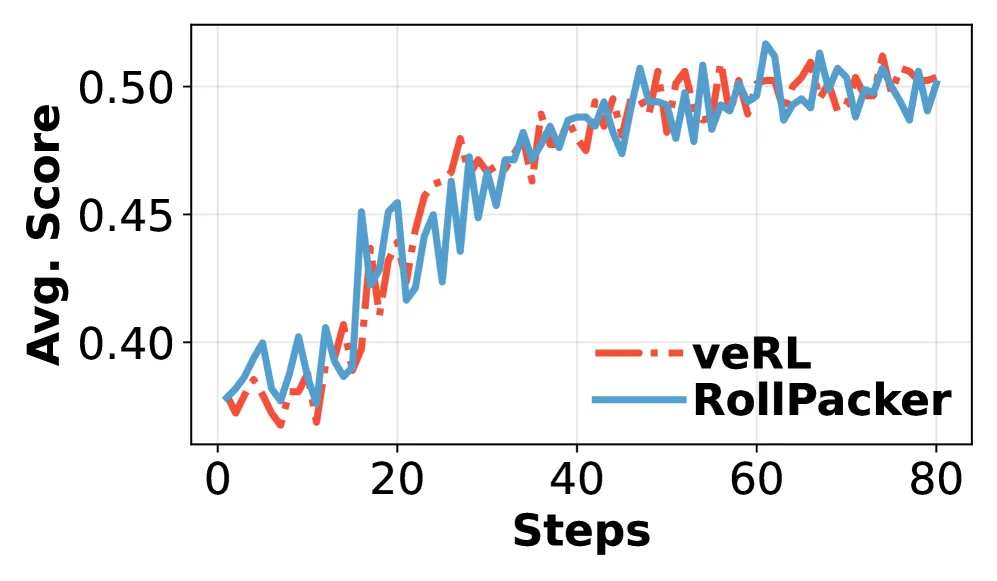
Tail batching的验证曲线与veRL几乎完全一致,不损害训练精度。早期收敛更快,可能因为更平衡的响应长度分布。
Short Round vs Long Round 性能
| 指标 | Short Round | Long Round |
|---|---|---|
| 最大响应长度 | 减少8.9× | 与baseline相当 |
| Rollout时间 | 加速7.8× | 与baseline相当 |
| GPU利用率 | 显著提升 | 仍有气泡 |
可扩展性
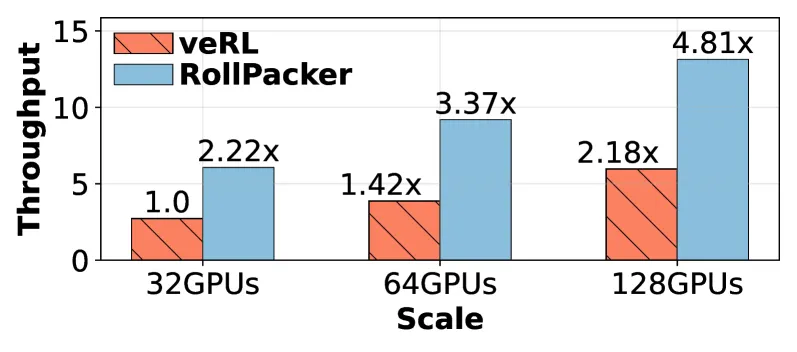
- 扩展到128 GPU,Qwen2.5-14B
- 相比veRL始终保持2.2×吞吐提升
- 资源翻倍时,吞吐提升约1.5×
七、关键消融实验
Tail Batching配置敏感性
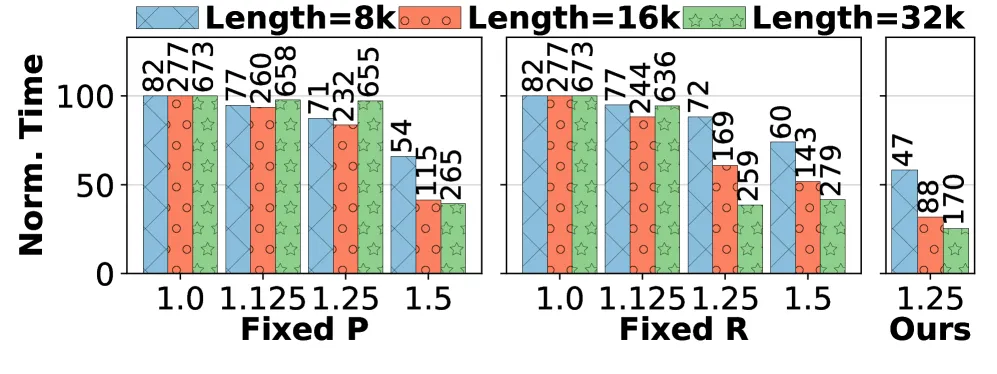
- η=1.25(P和R都扩大25%)效果最佳
- 单独扩大R(response)到1.5才有效
- 单独扩大P(prompt)会增加long round频率,抵消收益
动态TP效果
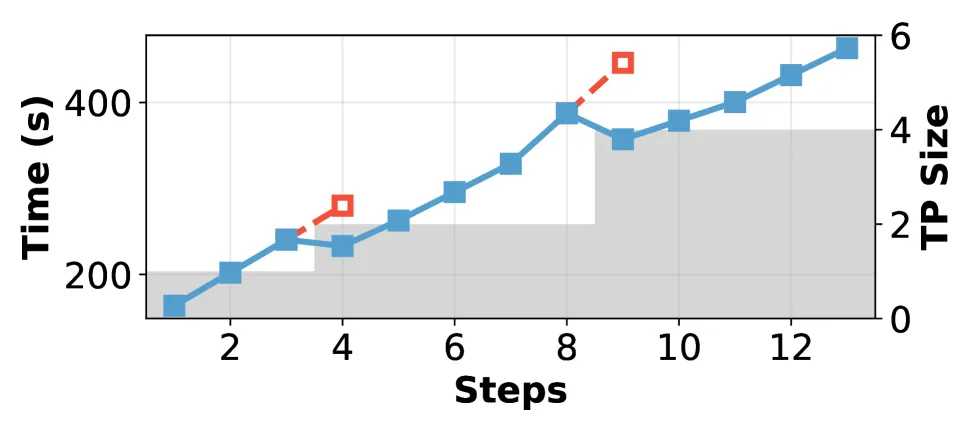
- 响应长度从8k增长到32k时,TP从1→2→4自适应调整
- 相比固定TP=1,平均1.9×加速
- 抢占次数减少13.8%
奖励调度器效果
- MPS共享:步时间减少最高25%
- 层级流水线:32k序列时加速1.4×
- 自适应超时:平均加速1.6×
八、相关工作
| 系统 | 方法 | 精度影响 | RollPacker优势 |
|---|---|---|---|
| veRL | 固定并行,同步执行 | 无 | 2.03-2.56×加速 |
| RLHFuse | 阶段重叠(reward+reference) | 无 | 最高2.24×加速 |
| ROLL/MiMO | 异步奖励计算 | 无 | +tail batching+动态TP+流式训练 |
| StreamRL/AsyncFlow | one-off pipeline | 轻微下降 | 保持精度 |
| AReaL | 完全异步 | 显著下降 | 保持on-policy精度 |
| Kimi | 部分rollout(截断长响应) | 轻微下降 | 不截断,不损失信息 |
九、总结
核心贡献
- Tail Batching:首次提出将长尾prompt集中调度的策略,从根本上解决长尾rollout问题
- 投机执行:启动更多请求但只保留最快完成,自然过滤长响应
- 全栈系统优化:并行规划器+奖励调度器+流式训练器,覆盖RL训练所有阶段
- 精度保证:仅改变样本顺序,数学等价于标准on-policy训练
- 显著加速:2.03-2.56×端到端加速,不损失精度
技术影响
- RL Infra方向:提供了一种新的解决长尾rollout的范式
- 与现有方法互补:tail batching可与异步方法结合,进一步优化
- 实用性强:基于ROLL/vLLM实现,将开源
局限性
- MPS无错误隔离:GPU共享时无故障隔离机制
- 仅优化TP:未考虑专家并行(EP)的优化空间
- 长round仍有气泡:tail batching无法完全消除long round的GPU空闲
十、参考资源
- arXiv论文
- ROLL框架 (RollPacker基于此实现)
- vLLM (推理后端)
- Megatron-LM (训练框架)