Tanbr: Tree-Structured Adaptive Neural Bandit Router for Online MoE Inference
基于树结构自适应神经老虎机路由器的在线MoE推理优化,实现45%延迟降低和25%内存节省
Tanbr: Tree-Structured Adaptive Neural Bandit Router for Online MoE Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Faster, Smaller, and Smarter: Task-Aware Expert Merging for Online MoE Inference |
| 作者 | Ziyi Han, Xutong Liu, Ruiting Zhou, Xiangxiang Dai, John C.S. Lui |
| 机构 | 未明确标注 |
| 论文 | arXiv:2509.19781 |
| 发布 | 2025-09-24 (v1), 2026-01-23 (v2) |
| 领域 | 机器学习 (cs.LG) |
二、核心思想
问题定义
稀疏混合专家(SMoE)模型在扩展Transformer容量方面表现出色,但在在线推理场景下面临挑战:
- 模型体积大:完整的SMoE模型包含大量专家参数
- 路由复杂性:专家选择和切换带来额外开销
- 任务信息缺失:在线推理时任务标签通常不可用
- 资源受限:边缘网络等场景下计算和内存资源有限
核心发现
关键洞察:
- 专家合并可以将多个专家的知识融合到单个专家中,减少计算开销
- 任务感知的合并策略比通用合并更有效
- 连续决策空间中的优化可以通过树结构分区实现高效探索
- 神经老虎机方法可以学习合并权重到性能的非线性映射
解决方案概述
Tanbr(Tree-Structured Adaptive Neural Bandit Router)是一个用于在线MoE推理的新型路由器,通过以下创新实现高效推理:
- 树结构空间分区:使用二叉树逐步细化连续决策空间
- 神经老虎机框架:利用深度神经网络学习合并权重到性能的映射
- 任务感知合并:基于在线估计的任务分布动态调整专家合并策略
核心结果:
- 推理延迟降低至少45%
- 内存使用减少最高25%
- 保持高精度,超越现有方法
三、技术架构
整体框架
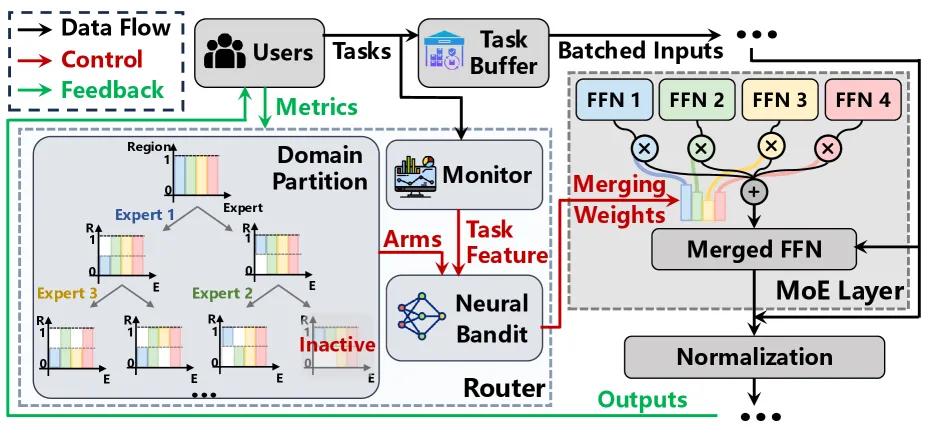
架构组成:
- 预训练MoE模型:包含K个专家的MoE层
- 任务分布估计:从历史数据估计任务分布
- 树结构分区:将连续决策空间离散化
- 神经老虎机:学习合并权重到性能的映射
- 专家合并:根据选定的权重合并专家
预备知识
稀疏混合专家(SMoE):
- 每个MoE层包含K个专家,每个专家是独立的FFN
- 路由器选择专家子集处理每个输入
- 输出:
专家合并:
- 将多个专家的参数加权组合为单个专家
- 输出:,其中
- 合并后的专家具有单个专家的计算成本,但融合了多个专家的知识
问题形式化
在线约束学习优化问题:
约束条件:
- (合并权重归一化)
- (最多选择B个专家)
树结构空间分区
分区树设计:
- 使用预定义的分区树
- 每个节点表示决策空间 的一个子区域
- h表示深度,i表示该深度的索引
- 二叉、非重叠的方式递归分区
节点扩展阈值:
其中:
- C:固定常数
- :平滑参数
- :置信参数
约束满足:
- 通过线性规划(LP)在每个叶节点的覆盖区域内寻找可行的合并权重
- 保留B个最大的权重值,归一化,其余设为零
神经老虎机框架
神经网络奖励预测:
算法流程(Algorithm 1):
输入: 时间范围T, 平滑参数ν₁,ν₂,ρ, 学习率η, 正则化参数λ, 探索参数υ
初始化: 分区树H={H₀,₁}, 神经网络参数θ, 时间步t=1

While t ≤ T do
    1. 获取活跃叶节点集合Lₜ
    2. 对每个叶节点,通过LP找到可行合并权重
    3. 使用UCB策略选择最优合并权重xₜ
    4. 使用xₜ合并专家,进行推理
    5. 观察奖励rₜ
    6. 更新神经网络参数θ
    7. 如果节点访问次数超过阈值τₕ(t),扩展该节点
    8. t = t + 1
End While
理论分析
遗憾界:
关键假设:
- 平滑性假设:奖励函数f满足Hölder平滑性
- 近优维度:存在常数C使得覆盖数有界
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 树结构空间分区 | 将连续决策空间离散化为二叉树 | 有效探索高维空间 |
| 神经老虎机框架 | 学习合并权重到性能的非线性映射 | 处理非线性依赖 |
| 任务感知合并 | 基于在线任务分布动态调整合并策略 | 适应动态环境 |
| 增量学习 | 逐步细化决策空间 | 平衡探索与利用 |
| 次线性遗憾界 | 理论保证 |
五、实验结果
实验设置
模型:
- T5-based MoE:编码器-解码器模型,12层FFN,约1.0B参数
- BERT-based MoE:编码器模型,12层FFN,约660M参数
- 每个MoE层包含K=8个专家
数据集:
- GLUE基准的8个任务:MNLI, QNLI, RTE, SST-2, MRPC, QQP, STS-B, CoLA
超参数:
- 平滑参数:,
- 正则化参数:
- 探索参数:
- 置信水平:
- 学习率:
- 神经网络宽度:d=64,深度:L=2
- 最大合并专家数:B=8
基线方法:
- RL:强化学习方法
- Switch:基于神经网络的稀疏路由
- SMEAR:基于神经网络的token级合并
- NUCB:神经老虎机方法
- Regmean:闭式解合并
- Fisher:基于Fisher信息的合并
- Average:简单平均
微调性能
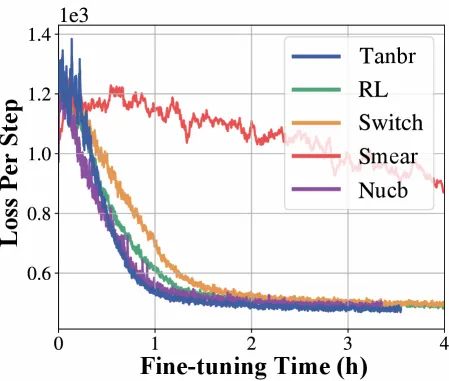
T5-based MoE微调结果:
- 训练损失:Tanbr收敛更快,最终损失更低
- 训练时间:比RL和Switch减少约40%
- 内存使用:比RL和Switch增加约10%
关键观察:
- Tanbr初始损失较高(候选合并权重少),但随树细化收敛更快
- NUCB(随机生成权重)波动更大,收敛更慢
- SMEAR(token级合并)计算成本增加20×
推理性能
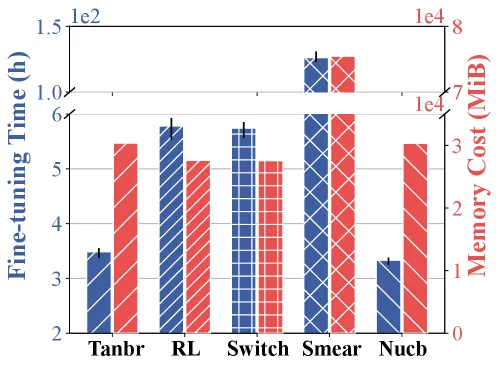
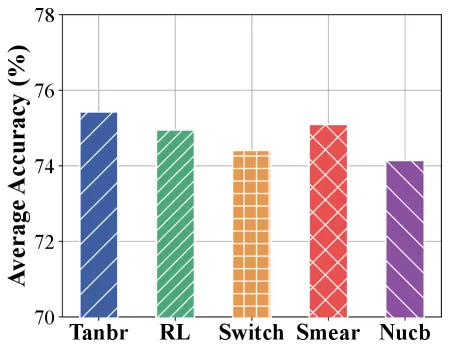
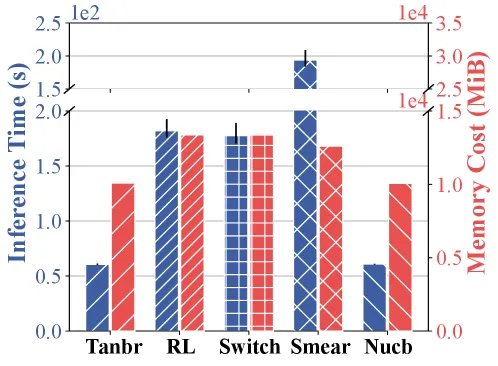
T5-based MoE推理结果:
| 方法 | 平均精度 | 推理时间 | 内存使用 |
|---|---|---|---|
| Tanbr | 75.43 | 最优 | 中等 |
| RL | 74.95 | 较高 | 较低 |
| Switch | 74.41 | 较高 | 较低 |
| SMEAR | 75.10 | 最高 | 最高 |
详细任务性能(TABLE II):
| 方法 | CoLA | MNLI | MRPC | QNLI | QQP | RTE | SST-2 | STS-B | 平均 |
|---|---|---|---|---|---|---|---|---|---|
| Tanbr | 42.9 | 75.3 | 78.4/84.4 | 84.1 | 82.0/74.8 | 63.8 | 91.5 | 86.1/85.9 | 75.43 |
| RL | 42.1 | 75.7 | 77.0/83.3 | 82.6 | 81.6/74.2 | 65.3 | 91.2 | 83.6/83.8 | 74.95 |
| Switch | 43.2 | 71.5 | 79.3/85.6 | 82.8 | 81.6/75.2 | 62.3 | 90.4 | 84.3/84.1 | 74.41 |
在线学习性能
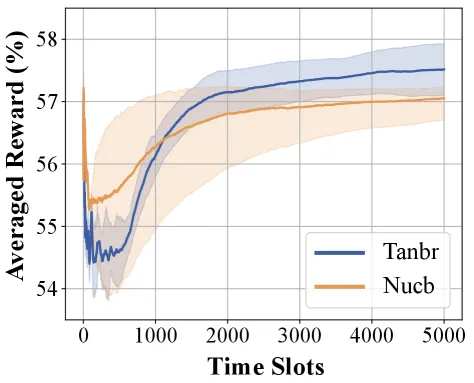
BERT-based MoE在线学习结果:
- 早期阶段:Tanbr表现较差(候选权重少)
- 收敛后:Tanbr超越NUCB
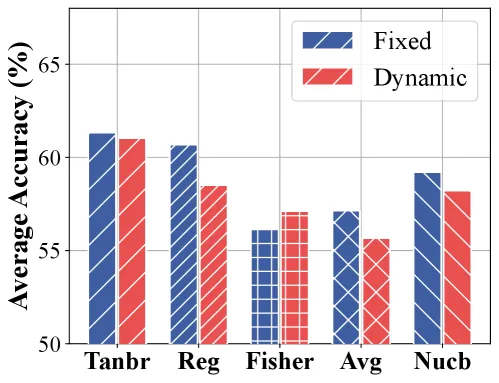
- 最终性能:在固定任务特征下提升最高9%,动态任务特征下提升5-10%
动态任务特征下的性能:
- Tanbr能实时适应任务分布变化
- 比静态合并策略方法表现更好
可扩展性评估
不同专家数量(4-192)的性能:
- 更新步骤数随专家数量增加而增加
- 路由时间保持低(K=192时<0.4ms)
- 表明Tanbr在大规模场景下保持高效
消融实验
平滑参数ρ的影响:
- 较小的ρ:更保守的分区,初始随机阶段短,但最终性能较低
- 较大的ρ:更好的探索,但初始随机时间长,微调慢
- 需要平衡探索与利用
学习率η的影响:
- 较高学习率:加速收敛,但可能导致不稳定
- 较低学习率:更稳定,但进度慢
- 需要调优以实现稳定性和收敛效率的平衡
六、相关工作
| 方法 | 特点 | Tanbr优势 |
|---|---|---|
| RL | 强化学习选择专家 | 训练时间减少40% |
| Switch | 神经网络稀疏路由 | 推理更快,精度更高 |
| SMEAR | token级专家合并 | 计算成本降低20× |
| NUCB | 神经老虎机(随机权重) | 更高效的探索策略 |
| Regmean | 闭式解合并 | 动态适应任务分布 |
| Fisher | Fisher信息合并 | 在线学习能力 |
| Average | 简单平均 | 任务感知优化 |
七、总结
核心贡献
- 树结构自适应神经老虎机路由器:将连续决策空间离散化为二叉树,实现高效探索
- 任务感知专家合并:基于在线任务分布动态调整合并策略
- 次线性遗憾界:理论保证
- 显著性能提升:推理延迟降低45%+,内存减少25%,保持高精度
- 适用于资源受限场景:特别适合边缘网络部署
技术影响
- 为MoE模型在线推理提供了新的优化范式
- 将多臂老虎机方法应用于专家合并问题
- 树结构分区思想可推广到其他连续决策空间优化
- 任务感知策略适用于动态环境下的模型部署
局限性
- 假设任务级路由在训练时使用(虽然也适用于其他级别)
- 需要在线获取任务分布信息
- 神经网络训练引入额外计算开销
- 未探索与其他优化技术(如量化、剪枝)的结合
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | Tanbr架构总览 | figure1-architecture.png |
| Figure 2 | T5微调性能 | figure2-finetuning.png |
| Figure 3 | T5推理性能 | figure3-inference.png |
| Figure 4 | BERT在线学习性能 | figure4-online-learning.png |
| Figure 5 | 每时隙推理性能 | figure5-per-slot.png |
| Figure 6 | 可扩展性评估 | figure6-scalability.png |
| Figure 7 | 消融实验 | figure7-ablation.png |