MiniCPM-V 4.5 - Cooking Efficient MLLMs via Architecture, Data, and Training Recipe
8B参数高效多模态大语言模型,通过统一3D-Resampler、文档知识统一学习范式和混合强化学习实现性能与效率的平衡
MiniCPM-V 4.5 - Cooking Efficient MLLMs via Architecture, Data, and Training Recipe
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MiniCPM-V 4.5: Cooking Efficient MLLMs via Architecture, Data, and Training Recipe |
| 作者 | Tianyu Yu, Zefan Wang, Chongyi Wang, Fuwei Huang, Wenshuo Ma, Zhihui He, Tianchi Cai, Weize Chen, Yuxiang Huang, Yuanqian Zhao, Bokai Xu, Junbo Cui, Yingjing Xu, Liqing Ruan, Luoyuan Zhang, Hanyu Liu, Jingkun Tang, Hongyuan Liu, Qining Guo, Wenhao Hu, Bingxiang He, Jie Zhou, Jie Cai, Ji Qi, Zonghao Guo, Chi Chen, Guoyang Zeng, Yuxuan Li, Ganqu Cui, Ning Ding, Xu Han, Yuan Yao, Zhiyuan Liu, Maosong Sun |
| 机构 | 清华大学 / OpenBMB |
| 论文 | arXiv:2509.18154 |
| 代码 | GitHub |
| 发布 | 2025年9月16日 |
| 许可 | 开源 |
二、核心思想
MiniCPM-V 4.5是一个8B参数的多模态大语言模型(MLLM),专注于解决MLLM训练和推理效率的核心瓶颈。模型在架构、数据策略和训练方法三个维度引入核心改进:
- 统一3D-Resampler架构:将2D-Resampler扩展为3D-Resampler,实现图像和视频的联合空间-时间压缩,视频token压缩率达到96×(6帧448×448视频压缩为64个token,而大多数MLLM需要1,536-3,072个token)
- 统一文档知识与OCR学习范式:通过动态视觉损坏统一文档知识学习和文本识别,无需依赖外部解析器
- 混合强化学习策略:结合短推理和长推理模式,实现可控的混合推理能力
问题定义
当前MLLM面临三大效率瓶颈:
- 架构效率:高分辨率图像和视频编码产生大量视觉token,带来巨大计算开销
- 数据效率:文档解析依赖脆弱的外部解析器,数据工程成本高
- 训练效率:推理模式单一,无法在简单任务上快速响应
解决方案概述
MiniCPM-V 4.5通过统一3D-Resampler实现6×时间压缩率,通过动态视觉损坏统一文档学习目标,通过混合RL实现短/长推理模式的灵活切换。在OpenCompass评估中,MiniCPM-V 4.5(8B)超越GPT-4o-latest和Qwen2.5-VL 72B等更大模型。
三、技术架构
整体框架图
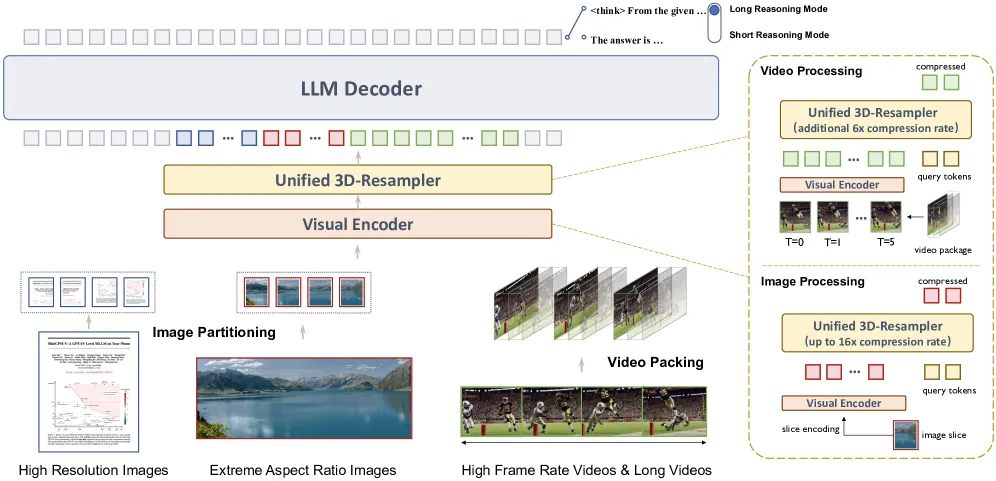
MiniCPM-V 4.5架构包含三个核心模块:
- 轻量级视觉编码器:通过特殊分区策略灵活处理高分辨率图像
- 统一3D-Resampler:将图像和视频编码为紧凑特征,利用时间冗余
- LLM解码器:理解图像、视频和文本,生成文本输出
统一3D-Resampler
图像处理:采用LLaVA-UHD图像分区策略,根据输入分辨率估计理想切片数量,使用可学习查询增强2D空间位置嵌入,通过交叉注意力为每个切片生成固定长度序列。
视频处理:沿时间维度将视频分割为包(package),每个包含相邻帧。在每个包内,通过交叉注意力将帧特征重采样为固定长度特征序列,增强3D空间-时间位置嵌入。
压缩率:
- 图像:4×压缩率(相比大多数MLLM)
- 视频:96×压缩率(6帧448×448 → 64个token)
- 时间压缩:6×压缩率
核心公式
混合RL奖励信号:
其中是标准化的偏好奖励分数:
GRPO优化:采用GRPO算法,移除KL和熵损失以提高稳定性。每个batch包含128个prompt,每个prompt生成8个响应,最大响应长度8192 token。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 视觉编码器 | 轻量级,支持高分辨率图像分区 | LLaVA-UHD策略 |
| 3D-Resampler | 统一图像/视频压缩 | 6×时间压缩,96×视频压缩 |
| LLM解码器 | 8B参数语言模型 | 支持混合推理模式 |
训练流程
预训练(三阶段渐进式)
Stage 1(热身):仅训练2D-Resampler,使用图像-字幕数据建立视觉-语言对齐
Stage 2(感知基础):解冻视觉编码器,使用OCR丰富数据和图像-字幕数据,LLM保持冻结
Stage 3(端到端):解冻所有参数,使用最高质量数据(文本语料、图像-文本交错样本、视频),采用Warmup-Stable-Decay学习率调度器
监督微调SFT(两阶段)
Stage 1(通用SFT):在多样化高质量指令-响应数据上微调,包含10%纯文本数据防止性能退化
Stage 2(Long-CoT & 3D-Resampler):引入长链推理热身指令,将架构从2D升级为3D-Resampler
强化学习
采用混合RL策略:
- 短推理模式:快速响应简单问题
- 长推理模式:显式逐步思考,包含反思和回溯
- 模式切换由prompt控制
- 滚动样本在两种模式间随机交替
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 统一3D-Resampler | 联合空间-时间压缩,统一图像/视频编码 | 视频token压缩96×,VideoMME仅用9.9%推理时间 |
| 动态视觉损坏范式 | 统一文档知识学习和OCR,无需外部解析器 | 低/中/高三级损坏自适应切换学习目标 |
| 混合RL策略 | 短/长推理模式联合优化 | OpenCompass 77.0,超越GPT-4o |
| 概率+规则奖励 | RLPR概率奖励补充规则验证 | 98%规则奖励准确率+复杂语言奖励覆盖 |
| RLAIF-V | AI反馈对齐减少视觉幻觉 | 扩展到视频输入,ObjHalBench显著降低 |
统一文档知识与OCR学习范式
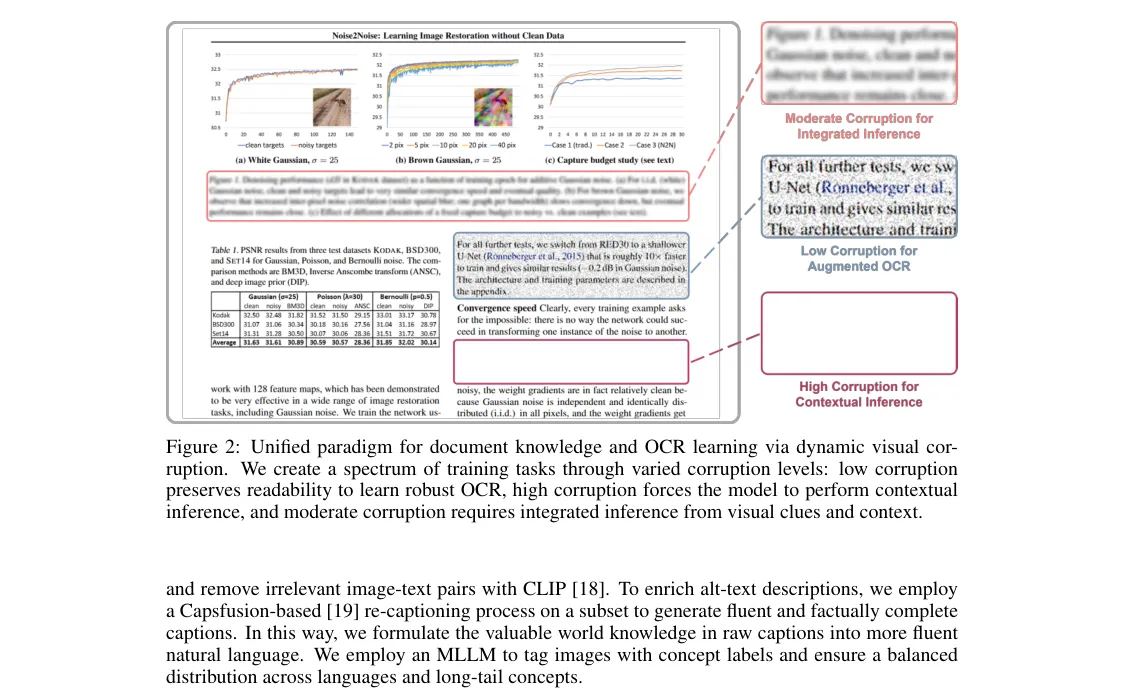
关键洞察:文档知识获取与文本识别的区别在于文本的可见性。通过动态损坏文本区域,统一为单一学习目标:
- 低损坏(增强OCR):轻微噪声,文本仍可识别,模型通过文本识别预测
- 中等损坏(集成推理):严重噪声,字符高度模糊,模型需结合噪声视觉线索和文档上下文重建
- 高损坏(上下文推理):文本完全遮蔽,模型被迫从多模态上下文和内部知识推断
五、代码实现分析
MiniCPM-V 4.5是OpenBMB开源项目,代码结构包含:
- 模型架构实现(3D-Resampler、视觉编码器)
- 预训练、SFT、RL训练流程
- 数据处理和增强工具
- 评估脚本和基准测试集成
六、实验结果
性能对比
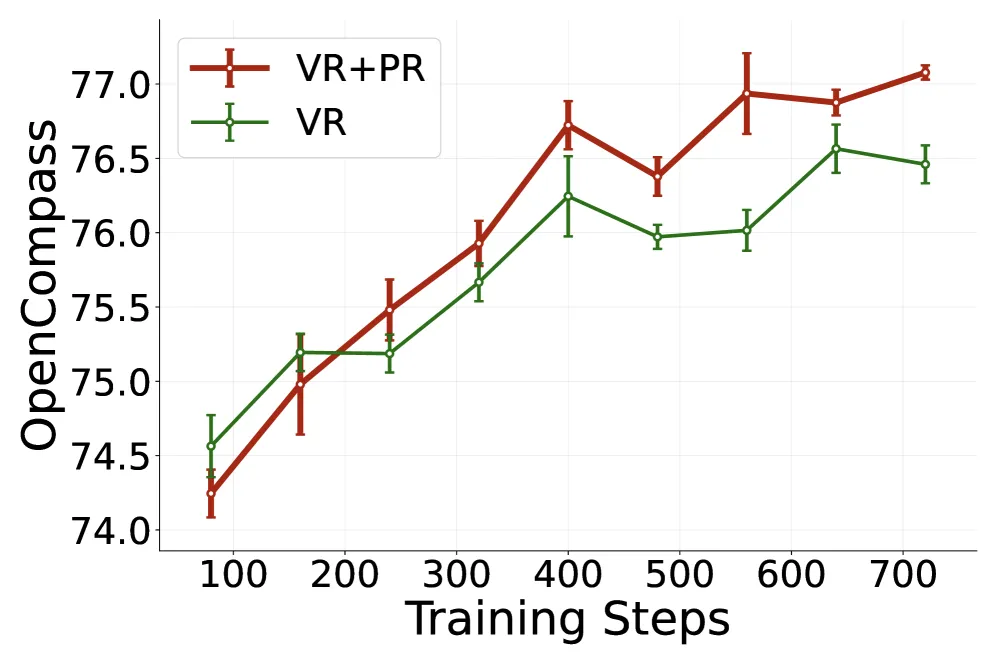
基准测试
Table 1: 主要评估结果
| 任务 | 基准 | MiniCPM-V 4.5 (8B) | Qwen2.5-VL (7B) | Qwen2.5-VL (72B) | InternVL3 (8B) | GLM-4.1V (9B) | GPT-4o |
|---|---|---|---|---|---|---|---|
| 综合多模态 | OpenCompass | 77.0 | 70.5 | 76.1 | 73.6 | 76.6 | 75.4 |
| MMVet | 75.5 | 67.1 | 76.9 | 81.3 | 70.5 | 76.9 | |
| STEM | MMMU | - | - | - | - | - | - |
| 文档/OCR | OCRBench | - | - | - | - | - | - |
| 视频理解 | VideoMME | - | - | - | - | - | - |
关键结果:
- OpenCompass 77.0,超越GPT-4o-latest(75.4)和Qwen2.5-VL 72B(76.1)
- 视频理解:VideoMME达到SOTA(30B以下模型),仅用46.7% GPU内存和8.7%推理时间
- OCR:OCRBench超越GPT-4o-latest
- 幻觉:ObjHalBench和MMHal-Bench显著降低幻觉
推理效率
Table 2: 推理效率对比
| 指标 | MiniCPM-V 4.5 | 对比模型 |
|---|---|---|
| GPU内存 | 46.7% of Qwen2.5-VL 7B | 100% |
| 推理时间 | 8.7% of Qwen2.5-VL 7B | 100% |
| 视频token压缩 | 96× | 1× |
Table 3: Thinking模型效率
| 模型 | 参数量 | 平均分 | 时间 |
|---|---|---|---|
| GLM-4.1V-9B-thinking | 10.3B | 76.6 | 17.5h |
| MiMo-VL-7B-RL | 8.3B | 76.4 | 11.0h |
| MiniCPM-V 4.5 | 8.7B | 77.0 | 7.5h |
消融实验
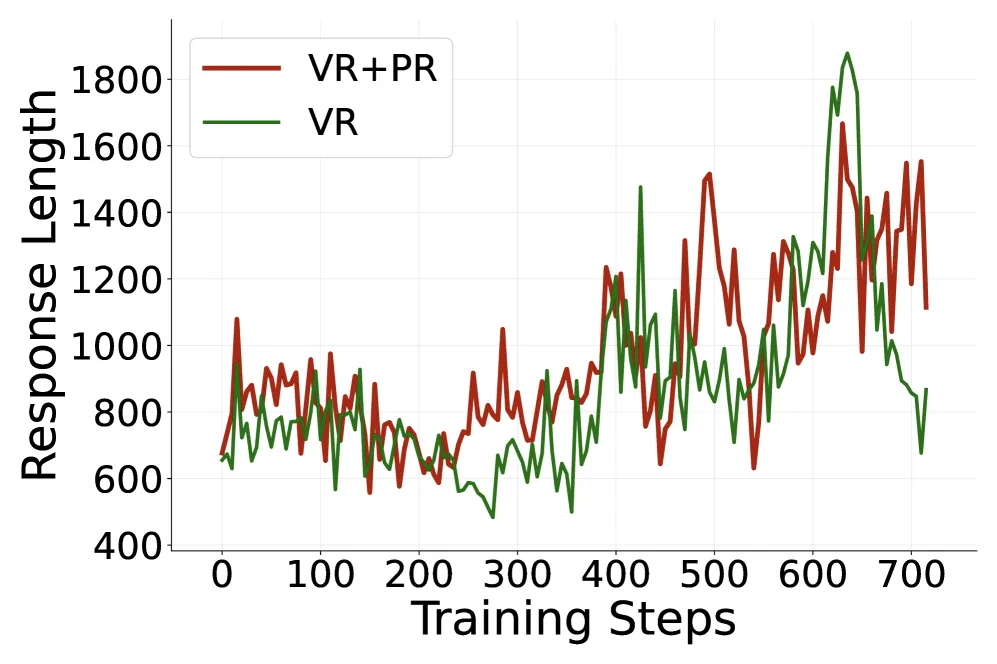
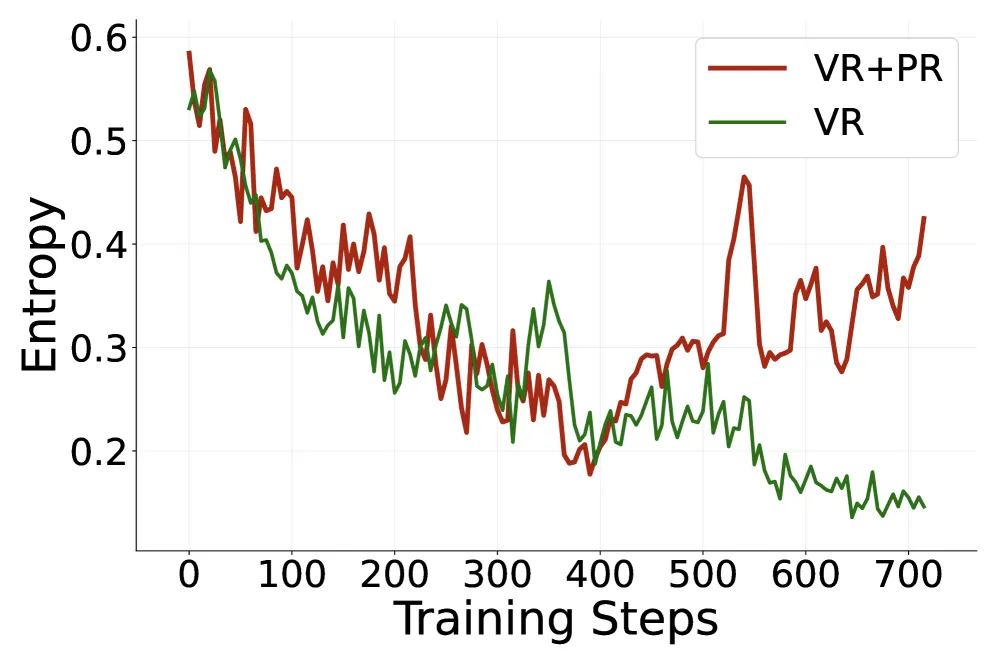
Table 4: 消融实验结果
| 消融项 | 发现 |
|---|---|
| 混合RL | 混合短/长推理模式训练提升整体性能和效率 |
| 概率奖励 | RLPR概率奖励补充规则验证,覆盖复杂自然语言答案 |
| 统一学习范式 | 动态视觉损坏同时提升文档知识和OCR能力 |
| 3D-Resampler | 相比2D基线,更高性能且更低token成本 |
七、案例分析
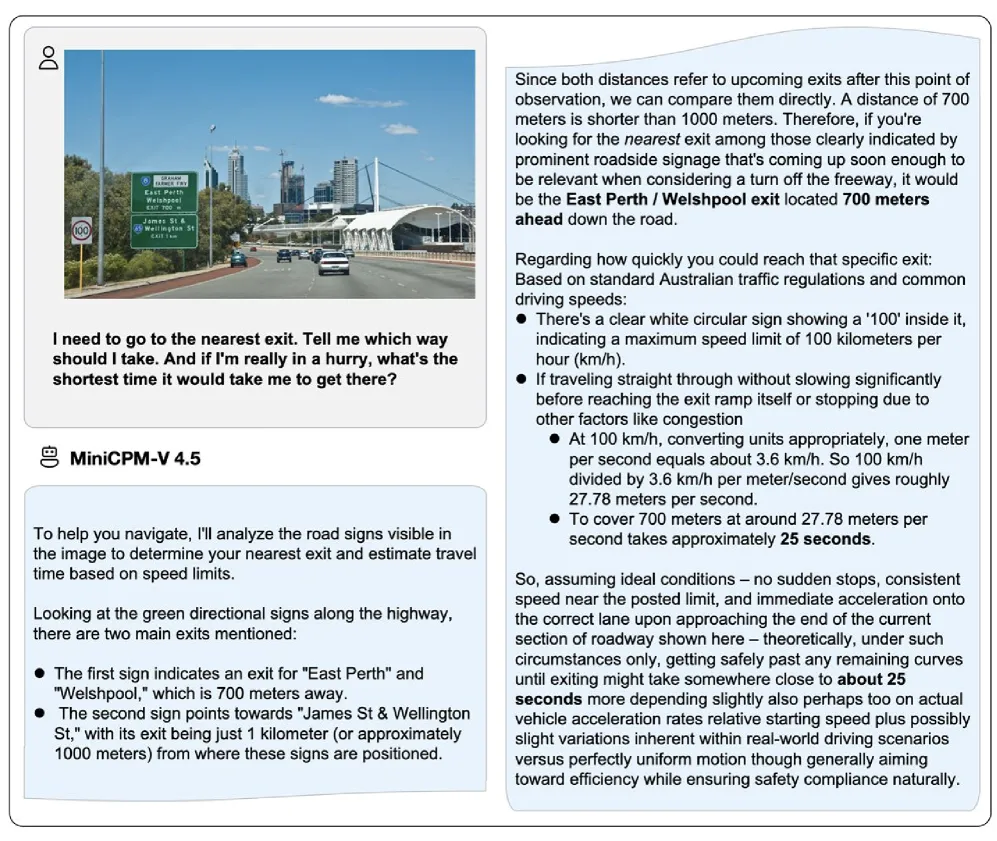
综合推理案例(英文)
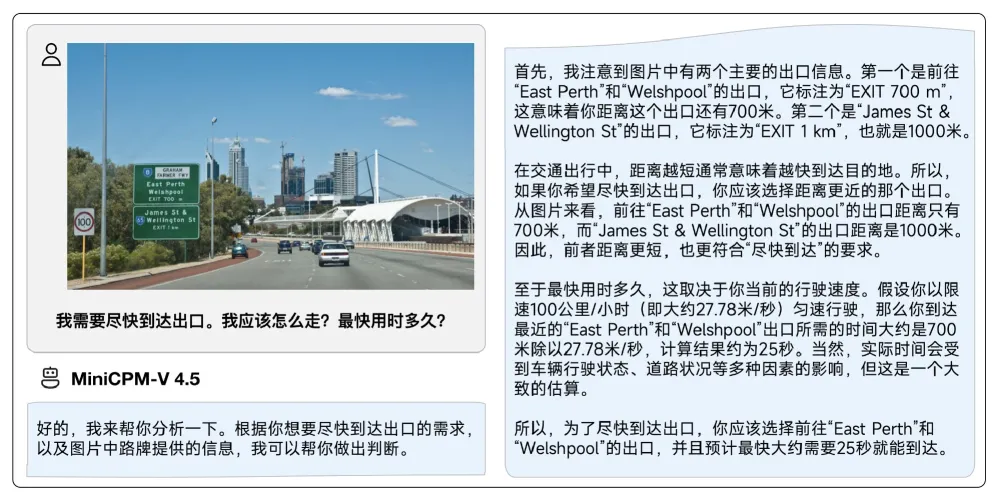
综合推理案例(中文)
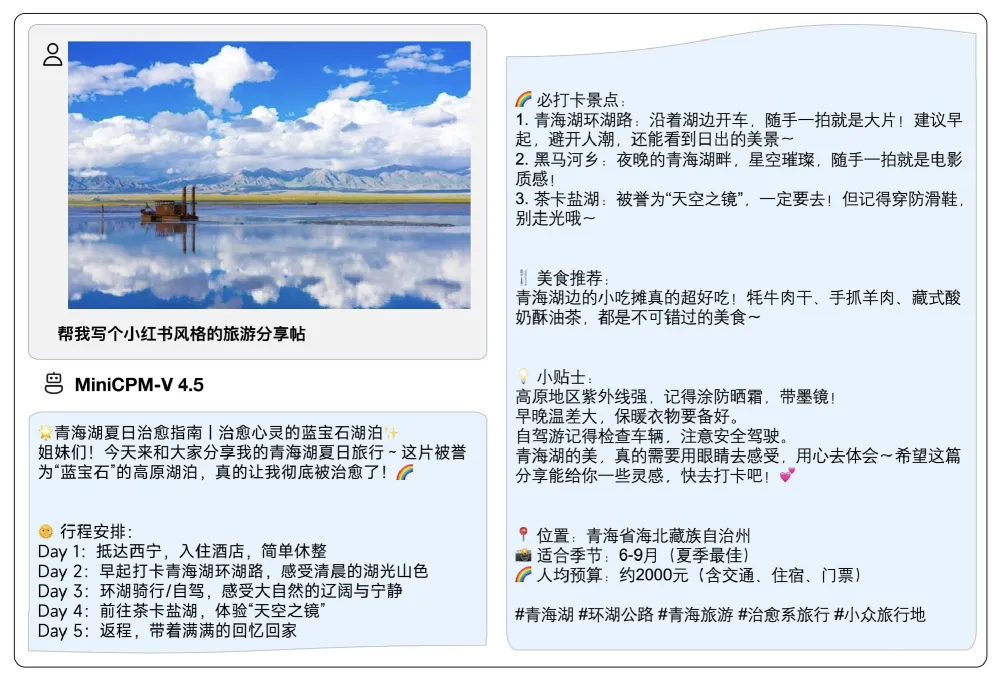
创意写作案例
世界知识理解案例
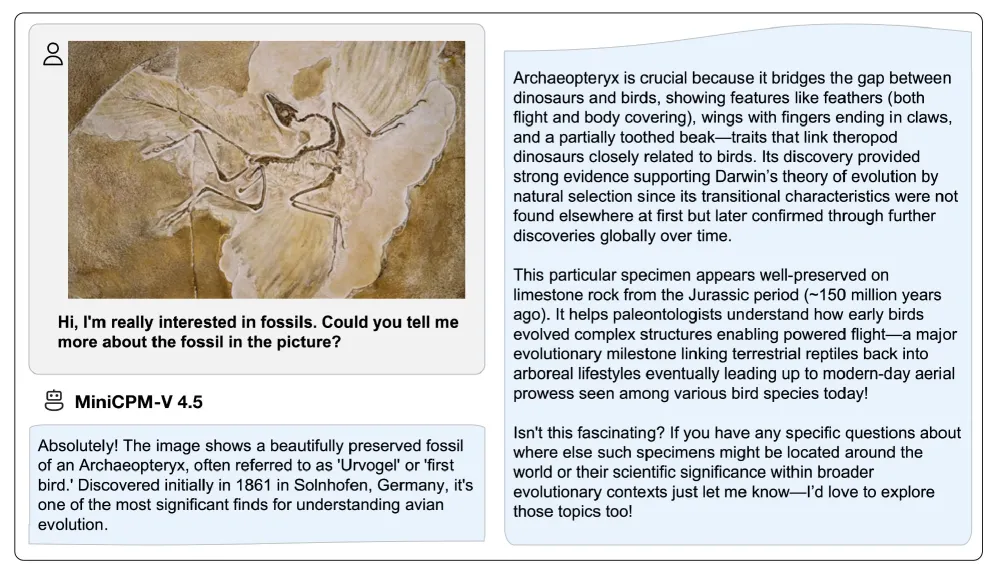
手写识别案例
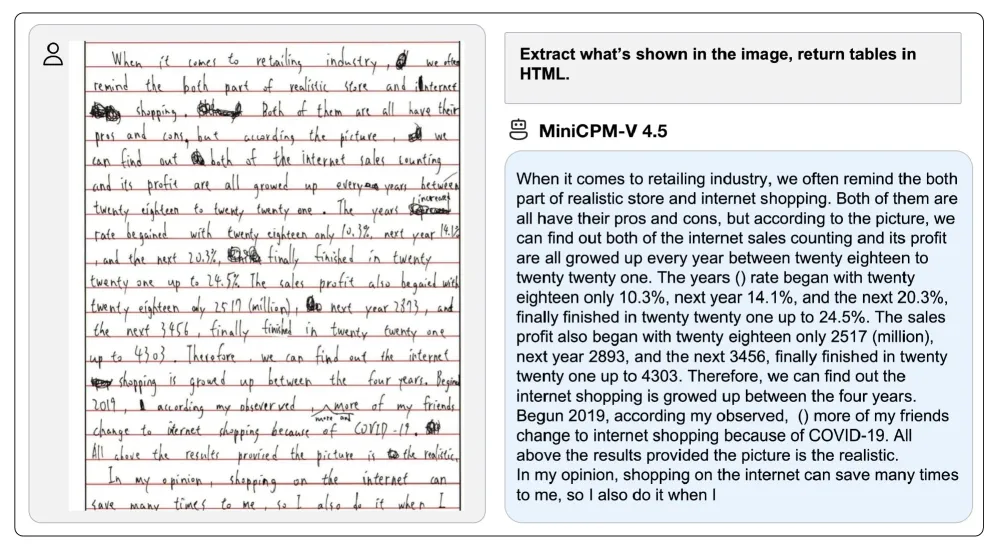
表格提取案例
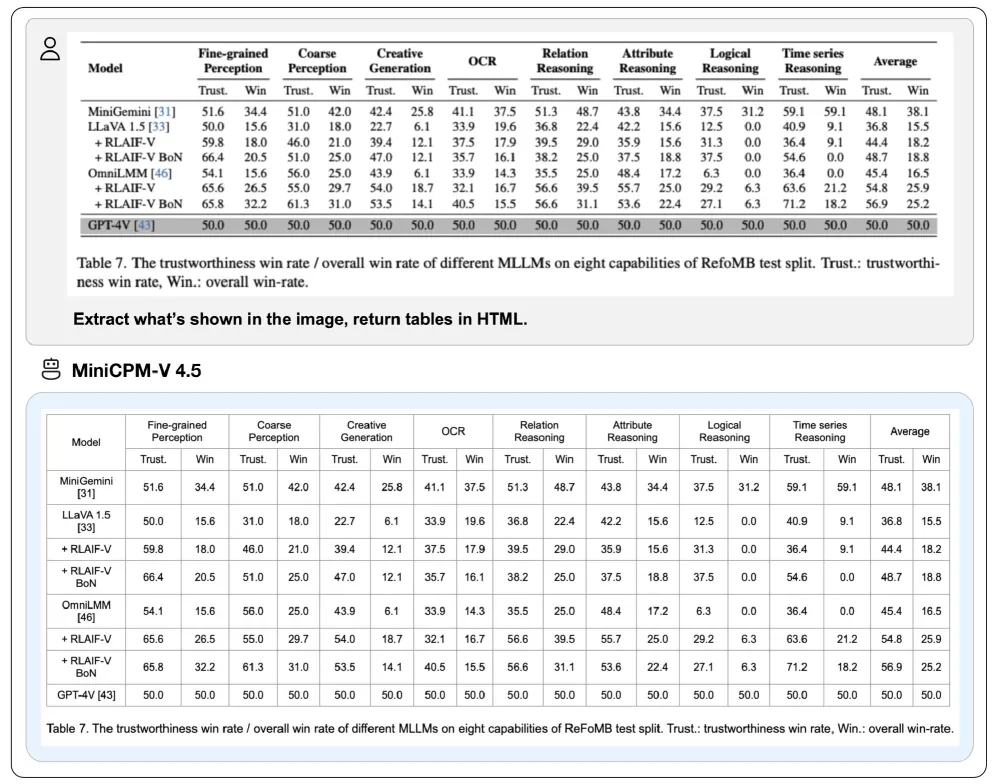
化学问题求解案例
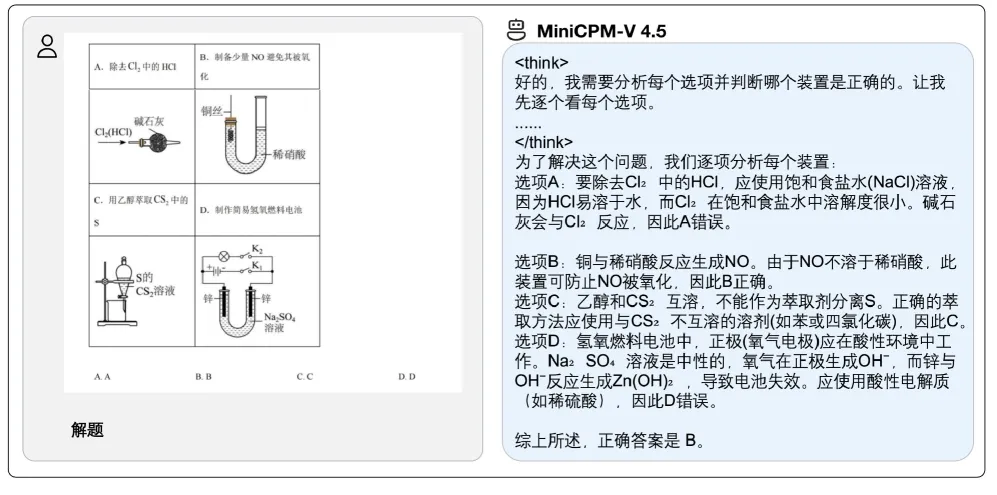
八、相关工作
| 方向 | 代表工作 | MiniCPM-V 4.5优势 |
|---|---|---|
| 开源MLLM | Qwen2.5-VL, InternVL3 | 8B参数超越72B模型 |
| 商业MLLM | GPT-4o, GLM-4.1V | OpenCompass 77.0超越GPT-4o |
| 视频理解 | VideoLLaMA, VideoChat | 96×视频压缩,高帧率支持 |
| 文档OCR | GOT-OCR, Surya | 统一范式无需外部解析器 |
九、总结
核心贡献
- 提出统一3D-Resampler架构,实现图像和视频的高效联合压缩
- 设计动态视觉损坏范式,统一文档知识学习和OCR训练目标
- 开发混合RL策略,支持可控的短/长推理模式切换
- 在8B参数规模下实现超越GPT-4o和72B开源模型的性能
技术影响
- 证明小参数模型通过架构和训练优化可以超越大模型
- 为MLLM效率优化提供系统性方法论(架构+数据+训练)
- 推动高帧率和长视频理解的实际应用
局限性
- 论文未详细披露所有基准的具体数值
- 3D-Resampler在极端长视频上的扩展性需进一步验证
- 混合推理模式的prompt控制在复杂场景下可能需要优化