Expert-as-a-Service (EaaS): 高效、可扩展、鲁棒的大规模MoE模型服务系统
本文提出EaaS,一种将MoE模块解耦为独立无状态服务的新型服务系统,实现细粒度资源扩展和固有容错能力,在模拟硬件故障下吞吐量下降不超过2%,并可节省高达37.5%的计算资源。
Expert-as-a-Service (EaaS): 高效、可扩展、鲁棒的大规模MoE模型服务系统
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Expert-as-a-Service: Towards Efficient, Scalable, and Robust Large-scale MoE Serving |
| 作者 | Ziming Liu, Boyu Tian, Guoteng Wang, Zhen Jiang, Peng Sun, Zhenhua Han, Tian Tang, Xiaohe Hu, Yanmin Jia, Yan Zhang, He Liu, Mingjun Zhang, Yiqi Zhang, Qiaoling Chen, Shenggan Cheng, Mingyu Gao, Yang You, Siyuan Feng |
| 机构 | National University of Singapore, Shanghai Qiji Zhifeng Co., Ltd., Infrawaves, Nanyang Technology University, Tsinghua University, Shanghai Innovation Institute |
| 论文 | arXiv:2509.17863 |
| 代码 | 未公开 |
| 发布 | 2025年9月22日 |
| 许可 | CC BY-NC-SA 4.0 |
| 领域 | cs.DC (Distributed, Parallel, and Cluster Computing) |
二、核心思想
问题定义
混合专家模型(Mixture-of-Experts, MoE)通过稀疏激活机制降低了计算成本,但其动态、稀疏的专家利用模式给服务基础设施带来了严峻挑战。传统的单体(monolithic)服务架构是为稠密模型设计的,在部署大规模MoE模型时面临三大核心问题:
-
低效的资源供给与高昂的运营成本:单体架构以粗粒度、不可分割的单元进行扩展(如DeepSeek-V3需要320个GPU作为一个单元),即使在低流量时段也必须保持大量GPU集群在线,导致严重的资源闲置和高昂的运营成本。
-
差的容错能力与高昂的恢复开销:集体通信原语(如All-to-All)要求所有参与者健康运行,单个GPU或网络链路的故障可能导致整个服务崩溃。恢复需要重启整个数百GPU的部署,造成严重的停机时间。
-
静态负载均衡与性能瓶颈:专家到GPU的映射在部署时固定,无法适应动态的输入依赖的专家激活模式,导致”热点”专家过载而”冷”专家闲置。
解决方案概述
EaaS的核心洞察在于专家的无状态性(statelessness)。MoE层中的专家网络执行纯粹的幂等函数——接收token的隐藏状态作为输入并产生输出,不保留任何序列级别的状态。基于此洞察,EaaS将MoE模块解耦为独立的、无状态的服务,实现了:
- 细粒度资源扩展:专家服务器池可以独立于注意力处理前端进行扩展,支持逐GPU级别的弹性伸缩
- 固有容错能力:通过专家复制和透明请求重定向实现优雅降级
- 动态负载均衡:通过服务实例化机制动态创建”热点”专家的副本
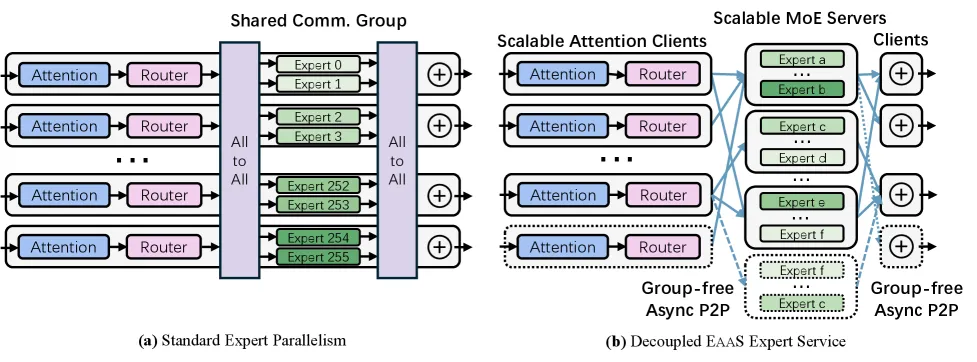 Figure 4: EaaS架构概览。与传统Expert Parallelism需要与其他集体并行共享通信组不同,EaaS将MoE层与其他稠密组件解耦,实现灵活可扩展的部署。
三、技术架构
整体框架图
EaaS采用解耦的、面向服务的架构,将MoE模型推理分解为两个独立可扩展的实体:
-
注意力客户端(Attention Clients):处理稠密计算(如注意力机制)。当到达MoE层时,客户端的路由器通过异步点对点(P2P)通信将激活分发到相应的专家服务器。
-
可扩展的专家服务器(Scalable Expert Servers):无状态服务,每个服务器托管一个或多个专家。这些服务器通过动态批处理来自不同客户端的请求来最大化GPU利用率。
┌─────────────────────────────────────────────────────────────────┐
│                        EaaS 系统架构                             │
├─────────────────────────────────────────────────────────────────┤
│                                                                 │
│  ┌──────────────┐    ┌──────────────┐    ┌──────────────┐      │
│  │  Attention   │    │  Attention   │    │  Attention   │      │
│  │  Client 1    │    │  Client 2    │    │  Client N    │      │
│  │  (Stateful)  │    │  (Stateful)  │    │  (Stateful)  │      │
│  └──────┬───────┘    └──────┬───────┘    └──────┬───────┘      │
│         │                   │                   │               │
│         │    P2P (IBGDA)    │                   │               │
│         │   CPU-free 异步通信 │                   │               │
│         ▼                   ▼                   ▼               │
│  ┌──────────────┐    ┌──────────────┐    ┌──────────────┐      │
│  │  Expert      │    │  Expert      │    │  Expert      │      │
│  │  Server 1    │    │  Server 2    │    │  Server M    │      │
│  │  (Stateless) │    │  (Stateless) │    │  (Stateless) │      │
│  └──────────────┘    └──────────────┘    └──────────────┘      │
│                                                                 │
│  ┌──────────────────────────────────────────────────────┐      │
│  │              Monitor (心跳监控)                        │      │
│  │    - 健康检测  - 故障通知  - 映射更新                    │      │
│  └──────────────────────────────────────────────────────┘      │
│                                                                 │
└─────────────────────────────────────────────────────────────────┘
核心公式
MoE层的计算可以形式化描述为:
专家路由(Expert Routing):
其中 是门控函数, 是第 个专家网络, 是专家总数。每个token只激活Top-K个专家(稀疏性)。
EaaS解耦的关键特性:
- 注意力层(有状态):维护KV Cache,与序列上下文相关
- MoE层(无状态):执行纯函数映射 ,无需维护序列级别的状态
这种无状态性使得专家可以被复制、迁移和独立扩展,而不会影响推理结果的正确性。
模型组件
| 组件 | 说明 | 关键设计 |
|---|---|---|
| Attention Client | 处理注意力层的有状态计算,维护KV Cache | 支持Double-Batch-Overlap优化 |
| Expert Server | 托管一个或多个专家的无状态服务 | 动态批处理,Kernel Shrinking优化 |
| Shared Communication Buffer | 共享内存缓冲区用于P2P通信 | 避免内存拷贝,支持零拷贝传输 |
| IBGDA Communication Library | CPU-free的点对点通信库 | 支持CUDA Graph捕获,最小化内核启动开销 |
| Monitor | 中心化心跳监控服务 | 检测故障、通知相关组件、更新映射 |
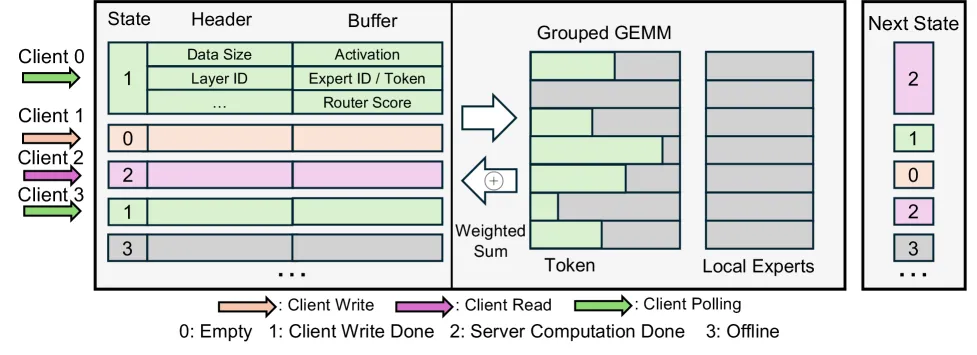 Figure 5: EaaS专家服务器的动态批处理机制。专家服务器持续监控并聚合来自注意力客户端的请求。
训练流程(系统优化)
EaaS包含五个关键优化:
4.1 Kernel Optimization for Expert Server
- Kernel Shrinking:压缩组元数据以提高专家服务器调度效率
- 通过紧凑的数据结构减少内存访问开销
4.2 Double-Batch-Overlap in Attention Client
- 将注意力计算与通信重叠执行
- 通过双批处理策略掩盖通信延迟
4.3 CUDA Graph for End-to-End Acceleration
- 消除CPU参与的内核启动开销
- 实现端到端的CUDA Graph捕获
4.4 Flexible IBGDA Connection
- 利用InfiniBand GPUDirect Async (IBGDA) 实现GPU直接通信
- 绕过CPU,消除主机内存队列访问开销
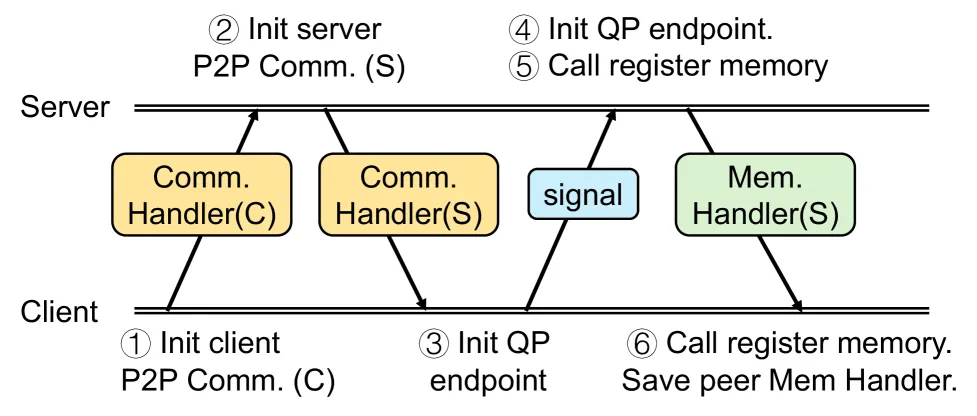 Figure 7: IBGDA连接建立过程
4.5 Dynamic Load Balancing for Experts
- 支持三种负载均衡策略:
- 调整每个服务器上的专家数量(非均匀分配)
- 基于IBGDA连接的动态扩缩容
- 改变专家托管实例的计算/内存规格
共享通信缓冲区设计
EaaS设计了高效的共享通信缓冲区机制:
- 注意力客户端在MoE层处将激活写入共享缓冲区
- 专家服务器通过轮询缓冲区状态(标志位”1”表示数据就绪)来检测请求
- 服务器直接从缓冲区读取数据,计算后写回结果
- 避免了传统方案中的多次内存拷贝
容错机制
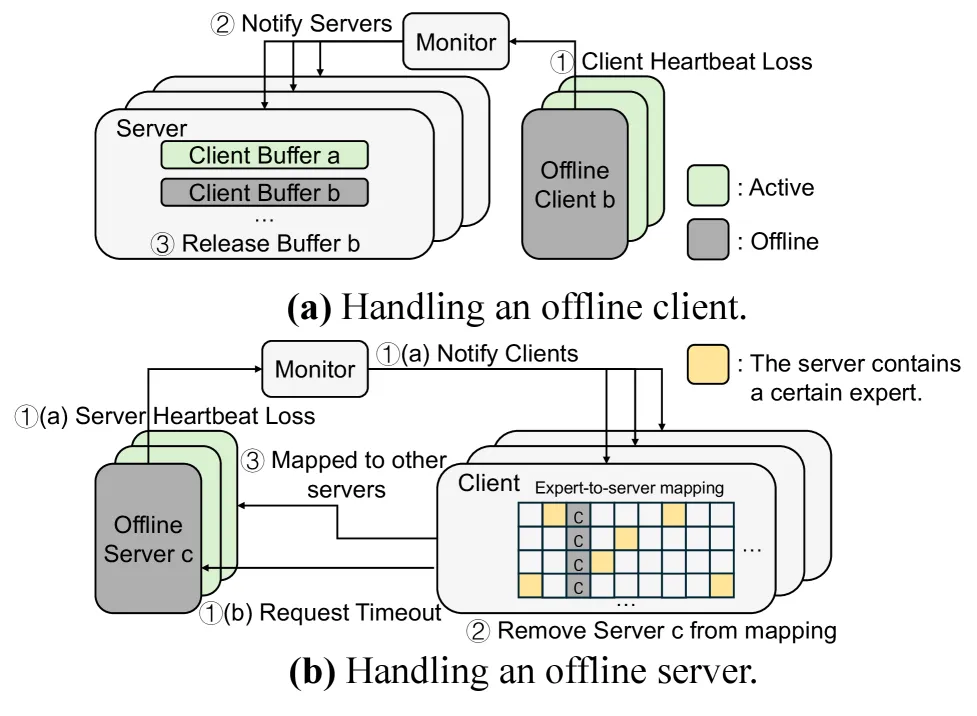 Figure 6: EaaS利用Monitor监控所有运行worker的心跳,当检测到离线客户端/服务器时发送通知。
客户端故障处理:
- Monitor检测到客户端心跳丢失后通知所有相关专家服务器
- 服务器释放该客户端的通信缓冲区
- 故障被局部化,不影响其他客户端和服务
服务器故障处理:
- 通过Monitor心跳检测或客户端超时检测
- 客户端自动更新专家-服务器映射,移除故障服务器
- 请求被自动重定向到托管相同专家副本的备用服务器
- 透明的故障转移,对最终推理结果影响可忽略
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 专家无状态性解耦 | 将MoE层从单体架构中解耦为独立无状态服务 | 专家执行纯幂等函数,无需维护序列状态 |
| CPU-free P2P通信库 | 基于IBGDA的异步点对点通信,完全绕过CPU | 比StepMesh降低49.6%延迟(对称场景) |
| 细粒度弹性扩展 | 支持任意GPU数量的扩展,而非固定分组 | 从32到64 GPU近线性扩展,节省37.5%资源 |
| 透明容错 | 通过专家复制和请求重定向实现优雅降级 | 故障下吞吐量下降不超过2% |
| 动态负载均衡 | 支持专家级别的动态扩缩容和负载再分配 | 与现有EPLB算法兼容,额外提供3种均衡方式 |
五、实验结果
实验设置
| 配置项 | 详情 |
|---|---|
| 硬件 | 16个计算节点,每节点8个NVIDIA Hopper GPU (80GB),节点内NVLink,节点间8×400Gbps RoCE |
| 框架 | PyTorch 2.7.1, Python 3.12, CUDA 12.6 |
| 模型 | DeepSeek-R1 671B |
| 工作负载 | ShareGPT数据集,最大响应长度768 tokens |
| 基线 | SGLang+EP (SGL-EP), SGLang+TP (SGL-TP), vLLM+DeepEP |
| 指标 | 解码吞吐量、Token间延迟(ITL) |
基准测试
端到端性能评估
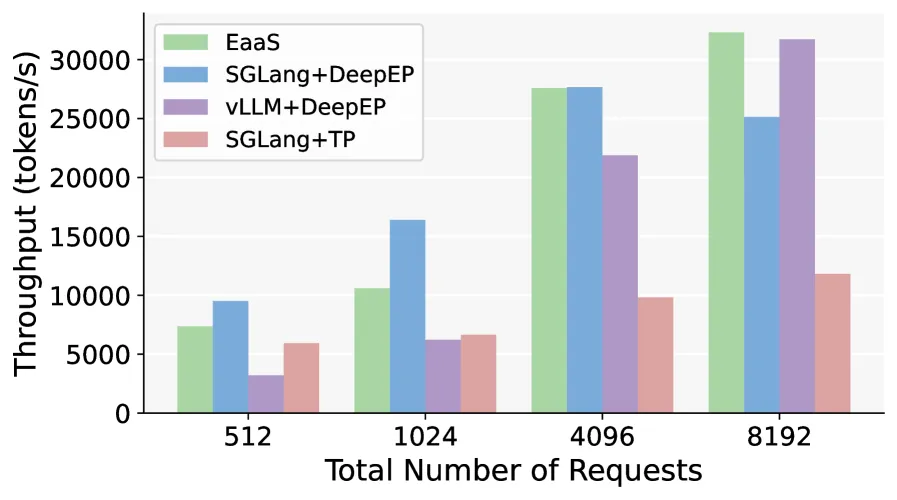 Figure 8a: 128 GPU (64 prefilling + 64 decoding) 解码吞吐量对比
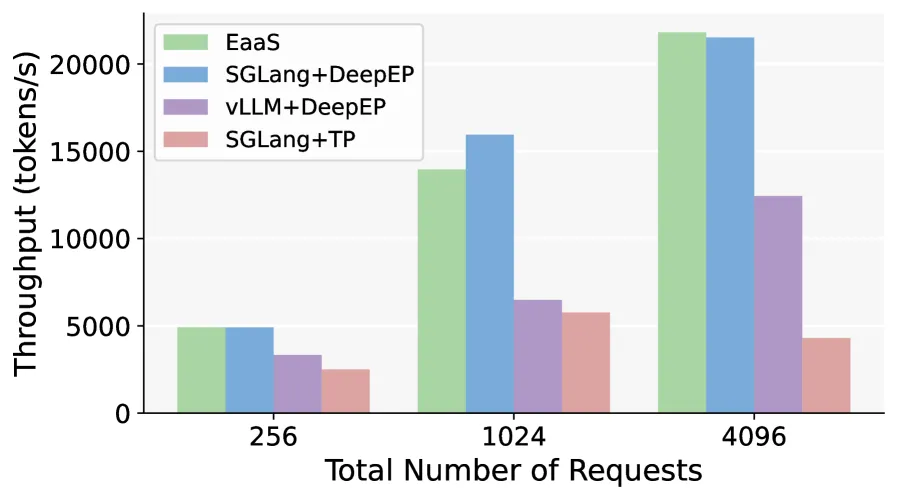 Figure 8b: 48 GPU (16 prefilling + 32 decoding) 解码吞吐量对比
关键发现:
- SGL-EP:在低请求量时性能竞争力强,但在高流量下出现明显的长尾延迟
- SGL-TP:ITL低且稳定(推理单元小,仅16 GPU),但吞吐量显著低于其他方法(需多次复制模型权重)
- vLLM:大规模配置下吞吐量高,但ITL较高
- EaaS:得益于高效通信库和均衡的资源分配,在保持强吞吐量的同时维持可接受的延迟
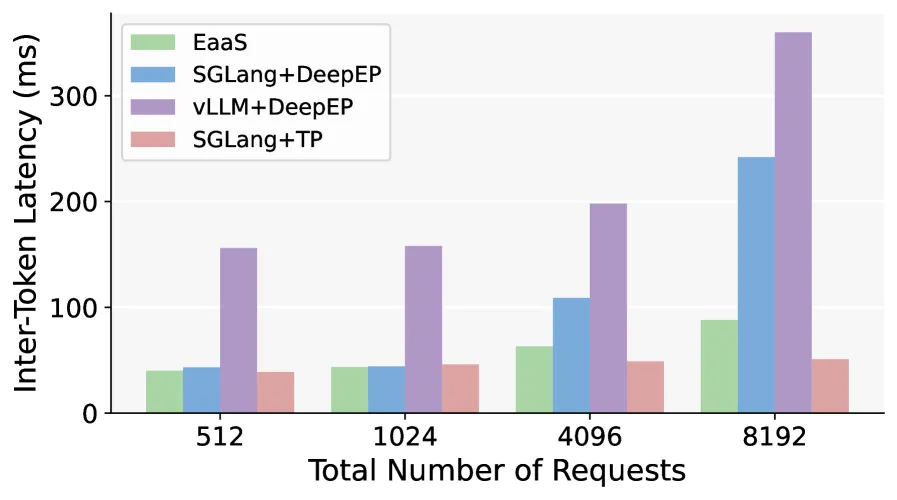 Figure 9a: 128 GPU配置下的Token间延迟对比
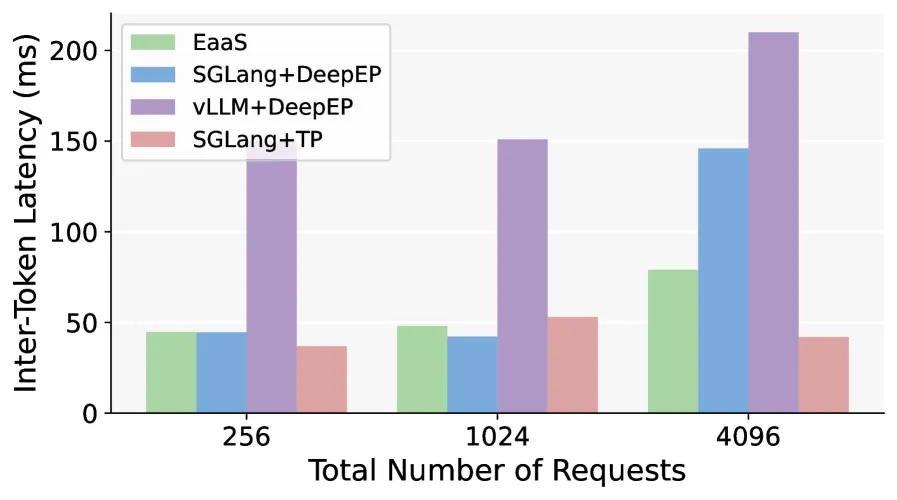 Figure 9b: 48 GPU配置下的Token间延迟对比
可扩展性评估
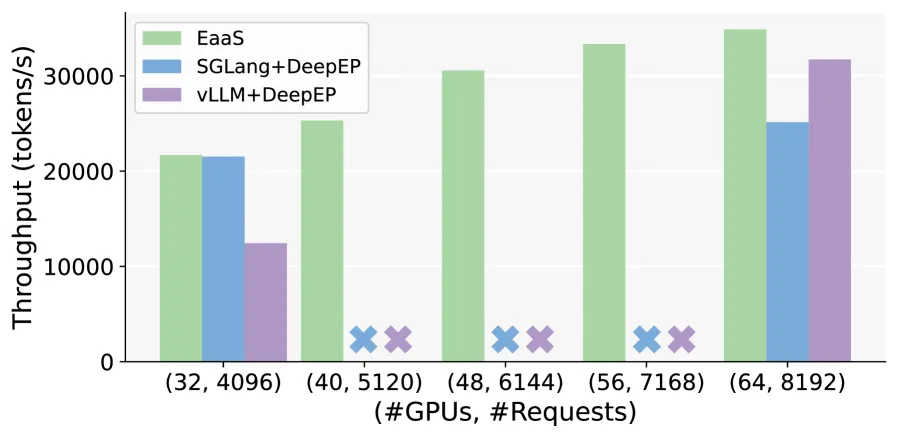 Figure 11: 弱扩展性实验。SGLang和vLLM只能在能整除7168的GPU数量下运行,而EaaS支持任意GPU数量。
关键发现:
- EaaS从32到64 GPU展现近线性的吞吐量增长
- SGL-EP和vLLM-EP无法在非标准GPU数量(如40、48、56)上运行
- 当流量从8192降至5120时,SGL-EP/vLLM-EP仍需64个解码GPU,而EaaS可降至40-48个GPU
- EaaS可节省高达37.5%的计算资源
容错能力评估
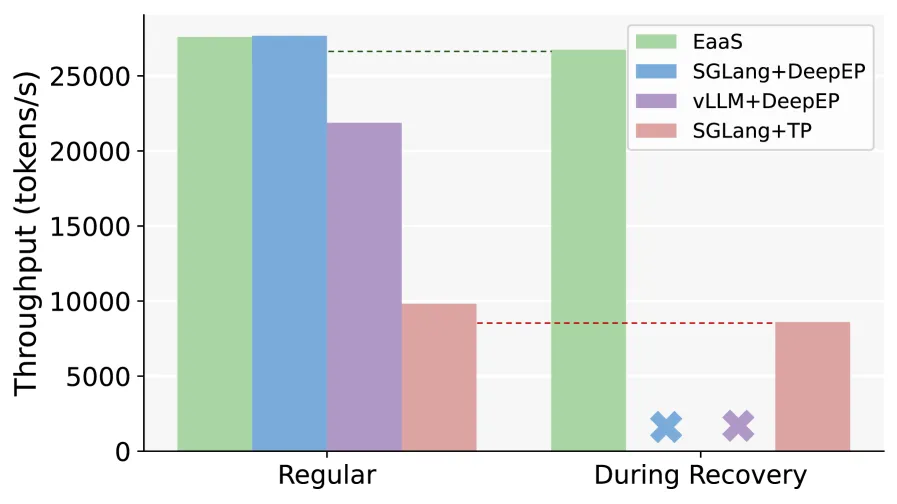 Figure 10: 容错实验结果。EaaS在故障恢复期间保持高吞吐量,仅出现轻微性能下降。
实验方法: 随机禁用10个GPU(逐个),测量恢复期间的平均解码吞吐量。
关键发现:
- SGL-EP和vLLM-EP:无法在恢复期间继续服务(所有解码GPU属于同一通信组,单GPU故障需重启整个组)
- SGL-TP:得益于较小的执行单元(16 GPU),仅需重启故障所在的组
- EaaS:通过预复制专家,故障请求可重定向到备用服务器;注意力客户端独立运行,故障可由PD解耦引擎的路由机制处理
- EaaS在GPU故障时吞吐量下降不超过2%
通信库对比
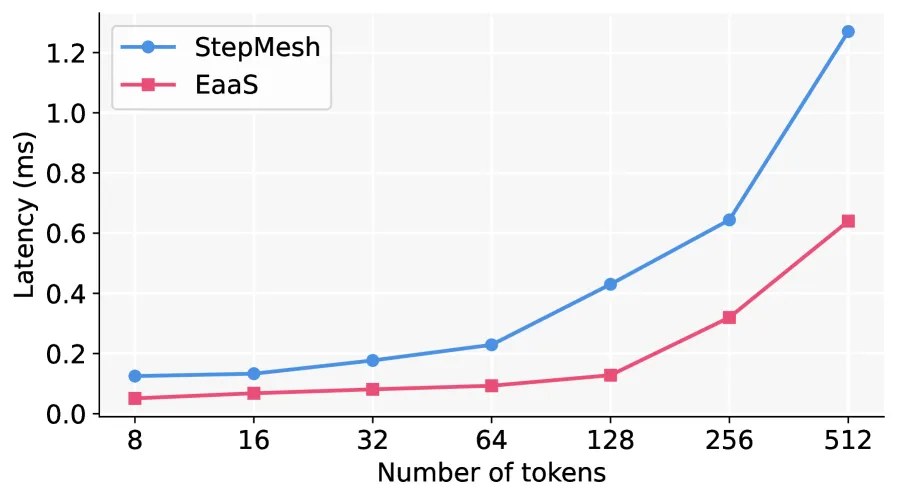 Figure 12a: 对称场景下的端到端通信延迟
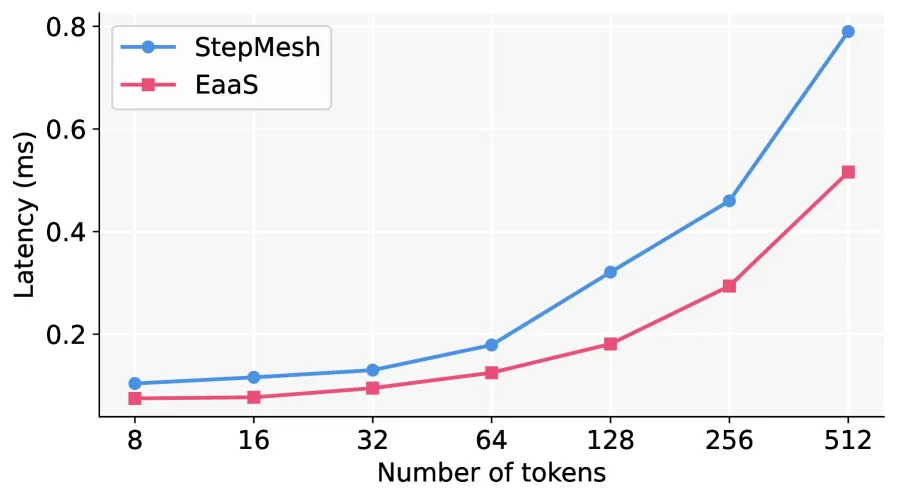 Figure 12b: 非对称场景下的端到端通信延迟
实验设置: PyTorch张量形状 (batch_size, 1, 7168),客户端发送到服务器后立即返回。
关键发现:
- 对称场景(2客户端 + 2服务器):EaaS比StepMesh降低**49.6%**延迟
- 非对称场景(1客户端 + 3服务器):EaaS比StepMesh降低**34.7%**延迟
- 性能优势来源于:(1) IBGDA绕过CPU消除主机内存访问开销;(2) CUDA Graph捕获减少通信内核启动开销
消融实验
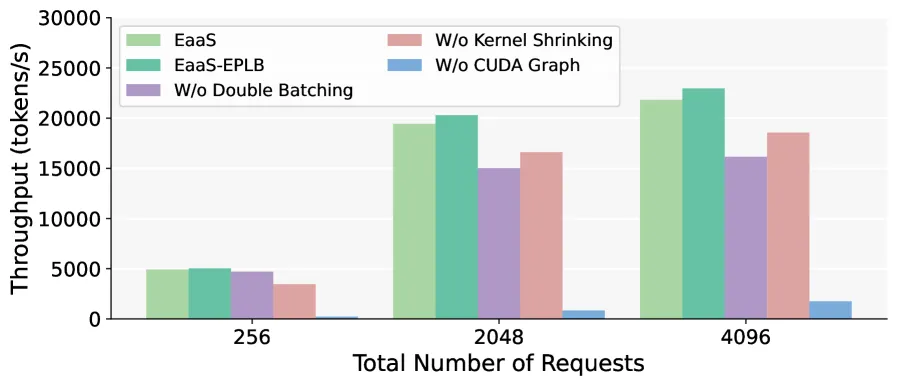 Figure 13: 消融实验表明EaaS的三个关键优化对性能都至关重要。
| 优化项 | 禁用后吞吐量下降 | 原因 |
|---|---|---|
| CUDA Graph | 91.9% | CPU端重复的内核启动开销 |
| Kernel Shrinking | 14.9% | 稀疏专家组上的低效调度 |
| Double Batching | 25.9% | 通信延迟不再被重叠掩盖 |
负载均衡兼容性: 结合DeepSeek提出的专家负载均衡算法,EaaS分别实现了2.4%、4.4%和5.1%的性能提升。
六、相关工作
LLM Serving Frameworks
- vLLM:引入PagedAttention进行高效KV Cache内存管理
- SGLang:通过RadixAttention实现高效的前缀缓存
- MLC-LLM:通过机器学习编译器在多种平台上实现服务
- TensorRT-LLM:提供灵活的LLM API和最先进的优化
- 这些框架针对稠密模型优化,未解决MoE模型的动态稀疏性问题
Parallelisms For LLMs
- Tensor Parallelism (TP):张量并行
- Pipeline Parallelism (PP):流水线并行
- Data Parallelism (DP):数据并行
- Expert Parallelism (EP):专家并行,将专家分布到不同设备
- EaaS将EP从模型的稠密部分和其他并行维度中解耦
同类工作对比
- MegaScale-Infer 和 Step-3:也探索了将注意力和MoE层解耦到不同层级,但依赖CPU控制的通信库(基于GDRCopy技术),引入额外开销且无法实现CUDA Graph的端到端捕获
- DeepEP:高性能通信库,但仍采用单体架构
Communication Libraries
- NCCL:广泛使用的集体通信库
- NVSHEMEM:NVIDIA GPU的可扩展高效通信
- Centauri 和 Concerto:通过重叠技术减少分布式通信开销
- EaaS引入了支持IBGDA的新型异步P2P通信库
七、总结
核心贡献
- 提出EaaS架构:首次将MoE层解耦为独立无状态服务,实现细粒度弹性扩展、固有容错和高效服务
- 设计CPU-free P2P通信库:基于IBGDA实现GPU直接通信,支持CUDA Graph端到端捕获,显著降低通信延迟
- 实现透明容错机制:通过专家复制和请求重定向,在硬件故障下保持服务连续性(吞吐量下降<2%)
- 验证细粒度可扩展性:支持任意GPU数量的弹性伸缩,节省高达37.5%的计算资源
- 提供动态负载均衡:支持专家级别的动态扩缩容,适应动态的专家激活模式
技术影响
EaaS提出的服务化范式为大规模MoE模型的生产部署建立了灵活高效的基础设施:
- 云服务商:可按需精确分配资源,降低运营成本
- 大规模推理:在保持性能的同时提供生产级的可靠性保障
- 系统设计:为MoE模型的服务架构提供了新的设计范式,从单体到解耦的服务化架构
局限性
- 代码未公开:目前论文未提供开源实现,可复现性受限
- 负载均衡算法:论文主要评估了与现有算法的兼容性,尚未设计专门针对EaaS的负载均衡策略
- 通信拓扑限制:当前实现基于InfiniBand/RoCE网络,对其他网络环境的适配性有待验证
- 模型适用性:主要在DeepSeek-R1 671B上验证,对其他MoE架构(如不同专家数量/大小)的泛化性需要进一步评估
- 故障恢复延迟:虽然吞吐量下降不超过2%,但论文未详细讨论故障检测到恢复完成的端到端延迟
八、参考资源
- 论文: https://arxiv.org/abs/2509.17863
- PDF: https://arxiv.org/pdf/2509.17863
- HTML: https://arxiv.org/html/2509.17863v1
- 引用格式: arXiv:2509.17863 [cs.DC]
关键参考文献
| 引用 | 说明 |
|---|---|
| DeepSeek-V3/R1 | 大规模MoE模型,EaaS的主要评估对象 |
| DeepEP | 高性能MoE通信库,EaaS的主要基线 |
| SGLang | 高效LLM服务框架,使用RadixAttention |
| vLLM | 引入PagedAttention的LLM服务框架 |
| MegaScale-Infer | 同类MoE解耦服务方案,基于GDRCopy |
| IBGDA (NVIDIA) | InfiniBand GPUDirect Async技术 |
| Mooncake | PD解耦引擎 |
| EPLB | DeepSeek提出的专家并行负载均衡算法 |
分析日期: 2026-05-31