Qwen3-Omni Technical Report
阿里巴巴Qwen团队的统一多模态模型,在文本、图像、音频、视频上无性能退化
Qwen3-Omni Technical Report
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Qwen3-Omni Technical Report |
| 作者 | Jin Xu, Zhifang Guo, Hangrui Hu, Yunfei Chu, Xiong Wang, Jinzheng He, Yuxuan Wang, Xian Shi, Ting He, Xinfa Zhu 等 37 人 |
| 机构 | Qwen Team (阿里巴巴) |
| 论文 | arXiv:2509.17765 |
| 代码 | GitHub |
| 发布 | 2025年9月22日 |
| 许可 | Apache 2.0 (模型), CC BY 4.0 (论文) |
| 主题 | cs.CL, cs.AI, cs.CV, eess.AS |
二、核心思想
问题定义
当前以 LLM 为中心的多模态模型通常存在模态权衡问题——在一个模态上的提升往往伴随着其他模态的退化。例如,为文本模型添加音频能力通常会削弱其文本性能。
解决方案概述
Qwen3-Omni 是一个统一的端到端多模态模型,首次在文本、图像、音频和视频上保持 SOTA 性能且无任何退化。它匹配同尺寸单模态模型的性能,并在音频任务上表现尤为突出。
核心性能
- 36 个音频和音视频基准中:32 个开源 SOTA,22 个整体 SOTA
- 超越 Gemini-2.5-Pro、Seed-ASR、GPT-4o-Transcribe 等闭源模型
- 支持 119 种文本语言、19 种语音理解语言、10 种语音生成语言
- 冷启动端到端首包延迟 234ms
三、技术架构
Thinker-Talker MoE 架构
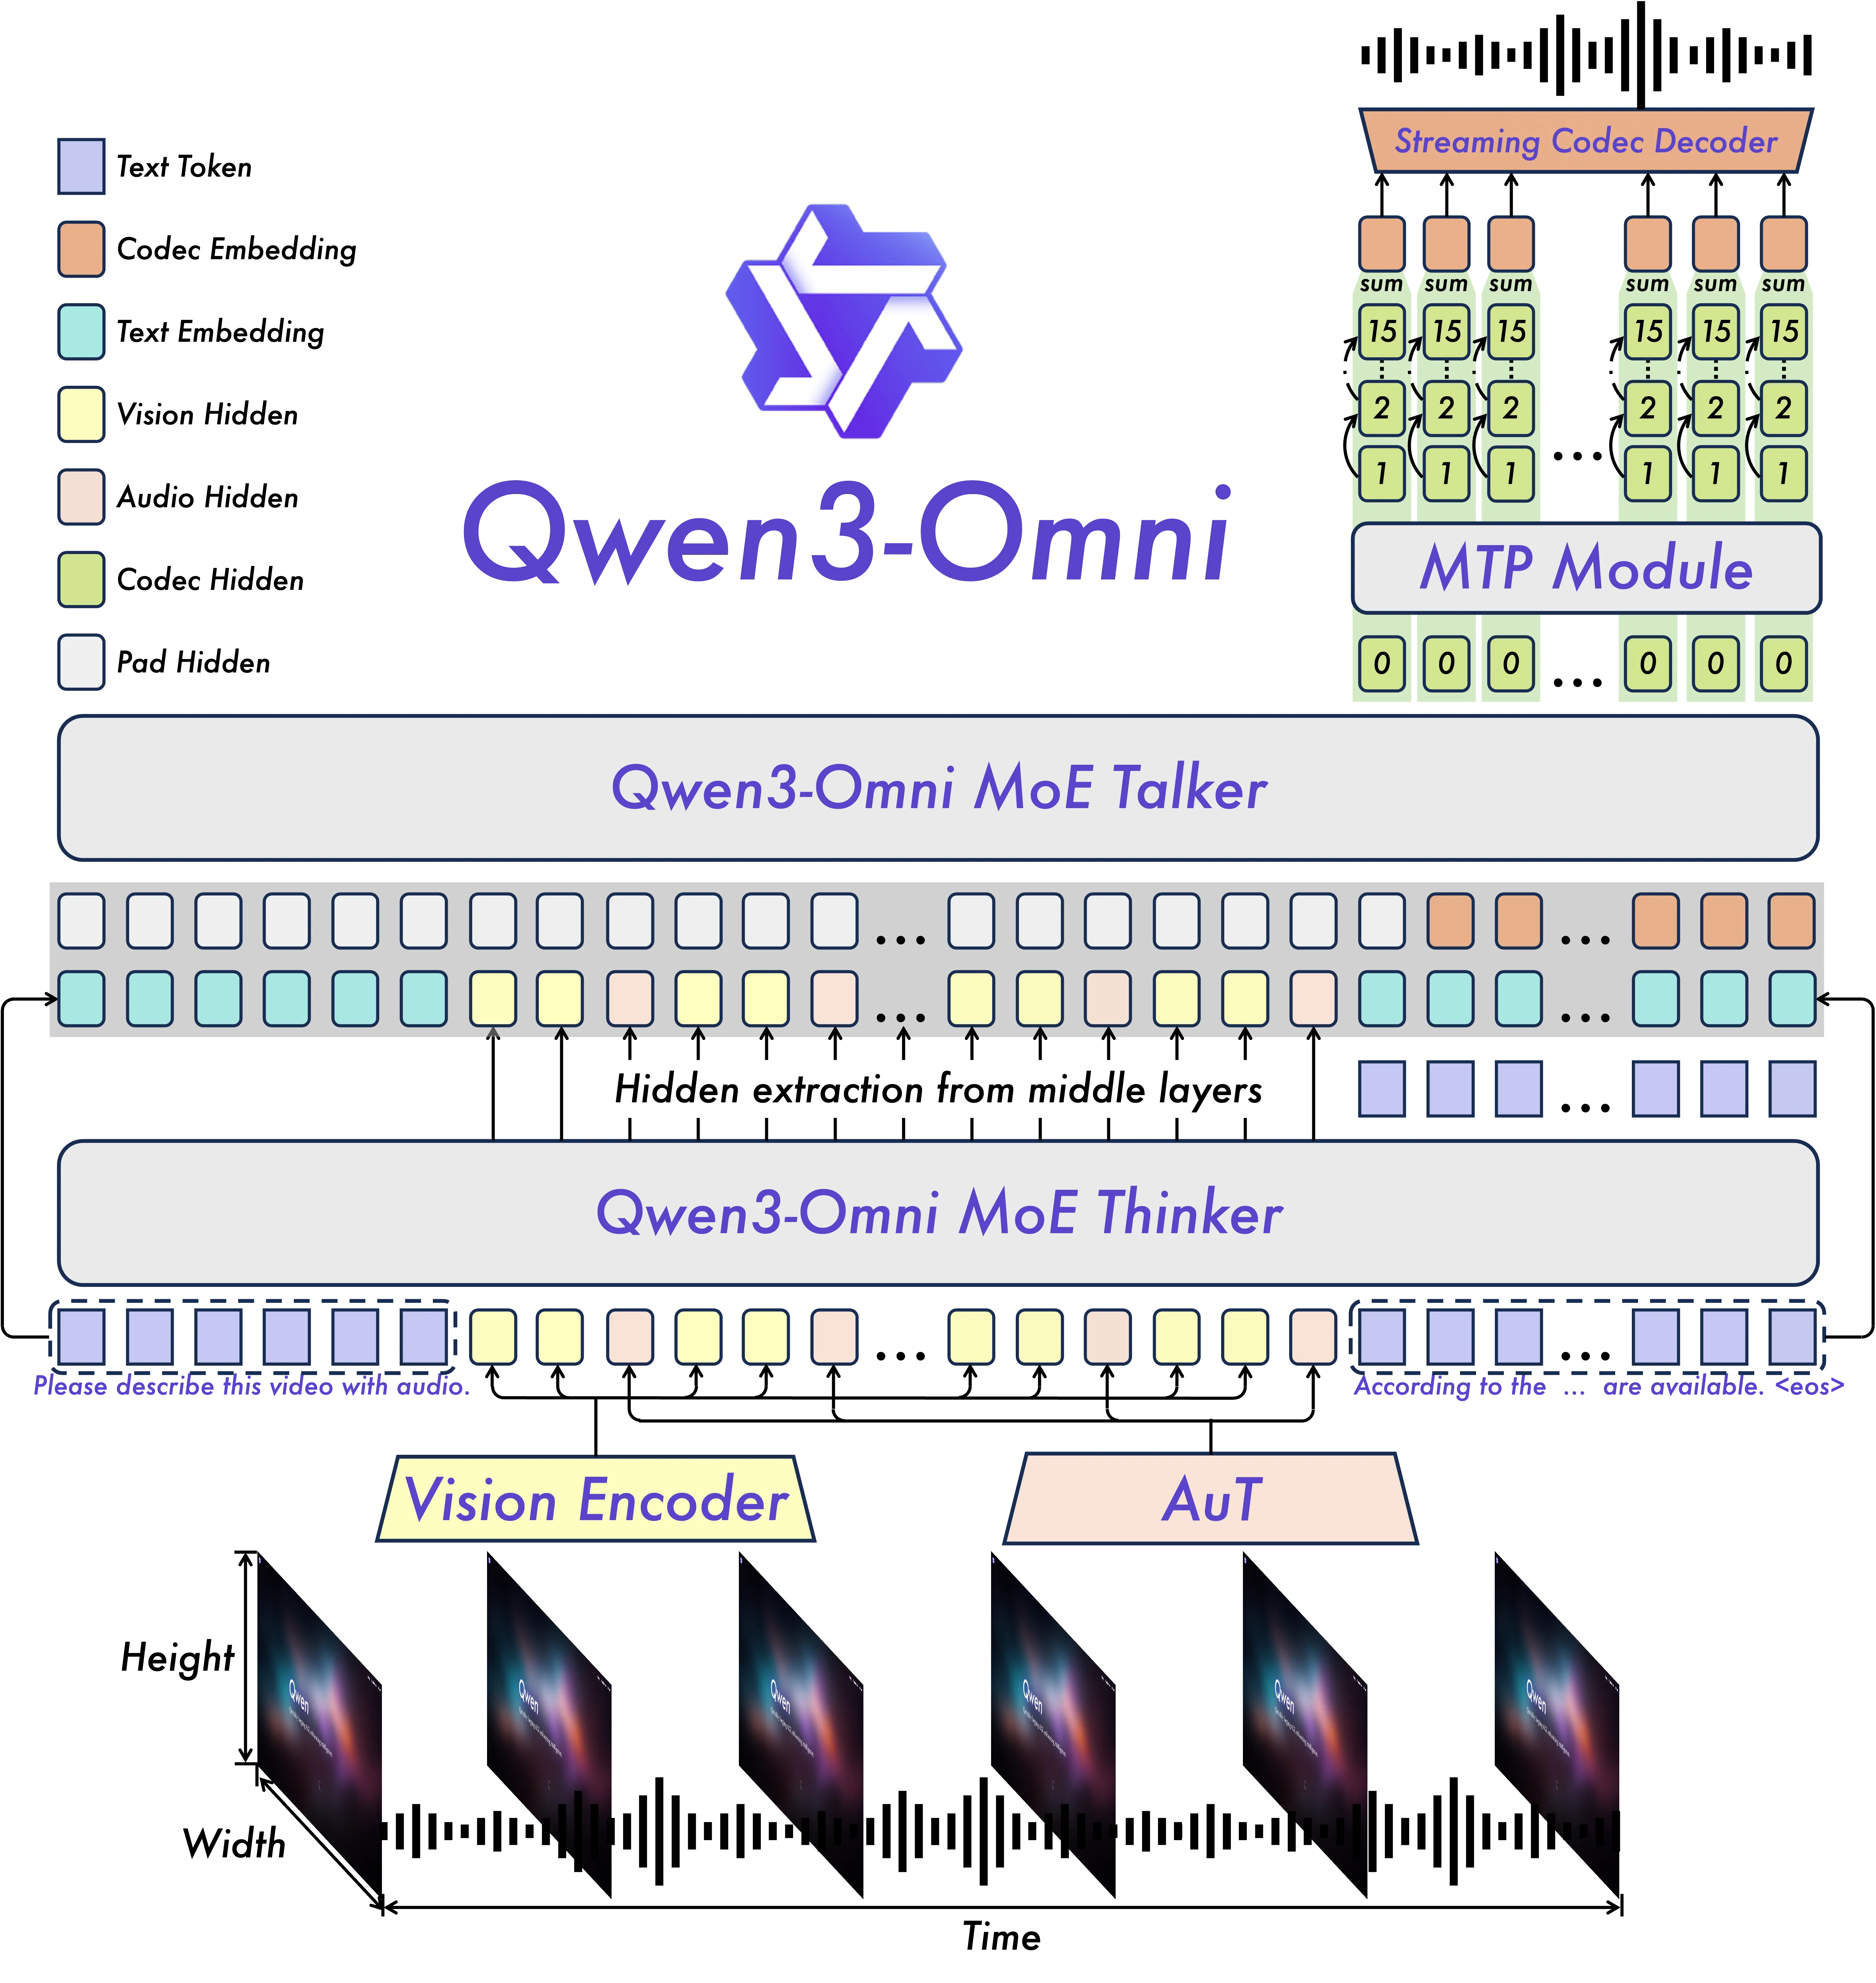
Figure 2: Thinker-Talker 架构详细图
Qwen3-Omni 采用 Thinker-Talker MoE 架构,统一感知和生成跨文本、图像、音频和视频。
| 模块 | 架构 | 参数量 | 流式 |
|---|---|---|---|
| 音频编码器 | AuT (Audio Transformer) | 650M | 是 |
| 视觉编码器 | SigLIP2-So400M | 540M | - |
| Thinker | MoE Transformer | 30B-A3B | 是 |
| Talker | MoE Transformer | 3B-A0.3B | 是 |
| MTP (多 token 预测) | Dense Transformer | 80M | 是 |
| Code2Wav | ConvNet | 200M | 是 |
端到端首包延迟: 234ms (音频) / 547ms (视频)
相比 Qwen2.5-Omni 的五大升级
1. MoE 设计: Thinker 和 Talker 均采用 MoE 架构,支持高并发和快速推理
2. AuT 编码器: 替代 Whisper,使用自研 Audio Transformer,在 2000 万小时监督音频上从零训练
3. 多码本表示: 增强对多样化语音、副语言线索和声学现象的建模能力
4. 多轨道编解码器建模: Talker 从单轨道转向多轨道,通过 MTP 模块自回归预测多个码本层
5. 轻量 ConvNet (Code2Wav): 替代块级 DiT,使用轻量卷积网络进行波形合成,支持从第一帧开始的流式生成
Thinker-Talker 解耦
关键设计选择:Talker 不再消费 Thinker 的高级文本表示,仅基于音频和视觉多模态特征进行条件化。这使得:
- 外部模块(RAG、函数调用、安全过滤器)可以干预 Thinker 的文本输出
- Thinker(响应风格)和 Talker(音频风格)可使用独立的系统提示
- 文本 token 和嵌入在离散 token 处理中信息等价
音频 Transformer (AuT)
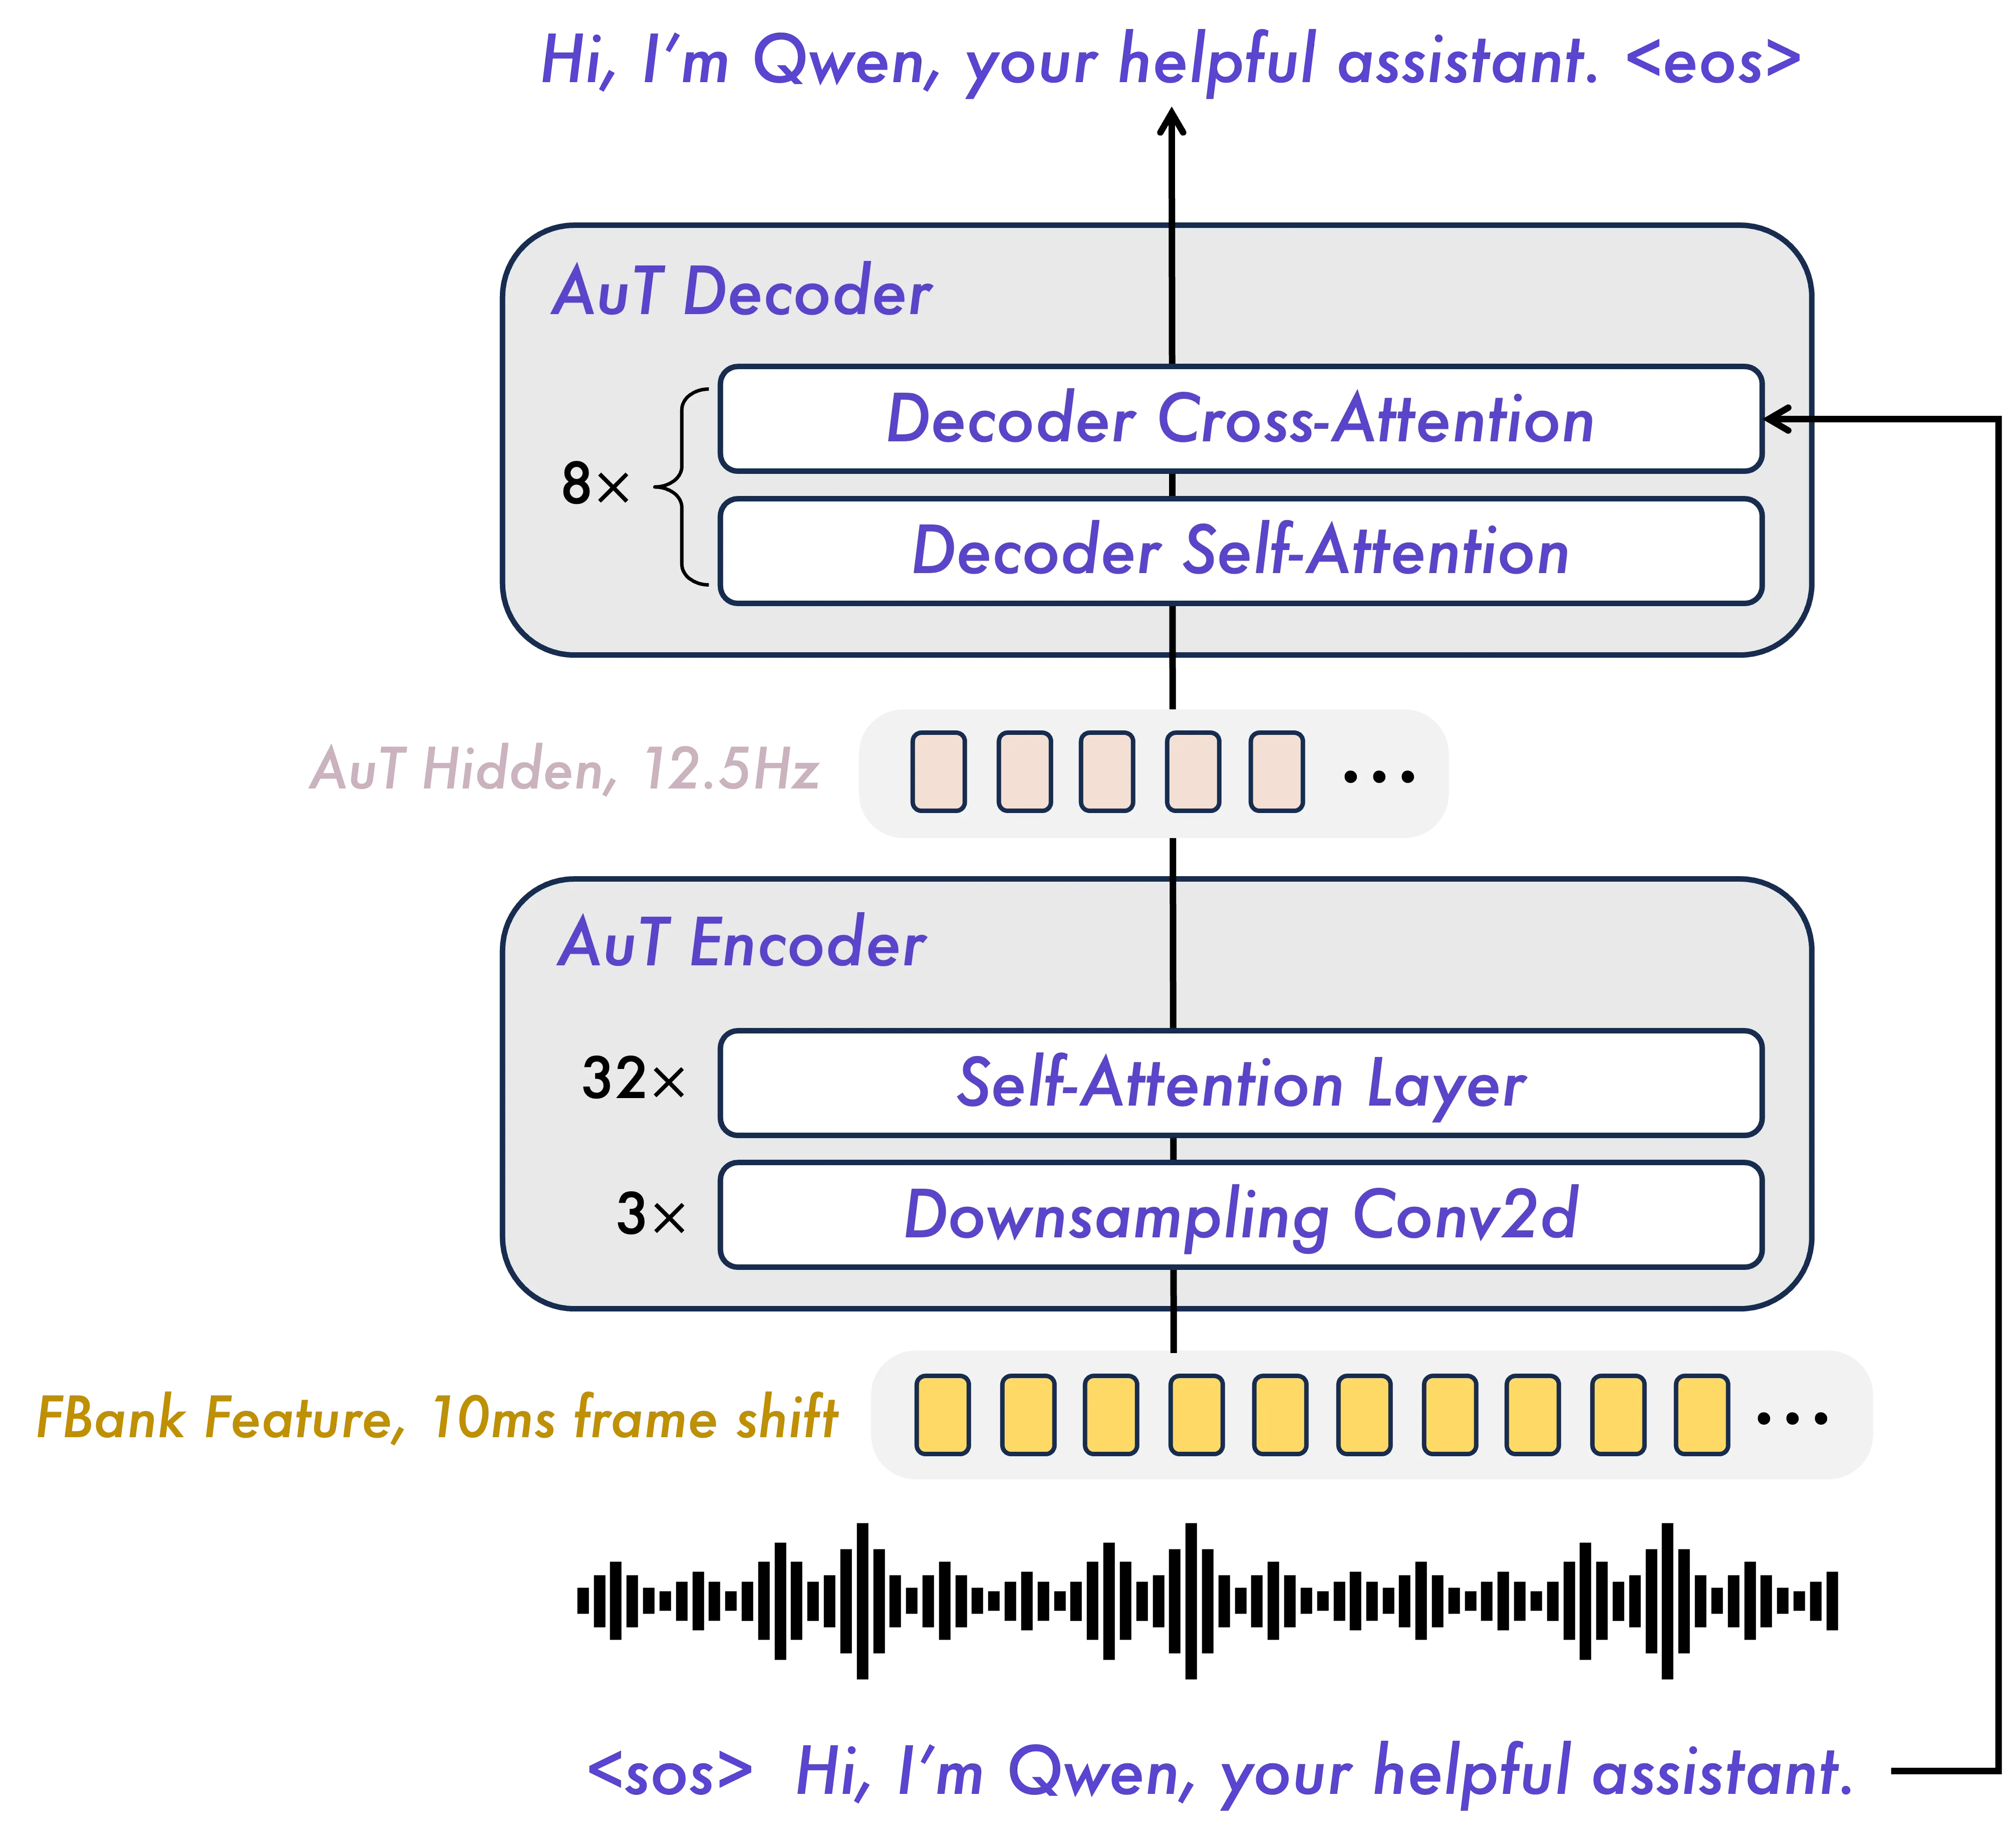
Figure 3: AuT 音频 Transformer 编码器架构
- 注意力编码器-解码器模型,在 2000 万小时监督音频上从零训练
- 训练数据:80% 中英文伪标签 ASR,10% 其他语言 ASR,10% 音频理解
- 使用 flash attention,动态注意力窗口大小(1-8 秒)
- 通过 Conv2D 块将滤波器组特征下采样 8 倍,实现 12.5 Hz token 率
- 约 0.6B 参数
时间对齐多模态 RoPE (TM-RoPE)
扩展多模态旋转位置编码,融入绝对时间信息:
- 将旋转位置编码分解为三个维度:时间(24 角度)、高度(20 角度)、宽度(20 角度)
- 音频输入使用共享位置 ID,带绝对时间编码(每 ID 80ms)
- 视频帧使用单调递增的时间 ID,动态调整到 80ms 分辨率
- 支持任意时长的流式输入
流式和并发设计
- 分块预填充机制: 音频和视觉编码器沿时间维度输出块
- 异步预填充: Thinker 和 Talker 异步预填充以减少 TTFT
- 多码本生成: Talker 生成第一个 token 后,MTP 模块预测当前帧的剩余 token
- 逐帧流式: Code2Wav 解码器在每个 token 后立即合成波形,实现超低首包延迟
理论首包延迟(Table 2):
- 并发 1 时:234ms
- 由于 MoE 架构,高并发下仍保持低延迟
四、预训练
数据
多样化数据集涵盖多种语言、方言和模态:
- 图像-文本、视频-文本、音频-文本、视频-音频、视频-音频-文本和纯文本语料
- 使用更广泛的自然语言提示(不同于 Qwen2.5-Omni 每个任务的单一提示)
三阶段预训练
| 阶段 | 内容 |
|---|---|
| 阶段 1 | 锁定 LLM 参数,用大量音频-文本和图像-文本对训练视觉和音频编码器 |
| 阶段 2 | 解冻所有参数,用更广泛的多模态数据训练 |
| 阶段 3 | 使用序列长度 32,768 的数据进行长序列理解训练 |
关键发现: 在早期预训练阶段混合单模态和跨模态数据,可在所有模态上实现无退化的性能对齐。
五、后训练
Thinker 后训练(三阶段)
| 阶段 | 内容 |
|---|---|
| SFT | 轻量级监督微调,桥接预训练表示和下游任务 |
| 强到弱蒸馏 | 从教师模型(Qwen3-32B 或 Qwen3-235B-A22B)进行离策略蒸馏 + KL 散度对齐的在策略蒸馏 |
| GSPO (RL) | 基于规则的奖励(数学、代码、指令跟随)+ 基于模型的奖励(Qwen3 作为 LLM-as-a-judge,Qwen2.5-VL 用于视觉任务) |
Talker 后训练(四阶段)
| 阶段 | 内容 |
|---|---|
| 阶段 1 | 用数亿条带多模态上下文的语音数据训练 |
| 阶段 2 | 持续预训练(CPT)+ 长上下文训练 |
| 阶段 3 | DPO 用于多语言语音生成泛化 |
| 阶段 4 | 说话人微调,提升自然度、表现力和可控性 |
Captioner
- 从 Qwen3-Omni-30B-A3B 微调,基于大规模详细音频描述
- 生成详细、低幻觉的任意音频输入字幕
- 填补通用音频字幕模型的空白
六、评估结果
文本到文本性能
Qwen3-Omni-30B-A3B-Instruct 超越更大模型:
- 在 GPQA、AIME25、ZebraLogic、WritingBench、PolyMath 上超越 Qwen3-235B-A22B Non-Thinking
- 在多个基准上超越 GPT-4o-0327
Qwen3-Omni-30B-A3B-Thinking 性能可比 Gemini-2.5-Flash-Thinking 和 Qwen3-235B-A22B Non-Thinking。
音频性能 (ASR & S2TT)
- 英文和中文 ASR SOTA(Librispeech、Wenetspeech、Fleurs、CommonVoice)
- 最佳歌词 ASR(Opencpop-test、MIR-1K)
- 多语言 ASR 和 S2TT 与专家模型竞争力强
语音交互与音频推理
| 基准 | Qwen3-Omni-Thinking | Gemini-2.5-Pro |
|---|---|---|
| VoiceBench | 89.5 | 89.6 |
| MMAU | 超越 | - |
| MMSU | 超越 | - |
- VoiceBench: 89.5 平均分(仅次于 Gemini-2.5-Pro 的 89.6)
- MMAU: 超越 Gemini-2.5-Pro 和 Gemini-2.5-Flash
- MMSU: 超越 Gemini-2.5-Flash 和 GPT-4o-Audio
音乐理解
- RUL-MuchoMusic SOTA
- 在 GTZAN、MTG-Jamendo、MagnaTagATune 上显著超越 Gemini-2.5-Pro 和 GPT-4o-Audio
视觉到文本性能
- 可比 Qwen2.5-VL-72B
- 在数学和 STEM 任务(MMMU-Pro、MathVista、MATH-Vision)上优于 GPT-4o 和 Gemini-2.0-Flash
音视频性能
- WorldSense 基准 SOTA
- 复杂推理任务(DailyOmni、VideoHolmes)性能增强
语音生成
| 任务 | 表现 |
|---|---|
| Zero-Shot TTS | SEED 测试集高度竞争力,RL 优化后最佳 |
| 多语言 TTS | 超越 MiniMax-Speech 和 ElevenLabs(中、英、法) |
| 跨语言 TTS | 超越 CosyVoice3(any-to-en、any-to-ko) |
七、跨模态无退化(核心贡献)
控制对比实验训练了三个匹配参数的模型:
- 纯文本基线
- 纯视觉基线
- 多模态 “Omni” 模型
关键发现:
- 预训练中早期多模态集成允许语言模型与视觉或音频共同训练且无任何退化
- 文本模态的加入显著提升视觉和音频性能
- 添加音频数据一致提升 MMMU 和 OCR 相关任务的视觉性能
- 联合多模态训练实现不同模态间的相互增强
基准对比(Table 16):
| 基准 | Qwen3-Omni-30B-A3B-Base | Qwen3-30B-A3B-Base |
|---|---|---|
| MMLU | 81.69 | 81.24 |
| EvalPlus | 73.96 | 69.70 |
多模态训练可以增强而非退化单模态能力。
八、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Thinker-Talker MoE | 统一多模态架构,Thinker 生成文本,Talker 生成语音 | 首次实现跨模态无退化 |
| AuT 编码器 | 自研音频 Transformer,2000 万小时训练 | 替代 Whisper,支持流式 |
| TM-RoPE | 时间对齐多模态旋转位置编码 | 支持任意时长流式输入 |
| 多码本多轨道 | Talker 多轨道编解码器建模 | 更好的语音多样性和表现力 |
| Code2Wav | 轻量卷积波形合成 | 替代 DiT,支持流式 |
| 跨模态无退化 | 早期混合训练消除模态权衡 | 首次实验证据 |
| Thinker-Talker 解耦 | Talker 不依赖 Thinker 文本表示 | 支持外部模块干预 |
九、发布模型
| 模型 | 描述 | 许可 |
|---|---|---|
| Qwen3-Omni-30B-A3B | 主指令模型 | Apache 2.0 |
| Qwen3-Omni-30B-A3B-Thinking | 推理变体 | Apache 2.0 |
| Qwen3-Omni-30B-A3B-Captioner | 音频字幕模型 | Apache 2.0 |
十、总结
核心贡献
- 首个跨模态无退化的统一多模态模型: 在文本、图像、音频、视频上保持 SOTA 且无性能退化
- 32/36 音频基准 SOTA: 统一模型超越 Gemini-2.5-Pro 等闭源模型
- 234ms 首包延迟: 超低延迟流式语音合成
- Thinker-Talker MoE 架构: 创新的解耦设计支持外部模块干预
- AuT 编码器: 自研音频 Transformer,在 2000 万小时数据上训练
- 跨模态增强: 首次证明多模态训练可实现模态间相互增强
技术影响
- 模态权衡不再是必然: 证明专业化与集成化并非根本性权衡
- 端到端优于级联: 更强的跨模态推理、更低延迟、更低成本
- 统一模型范式: 为更强大高效的统一 AI 系统铺平道路
局限性
- 长视频基准性能不佳(位置外推受限、上下文长度受限)
- 未来工作:多人 ASR、视频 OCR、音视频主动学习、基于智能体的工作流
十一、参考资源
- 论文: arXiv:2509.17765
- 代码: GitHub - QwenLM/Qwen3-Omni
- 许可: Apache 2.0