GraphMend: Code Transformations for
Source-Level Compiler Technique to Eliminate FX Graph Breaks
GraphMend: Code Transformations for Fixing Graph Breaks in PyTorch 2
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | GraphMend: Code Transformations for Fixing Graph Breaks in PyTorch 2 |
| 作者 | Savini Kashmira, Jayanaka Dantanarayana, Thamirawaran Sathiyalogeswaran, Krisztian Flautner, Lingjia Tang, Jason Mars |
| 机构 | University of Michigan |
| 论文 | arXiv:2509.16248 |
| 代码 | 基于 Jaseci 框架 |
| 发布 | 2025-09-17 (v3: 2026-04-30) |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
PyTorch 2 引入 TorchDynamo 和 TorchInductor 实现即时图编译,但动态控制流和不支持的 Python 构造经常将模型分割成多个 FX 图(graph breaks)。这些片段导致:
- 频繁回退到 eager 模式:每次 graph break 都需要回退到 Python 执行
- 昂贵的 CPU-GPU 同步:需要 cudaDeviceSynchronize + D2H memcpy
- 优化机会丧失:TorchInductor 无法跨 break 边界进行内核融合
解决方案概述
GraphMend 是一种源码级编译器技术,在执行前分析和转换源代码,消除因动态控制流和 Python 副作用导致的 graph breaks。核心设计:
- 谓词化数据依赖控制流:用
torch.where/torch.cond重写 if/else - 延迟副作用:将 print/logger 调用移到函数末尾
- 谓词化验证守卫:用
torch._assert_async替换torch.equal验证
三、技术架构
整体框架图
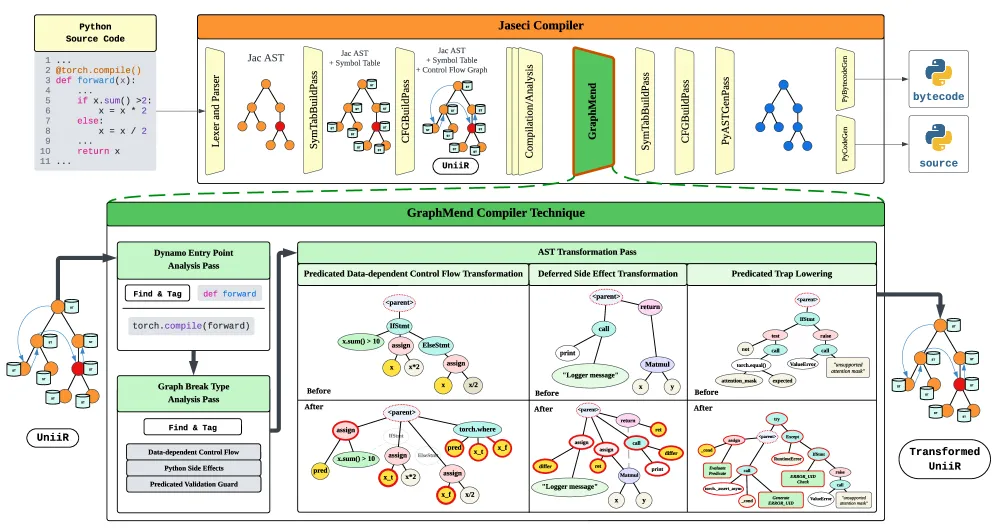
GraphMend 集成在 Jaseci 编译管线中:
- Python 源码 → UniiR(统一中间表示,含 AST、符号表、CFG)
- GraphMend 分析入口点、检测 graph breaks、应用 AST 转换
- 转换后的代码进入 TorchDynamo 字节码分析
核心转换
转换 1:谓词化数据依赖控制流
问题:if x.sum() > 0: 依赖 tensor 数据,Dynamo 无法安全评估
解决:用 torch.where 重写,保持计算在单个 FX 图中
# 原始代码(graph break)
if x.sum() > 0:
    return x * 2
else:
    return x * 3

# 转换后(无 graph break)
return torch.where(x.sum() > 0, x * 2, x * 3)
转换 2:延迟副作用
问题:print()/logger 调用与 Python 运行时交互,无法在函数式图中表示
解决:将副作用操作延迟到图执行后
# 原始代码(graph break)
x = torch.relu(x)
print("tensor:", x)  # graph break
return torch.sin(x)

# 转换后(无 graph break)
x = torch.relu(x)
to_print = "tensor:", x  # 分配到 buffer
y = torch.sin(x)
print(to_print)  # 在追踪结束后打印
return y
转换 3:谓词化验证守卫
问题:torch.equal(a, b) 返回 Python bool,导致 graph break
解决:用 torch._assert_async 替换,保持 tensor 操作在图内
# 原始代码(graph break)
if not torch.equal(attention_mask, expected):
    raise ValueError("unsupported attention mask")

# 转换后(无 graph break)
_meta_ok = (attention_mask.shape == expected.shape
            and attention_mask.dtype == expected.dtype)
_cond = (
    (attention_mask == expected).all()
    if _meta_ok
    else torch.tensor(False, device=attention_mask.device)
)
torch._assert_async(_cond, 'unsupported attention mask')
为什么字节码级转换困难
- 控制流模糊:if/else 和 while 循环都变成 POP_JUMP 指令,难以区分
- 数据流分析困难:Python 使用栈模型,中间值无显式命名
- 副作用追踪:需要符号绑定信息判断是内置函数还是用户重定义
模型组件
| 组件 | 说明 | 关键特性 |
|---|---|---|
| Jaseci IR | 统一中间表示(UniiR) | AST + 符号表 + CFG |
| 入口点分析 | 识别模型入口函数 | 追踪调用链 |
| Graph Break 检测 | 识别三类 break 原因 | 控制流/副作用/验证 |
| AST 转换 | 三种代码重写规则 | 谓词化/延迟/断言 |
| TorchDynamo 集成 | 转换后代码进入标准管线 | 无修改编译流程 |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 源码级转换 | 在 AST 层面消除 graph breaks,保留完整语义 | 字节码级转换信息丢失严重 |
| 三类 break 覆盖 | 数据依赖控制流 + 副作用 + 验证守卫 | 覆盖 73% 的真实 graph breaks |
| PyTorch 2 完全兼容 | 无需修改 TorchDynamo/Inductor,作为前置 pass | 与标准编译管线无缝集成 |
| 低编译开销 | 冷运行 2.9% 开销,缓存后 0.9% | 一次性成本,完全摊销 |
| 无额外 IR | 直接在 Python AST 上操作 | 避免 TensorSSA 等系统的基础设施开销 |
五、代码实现分析
- 实现基础: Jaseci 编译框架
- IR: UniiR(统一中间表示)
- 转换目标: Python AST(抽象语法树)
- 集成方式: 作为 TorchDynamo 字节码分析前的预处理 pass
六、实验结果
基准测试
测试环境: NVIDIA RTX 3090 和 A40 GPU,TorchInductor 后端
模型选择: 195 个 HuggingFace 模型中 27 个存在 graph breaks
Graph Break 修复效果
| 指标 | 结果 |
|---|---|
| 修复模型数 | 21/27 完全修复,3/27 部分修复 |
| 修复 break 数 | 107/147 (73%) |
| 未修复原因 | tensor.item() 和动态 shape 操作 |
冷启动加速
| 模型 | 冷启动加速 |
|---|---|
| 平均 | 5x |
| 最高 | 25x |
| 最低 | 2x |
冷启动加速来自减少 CUDA graph 录制次数(每个 break 一个独立录制)。
稳态加速
| 模型 | 稳态加速 |
|---|---|
| 范围 | 1.05x ~ 1.34x |
| 数据依赖 break | 最大收益(消除 D2H 同步) |
| logger-only break | 1.05-1.09x |
| tiny-random-Pegasus | 1.34x(模型小,break 占比大) |
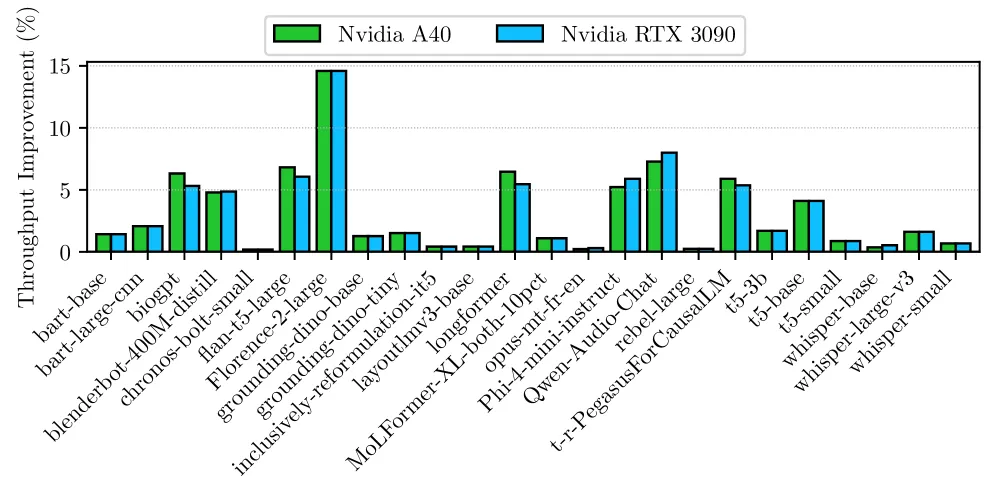
吞吐量提升
| 模型类型 | 吞吐量提升 |
|---|---|
| Florence-2-large (VLM) | 15%(非自回归,前向传播占比大) |
| Qwen-Audio-Chat | 8% |
| Phi-4-mini-instruct | 5% |
| 整体范围 | 最高 15% |
分析器追踪
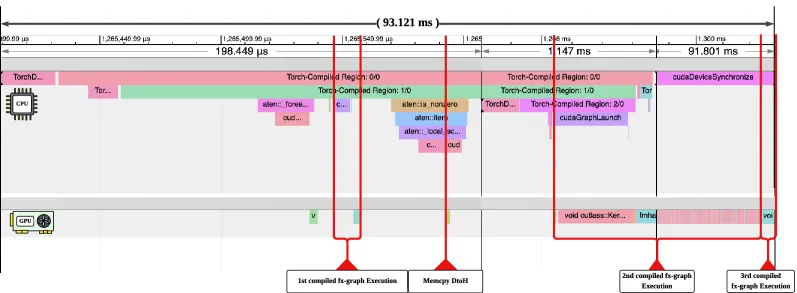
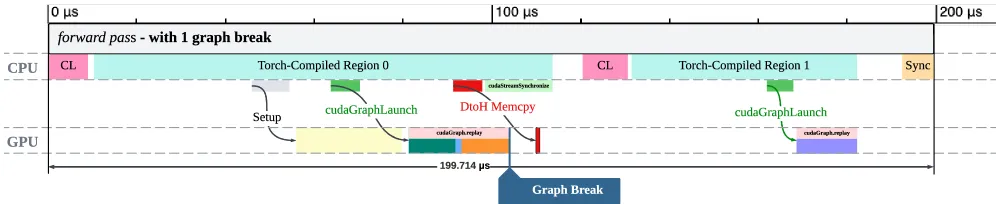
原始模型:3 个独立 CUDA graph,中间有 GPU 空闲 修复模型:1 个连续 CUDA graph,无中断
内核融合
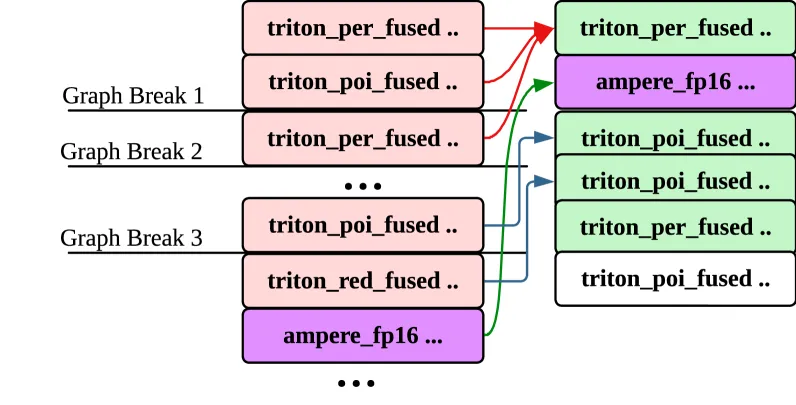
Phi-4-mini-instruct 模型:
- 原始:404 个内核
- 修复:393 个内核(减少 11 个)
- 三个小内核合并为一个融合内核
编译开销
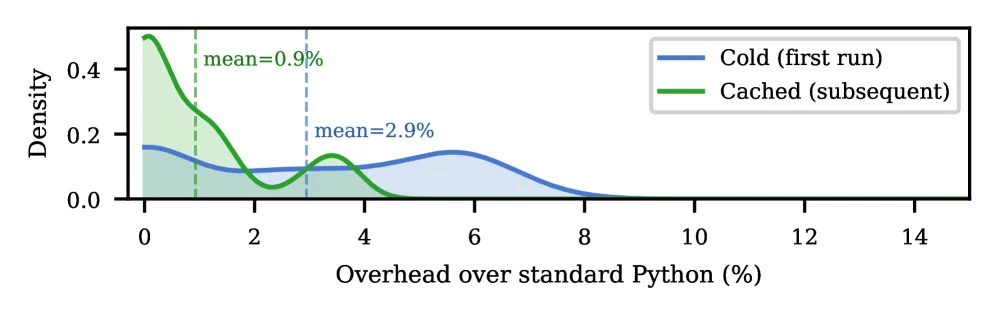
| 场景 | 开销 |
|---|---|
| 冷运行 | 平均 2.9% |
| 缓存运行 | 平均 0.9% |
与现有方法对比
| 特性 | AutoGraph | MagPy | TensorSSA | GraphMend |
|---|---|---|---|---|
| 源码级语义分析 | ✓ | ✓ | ✗ | ✓ |
| PyTorch 2 兼容 | ✗ | ✗ | ✗ | ✓ |
| 副作用处理 | ✗ | ✗ | ✗ | ✓ |
| 无需额外 IR | ✓ | ✓ | ✗ | ✓ |
| 运行前转换 | ✓ | ✗ | ✓ | ✓ |
七、相关工作
PyTorch 编译演进
- TorchScript:AOT 图捕获,但难以处理动态控制流
- TorchDynamo:字节码级图捕获,但 graph breaks 仍频繁
- TorchInductor:后端编译器,假设大图可用
源码级转换
- AutoGraph:TensorFlow 的源码级图生成,不兼容 PyTorch 2
- MagPy:替换 TorchDynamo,从运行时 trace 重建图
- TensorSSA:自定义 SSA-based IR,基础设施开销大
编译器基础设施
- XLA、TVM、MLIR:IR-based 优化,假设大图可用
- GraphMend 专注于最大化图连续性,使这些优化更有效
八、总结
核心贡献
- 提出 GraphMend,源码级编译器技术消除 PyTorch 2 的 FX graph breaks
- 设计三种 AST 转换覆盖数据依赖控制流、副作用、验证守卫
- 在 27 个 HuggingFace 模型上消除 73% 的 graph breaks
- 实现最高 25x 冷启动加速和 15% 吞吐量提升
- 编译开销可忽略(冷运行 2.9%,缓存 0.9%)
技术影响
- 作为 PyTorch 2 编译管线的前置 pass,无需修改现有基础设施
- 使 TorchDynamo 能捕获更大、更完整的 FX 图
- 为 serverless LLM serving 场景显著减少冷启动延迟
- 启发更多源码级优化技术应用于 PyTorch 生态
局限性
- 无法处理
tensor.item()和动态 shape 操作导致的 graph breaks - 仅覆盖三类常见 break 原因,其他原因需要单独处理
- 基于 Jaseci 框架实现,与 PyTorch 原生集成需要额外工作
- 吞吐量提升受 Amdahl 定律限制(非前向传播部分无法优化)
九、参考资源
- 论文: arXiv:2509.16248
- 相关工作:
- TorchDynamo (Ansel et al., 2024) - PyTorch 2 字节码级图捕获
- AutoGraph (Moldovan et al., 2019) - TensorFlow 源码级图生成
- MagPy (Zhang et al., 2024) - 替换 TorchDynamo 的运行时 trace
- TensorSSA (Ma et al., 2024) - SSA-based IR 张量分析
- Jaseci (Mars et al., 2023) - 编译框架