VLA-Adapter: An Effective Paradigm for Tiny-Scale Vision-Language-Action Model
A lightweight bridging paradigm that enables SOTA-level VLA performance with only 0.5B parameters, without robotic data pre-training
VLA-Adapter: An Effective Paradigm for Tiny-Scale Vision-Language-Action Model
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | VLA-Adapter: An Effective Paradigm for Tiny-Scale Vision-Language-Action Model |
| 作者 | Yihao Wang, Pengxiang Ding, Lingxiao Li, Can Cui, Zirui Ge, Xinyang Tong, Wenxuan Song, Han Zhao, Wei Zhao, Pengxu Hou, Siteng Huang, Yifan Tang, Wenhui Wang, Ru Zhang, Jianyi Liu, Donglin Wang |
| 机构 | 未明确标注(推测为中国研究机构,致谢中提到国家自然科学基金和北邮优秀博士生基金) |
| 论文 | arXiv:2509.09372 |
| 代码 | GitHub: OpenHelix-Team/VLA-Adapter |
| 模型 | HuggingFace: VLA-Adapter |
| 项目页 | https://vla-adapter.github.io/ |
| 发布 | 2025-09-11 (v1), 2025-09-22 (v2) |
| 领域 | Robotics (cs.RO) |
| 页数 | 28 pages |
二、核心思想
VLA-Adapter 提出了一种全新的视觉-语言-动作(Vision-Language-Action, VLA)模型桥接范式,旨在解决当前 VLA 模型对大规模视觉语言模型(VLM)和海量机器人数据预训练的严重依赖问题。
问题定义
当前 VLA 模型面临的核心瓶颈包括:
- 依赖大规模 VLM:需要使用数十亿参数的大模型作为骨干网络
- 训练成本高昂:需要在大规模具身数据(如 Open X-Embodiment, DROID)上进行预训练
- GPU 显存消耗大:大模型推理和训练需要大量 VRAM
- 推理效率低:吞吐量(throughput)受限,延迟(latency)高
这引出了 VLA 领域一个关键但鲜有讨论的问题:如何更有效地弥合视觉-语言表征(VL)到动作(A)之间的鸿沟?
解决方案概述
VLA-Adapter 的核心创新在于:
-
系统性条件分析:首次系统分析了不同 VL 条件对动作生成的影响,发现:
- ActionQuery 特征优于 Raw 特征
- 中间层 Raw 特征在某些困难任务中仍然重要
- 结合使用所有层的 Raw 和 ActionQuery 可获得最佳性能
-
轻量级 Bridge Attention:提出了一种自主将最优条件注入动作空间的注意力机制,包含:
- 两个交叉注意力:分别处理 Raw 特征和 ActionQuery 特征
- 一个自注意力:处理动作潜变量自身
- 可学习的注入程度参数(tanh(g))控制 Raw 特征的注入
-
极低资源需求:仅使用 0.5B 参数的骨干网络,无需机器人数据预训练,可在单块消费级 GPU 上 8 小时内完成训练。
三、技术架构
整体框架图
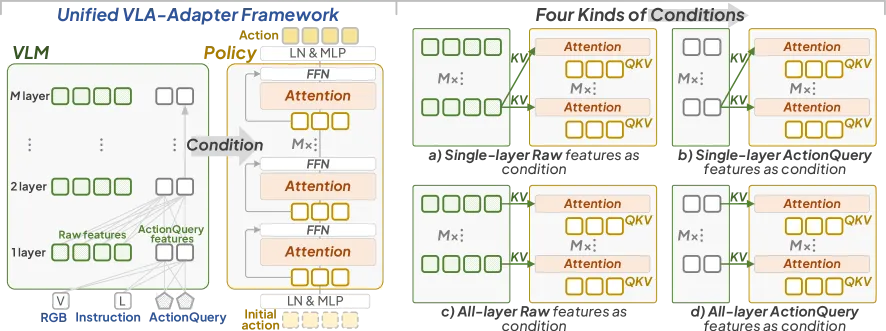
Figure 3: VLA-Adapter 整体框架。 关键组件是有效的条件探索和注意力设计。“Attention” 具体包括与条件的交叉注意力和与自身的自注意力。在”统一 VLA-Adapter 框架”中,“Attention” 即 Bridge Attention。
框架组成
VLA-Adapter 采用 Prismatic-VLMs 架构,包含 M 层。在时间步 t,输入包括:
- 第三视角图像
- 夹爪图像
- 语言指令
- 额外的 ActionQuery
视觉嵌入由 DINOv2 和 SigLIP 提取。输出为指定层的 Raw 潜变量 和 ActionQuery 潜变量 ,它们作为 Policy 的条件。
骨干网络选择
| 骨干网络 | 参数量 | 预训练数据 | 说明 |
|---|---|---|---|
| Prismatic VLM (Qwen2.5-0.5B) | 0.5B | 无机器人数据 | 默认骨干,效率最优 |
| Prismatic VLM (LLaMA2-7B) | 7B | 无机器人数据 | 大规模对比 |
| OpenVLA-7B | 7B | 机器人数据预训练 | 对比实验 |
实验表明,增加骨干规模带来的收益在 VLA-Adapter 中有限(见 Table 2),因此默认使用 Qwen2.5-0.5B 以确保效率。
核心公式
条件定义
在时间步 t,VLM 的输出条件包括:
- Raw 特征 :直接从 VLM 各层提取的视觉和语言表征
- ActionQuery 特征 :通过额外查询 token 作为接口聚合的多模态信息
Bridge Attention 公式 (Equation 1)
其中:
- :第一个交叉注意力,处理 Raw 特征
- :第二个交叉注意力,处理 ActionQuery 特征 和本体感知嵌入
- :自注意力,处理动作潜变量自身
- :可学习参数,控制 Raw 特征的注入程度
- :MLP 投影层
- :本体感知状态的两层 MLP 映射
训练目标 (Equation 2)
训练采用端到端方式,Policy 从零开始训练。使用 L1 损失函数。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| VLM 骨干 | Prismatic VLM (Qwen2.5-0.5B) | 24 层, 0.5B 参数 |
| ActionQuery | 可学习查询 token,聚合多模态信息 | 64 个 token |
| Policy (L1-based) | 带 Bridge Attention 的轻量策略网络 | 97.3M 参数 |
| Bridge Attention | 双交叉注意力 + 自注意力 | 隐藏维度 896, 8 头 |
| Action Chunk | 预测的动作序列长度 | H=8 步 |
| LoRA | VLM 微调方案 | 学习率 1e-4 |
总可训练参数:VLA-Adapter 共 197.2M(Policy 97.3M + LoRA 适配器等)
训练流程
| 设置 | 值 |
|---|---|
| 优化器 | AdamW |
| 微调方案 | LoRA |
| 学习率 | 1e-4 |
| 学习率调度 | 余弦退火 + 预热 |
| Batch size | 16 |
| 最大训练步数 | 150,000 |
| 预热步数 | 10% |
| 硬件 | 4x NVIDIA H100 GPUs |
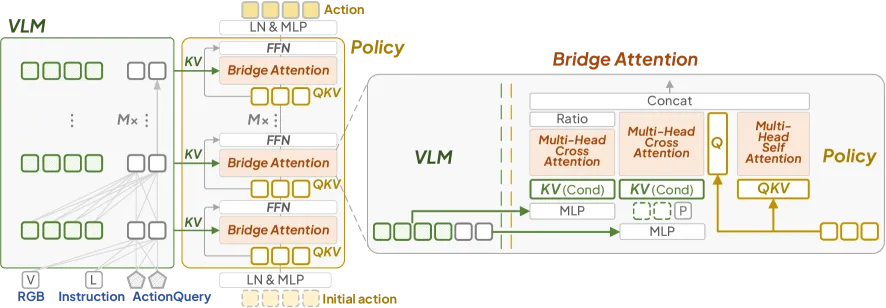
Figure 5: Policy with Bridge Attention 结构。 当骨干为 Qwen2.5-0.5B 时,Policy 参数仅 97M。每层的 和 在 Bridge Attention 中与对应层的动作潜变量融合。
关键条件探索
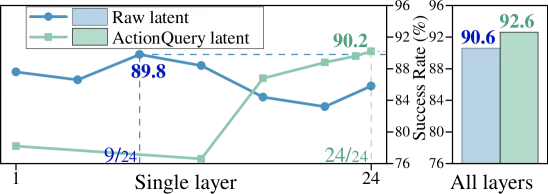
Figure 4: LIBERO-Long 上四种条件的对比。 蓝色和绿色线分别是单层 和单层 。
研究发现:
- Finding 1: ActionQuery 特征 整体优于 Raw 特征
- Finding 2: 中间层 Raw 特征在某些困难任务中表现突出
- Finding 3: 结合所有层的 Raw 和 ActionQuery 获得最优性能(SR=95.0%)
| 条件类型 | 层级 | 来源 | 成功率 |
|---|---|---|---|
| Last Raw | 最后一层 | 85.8% | |
| Last ActionQuery | 最后一层 | 90.2% | |
| Intermediate Raw | 中间层 | 88.4% | |
| All Raw | 所有层 | 90.6% | |
| All ActionQuery | 所有层 | 92.6% | |
| All Raw + All ActionQuery | 所有层 | 两者结合 | 95.0% |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 系统性条件分析 | 首次系统分析 VLA 中不同 VL 条件对动作生成的影响 | Table 1, Figure 4 的消融实验 |
| Bridge Attention | 双交叉注意力 + 自注意力结构,自主注入最优条件 | Equation 1, Table 8 的注入程度消融 |
| 可学习注入程度 | tanh(g) 参数控制 Raw 特征注入,确保训练稳定性 | Table 8: tanh(g)+1 vs 1+1 的对比(95.0% vs 91.4%) |
| 极轻量架构 | 仅 0.5B 骨干 + 97M Policy,无需机器人数据预训练 | Table 2: B1+Ours 达到 95.0%,接近 B3+OFT 的 94.5% |
| 高效推理 | 吞吐量 219.2 Hz,延迟 0.0365 秒 | Table 4: 比 OpenVLA-OFT 快 3 倍 |
| 低资源训练 | 单块消费级 GPU 8 小时完成训练 | 项目页声明 |
五、实验结果
基准测试
LIBERO Benchmark
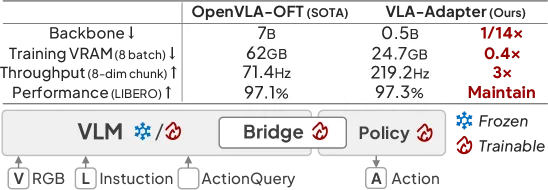
Figure 1: VLA-Adapter 特性对比。 ”↓” 表示越小越好,反之亦然。该范式能有效使用微型骨干获得 SOTA 级 VLA 模型。
| 方法 | 参数量 | Spatial | Object | Goal | Long | Avg. |
|---|---|---|---|---|---|---|
| Large Scale (7-8.5B) | ||||||
| FlowVLA | 8.5B | 93.2 | 95.0 | 91.6 | 72.6 | 88.1 |
| UnifiedVLA | 8.5B | 95.4 | 98.8 | 93.6 | 94.0 | 95.5 |
| OpenVLA | 7B | 84.7 | 88.4 | 79.2 | 53.7 | 76.5 |
| OpenVLA-OFT | 7B | 97.6 | 98.4 | 97.9 | 94.5 | 97.1 |
| UniVLA | 7B | 96.5 | 96.8 | 95.6 | 92.0 | 95.2 |
| Small Scale (2-4B) | ||||||
| pi_0 | 3B | 96.8 | 98.8 | 95.8 | 85.2 | 94.2 |
| pi_0-FAST | 3B | 96.4 | 96.8 | 88.6 | 60.2 | 85.5 |
| SmolVLA | 2.2B | 93.0 | 94.0 | 91.0 | 77.0 | 88.8 |
| GR00T N1 | 2B | 94.4 | 97.6 | 93.0 | 90.6 | 93.9 |
| Tiny Scale (0.5B) | ||||||
| VLA-OS | 0.5B | 87.0 | 96.5 | 92.7 | 66.0 | 85.6 |
| VLA-Adapter (Ours) | 0.5B | 97.8 | 99.2 | 97.2 | 95.0 | 97.3 |
| VLA-Adapter-Pro (Ours) | 0.5B | 99.6* | 99.6* | 98.2* | 96.4* | 98.5* |
关键发现:VLA-Adapter 仅用 0.5B 参数,在 LIBERO 所有子任务上均达到或超过 7B 级别模型的性能,平均成功率 97.3% 甚至超过 OpenVLA-OFT (7B) 的 97.1%。
CALVIN Benchmark (零样本泛化)
| 方法 | 参数量 | 1 | 2 | 3 | 4 | 5 | Avg. len |
|---|---|---|---|---|---|---|---|
| Large Scale | |||||||
| UniVLA | 7B | 95.5 | 85.8 | 75.4 | 66.9 | 56.5 | 3.80 |
| OpenVLA | 7B | 91.3 | 77.8 | 62.0 | 52.1 | 43.5 | 3.27 |
| OpenVLA-OFT | 7B | 96.3 | 89.1 | 82.4 | 75.8 | 66.5 | 4.10 |
| OpenHelix | 7B | 97.1 | 91.4 | 82.8 | 72.6 | 64.1 | 4.08 |
| Small Scale | |||||||
| VPP | 1.5B | 95.7 | 91.2 | 86.3 | 81.0 | 75.0 | 4.33 |
| Tiny Scale | |||||||
| SeerLarge | 0.57B | 96.3 | 91.6 | 86.1 | 80.3 | 74.0 | 4.28 |
| MoDE | 0.44B | 96.2 | 88.9 | 81.1 | 71.8 | 63.5 | 4.01 |
| VLA-Adapter (Ours) | 0.5B | 99.1* | 94.6 | 88.8 | 82.8 | 76.5 | 4.42 |
| VLA-Adapter-Pro (Ours) | 0.5B | 98.5 | 95.0* | 90.5* | 85.3* | 80.0* | 4.50* |
关键发现:VLA-Adapter 在 CALVIN 零样本泛化任务上表现出色,平均长度 4.42 仅次于 VLA-Adapter-Pro 的 4.50,展现出强大的泛化能力。
推理效率
| 指标 | OpenVLA | OpenVLA-OFT (简化) | OpenVLA-OFT | VLA-Adapter |
|---|---|---|---|---|
| 吞吐量 (Hz) ↑ | 4.2 | 109.7 | 71.4 | 219.2 |
| 延迟 (Sec) ↓ | 0.2396 | 0.0729 | 0.1120 | 0.0365 |
关键发现:VLA-Adapter 的吞吐量是 OpenVLA-OFT 的 3 倍,延迟仅为后者的 1/3。
真实世界实验
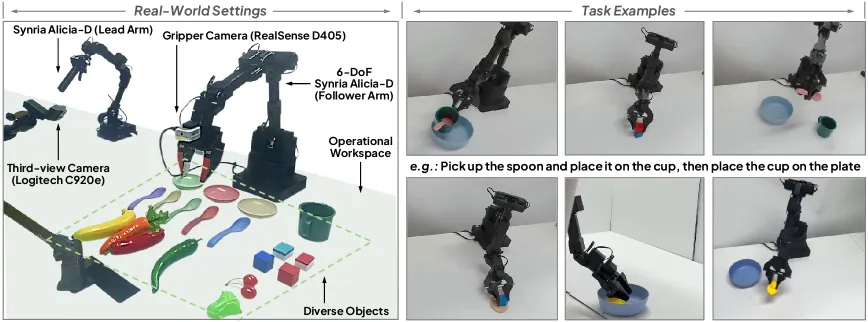
Figure 6: 真实世界系统 Synria Alicia-D 和任务示例。 使用 6-DOF Synria Alicia-D 机械臂,配备 1-DOF 夹爪,Logitech C920e 和 RealSense D405 相机。
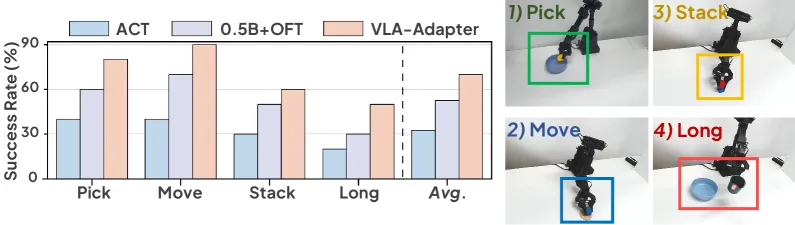
Figure 7: 真实世界任务对比。 每个结果取 10 次执行的平均值。
评估类别包括:
- 简单抓取放置任务(多种材质和几何形状物体)
- CALVIN 风格挑战任务:横向物体移动
- CALVIN 风格挑战操作:积木堆叠
- LIBERO 风格复杂长序列任务(如”拿起勺子放在杯子上,再把杯子放在盘子上”)
消融实验
ActionQuery 数量
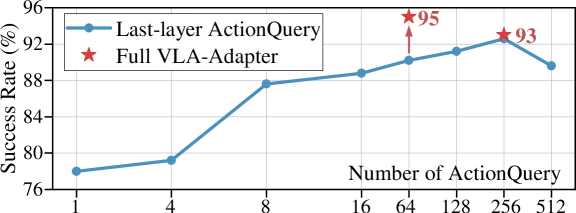
Figure 8: 不同 ActionQuery 数量的对比。 蓝线表示仅使用最后一层 ActionQuery 的结果,红星表示完整 VLA-Adapter 的结果。
测试数量:1, 4, 8, 16, 64, 128, 256, 512
- 过少的 ActionQuery token 会削弱多模态聚合能力
- 过多的 ActionQuery token 会引入冗余,干扰性能
- 最优选择:64 个 ActionQuery token,在性能和效率之间取得最佳平衡
注入程度消融
| Raw 注入 | ActionQuery 注入 | 成功率 |
|---|---|---|
| tanh(g) (可学习) | 1 (完全注入) | 95.0% |
| 1 (完全注入) | 1 (完全注入) | 91.4% |
| 1 (完全注入) | tanh(g) (可学习) | 89.2% |
| tanh(g) (可学习) | tanh(g) (可学习) | 92.0% |
关键结论:
- 性能不如 ,因此应通过学习注入有效信息
- 聚合了多模态信息,有利于动作生成,应完全注入
- Bridge Attention 的设计是有效的
六、核心架构对比
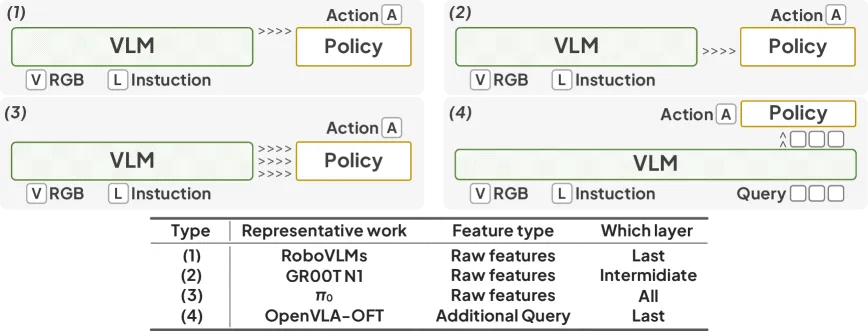
Figure 2: 现有的代表性 VL 到 A 桥接范式。
VLA-Adapter 与现有范式的关键区别:
| 特性 | OpenVLA-OFT | pi_0 | GR00T N1 | VLA-Adapter |
|---|---|---|---|---|
| 条件类型 | Last ActionQuery | All Raw | Intermediate Raw | All Raw + All ActionQuery |
| 骨干规模 | 7B | 3B | 2B | 0.5B |
| 机器人数据预训练 | 是 | 是 | 是 | 否 |
| 吞吐量 | 71.4 Hz | - | - | 219.2 Hz |
| LIBERO Avg. | 97.1 | 94.2 | 93.9 | 97.3 |
七、相关工作
VLA 模型
- 大型 VLA:OpenVLA, pi_0, UniVLA, FlowVLA 等,通常需要 7B+ 参数和大规模机器人数据预训练
- 双系统架构:RoboDual, OpenHelix 等,引入中间潜 token 连接 VLM 和 Policy
- 高效 VLA:SmolVLA, Seer 等,探索更轻量的架构
桥接范式
- 离散动作 token 化:早期方法(RT-2, Octo),将动作离散化为 token,但引入信息损失
- 连续动作空间:近期方法转向连续表示
- Raw 特征直接使用:从 VLM 各层提取特征直接用于 Policy
- 额外查询作为接口:引入 ActionQuery 等可学习 token 作为桥接接口
关键区别
VLA-Adapter 的独特之处在于:
- 首次系统性分析不同条件的效果
- 结合 Raw 和 ActionQuery 两种条件
- 使用可学习的注入程度控制
- 在极小规模下实现 SOTA 性能
八、总结
核心贡献
- 首次系统性分析:对 VLA 中桥接范式的效果进行了系统性研究,给出了关键设计发现
- Bridge Attention 机制:提出了一种能自主将最优条件注入动作空间的注意力架构
- SOTA 级性能:仅用 0.5B 参数骨干,在 LIBERO(97.3%)、CALVIN(4.42 avg.len)等基准上达到 SOTA 水平
- 极高推理效率:219.2 Hz 吞吐量,0.0365 秒延迟
- 低资源部署:单块消费级 GPU 8 小时即可训练完成
技术影响
- 降低 VLA 部署门槛:使得在资源受限环境下部署强大的 VLA 模型成为可能
- 启发未来研究:条件分析方法和 Bridge Attention 设计为 VLA 架构设计提供了新思路
- 推动轻量化趋势:证明了小型模型通过正确的桥接策略可以匹配甚至超越大型模型
局限性
- 泛化能力有限:由于未在大规模具身数据上预训练且规模较小,真实世界泛化能力有待提升
- 条件质量依赖:Policy 网络生成的动作质量取决于 VLM 提供的条件及其使用方式
- 训练过程简单:基础训练过程相对简单,尚未探索强化学习等复杂训练方法
未来方向
- 在更大规模具身数据上预训练以提升泛化能力
- 进一步探索条件的表征和高效使用
- 引入强化学习等复杂训练策略
- 探索更先进的 Policy 架构(如 DiT-based Policy,见 Appendix B)
九、参考资源
关键参考文献
| 简称 | 全称 | 出处 |
|---|---|---|
| OpenVLA | Open-source Vision-Language-Action model | CoRL 2024 |
| OpenVLA-OFT | OpenVLA with Optimized Fine-Tuning | RSS 2025 |
| pi_0 | Physical Intelligence pi-zero | RSS 2025 |
| GR00T N1 | NVIDIA GR00T N1 Foundation Model | ArXiv 2025 |
| SmolVLA | Small Vision-Language-Action model | ArXiv 2025 |
| LIBERO | LIBERO benchmark suite | 2023 |
| CALVIN | CALVIN ABC->D benchmark | 2022 |
| Prismatic-VLMs | Prismatic Vision-Language Models | 2024 |
| DINOv2 | Self-supervised Vision Transformer | 2024 |
| SigLIP | Sigmoid Loss for Language-Image Pre-training | 2023 |
分析日期:2026-05-29 论文版本:arXiv:2509.09372v2 分析工具:paper-analyzer skill