LimiX: Unleashing Structured-Data Modeling Capability for Generalist Intelligence
首个统一的大规模结构化数据模型(LDM),通过上下文条件掩码建模实现分类、回归、缺失值填补、数据生成等多任务的单模型泛化
LimiX: Unleashing Structured-Data Modeling Capability for Generalist Intelligence
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LimiX: Unleashing Structured-Data Modeling Capability for Generalist Intelligence |
| 作者 | LimiX Team(Stable AI & Tsinghua University) |
| 论文 | arXiv:2509.03505 |
| 代码/模型 | github.com/limix-ldm/LimiX |
| 发布 | 2025-09-03 (v1), 2025-11-07 (v2, 最终版) |
| 许可 | Apache 2.0 |
| 页数 | 61页 |
| 领域 | Machine Learning (cs.LG); AI (cs.AI); Computation and Language (cs.CL) |
二、核心思想
问题定义
表格数据(structured data)是金融、医疗、物流、公共政策等关键领域的决策基石。然而,传统实践依赖于为每个数据集和任务单独训练的专用模型管道(XGBoost、LightGBM、CatBoost、AutoGluon等),存在以下根本性局限:
- 每数据集重训练:每个新数据集都需要完整的重新训练,延长部署周期
- 知识无法跨域复用:模型间无法共享学到的统计规律
- 任务割裂:分类、回归、缺失值填补、数据生成需要不同的模型架构和训练目标
- 语言模型不适用:将表格转为自由文本会丢弃度量几何、物理单位和缺失模式等关键信息
核心洞察
通向通用智能的进步需要三个互补空间:语言、物理世界和结构化数据。结构化数据不是由语言模型或具身智能所涵盖的独立模态。
LimiX的核心哲学:将结构化数据视为变量和缺失性的联合分布,通过查询式条件预测(query-based conditional prediction)用单一模型解决广泛的表格任务。
解决方案概述
LimiX是一个大型结构化数据模型(Large Structured-Data Model, LDM)系列,发布两个实例:
- LimiX-16M(1600万参数):全面能力,在多任务上持续超越强基线
- LimiX-2M(200万参数):资源受限场景下仍保持竞争力
核心方法:
- 上下文条件掩码建模(CCMM):预训练时采用episode式设定,上下文子集建立数据集先验,查询子集进行预测
- 分层SCM数据生成:使用结构因果模型生成多样化预训练数据
- 注意力引导检索集成:推理时利用自身注意力分数检索相关信息样本
三、技术架构
整体模型结构
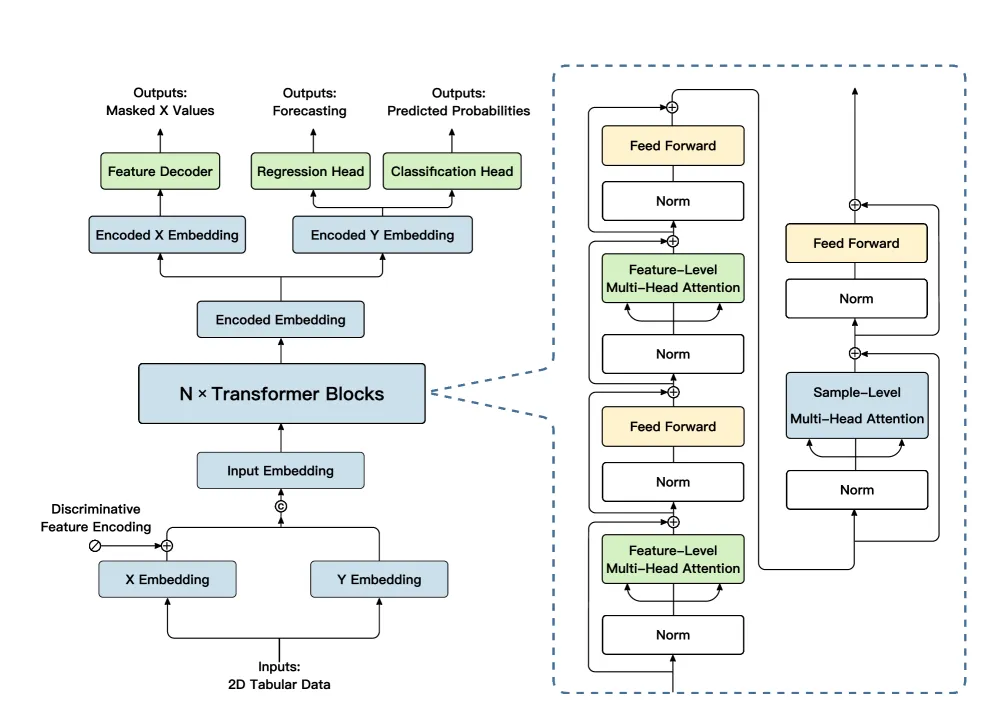
LimiX采用轻量级Transformer架构,包含12个Transformer块,每个块沿**特征轴(列)和样本轴(行)**执行双向自注意力:
输入: 2D表格数据 X ∈ R^(m×d), 输出 Y ∈ R^m
        ↓
    嵌入层 (MLP + LayerNorm)
        ↓
    ┌─────────────────────────┐
    │   12 Transformer Blocks  │
    │  ┌───────────────────┐   │
    │  │ Feature-Level     │   │
    │  │ Multi-Head Attn   │   │  ← 2 passes (more than sample)
    │  │ + FFN             │   │
    │  ├───────────────────┤   │
    │  │ Sample-Level      │   │
    │  │ Multi-Head Attn   │   │  ← 1 pass
    │  │ + FFN             │   │
    │  └───────────────────┘   │
    └─────────────────────────┘
        ↓
任务头 (分类/回归/生成)不对称配置:每个块执行2次特征级pass + 1次样本级pass。消融研究表明,等数量会低估特征交互,增加特征轴注意力增强了异构schema的建模能力且开销可忽略。
核心创新组件
1. 判别性特征编码(Discriminative Feature Encoding, DFE)
标准注意力分数仅依赖于单元格值的嵌入交互,无法可靠推断单元格的列来源。DFE引入可学习的低秩列标识符:
给定: 嵌入维度p, 列标识符秩s ≪ p
初始化: U ∈ R^(d×s),第j行u_j ≈ 正交归一化
提升: E ∈ R^(s×p), e_j = u_j E ∈ R^p
增强: x̃_i,j = x_i,j + e_j  (类似绝对位置编码,沿特征轴)
设计哲学:
- (i) 不同特征的编码充分分离以保证判别性
- (ii) 嵌入空间中的编码具有低有效秩,以紧凑表达列身份并跨特征共享统计强度
实践中设 s = p/4。
2. 上下文条件掩码建模(CCMM)
传统BERT式掩码建模:  隐式学习,适应体现在参数中
LimiX CCMM:          显式上下文记忆,适应体现在推理时的条件查询中
对于每个数据集,episode将行分为上下文子集(context)和查询子集(query):
- 上下文子集:建立数据集特定的先验(类别频率、边际尺度、跨特征耦合)
- 查询子集:预测掩码条目
这使得单参数模型服务于所有schema和任务,推理时无需梯度更新即可实现每数据集校准。
3. 掩码模式设计
采用异构调度,交替使用三种掩码:
| 掩码类型 | 目的 | 效果 |
|---|---|---|
| Cell-wise | 局部条件预测 | 细化个体单元格预测 |
| Column-wise | 整列缺失推理 | 从剩余属性推断整个特征 |
| Block | 高阶依赖建模 | 语义相关组的联合预测(如人口统计+结果) |
掩码率按变量类型、流行度和离散度分层采样,范围 [0.1, 0.4]。排除几乎移除所有信息上下文的退化模式。
4. 掩码嵌入
- 可学习的掩码向量标记待预测位置
- 与列嵌入结合,使编码器能条件于”哪里缺失”以及”缺失什么”
- 通过掩码密度特征(masked cells的比例)校准预训练-推理不匹配
5. 分层SCM数据生成
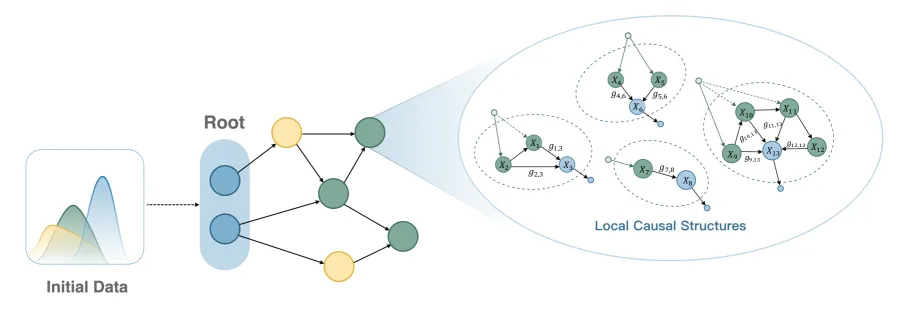
预训练数据通过分层结构因果模型(SCMs)生成,包含三个阶段:
阶段1:DAG生成
- 从根节点开始,数据沿有向边传播
- 每个节点代表一个局部因果结构(LCS)
- 边函数类型:MLP(非线性)、卷积(样本维度局部混合)、决策树(规则映射)
- 聚合函数:简单平均、加权平均、MLP聚合
- 噪声幅度按特征分布缩放
阶段2:数据采样
- 图感知采样:考虑采样数据的图形分布,约束采样空间
- 可解性感知采样:生成高/中/低可解性问题,鼓励泛化
阶段3:任务适配
- 分类:将连续目标离散化
- 回归:对聚类紧密的离散变量进行有序变换
推理时检索集成
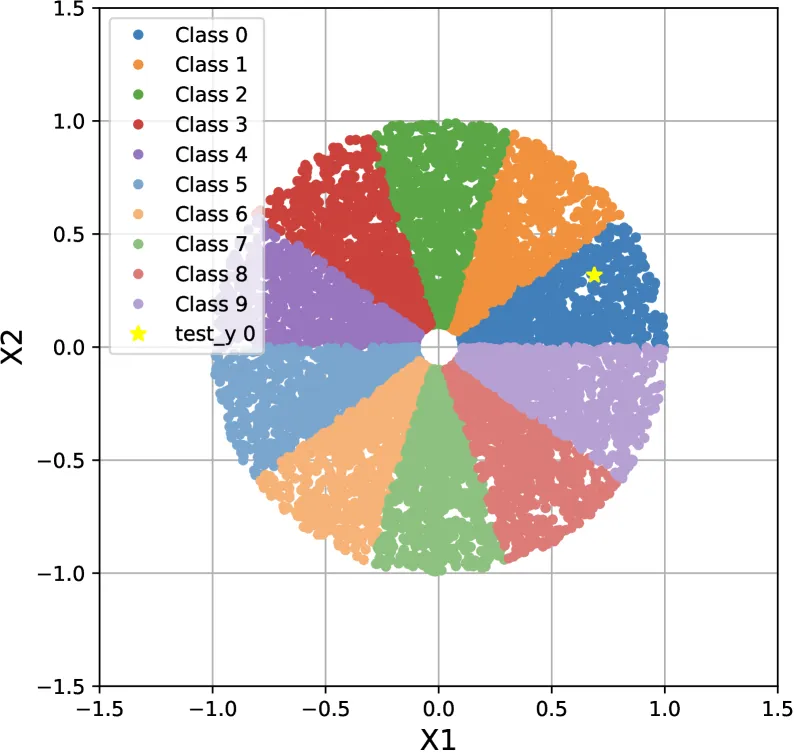
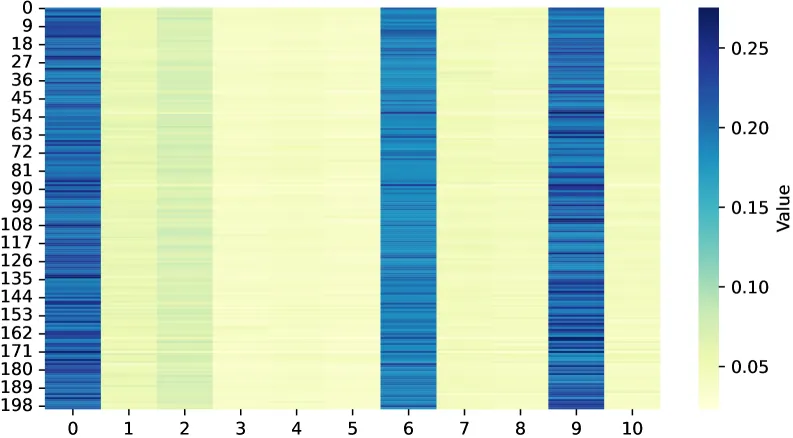
LimiX利用自身注意力分数进行推理时检索,无需额外训练:
Ensemble:每个数据集运行多个推理pipeline(分类4个,回归8个),每个pipeline随机打乱特征列并对子集进行变换(分位数归一化、log变换、SVD分量)。
Retrieval:每个pipeline执行两次前向传播:
- 第一次:基于所有上下文样本 → 计算注意力分数
- 第二次:基于检索到的定制上下文样本 → 预测
重加权公式:a_s^f = a_s · a_f,其中 a_f 是特征级注意力分数(作为特征权重),a_s 是样本级交叉注意力分数。
四、核心创新
| 创新点 | 说明 | 价值 |
|---|---|---|
| 联合分布建模 | 将表格视为变量和缺失性的联合分布 | 单一模型解决分类、回归、填补、生成 |
| CCMM预训练 | 上下文条件掩码建模,episode式设定 | 推理时无需微调即可每数据集校准 |
| 判别性特征编码 | 低秩列标识符,增强特征判别性 | 显式列感知而不增加参数量 |
| 分层SCM数据生成 | DAG+LCS+图感知/可解性采样 | 可控、可解释的多样化合成数据 |
| 注意力引导检索 | 利用自身注意力分数检索上下文 | 推理时免费的性能提升 |
| 首个LDM缩放定律 | 系统性研究数据/参数缩放与性能关系 | 为表格基础建模提供定量指导 |
| 理论保证 | CCMM与联合条件分布的一一对应证明 | 随机掩码数量的理论依据 |
五、理论分析
上下文条件掩码建模的理论基础
命题6.1(非正式):对于任意 k ∈ [d],分布 p(X^te | X^ct) 与条件族 { p(X^te_π | X^te_{-π}, X^ct) : ∀ π ∈ Π_k } 之间存在一一对应关系。
这意味着:如果模型能良好近似所有掩码模式下的条件分布,就能恢复联合条件分布并有效泛化。反之,仅学习部分掩码模式不足以泛化(例B.1)。
定理6.2(样本效率):更大的 k(掩码数量)产生更低的估计不确定性:
√n (θ̂_{k,n} - θ*) → N(0, Γ_k)
其中 Γ_{k+1} ⪯ Γ_k
等价地,k越大,达到相同不确定性所需的样本越少。
定理6.3(泛化界):估计条件联合分布与真实分布之间的总变差上界随掩码数量单调递减:
DTV(q_θ || p) ≤ √(C_k(q_θ) L̂_k(θ)/2) + ...
其中 C_{k+1}(q_θ) ≤ C_k(q_θ)
因果结构建模
通过SCM分解:
p(X^te | X^ct) = ∫_S p(S|X^ct) p(X^te|S) dS其中S是对应SCM的随机变量。高效学习 p(X^te|X^ct) 需要两个组件: (i) p(S|X^ct):给定上下文下SCM的后验分布 (ii) p(X^te|S):给定SCM下测试样本的似然
六、实验结果
评估设置
11个大表格基准,覆盖广泛的 regime:
| 基准 | 任务 | 数据集数 | 特点 |
|---|---|---|---|
| BCCO-CLS | 分类 | 106 | 全新基准,~1/3含缺失值,多维度均衡分箱 |
| BCCO-REG | 回归 | 50 | 同上,回归版本 |
| OpenML-CC18 | 分类 | 62 | 经典基准 |
| TALENT-CLS/REG | 分类/回归 | 179/99 | 大规模基准 |
| TabArena-CLS/REG | 分类/回归 | 33/13 | 竞赛风格基准 |
| PFN-CLS/REG | 分类/回归 | 29/28 | 小样本基准 |
| TabZilla | 分类 | 27 | 多样化基准 |
基线模型:
- 树模型:XGBoost, LightGBM, CatBoost, RF, ET, AutoGluon
- 神经网络:SNN, AutoInt, NODE, TabTransformer, GrowNet, TabNet, DCN-v2, FT-Transformer, MLP, ResNet, SAINT, MLP-PLR, DANets, TANGOS, T2G-Former, ExcelFormer, Trompt, TabR, TabCaps, RealMLP, SwitchTab, ModernNCA
- ICL模型:TabPFN-v2, TabICL, Mitra
分类性能
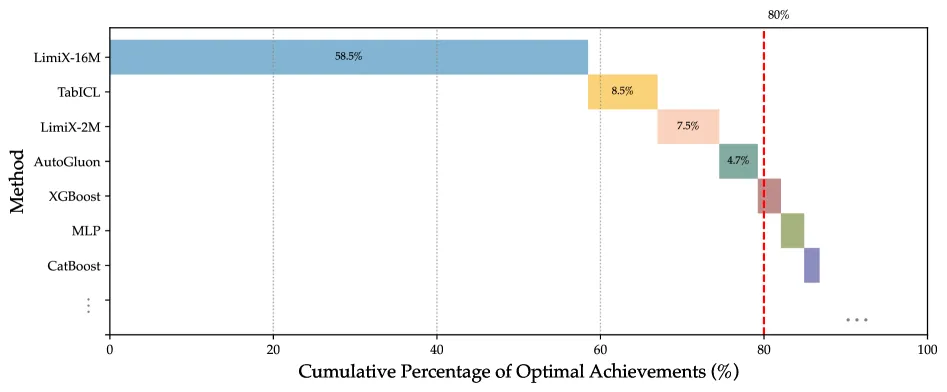
BCCO-CLS(Table 1):
| 模型 | AUC ↑ | Acc ↑ | F1 ↑ | AUC Rank ↓ | Acc Rank ↓ | F1 Rank ↓ |
|---|---|---|---|---|---|---|
| LimiX-16M | 0.871 | 0.804 | 0.731 | 2.64 | 2.25 | 2.89 |
| LimiX-2M | 0.858 | 0.787 | 0.701 | 6.17 | 6.48 | 8.54 |
| TabICL | 0.847 | 0.768 | 0.672 | 7.26 | 8.73 | 10.78 |
| AutoGluon | 0.846 | 0.771 | 0.677 | 8.50 | 8.50 | 9.93 |
| TabPFN-v2 | 0.843 | 0.772 | 0.679 | 9.21 | 9.82 | 11.40 |
| XGBoost | 0.834 | 0.762 | 0.674 | 10.66 | 10.85 | 11.55 |
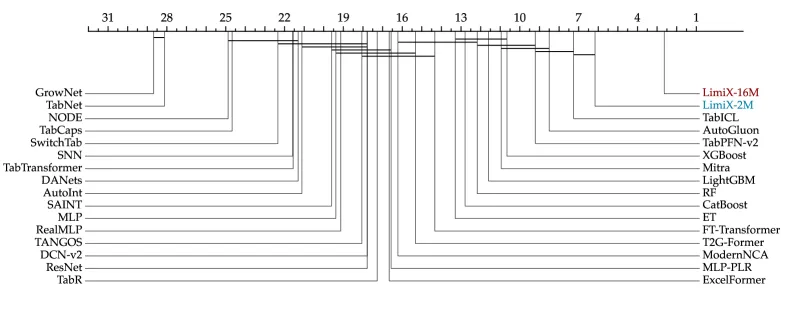
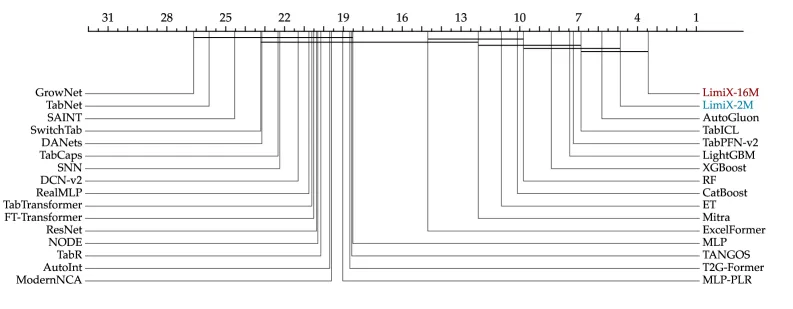
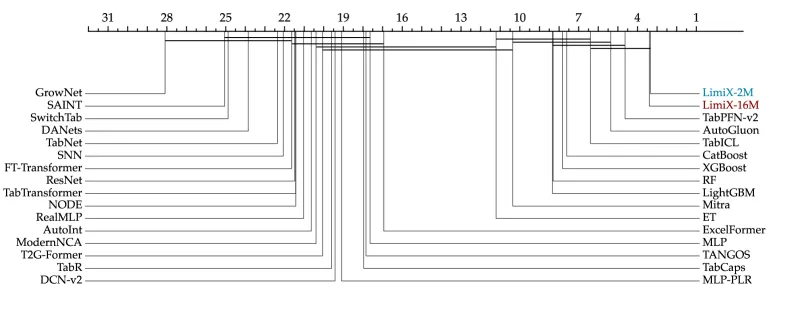
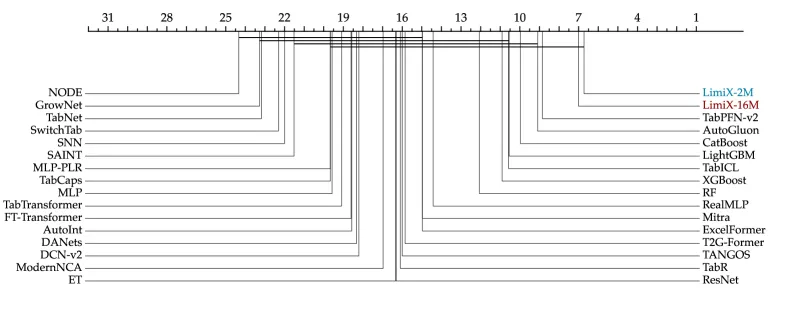
LimiX-16M在所有基准上AUC、Accuracy、F1均排名第一,排名均值仅2.64(越低越好)。
关键发现:LimiX-16M是唯一在几乎所有子群体中持续超越AutoGluon的ICL模型,特别是在大训练样本和高类别基数场景下。
回归性能
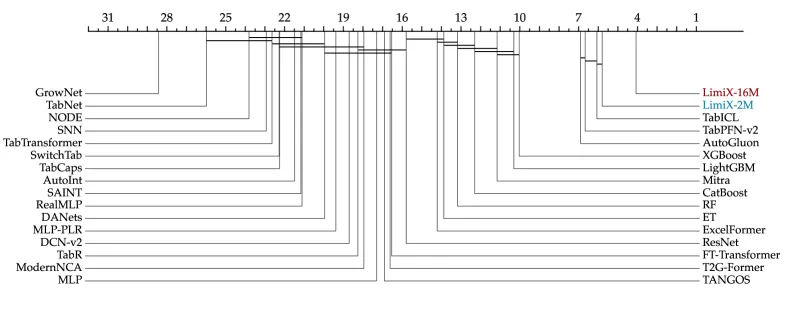
BCCO-REG(Table 13):
| 模型 | NRMSE ↓ | R² ↑ |
|---|---|---|
| LimiX-16M | 最优 | 最优 |
| LimiX-2M | 接近AutoGluon | 接近AutoGluon |
| TabPFN-v2 | 强竞争者 | 强竞争者 |
| AutoGluon | 强竞争者 | 强竞争者 |
LimiX-2M在计算资源受限情况下仍与AutoGluon和TabPFN-v2相当。
缺失值填补
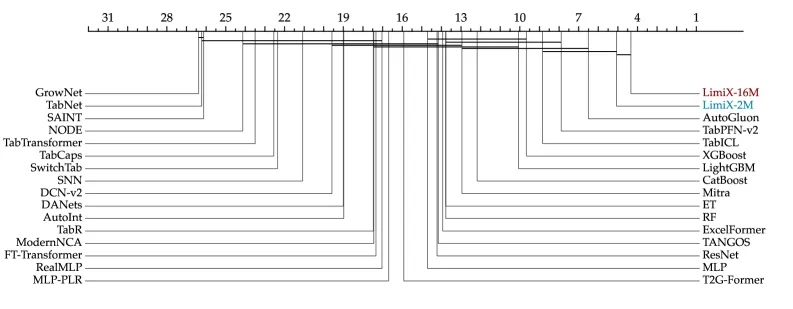
LimiX-16M在MNAR(非随机缺失)设置下表现尤其出色,证明了CCMM预训练中对缺失模式的显式建模的有效性。
鲁棒性
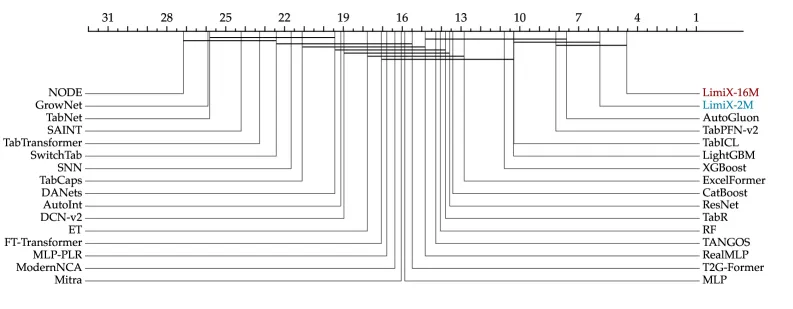
随着缺失比例增加,大多数基线性能急剧下降,而LimiX-16M仅出现适度退化,保持相对稳定。
嵌入质量
LimiX的样本和特征嵌入在t-SNE可视化中显示出清晰的类别分离和因果结构捕获能力。
微调性能
即使在少量数据上进行微调,LimiX也能持续提升性能,展示了良好的可塑性。
数据生成质量
通过迭代掩码和填充,LimiX能生成与真实数据分布一致的合成样本。
分布外泛化(OOD)
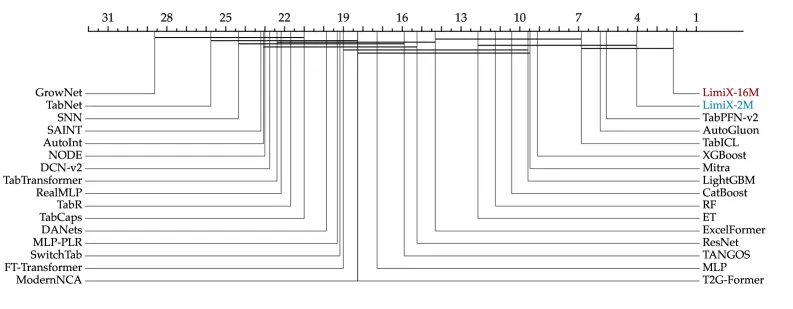
LimiX在分布外数据集上展现出显著的泛化优势,得益于CCMM对因果结构的显式建模。
缩放定律(Scaling Law)
损失vs数据集大小(Figure 26):
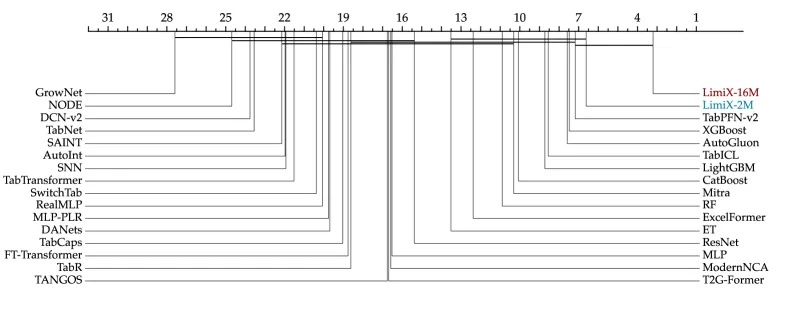
- 分类(BCCO-CLS)和回归(BCCO-REG)均呈现一致的幂律关系
- R² > 0.99,确认缩放定律的稳健性
- 数据量从 ~10¹¹ 增加到 ~10¹³ token,损失系统下降
- 较小模型初始下降更陡峭,较大模型达到更低的整体损失水平
损失和性能vs模型参数(Figure 27):
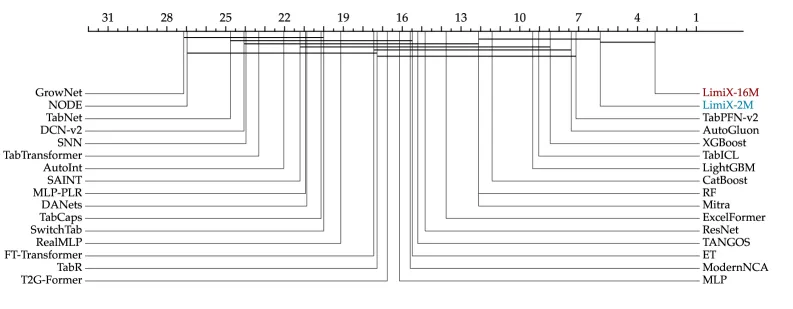
拟合结果(R² > 0.9):
Log-Loss = -132.43 + 133.12·N^(-0.000)    (R² = 0.9646)
AUC = 1.30 - 0.56·N^(-0.014)              (R² = 0.9044)
ACC = 0.91 - 0.31·N^(-0.058)              (R² = 0.9933)
RMSE-Loss = -30.63 + 31.13·N^(-0.000)     (R² = 0.9890)
R² = 26.33 - 25.65·N^(-0.000)             (R² = 0.9890)
关键洞察:
- 损失随N增加急剧下降,而AUC、ACC和F1逐渐改善
- 误差收敛相对较早实现,而细粒度判别能力需要更大的模型
- 缩放行为遵循可预测的幂律趋势,类似于LLM中的观察
七、与相关工作的比较
| 工作 | 方法 | 任务范围 | 推理时适配 | 数据生成 |
|---|---|---|---|---|
| TabPFN-v2 | 贝叶斯神经网络ICL | 分类为主 | ✓ (ICL) | ✗ |
| TabICL | Transformer ICL | 分类/回归 | ✓ (ICL) | ✗ |
| Mitra | 深度ICL | 分类 | ✓ (ICL) | ✗ |
| LimiX | 掩码联合分布建模 | 分类+回归+填补+生成 | ✓ (检索) | ✓ |
LimiX的独特之处:
- 任务统一:单一模型接口支持五种任务
- 因果结构显式建模:通过SCM数据生成和DFE编码
- 检索集成:推理时可选的免费性能提升
- 理论保证:CCMM与联合条件分布的一一对应
- 缩放定律:首个系统性的LDM缩放研究
八、总结
核心贡献
- LimiX模型系列:发布LimiX-16M和LimiX-2M,首个真正统一的表格基础模型
- CCMM预训练:上下文条件掩码建模,实现推理时无需微调的每数据集适配
- 分层SCM数据生成:可控、可解释的合成数据管道
- 11个基准的全面评估:跨越分类、回归、填补、生成、OOD泛化等广泛任务
- 首个LDM缩放定律:揭示数据/参数缩放与性能的幂律关系
- 理论分析:CCMM与联合条件分布的一一对应,掩码数量的理论依据
- 开源:Apache 2.0许可,模型和代码完全开放
技术影响
- 为结构化数据建立了与LLM和视觉基础模型相媲美的基础模型范式
- 证明了表格数据作为独立智能空间的价值,不应被语言或视觉模型所涵盖
- 缩放定律为未来LDM设计提供了定量指导
局限性
- 参数规模较小:当前最大16M参数,相比LLM的百亿/万亿参数仍有巨大差距
- 数据生成依赖SCM:合成数据可能与真实数据的复杂依赖存在差距
- 检索集成增加推理延迟:虽然无需训练,但多次前向传播增加计算成本
- 超大数据集未覆盖:评估排除了>50K训练样本的数据集,大规模场景仍需验证
- 特征维度限制:排除了>10K特征的数据集,超高维场景的表现未知
九、参考资源
- 论文:https://arxiv.org/abs/2509.03505
- 代码:https://github.com/limix-ldm/LimiX/
- 模型:https://huggingface.co/stableai-org/
- ModelScope:https://modelscope.cn/organization/stable-ai/
- 许可证:Apache 2.0
- BCCO基准:https://huggingface.co/datasets/stableai-org/bcco_cls, https://huggingface.co/datasets/stableai-org/bcco_reg
- 相关基础模型:TabPFN-v2, TabICL, Mitra, TabDPT