The Landscape of Agentic Reinforcement Learning for LLMs: A Survey
LLM 智能体强化学习综述:从被动序列生成器到自主决策智能体
The Landscape of Agentic Reinforcement Learning for LLMs: A Survey
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | The Landscape of Agentic Reinforcement Learning for LLMs: A Survey |
| 作者 | Guibin Zhang, Hejia Geng, Xiaohang Yu, Zhenfei Yin, Zaibin Zhang, Zelin Tan, Heng Zhou, Zhongzhi Li, Xiangyuan Xue, Yijiang Li, Yifan Zhou, Yang Chen, Chen Zhang, Yutao Fan, Zihu Wang, Songtao Huang, Francisco Piedrahita-Velez, Yue Liao, Hongru Wang, Mengyue Yang, Heng Ji, Jun Wang, Shuicheng Yan, Philip Torr, Lei Bai |
| 机构 | NUS, Imperial College Oxford, 上海 AI Lab, 清华大学, 牛津大学, 多所国际高校 |
| 论文 | arXiv:2509.02547 |
| 发布 | 2025年9月 |
| 领域 | 人工智能 (cs.AI), 计算语言学 (cs.CL) |
| 规模 | 综述超过 500 篇近期工作 |
二、核心思想
范式转变:从 LLM-RL 到 Agentic RL
本综述的核心论点是:Agentic RL 标志着从传统 LLM-RL 的范式转变——将 LLM 从被动的序列生成器重新定义为嵌入复杂动态世界中的自主决策智能体。
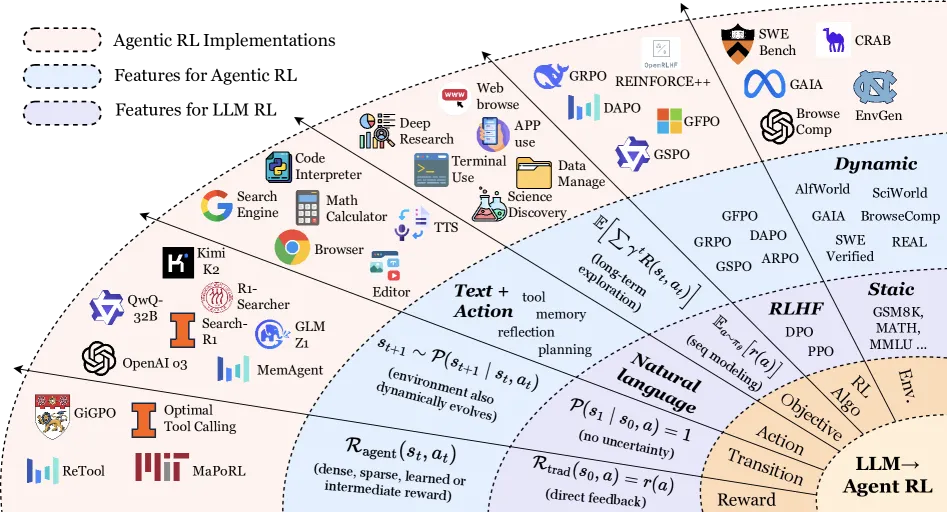
问题定义
传统 LLM-RL(如 PBRFT)将 RL 训练建模为退化的单步 MDP:
- 状态空间:仅包含单个 prompt
- 动作空间:纯文本序列
- 转移:确定性终止
- 奖励:单个标量
- 视界:
Agentic RL 则建模为时序扩展的 POMDP:
- 状态空间:,智能体获得观测
- 动作空间:
- 转移:动态转移函数
- 奖励:步级奖励 ,结合稀疏任务和密集过程奖励
- 目标:
形式化对比
| 概念 | 传统 PBRFT | Agentic RL |
|---|---|---|
| 状态空间 | (单个 prompt);立即终止 | ; |
| 动作空间 | 纯文本序列 | |
| 转移 | 确定性终止 | 动态转移 $P(s_{t+1} |
| 奖励 | 单标量 | 步级 ;稀疏+密集 |
| 目标 |
三、技术架构
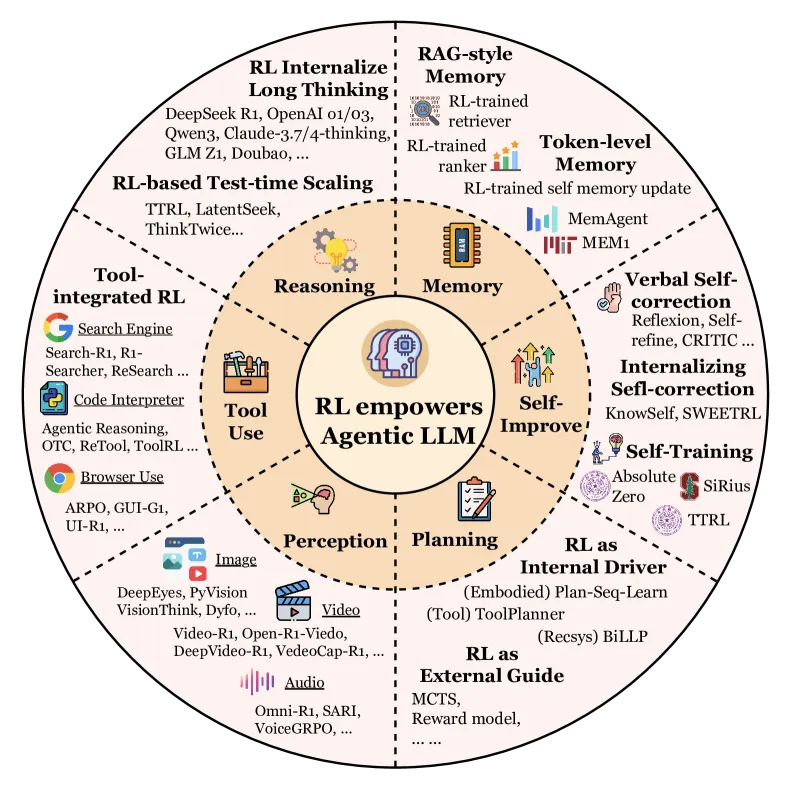
整体分类框架
本综述提出双重分类法:
- 能力视角(Section 3):规划、工具使用、记忆、自我改进、推理、感知
- 任务视角(Section 4):搜索、代码、数学、GUI、视觉、具身、多智能体
核心公式
REINFORCE
其中 是第 个采样响应, 是任务完成后的最终奖励。
PPO (Proximal Policy Optimization)
其中 ,。
关键缺点:依赖单独的 critic 网络进行优势估计,大幅增加训练参数量。
DPO (Direct Preference Optimization)
其中 是参考策略, 是超参数。关键缺点:性能受限于静态偏好数据集的质量和覆盖范围。
GRPO (Group Relative Policy Optimization)
优势函数通过组内相对奖励估计:
关键优势:消除绝对值 critic,高度样本高效,计算开销低。
RL 算法族谱
| 方法族 | 代表方法 | 核心机制 |
|---|---|---|
| PPO 家族 | PPO, VAPO, PF-PPO, VinePPO, PSGPO | 策略梯度 + 剪切 + 可选 KL 惩罚 |
| DPO 家族 | DPO, β-DPO, SimPO, IPO, KTO, ORPO, Step-DPO, LCPO | 偏好优化,无需显式奖励模型 |
| GRPO 家族 | GRPO, DAPO, GSPO | 组相对奖励,消除 critic |
动作空间设计
Agentic RL 的动作空间包含两个不相交的子空间:
- :通过自回归解码生成自由形式的自然语言 token
- :由特殊 token
<action_start>和<action_end>界定的结构化非语言动作(如工具调用、环境交互)
四、能力视角:六大核心能力
1. 规划 (Planning)
两大范式:
- 外部引导:RL 作为搜索过程的外部引导,训练辅助奖励/启发式函数(如奖励模型引导 MCTS)
- 内部驱动:RL 直接优化 LLM 的规划行为,通过环境交互的试错反馈内化到模型参数
未来方向:综合两种范式,将结构化搜索过程本身内化到智能体中。
2. 工具使用 (Tool Use)
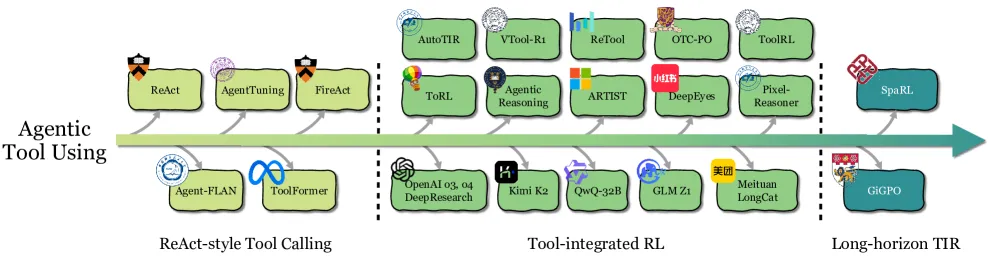
演进路径:
- 提示工程:ReAct 风格的 Thought-Action-Observation 循环
- SFT 模仿:在工具调用轨迹上微调
- RL 优化:从模仿固定模式转向优化最终任务性能
- 工具集成推理 (TIR):深度交织的多轮推理系统
当前状态:工具集成 RL 已成为先进智能体模型的基线特征(OpenAI o3, Kimi K2, Qwen QwQ-32B 等)。
3. 记忆 (Memory)
| 阶段 | 方法 | 特点 |
|---|---|---|
| 无 RL 记忆 | MemoryBank, MemGPT, HippoRAG | 预定义记忆管理策略 |
| 可训练记忆控制器 | 显式 token / 隐式状态 | 智能体自主调控记忆状态 |
| 结构化记忆 | Zep (时序知识图谱), A-MEM (原子记忆), G-Memory (层次图) | 超越扁平 token 序列 |
| RL 控制记忆 | RL 决定存储/检索/遗忘 | 动态子系统 |
4. 自我改进 (Self-Improvement)
三个层次:
- 提示式反思:Reflexion 等,单次推理中的语言自我纠正(无梯度更新)
- RL 内化反思:通过梯度更新将反思能力内化到模型参数
- 自主循环:自我博弈 + 搜索引导精化,无需人类标注数据的无界自我改进
5. 推理 (Reasoning)
双过程理论:
- 快速推理 (System 1):启发式驱动,快速直觉,无显式中间步骤
- 慢速推理 (System 2):显式中间推理链,链式思维,多步验证
RL 挑战:在智能体场景中可靠训练慢思考推理能力,面临训练稳定性、多样化环境兼容等挑战。
6. 感知 (Perception)
多模态感知能力,使智能体能够处理视觉、听觉等非文本输入。
五、任务视角:关键应用领域
领域演进树
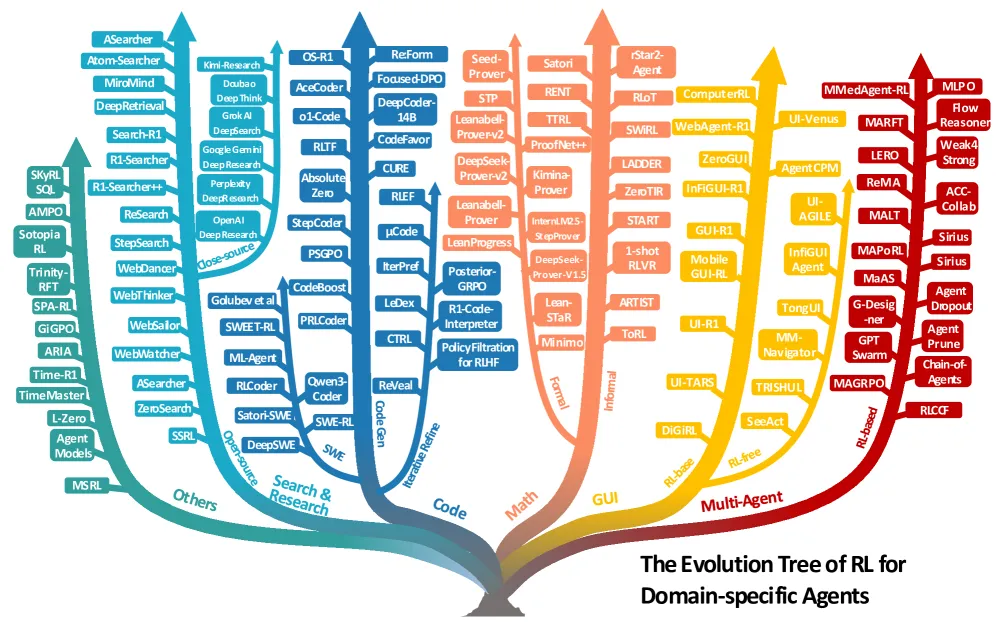
1. 搜索与研究智能体
- 开源方法:DeepRetrieval (GRPO 训练查询生成), Search-R1, R1-Searcher
- 闭源方法:OpenAI DeepResearch, Gemini Deep Research
- 挑战:BrowseComp 基准测试暴露长程规划、页面工具使用、跨源验证的差距
2. 代码智能体
| 阶段 | 任务 | 代表方法 |
|---|---|---|
| 单轮代码生成 | 函数编写、竞赛题 | AceCoder, StepCoder, PSGPO |
| 迭代代码精化 | 调试、多轮改进 | RLEF, IterPref, LeDex |
| 自动软件工程 | 仓库级任务、SWE-bench | DeepSWE, SWE-RL, DAPO |
3. 数学智能体
- 非形式化推理:自然语言数学推理,RLVR (DAPO, GRPO, GRESO)
- 形式化推理:Lean/Isabelle 等证明助手中的形式化证明
4. GUI 智能体
- 静态环境:WebShop, MiniWoB++
- 交互环境:AndroidWorld, 动态网页
- 挑战:长程规划、状态空间巨大、奖励稀疏
5. 具身智能体
机器人控制、物理世界交互。
6. 多智能体系统
协作、竞争、通信协议的学习。
六、环境与框架
环境分类
| 类别 | 代表环境 | 特点 |
|---|---|---|
| Web 环境 | WebShop, MiniWoB++, Mind2Web | 静态/动态网页交互 |
| GUI 环境 | AndroidWorld, AITW | 移动/桌面 GUI 操作 |
| 代码环境 | Debug-Gym, HumanEval, SWE-bench | 可执行验证 |
| 领域特定 | ScienceWorld, PaperBench, MLE-Dojo | 科学/研究任务 |
| 通用环境 | ALFWorld, BabyAI | 文字冒险/导航 |
RL 框架
| 框架 | 类型 | 关键特性 |
|---|---|---|
| veRL | 训练框架 | 高效训练-Rollout 协同 |
| OpenRLHF | 训练框架 | 开源 RL 对齐 |
| TRL | 训练框架 | HuggingFace 生态集成 |
| AgentGym | 环境框架 | 多环境统一接口 |
七、核心创新
| 创新点 | 说明 | 影响 |
|---|---|---|
| 形式化区分 | 首次系统性地将 Agentic RL 与传统 LLM-RL 从 MDP/POMDP 角度形式化区分 | 为领域建立理论基础 |
| 双重分类法 | 能力视角 + 任务视角的全面分类框架 | 覆盖 500+ 篇工作 |
| 动作空间形式化 | 的统一表示 | 连接语言生成与环境交互 |
| RL 算法族谱 | PPO/DPO/GRPO 三大族系的系统梳理 | 算法选择指导 |
| 实用资源汇编 | 环境、基准、框架的实践指南 | 加速未来研究 |
八、开放挑战与未来方向
1. 可信度 (Trustworthiness)
- 安全风险:智能体的攻击面比标准 LLM 更大(工具、记忆、规划模块)
- 奖励黑客:RL 可能放大不安全行为——智能体学习将不安全动作作为最大化奖励的最有效路径
- 幻觉:结果驱动的 RL 可能鼓励虚假关联,产生自信但无依据的中间推理
- 谄媚:智能体倾向于迎合用户观点而非提供客观判断
- 缓解策略:沙箱隔离、基于过程的奖励、谄媚感知奖励模型
2. 扩展智能体训练
- Agent RL Scaling Law:更长训练视界系统性提升工具使用频率、推理深度和任务准确率
- 熵坍缩:大模型 + RL 可能导致输出分布收窄,限制多样性
- 跨域交互:数学、代码、逻辑等领域的 RL 训练存在协同和冲突
- 训练效率:POLARIS 等通过数据难度校准、多样性采样、推理长度扩展提升效率
3. 扩展智能体环境
- 环境自动化:从静态环境转向动态可优化系统
- 课程生成:自动课程生成,环境作为主动教师
- 奖励工程:自动设计奖励信号
九、总结
核心贡献
- 范式形式化:首次系统性地将 Agentic RL 与传统 LLM-RL 从 MDP/POMDP 角度进行形式化区分
- 双重分类框架:能力视角(规划/工具/记忆/自我改进/推理/感知)+ 任务视角(搜索/代码/数学/GUI/视觉/具身/多智能体)
- 算法梳理:PPO/DPO/GRPO 三大族系的系统性比较和演进脉络
- 资源汇编:整合环境、基准、框架为实用参考指南
- 挑战展望:可信度、训练扩展、环境扩展三大前沿方向
技术影响
- 为 Agentic RL 领域建立统一的理论框架和术语体系
- 揭示 RL 作为将静态能力转化为自适应鲁棒行为的关键机制
- 为构建可扩展通用 AI 智能体提供路线图
局限性
- 综述覆盖范围广但深度有限,每个子领域可进一步展开
- 部分新兴工作(2025年下半年)可能未被覆盖
- 闭源系统(OpenAI, Anthropic)的技术细节有限
- 缺乏统一的跨领域评估基准
十、参考资源
- 论文: arXiv:2509.02547
- 关键引用: 500+ 篇近期工作
- 核心参考:
- PPO: Schulman et al., 2017
- DPO: Rafailov et al., 2024
- GRPO: DeepSeek, 2025
- ReAct: Yao et al., 2023
- Reflexion: Shinn et al., 2023---
分析日期: 2026-06-04