LiquidGEMM: Hardware-Efficient W4A8 GEMM Kernel for High-Performance LLM Serving
硬件高效的W4A8 GEMM内核,实现2.90倍加速和4.94倍系统级加速
LiquidGEMM: Hardware-Efficient W4A8 GEMM Kernel for High-Performance LLM Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LiquidGEMM: Hardware-Efficient W4A8 GEMM Kernel for High-Performance LLM Serving |
| 作者 | Huanqi Hu, Bowen Xiao, Shixuan Sun, Jianian Yin, Zhexi Zhang, Xiang Luo, Chengquan Jiang, Weiqi Xu, Xiaoying Jia, Xin Liu, Minyi Guo |
| 论文 | arXiv:2509.01229 |
| 发布 | 2025年9月1日 |
| 领域 | cs.DC, cs.AI, cs.LG |
| 页数 | 12页,13张图 |
二、核心思想
问题定义
量化是通过减少内存占用和提高计算效率来加速LLM推理的关键技术。在各种量化方案中,4-bit权重和8-bit激活量化(W4A8)在精度和性能之间提供了强大的平衡。然而,现有的W4A8 GEMM内核在实践中表现不佳,原因在于CUDA Core上的低效反量化无法跟上Tensor Core的高吞吐量。
具体问题:
- QServe等现有W4A8实现在小批量(batch size ≤ 64)下与W8A8性能相当
- 在大批量(batch size ≥ 128)下反而比W8A8慢2倍
- 甚至不如FP16和W4A16等无量化的方案
- 这与理论roofline分析的预期完全相反
解决方案概述
本文提出LiquidGEMM,一种硬件高效的W4A8 GEMM内核,包含两个关键技术:
- LiquidQuant (LQQ):一种硬件高效的量化方法,仅需两条算术指令即可处理四个元素的快速、无溢出反量化
- 隐式细粒度流水线(ImFP):在warp组之间完全重叠权重加载、反量化和MMA,无需软件同步或冗余内存流量
核心成果:
- 相比SOTA W4A8内核加速2.90倍
- 端到端系统级加速4.94倍
- 相比TensorRT-LLM的各种量化GEMM内核(W4A16, W8A8, FP8)性能提升1.12-1.63倍
- 系统级加速最高1.63倍
三、技术架构
整体框架图
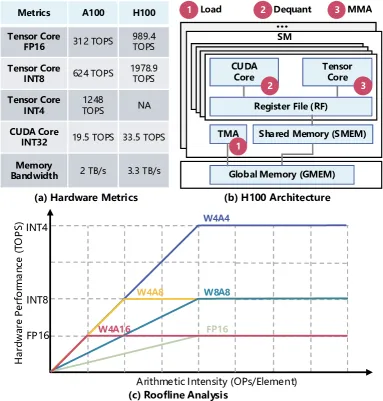
Figure 1: NVIDIA A100和H100 GPU的关键性能指标,以及LLM服务中GEMM层的roofline分析。
核心公式
量化基础
标准量化公式:
反量化公式:
LiquidQuant量化
两级量化框架:
第一级:FP16 → INT8(使用per-channel缩放)
第二级:INT8 → UINT4(关键创新)
LiquidQuant反量化(核心创新):
其中 离线预计算, 表示XOR操作。
关键优势:
- 所有中间值保持在UINT8范围内,避免溢出
- 仅需IMAD和XOR两条指令处理4个元素
- 完全由硬件原生支持
成本模型
单次迭代时间:
GPU级执行时间:
关键约束:为匹配权重加载延迟,每元素指令成本需满足 (H100)
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| LiquidQuant (LQQ) | 硬件高效的两级量化方案 | INT8→UINT4,仅需IMAD+XOR |
| 隐式细粒度流水线(ImFP) | 单生产者-多消费者执行模型 | 跨warp组重叠加载/反量化/MMA |
| Dual-MMA打包布局 | 优化的权重内存布局 | 减少内存访问开销 |
| TMA异步加载 | Tensor Memory Accelerator | 异步权重传输到SMEM |
流水线设计
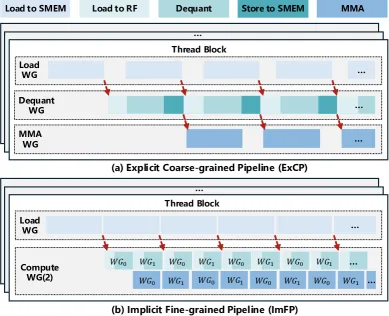
Figure 6: 显式粗粒度流水线(ExCP)和隐式细粒度流水线(ImFP)设计对比。
显式粗粒度流水线(ExCP)的问题
传统的warp specialization方法将warps分为Load Warps和MMA Warps:
- 反量化需要在RF和SMEM之间往返数据移动
- 需要昂贵的warp间同步
- 导致流水线气泡和效率降低
隐式细粒度流水线(ImFP)设计
单生产者-多消费者模型:
- 专用Load WG将权重从GMEM传输到SMEM
- GEMM工作负载被划分为细粒度任务
- 多个Compute WG以抢占式方式动态消费任务
- 每个Compute WG立即对其反量化的权重执行MMA
- 任务调度由硬件管理,避免软件同步开销
关键优势:
- 消除SMEM和RF之间的往返数据移动
- 反量化和MMA在并发执行的Compute WG之间重叠
- 无软件同步开销
量化溢出分析
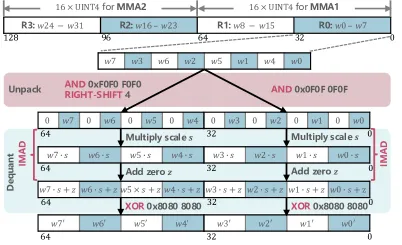
Figure 8: 使用bitwise和IMAD指令的反量化过程,由硬件原生支持。
QServe的溢出问题:
- 直接从INT8量化到UINT4导致反量化时溢出
- 需要使用vadd指令(非原生硬件指令)
- vadd被降低为十几个低级操作
- 在LLaMA2-7B FFN层中,vadd相关的减法导致21%的warp stalls
LiquidQuant的解决方案:
- 使用旋转式变换将INT8值移入UINT8范围
- 利用二进制补码表示的性质
- 在UINT8域内恢复原始INT8值,无溢出
- 仅需两条32位硬件指令:IMAD和XOR
数据布局优化
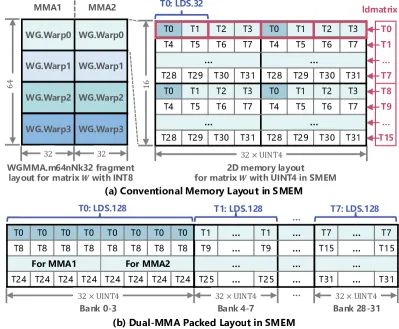
Figure 7: 传统内存布局和Dual-MMA打包布局对比。
Dual-MMA打包布局:
- 优化权重在SMEM中的存储方式
- 减少内存访问开销
- 提高Tensor Core利用率
训练流程
LiquidGEMM采用离线量化方案:
- 第一级量化(INT8)在离线完成
- 第二级量化(UINT4)也在离线完成
- 在线推理仅需执行反量化
- 支持per-group量化策略
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| LiquidQuant (LQQ) | 硬件高效的W4A8量化方案,仅需2条指令处理4元素 | 消除vadd导致的21% warp stalls |
| 溢出消除 | 利用二进制补码性质,所有中间值在UINT8范围内 | 数学证明无溢出 |
| 隐式细粒度流水线 | 单生产者-多消费者模型,硬件调度 | 消除软件同步开销 |
| Dual-MMA打包布局 | 优化SMEM中权重存储 | 减少内存访问开销 |
| Y = (WX^T)^T计算 | 改变计算顺序优化性能 | 提高硬件利用率 |
与QServe对比
| 特性 | QServe | LiquidGEMM |
|---|---|---|
| 反量化指令数 | 数十条(vadd) | 2条(IMAD+XOR) |
| 溢出处理 | 渐进量化+减法后乘法 | 旋转式变换+XOR |
| 流水线设计 | 显式粗粒度 | 隐式细粒度 |
| 硬件利用率 | 低(CUDA Core瓶颈) | 高(完全重叠) |
五、实验结果
基准测试
实验环境:
- GPU:NVIDIA H800
- 模型:LLaMA2-7B, LLaMA2-13B, LLaMA2-70B, LLaMA3-8B, Mistral-7B, Mixtral-8×7B
- 基线:QServe (W4A8), TensorRT-LLM (W4A16, W8A8, FP8)
GEMM内核性能
| 对比方法 | 加速比 |
|---|---|
| vs QServe (W4A8) | 2.90× |
| vs TRT-W4A16 | 1.12-1.63× |
| vs TRT-W8A8 | 1.12-1.63× |
| vs TRT-FP8 | 1.12-1.63× |
系统级性能
| 对比方法 | 系统级加速 |
|---|---|
| vs QServe | 4.94× |
| vs TensorRT-LLM | 1.63× |
消融实验
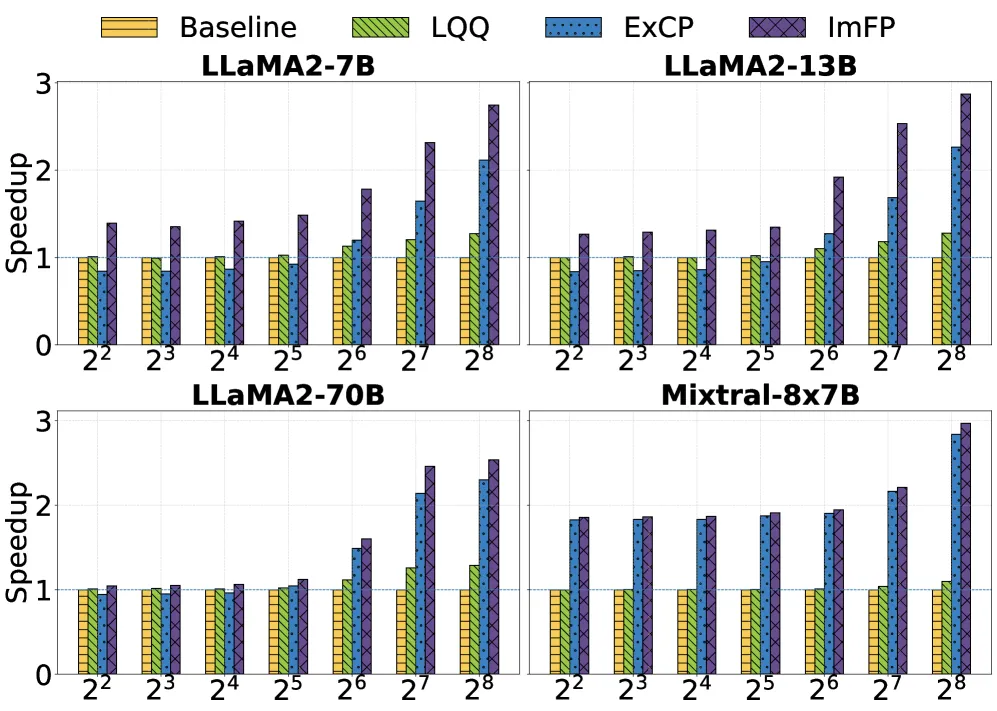
Figure 13: LiquidGEMM消融研究,首先启用LQQ,然后使用显式粗粒度流水线(ExCP)或隐式细粒度流水线(ImFP)。
消融结果:
- LQQ单独:相比基线有显著提升
- LQQ + ExCP:进一步提升,但受限于流水线开销
- LQQ + ImFP:最优性能,完全重叠反量化开销
推理时间分解
- GEMM在小批量下主导延迟
- 在大批量长序列下仍占总延迟的20%以上
- 对于Mixtral-8×7B,GEMM在所有测试用例中是主要延迟贡献者
六、相关工作
W4A8量化
- QServe (Lin et al., 2024b):SOTA W4A8实现,但存在溢出问题
- QQQ (Zhang et al., 2024):另一种W4A8方案,性能不如QServe
- Atom (Zhao et al., 2024):W4A4方案,在H800上较慢
其他量化方案
- W8A8:对称GEMM,无需主循环反量化
- W4A16:权重4-bit,激活16-bit
- FP8:8-bit浮点,TensorRT-LLM支持
GEMM优化
- CUTLASS:NVIDIA的高性能GEMM库
- FlashAttention:高效注意力计算
- PagedAttention:KV cache管理
七、总结
核心贡献
- 深入分析W4A8 GEMM执行流水线:识别关键性能瓶颈
- LiquidGEMM:高性能W4A8 GEMM内核,优化LLM服务
- LiquidQuant:硬件高效量化算法,最小化GPU反量化开销
- 隐式细粒度流水线:通过高效流水线执行最大化硬件利用率
- 端到端LLM服务系统:基于开源组件构建的完整评估系统
技术影响
- 填补理论与实践差距:使W4A8实际性能匹配roofline分析预期
- 生产部署:已部署为主要GEMM内核
- 硬件趋势适配:随着Tensor Core性能提升,W4A8价值更大
- 通用性:优化适用于其他架构和任务
局限性
- 硬件依赖:针对NVIDIA Hopper GPU优化
- 量化范围限制:INT8值限制在[-119, 119]
- 模型支持:主要在LLaMA系列模型上验证
未来工作
- 改进融合GEMM+反量化内核,支持完全向量化的16字节加载
- 探索分布式推理以部署更大规模模型
- 扩展到更多模型架构
八、参考资源
- 论文: arXiv:2509.01229
- PDF: arxiv.org/pdf/2509.01229
- HTML版本: arxiv.org/html/2509.01229v1
引用
@article{hu2025liquidgemm,
  title={LiquidGEMM: Hardware-Efficient W4A8 GEMM Kernel for High-Performance LLM Serving},
  author={Hu, Huanqi and Xiao, Bowen and Sun, Shixuan and Yin, Jianian and Zhang, Zhexi and Luo, Xiang and Jiang, Chengquan and Xu, Weiqi and Jia, Xiaoying and Liu, Xin and Guo, Minyi},
  journal={arXiv preprint arXiv:2509.01229},
  year={2025}
}