LightVLM: Accelerating Large Multimodal Models with Pyramid Token Merging and KV Cache Compression
通过金字塔Token合并和KV缓存压缩,在训练无关的方式下大幅加速视觉语言模型推理
LightVLM: Accelerating Large Multimodal Models with Pyramid Token Merging and KV Cache Compression
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LightVLM: Accelerating Large Multimodal Models with Pyramid Token Merging and KV Cache Compression |
| 作者 | Lianyu Hu, Fanhua Shang, Wei Feng, Liang Wan |
| 论文 | https://arxiv.org/abs/2509.00419 |
| 发布 | 2025-08-30 |
二、核心思想
问题定义
现有VLM面临推理效率问题:
| 问题 | 说明 |
|---|---|
| 图像Token冗余 | 一张图像被编码为数千个token(如QWen2.5-VL使用16384个) |
| 注意力分布不均 | 少数token主导大部分注意力分数 |
| KV缓存膨胀 | 长序列解码时内存和计算开销大 |
观察发现
论文通过实验发现两个关键现象:
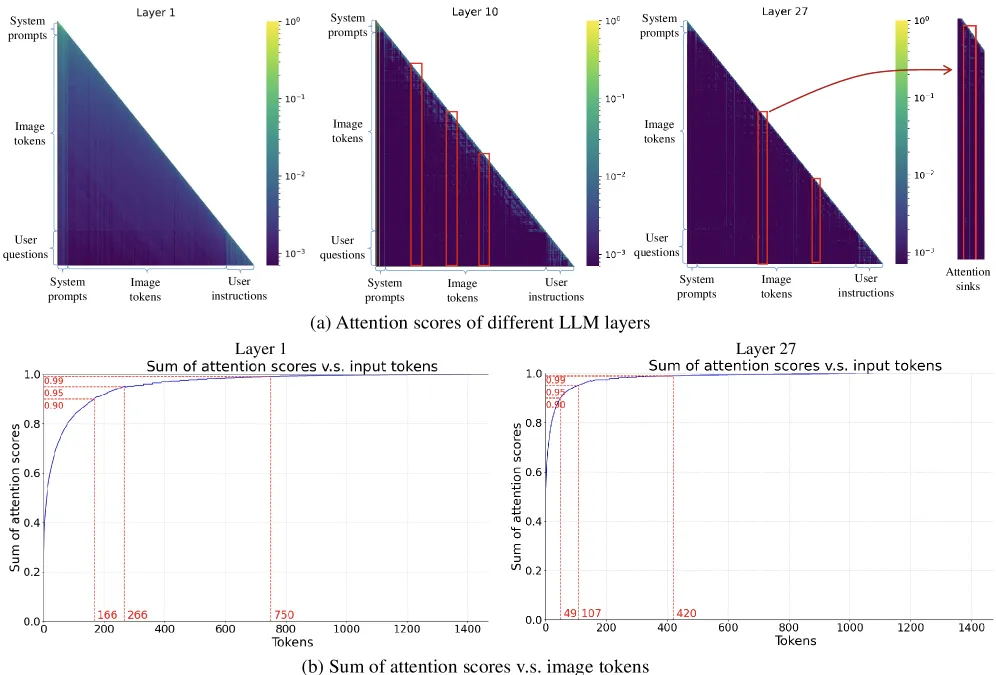
- 图像token注意力稀疏:文本输入比图像token获得多得多的注意力
- 少数token主导:在深层网络中,仅3%的图像token占据90%的注意力分数
解决方案概述
LightVLM 提出两个互补的加速策略:
- 金字塔Token合并(Pyramid Token Merging):在编码阶段逐层减少图像token
- KV缓存压缩(KV Cache Compression):在解码阶段压缩不必要的缓存
核心优势:
- 训练无关(Training-free):无需重新训练,即插即用
- 双阶段加速:同时加速编码和解码过程
- 高性能保持:仅保留35% token即可保持100%性能
三、技术架构
整体框架
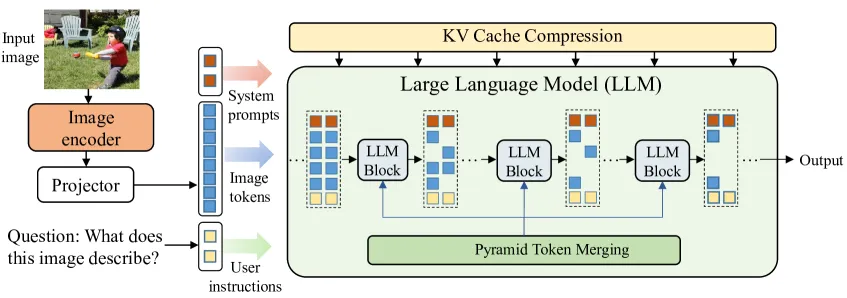
VLM推理流程:
输入图像 → 图像编码器 → 图像Token序列 → LLM解码 → 文本输出
          ↓                                        ↑
    [LightVLM加速1]                         [LightVLM加速2]
    金字塔Token合并                          KV缓存压缩
核心公式
金字塔Token合并:
其中 随层数增加而递减:
| 层数 | 保留比例 | 说明 |
|---|---|---|
| Layer 1-9 | 100% | 保留所有token |
| Layer 10-18 | 50% | 合并一半token |
| Layer 19-27 | 25% | 仅保留关键token |
KV缓存压缩:
基于注意力分数选择最重要的缓存条目。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 金字塔Token合并器 | 逐层合并图像token | keep_ratio: 100%→50%→25% |
| KV缓存选择器 | 基于注意力分数选择缓存 | keep_ratio: 可调 |
| 注意力分数统计 | 实时计算token重要性 | 无需额外训练 |
训练流程
LightVLM是训练无关的:
- 无需训练:直接在现有VLM上部署
- 即插即用:作为插件集成到VLM推理流程
- 自适应:根据输入动态调整token保留比例
四、核心创新
| 创新点 | 说明 | 优势 |
|---|---|---|
| 金字塔Token合并 | 逐层递减保留比例,模拟VLM内部信息聚合 | 高效压缩,保持性能 |
| KV缓存压缩 | 基于注意力分数选择重要缓存 | 减少内存和计算开销 |
| 双阶段加速 | 同时加速编码和解码 | 整体推理速度大幅提升 |
| 训练无关 | 无需重新训练,即插即用 | 部署灵活,兼容性强 |
| 极端压缩 | 仅保留3%token仍保持98%性能 | 适用于资源受限场景 |
五、代码实现分析
关键代码逻辑:
def pyramid_token_merging(tokens, layer_idx, total_layers):
    if layer_idx < total_layers * 0.33:
        return tokens  # 前1/3层保留所有token
    elif layer_idx < total_layers * 0.67:
        return merge_tokens(tokens, keep_ratio=0.5)  # 中间1/3保留50%
    else:
        return merge_tokens(tokens, keep_ratio=0.25)  # 后1/3保留25%

def kv_cache_compression(kv_cache, attention_scores, keep_ratio):
    top_k = int(len(kv_cache) * keep_ratio)
    indices = torch.topk(attention_scores, top_k).indices
    return kv_cache[indices]
六、实验结果
图像理解基准测试
QWen2.5-VL 7B模型结果:
| 方法 | MMMU | MMBench | MMStar | RWQA | 平均 |
|---|---|---|---|---|---|
| 原始(100%) | 58.6 | 82.6 | 63.9 | 68.5 | 65.3 |
| LightVLM (35%) | 58.7 | 82.5 | 63.8 | 68.6 | 65.3 |
| SparseVLM (35%) | 56.4 | 79.0 | 60.6 | 65.6 | 62.5 |
| FasterVLM (35%) | 57.7 | 80.9 | 62.1 | 67.5 | 64.0 |
| VisionZip (35%) | 57.8 | 81.2 | 62.7 | 67.3 | 64.3 |
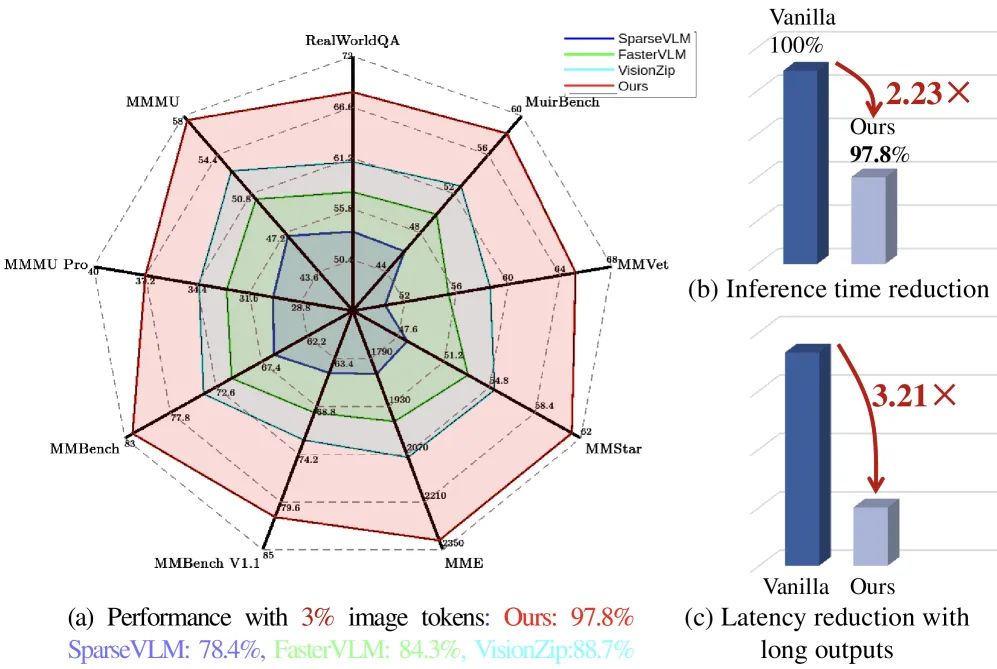
| LightVLM (3%) | 57.6 | 81.3 | 61.3 | 68.2 | 63.9 |
| FasterVLM (3%) | 50.3 | 69.5 | 53.1 | 57.6 | 55.0 |
| VisionZip (3%) | 52.9 | 72.6 | 55.2 | 60.8 | 57.9 |
关键发现:
- 35% token:LightVLM保持100%性能,甚至略有提升
- 3% token:LightVLM保持97.8%性能,大幅超越其他方法
- 压缩图像token可帮助VLM更好感知(去噪效应)
视频理解基准测试
QWen2.5-VL 7B模型结果:
| 方法 | VideoMME | MVBench | EgoS | MLVU | 平均 |
|---|---|---|---|---|---|
| 原始(100%) | 71.6/65.1 | 69.6 | 65.0 | 70.2 | 68.3 |
| LightVLM (35%) | 71.7/65.1 | 69.7 | 65.0 | 70.1 | 68.3 |
| LightVLM (15%) | 71.3/65.0 | 69.4 | 64.1 | 69.6 | 67.8 |
| LightVLM (3%) | 70.5/64.1 | 68.6 | 64.0 | 68.7 | 67.1 |
| FasterVLM (3%) | 61.0/55.5 | 59.3 | 55.4 | 59.8 | 52.5 |
| VisionZip (3%) | 64.2/58.3 | 62.4 | 58.2 | 62.9 | 61.1 |
大模型加速效果
使大模型更快:
| 模型配置 | MMMU | MMStar | 吞吐量 |
|---|---|---|---|
| InternVL2.5 8B(原始) | 56.0 | 62.8 | 基准 |
| InternVL2.5 26B + LightVLM | 60.1 | 66.6 | 更高 |
| QWen2.5-VL 3B(原始) | 53.3 | 54.6 | 基准 |
| QWen2.5-VL 7B + LightVLM | 58.8 | 62.6 | 更高 |
关键发现:LightVLM使大模型(如26B)比小模型(如8B)更快且性能更好
效率分析
推理速度提升:
| 方法 | 吞吐量(img/s) | 增速 | 首token延迟 | 加速 |
|---|---|---|---|---|
| QWen2.5-VL 7B | 1.86 | - | 428ms | - |
| PyramidDrop | 2.97 | 1.60× | 237ms | 1.80× |
| SparseVLM | 3.07 | 1.65× | 251ms | 1.71× |
| FasterVLM | 3.31 | 1.78× | 223ms | 1.92× |
| VisionZip | 3.83 | 2.06× | 96ms | 4.46× |
| LightVLM | 3.75 | 2.02× | 117ms | 3.65× |
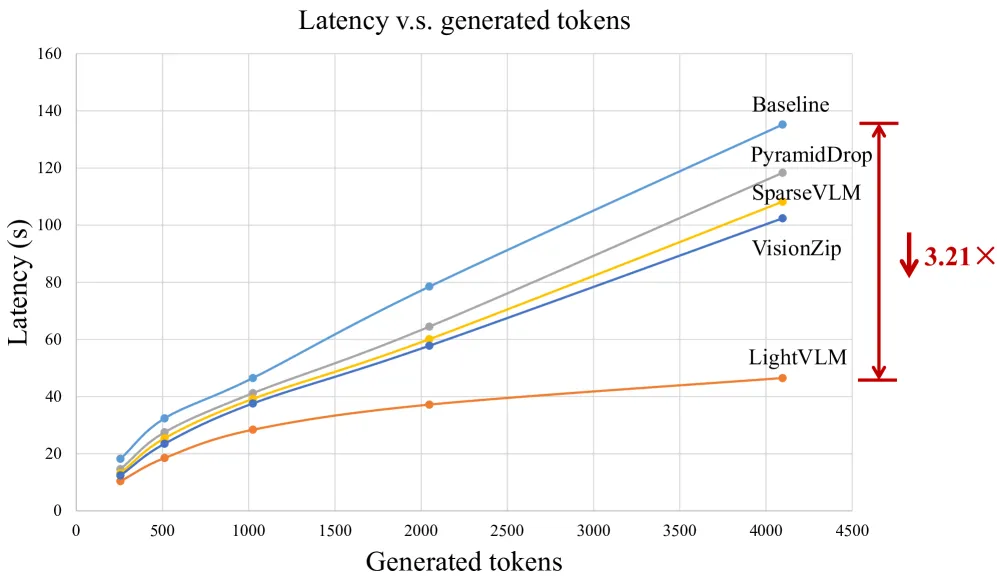
长序列生成加速:
- 生成4096 token时,LightVLM减少3.21×推理时间
- 内存使用也显著降低
七、相关工作
Token减少方法
| 方法 | 策略 | 局限性 |
|---|---|---|
| SparseVLM | 稀疏注意力 | 性能下降明显 |
| FasterVLM | token选择 | 极端压缩效果差 |
| PyramidDrop | 层级丢弃 | 缺乏自适应性 |
| VisionZip | 视觉压缩 | 不够精细 |
八、总结
核心贡献
- 发现VLM注意力稀疏性:图像token注意力分布极不均匀
- 提出金字塔Token合并:逐层递减保留比例,高效压缩
- 提出KV缓存压缩:基于重要性选择,减少内存开销
- 训练无关部署:即插即用,兼容多种VLM
技术影响
- 推理加速:2.02×吞吐量提升,3.65×首token加速
- 极端压缩:3%token保持98%性能
- 大模型加速:使大模型比小模型更快
- 部署灵活:无需训练,适用于多种VLM
局限性
- 压缩上限:低于3%token时性能下降明显
- 架构依赖:主要验证于Transformer架构VLM
- 动态调整:保留比例需手动设置
- 视频任务:长视频处理仍有优化空间
九、参考资源
论文
- 本文: https://arxiv.org/abs/2509.00419
- QWen2.5-VL: Bai et al., 2025
- InternVL2.5: Chen et al., 2024
相关方法
- SparseVLM: Zhang et al., 2025
- FasterVLM: Zhang et al., 2024
- PyramidDrop: Xing et al., 2025
- VisionZip: Yang et al., 2025