Strata: Hierarchical Context Caching for Long Context Language Model Serving
面向长上下文LLM服务的分层上下文缓存框架
Strata: Hierarchical Context Caching for Long Context Language Model Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Strata: Hierarchical Context Caching for Long Context Language Model Serving |
| 论文 | arXiv:2508.18572 |
| 发布 | 2025-08-26 |
| 主题 | cs.DC (Distributed, Parallel, and Cluster Computing) |
| 评论 | 13 pages, 14 figures, under peer review |
| 代码 | 基于SGLang构建,已在生产环境部署 |
二、核心思想
问题定义
长上下文LLM推理面临严重的性能瓶颈:
- KV缓存存储压力:长上下文的KV缓存快速超出GPU显存容量
- I/O碎片化:分页布局导致无法充分利用带宽
- 调度器缺陷:现有调度器未考虑缓存加载延迟,导致系统处于加载受限而非计算受限状态
关键观察(Figure 1):
- 在LooGL数据集上,Qwen2.5-14B的Load/Compute Ratio显示大部分时间花在从CPU加载KV缓存
- 长上下文场景下,I/O成为主要瓶颈
解决方案概述
Strata是一个面向长上下文LLM服务的分层上下文缓存框架:
- GPU辅助I/O:解耦GPU和CPU内存布局,对抗KV缓存碎片化
- 缓存感知调度:平衡计算与I/O延迟,重叠不可避免的停顿与互补任务
- 生产部署:基于SGLang构建,已在领先AI公司生产环境部署
三、技术架构
整体框架图
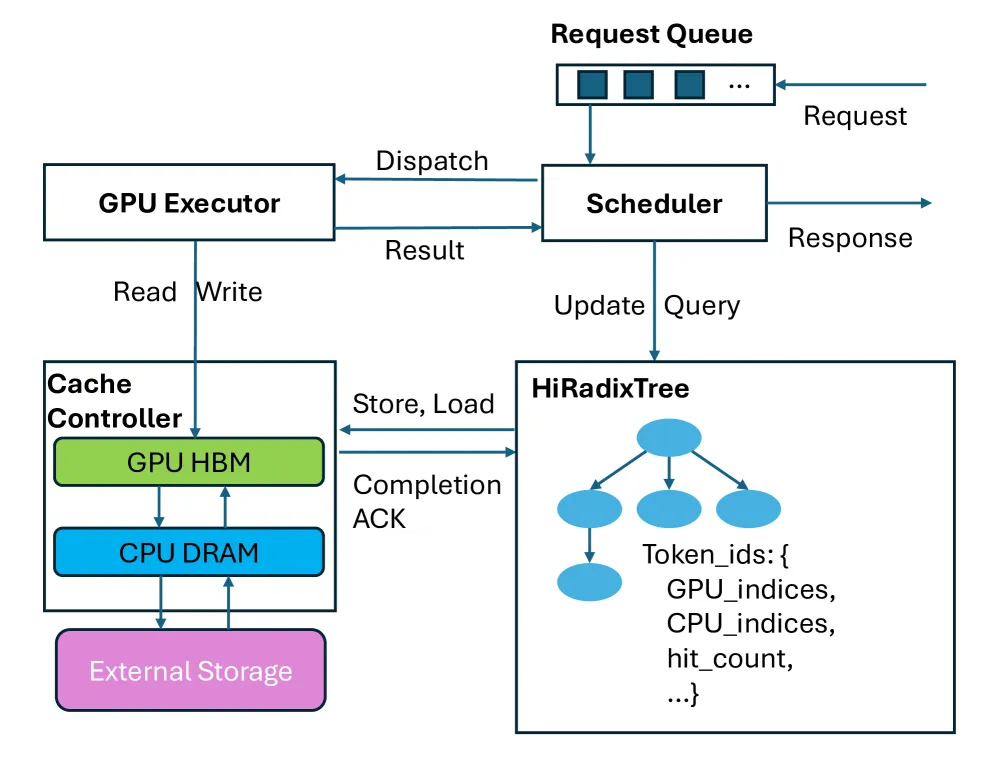
Figure 4: Strata系统架构。
核心挑战
Challenge 1: KV缓存碎片化
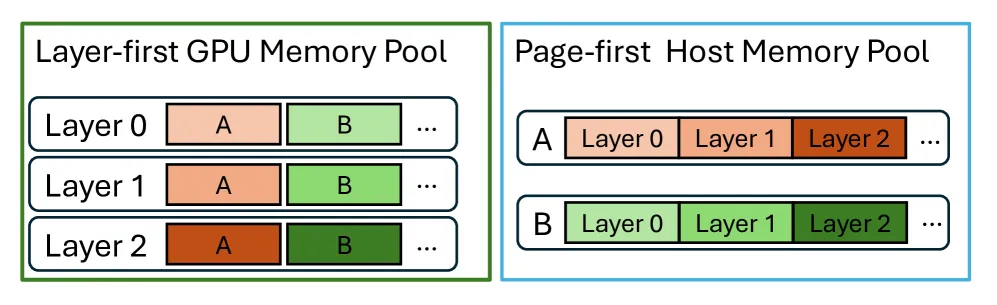
Figure 6: Layer-first vs Page-first布局。
- Layer-first布局:同一层的所有token连续存储,利于GPU计算
- Page-first布局:同一token的所有层连续存储,利于CPU-GPU传输
- 问题:现有系统使用Page-first布局(分页),导致I/O碎片化
Challenge 2: 带宽利用率低
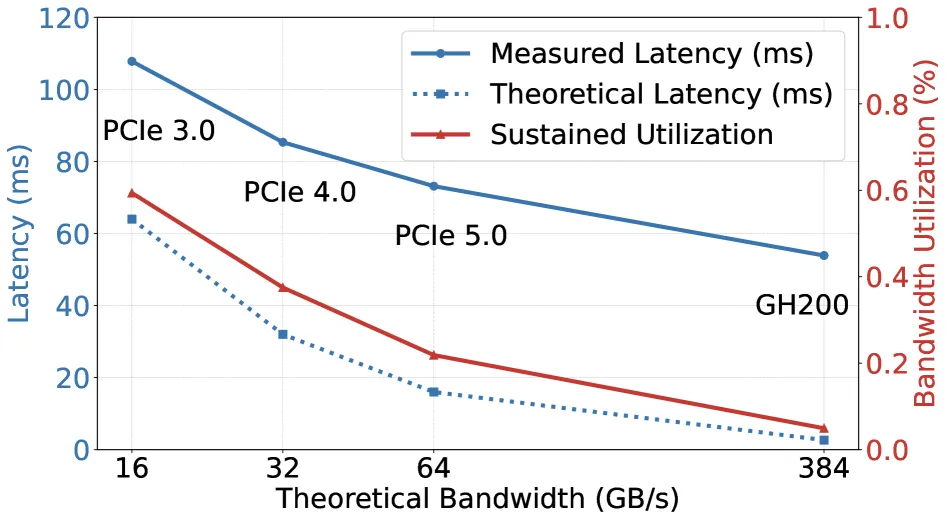
Figure 3: 从CPU加载8192 tokens KV缓存的延迟和带宽利用率。
- PCIe-5.0平台:实际带宽远低于理论峰值
- Grace-Hopper平台:NVLink提供更高带宽,但仍需优化
Challenge 3: Page大小权衡
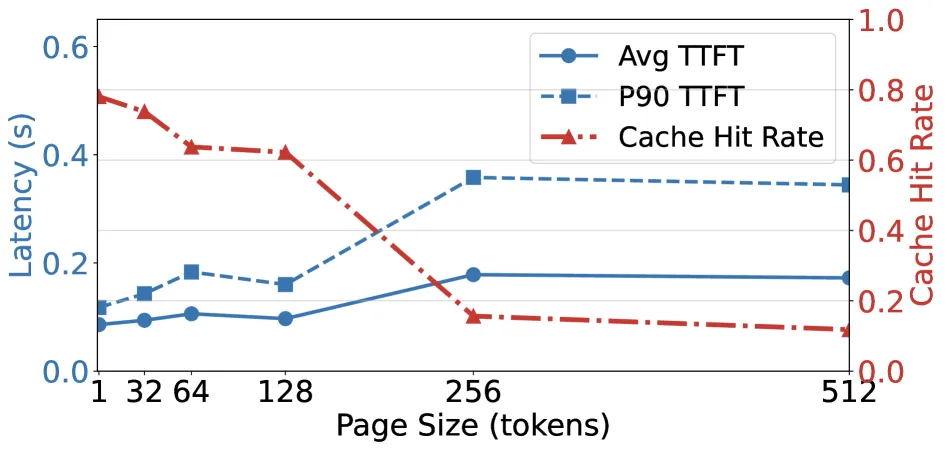
Figure 2: 大page大小降低缓存命中率并增加TTFT。
- 小page(如32 tokens):高缓存命中率,但I/O碎片化严重
- 大page:减少I/O碎片,但缓存浪费增加
核心算法
GPU辅助I/O:
- 解耦GPU和CPU内存布局
- GPU端使用Layer-first布局(利于计算)
- CPU端使用Page-first布局(利于传输)
- 使用专门的GPU kernel执行I/O,避免干扰计算
缓存感知调度:
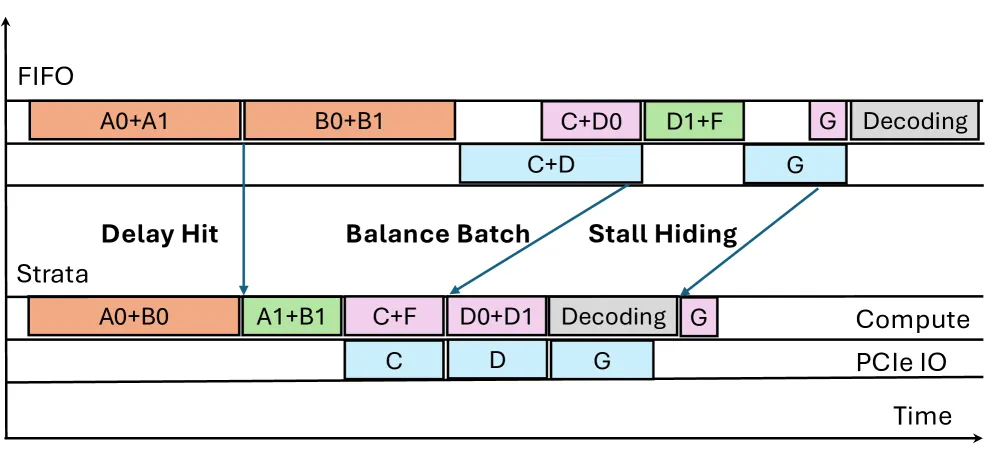
Figure 7: Strata的调度策略。
- Cache hit(绿色):直接使用GPU上的缓存
- Cache miss(橙色):需要从CPU加载,与其他计算任务重叠
- I/O重叠:将不可避免的I/O停顿与互补任务重叠
I/O干扰分析
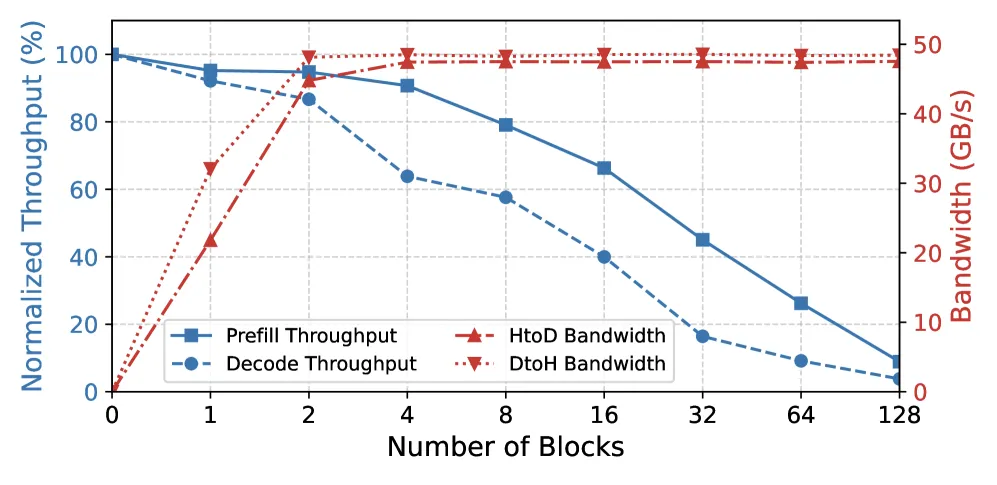
Figure 5: I/O kernel与计算kernel并发执行时的性能干扰。
- 分配适量资源给I/O kernel,避免干扰计算
- GPU辅助I/O比CPU发起的DMA更高效
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| GPU辅助I/O | 使用GPU kernel执行KV缓存传输 | 更高的带宽利用率 |
| 解耦内存布局 | GPU用Layer-first,CPU用Page-first | 兼顾计算效率和传输效率 |
| 缓存感知调度 | 考虑缓存加载延迟的请求调度 | 减少I/O等待时间 |
| I/O-计算重叠 | 将I/O停顿与互补任务重叠 | 隐藏I/O延迟 |
五、实验结果
实验设置
- 硬件平台:
- NVIDIA H200 GPU
- PCIe-5.0平台
- Grace-Hopper平台
- 模型:
- Llama-3.1-8B
- Mistral-24B
- Qwen2.5-14B
- 基线:
- vLLM + LMCache
- NVIDIA TensorRT-LLM
- SGLang + HiCache
- 数据集:LooGL, ShareGPT
端到端性能
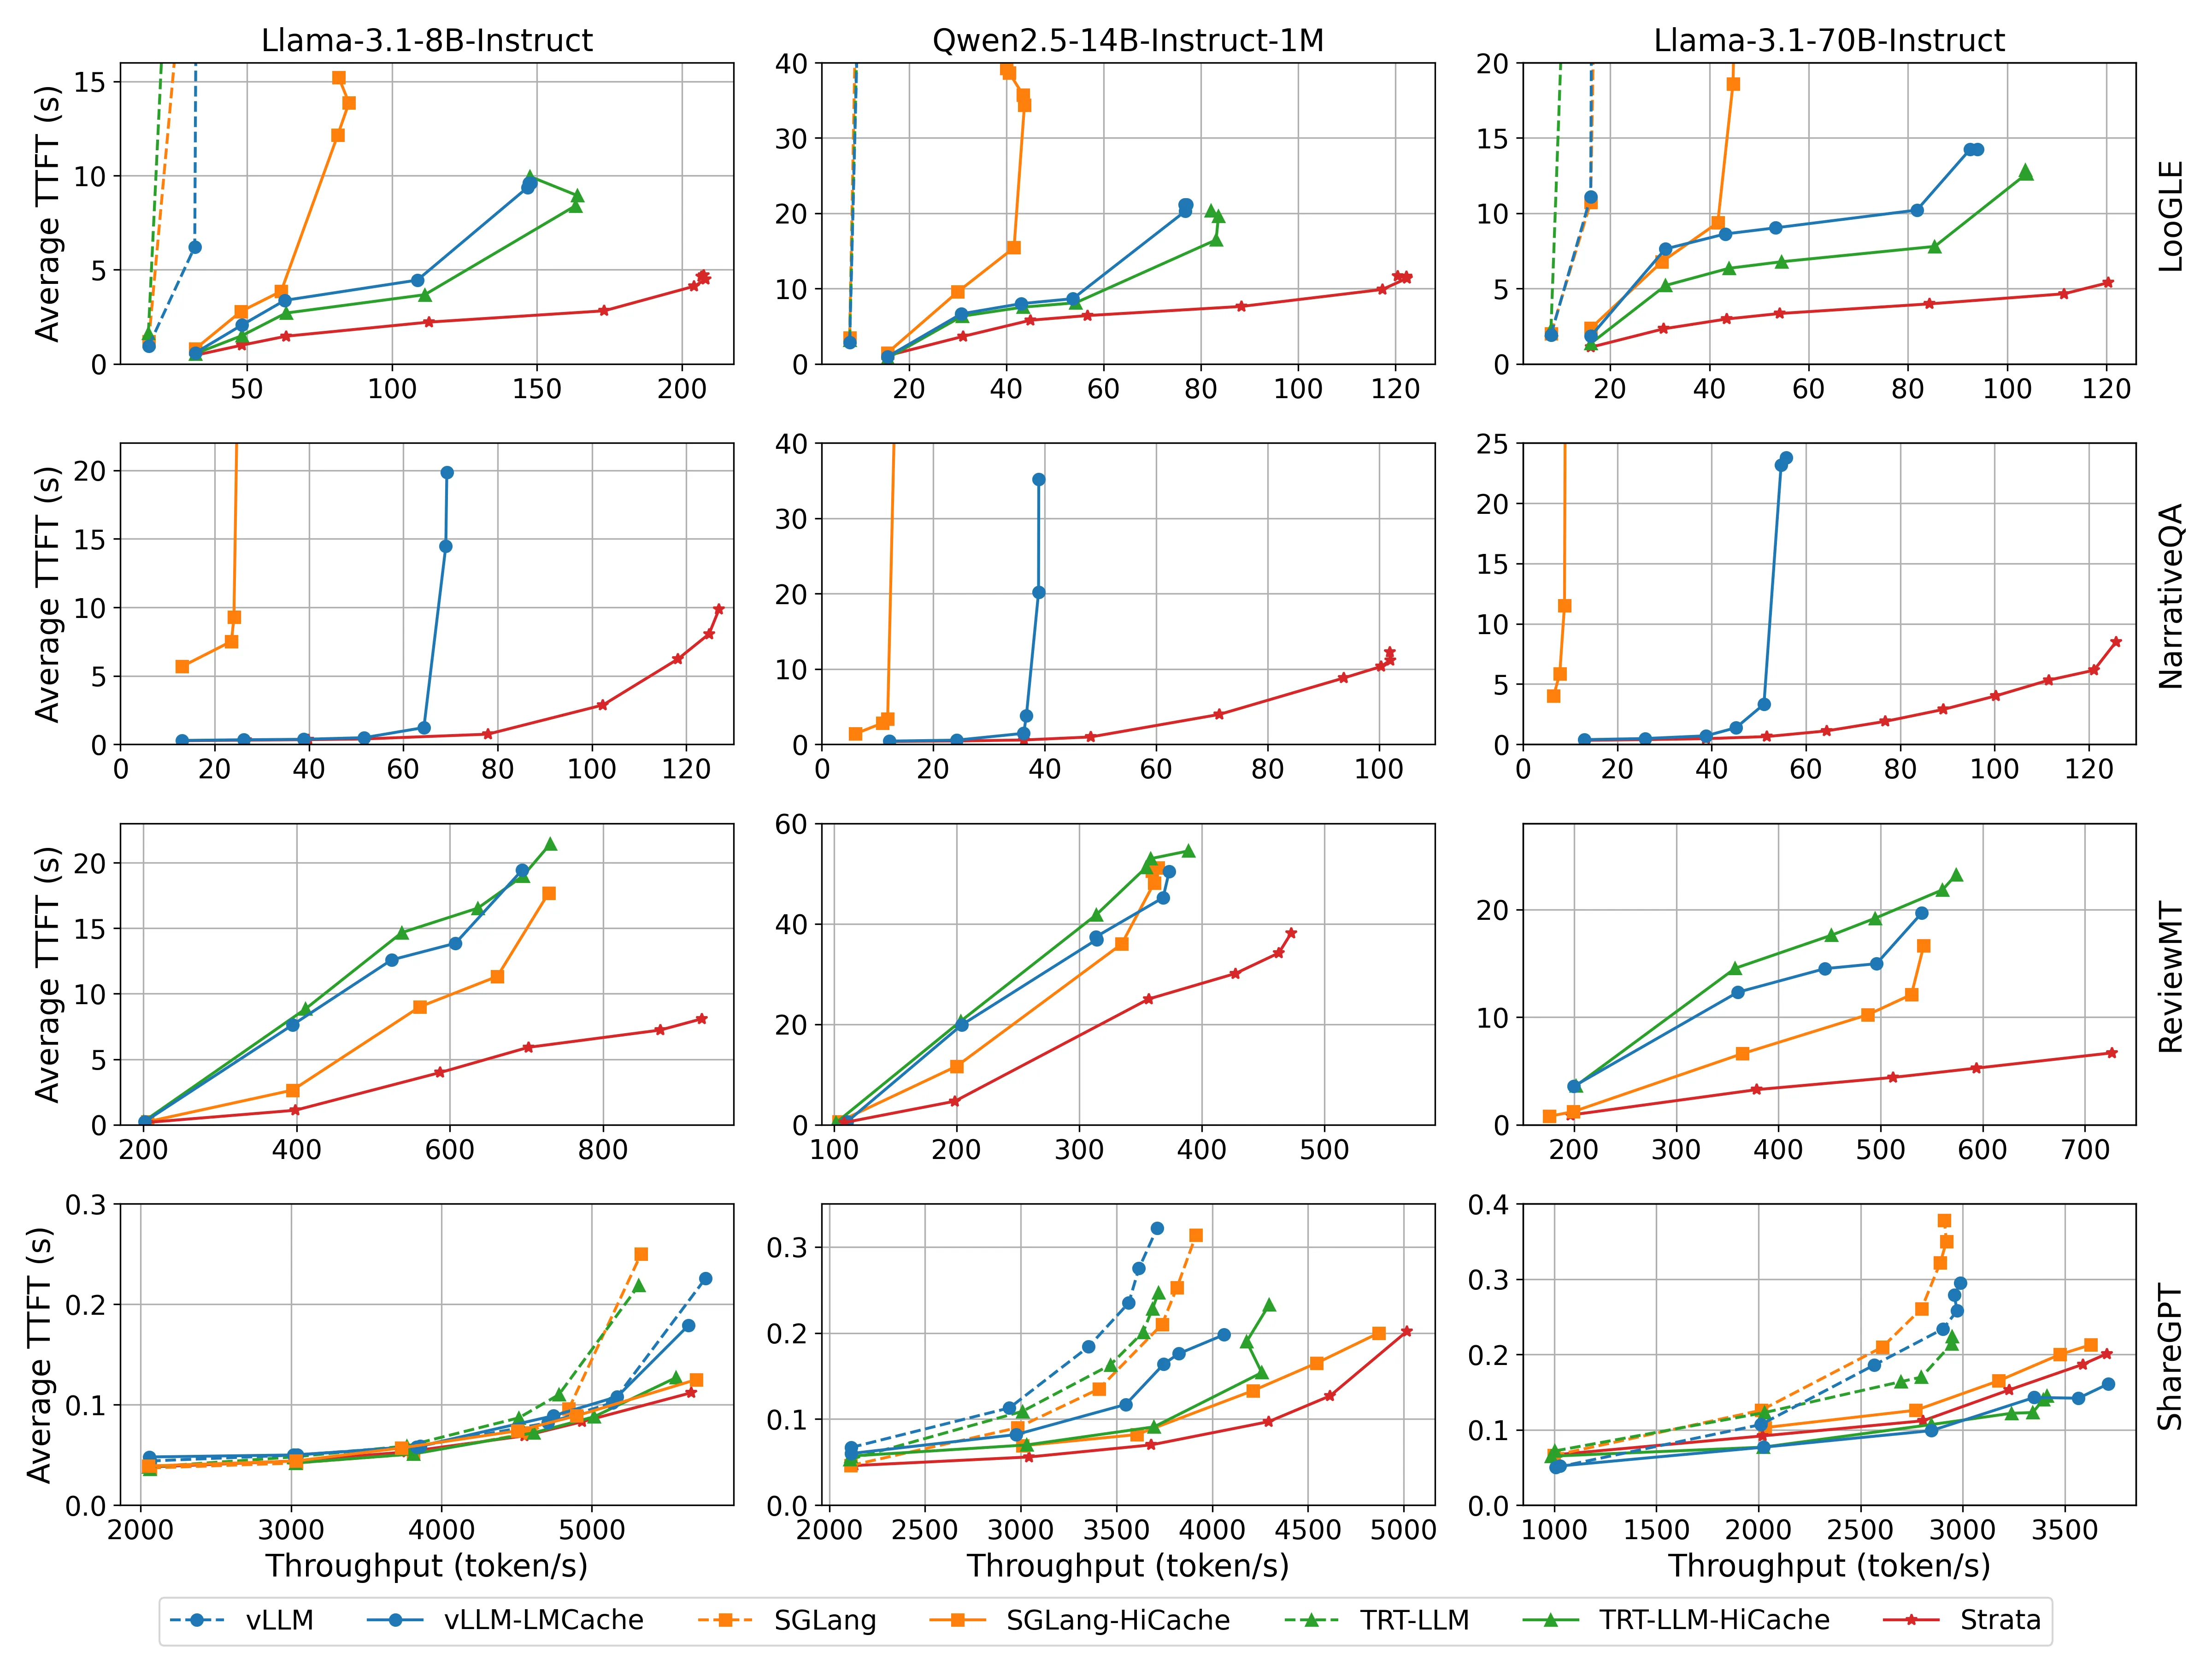
Figure 8: H200上的端到端基准测试性能对比。
关键结果:
- 比vLLM + LMCache快5倍TTFT
- 比TensorRT-LLM快3.75倍
- 短上下文场景无性能退化
I/O和调度分解
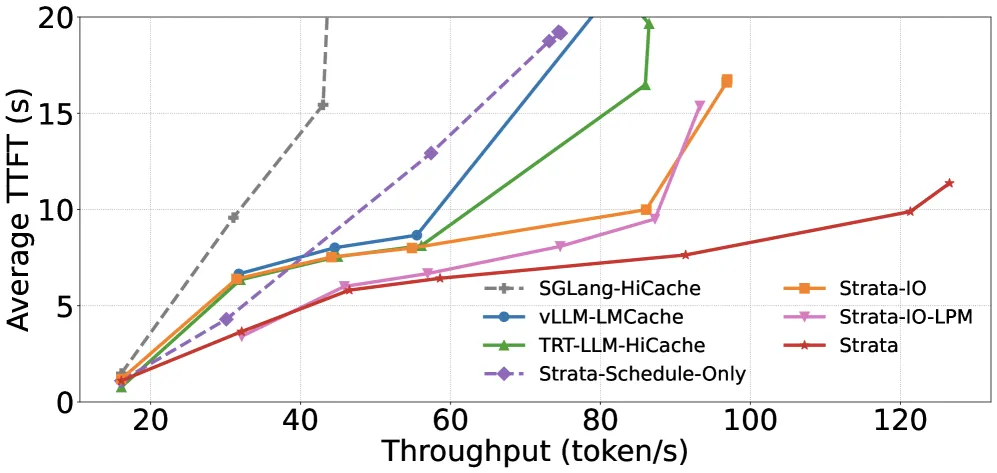
Figure 9: Strata的I/O和调度分解。
Page大小对比
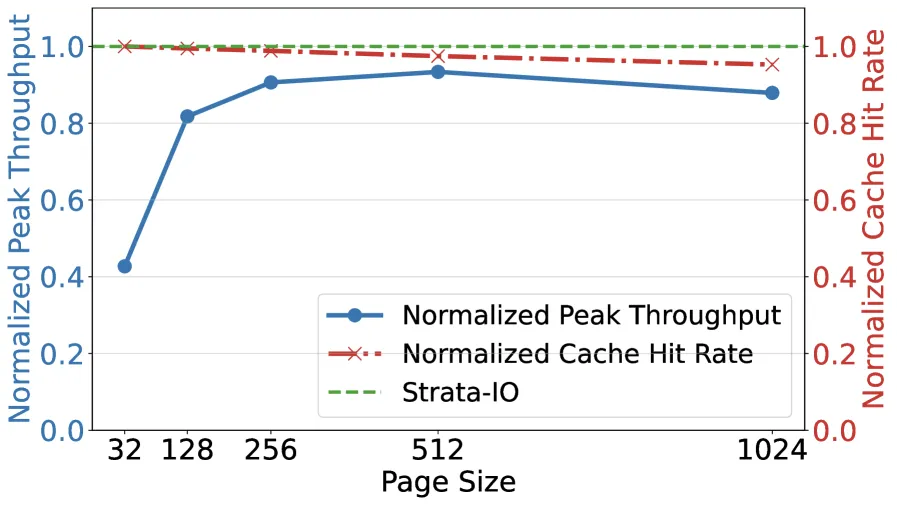
Figure 10: Strata+IO与SGLang+HiCache在不同page大小下的性能对比。
优化归因分析
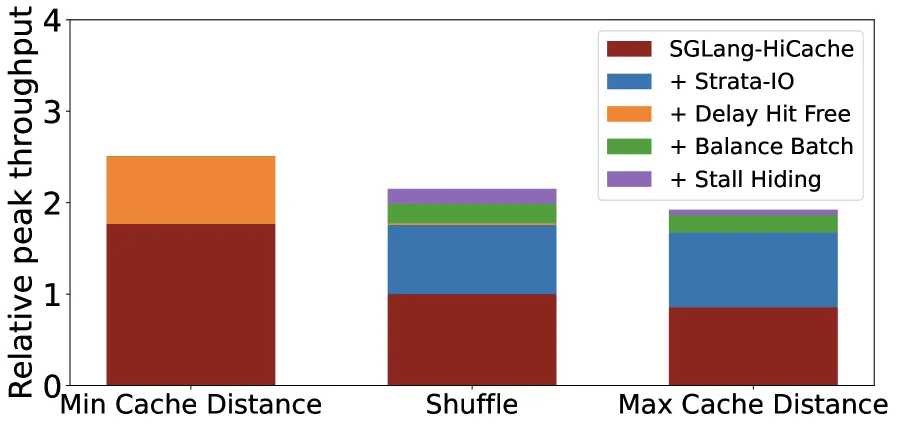
Figure 11: Strata各优化在不同工作负载模式下的贡献。
平台对比
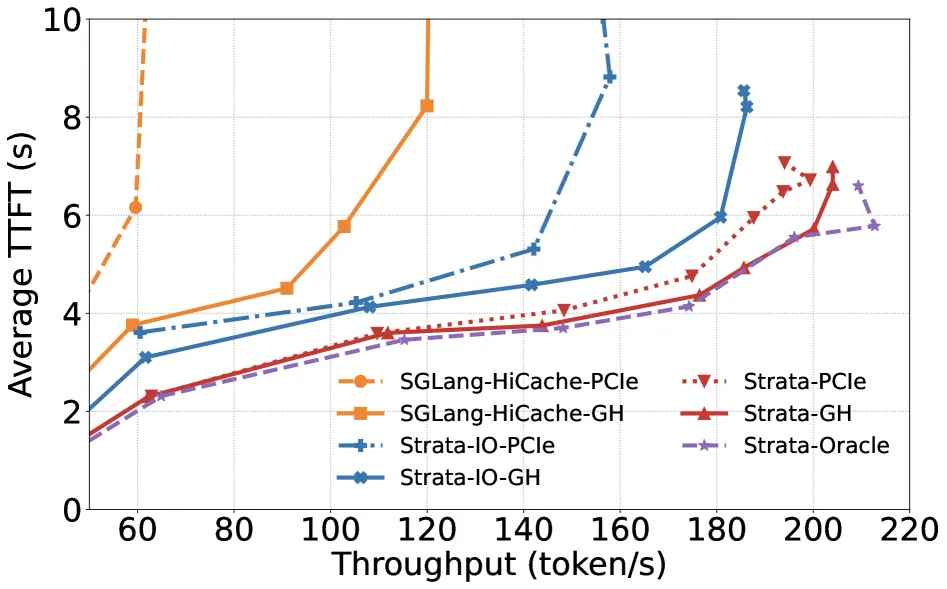
Figure 13: PCIe-5.0和Grace-Hopper平台上的性能对比。
带宽对比
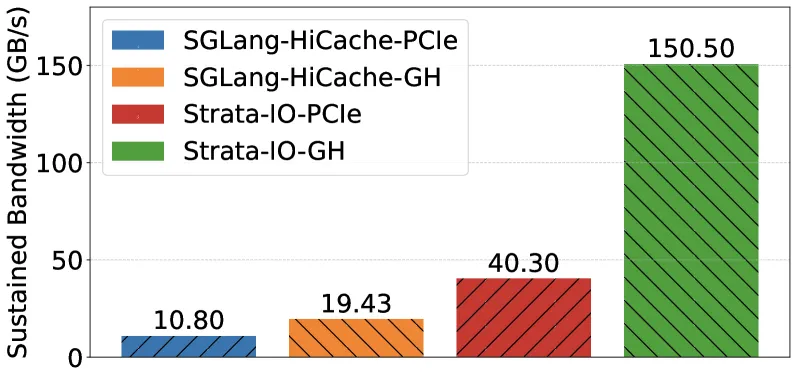
Figure 14: 持续带宽对比。
磁盘到CPU延迟
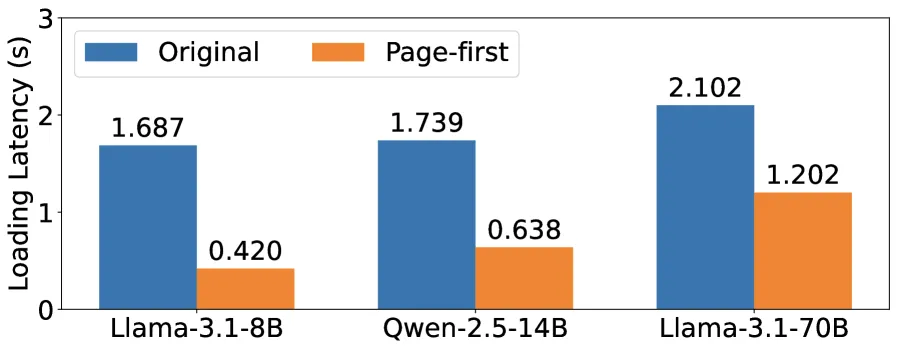
Figure 12: 不同模型从本地磁盘加载8192 tokens KV缓存到CPU内存的延迟。
六、相关工作
| 方法 | 特点 | Strata优势 |
|---|---|---|
| vLLM + LMCache | 分层缓存 | 5倍TTFT降低 |
| TensorRT-LLM | NVIDIA优化 | 3.75倍加速 |
| CachedAttention | 逐层重叠 | GPU辅助I/O更高效 |
| SGLang + HiCache | SGLang原生 | 解耦布局+缓存感知调度 |
七、总结
核心贡献
- GPU辅助I/O:使用GPU kernel执行KV缓存传输,解决碎片化问题
- 解耦内存布局:GPU用Layer-first,CPU用Page-first,兼顾计算和传输效率
- 缓存感知调度:考虑缓存加载延迟,平衡计算与I/O
- 生产验证:基于SGLang部署,已在生产环境验证
性能总结
| 指标 | 提升 |
|---|---|
| TTFT vs vLLM + LMCache | 5倍降低 |
| TTFT vs TensorRT-LLM | 3.75倍降低 |
| 短上下文性能 | 无退化 |
技术影响
Strata展示了分层缓存管理对长上下文LLM服务的重要性:
- 内存布局:需要根据使用模式选择合适的布局
- I/O优化:GPU辅助I/O比CPU发起的DMA更高效
- 调度策略:缓存感知调度能显著减少I/O等待
未来方向
- 支持更大规模模型和更长上下文
- 优化跨节点分布式缓存
- 探索更高效的压缩和量化技术
八、参考资源
- 论文: arXiv:2508.18572
- 相关框架: