ShaLa: Multimodal Shared Latent Space Modelling
ShaLa提出多模态共享潜空间建模方法,实现文本、图像等多模态信息的统一表示学习。
ShaLa: Multimodal Shared Latent Space Modelling
一、论文概述 (Paper Overview)
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 论文标题 | ShaLa: Multimodal Shared Latent Space Modelling |
| 作者 | Jiali Cui, Yan-Ying Chen, Yanxia Zhang, Matthew Klenk |
| 提交日期 | 2025年8月24日 |
| arXiv ID | 2508.17376 |
| 领域 | cs.LG (机器学习), cs.CV (计算机视觉与模式识别) |
1.2 摘要翻译
本文提出了一种用于学习多模态数据共享潜在表示的新型生成框架。许多先进的多模态方法专注于捕获输入之间所有模态特定细节的组合,这可能会无意中掩盖跨模态共享的高层语义概念。值得注意的是,具有低维潜在变量的多模态VAE旨在捕获共享表示,支持联合多模态合成和跨模态推理等各种任务。然而,多模态VAE常常难以设计表达性联合变分后验分布,并且存在低质量合成的问题。
在这项工作中,ShaLa通过整合一种新颖的架构推理模型和二阶表达性扩散先验来解决这些挑战,这不仅促进了共享潜在表示的有效推理,还显著提高了下游多模态合成的质量。我们在多个基准上广泛验证了ShaLa,展示了与最先进的多模态VAE相比更优越的一致性和合成质量。此外,ShaLa能够扩展到更多模态,而先前的多模态VAE在捕获共享潜在空间日益增加的复杂性方面存在不足。
1.3 核心问题
论文针对多模态VAE面临的两大核心挑战:
- 推理模型设计困难:现有PoE和MoE范式在表达性和跨模态推理方面存在局限
- 先验空洞问题(Prior-hole Problem):聚合后验与固定先验之间的分布不匹配导致合成质量下降
二、核心思想 (Core Ideas)
2.1 设计理念
ShaLa的核心理念是将多模态VAE与扩散模型相结合,通过学习共享语义表示来解决上述两大挑战。
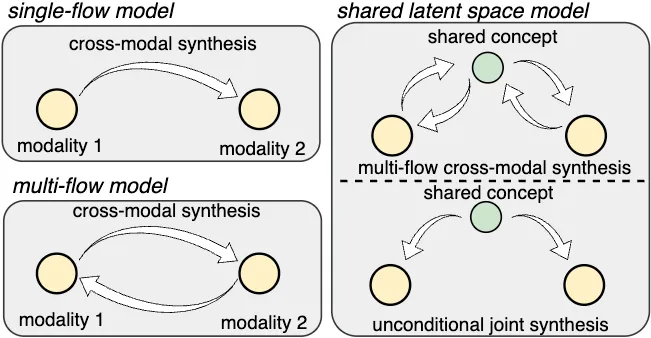 图1:多模态建模范式比较。左:单流和多流模型通常学习模态之间的直接映射。右:共享潜在空间模型学习跨模态的高层语义表示。
2.2 关键创新点
- 架构推理模型(Architectural Inference Model):将每个模态编码为确定性特征,融合成联合表示作为信息瓶颈
- 二阶段扩散先验(Second-stage Diffusion Prior):在共享潜在空间上训练扩散模型,解决先验空洞问题
- 跨模态条件生成:通过随机条件策略支持任意模态子集作为输入
2.3 与现有方法的对比
| 特性 | Product of Experts (PoE) | Mixture of Experts (MoE) | ShaLa |
|---|---|---|---|
| 建模表达性 | ✓ | ✗ | ✓ |
| 跨模态推理 | ✗ | ✓ | ✓ |
| 先验空洞解决 | ✗ | ✗ | ✓ |
三、技术架构 (Technical Architecture)
3.1 整体框架
ShaLa采用两阶段训练策略:
第一阶段:架构推理模型训练
- 每个模态通过独立编码器编码为确定性特征
- 融合函数将所有模态特征融合为
- 条件于融合特征的VAE学习共享潜在变量
第二阶段:扩散先验训练
- 在共享潜在空间上训练DDPM
- 条件于确定性模态特征支持跨模态推理
- 通过随机条件策略增强灵活性
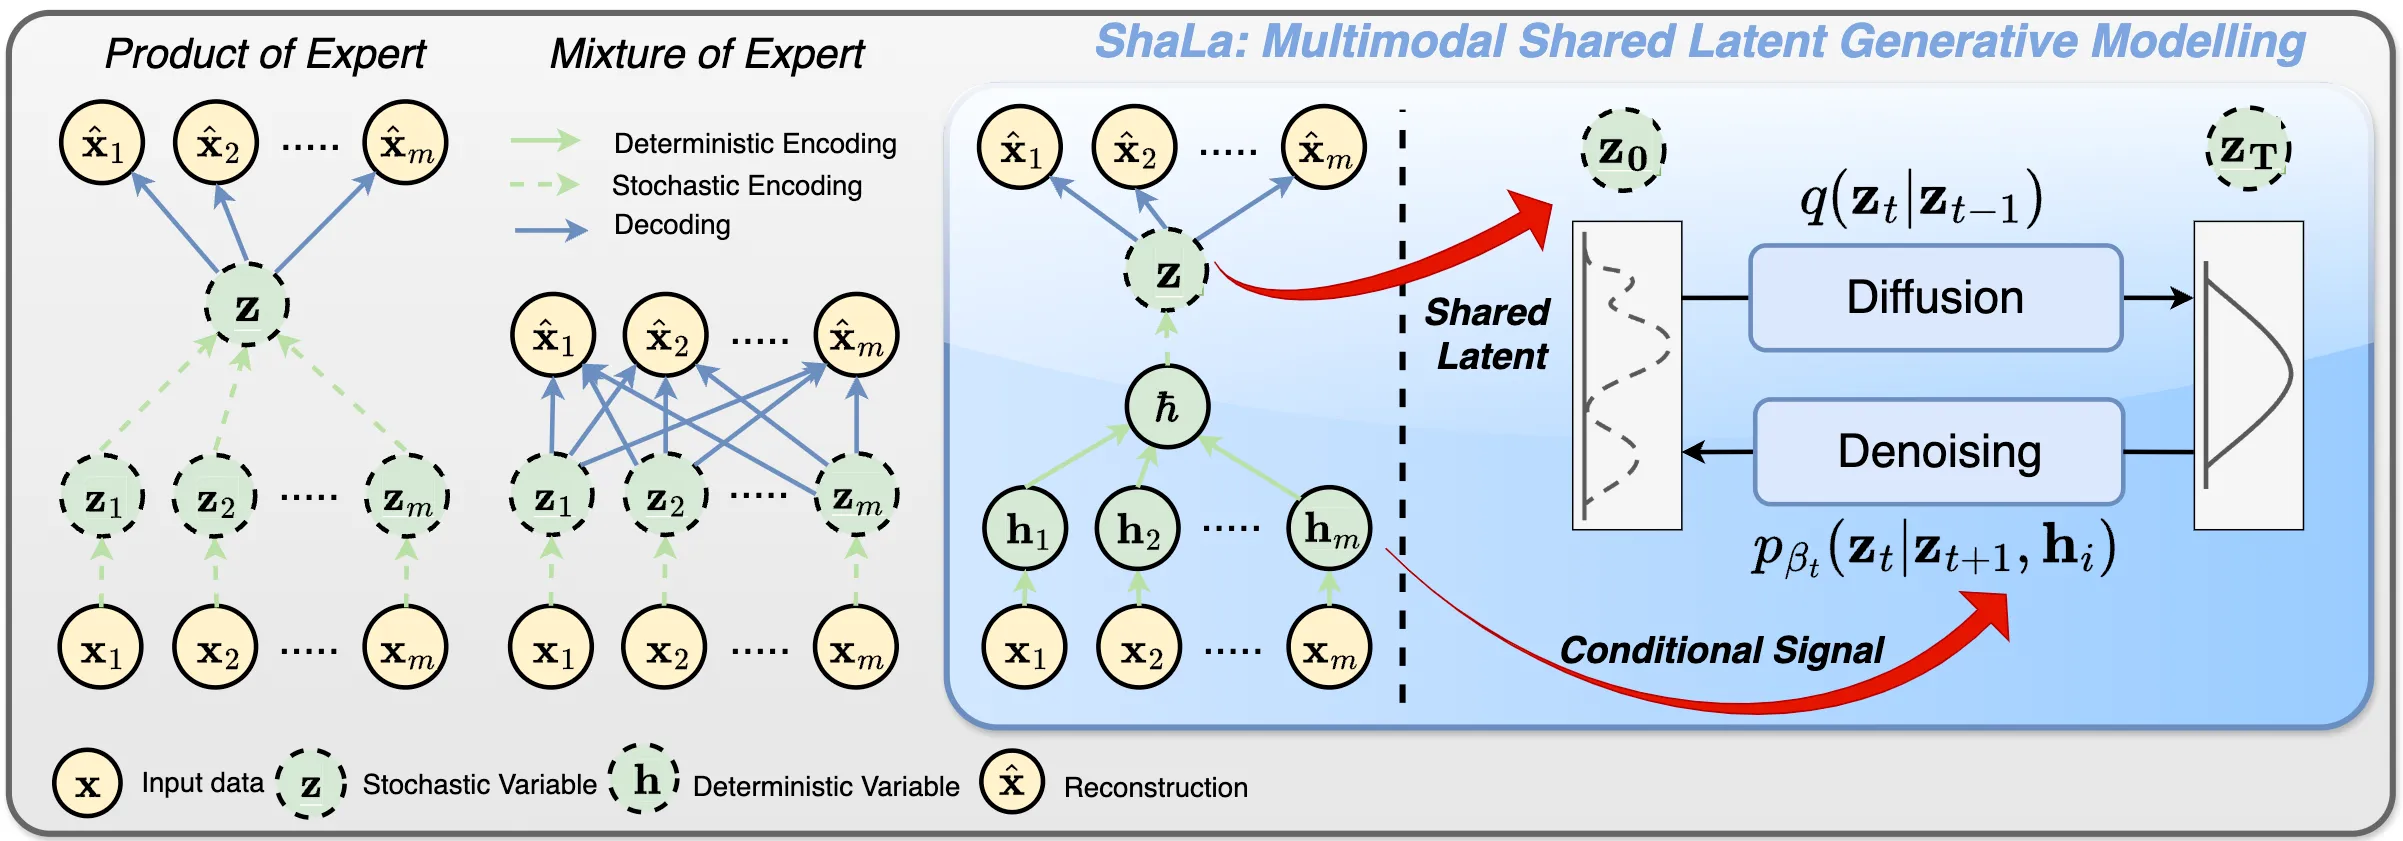 图3:ShaLa架构。左:PoE和MoE模型的局限性。右:ShaLa的架构推理模型和扩散先验设计。
3.2 数学形式化
共享潜在变量模型:
其中 为标准高斯先验。
架构推理过程:
扩散先验(前向过程):
扩散先验(逆向过程):
其中 为随机条件策略。
3.3 实现细节
| 组件 | 实现方式 |
|---|---|
| 编码器 | 多层卷积+下采样 |
| 解码器 | 多层卷积+上采样 |
| 融合函数 | 拼接+4层线性变换 |
| 扩散网络 | Diffusion Transformer |
| 训练设备 | A100 Nvidia GPU |
| 推理开销 | 251 NFE (去噪步骤+解码) |
四、核心创新 (Core Innovations)
4.1 架构推理模型
与PoE和MoE不同,ShaLa采用更直接的方法:
- 确定性特征编码:每个模态编码为确定性表示 ,而非概率分布
- 信息瓶颈:融合表示 作为紧凑的高层语义抽象
- 灵活后验参数化:直接将联合后验参数化为单一条件高斯分布
4.2 二阶段扩散先验
扩散先验的引入带来三大优势:
- 解决先验空洞问题:学习的扩散模型桥接聚合后验与假设先验之间的分布不匹配
- 支持跨模态推理:通过条件于模态特定特征,实现从任意模态子集的推理
- 提升合成质量:扩散模型的表达能力显著提高生成样本的质量
4.3 随机条件策略
训练过程中采用随机条件策略:
- 随机丢弃部分模态的条件信号
- 确保模型学习条件和无条件生成路径
- 通过引导尺度灵活控制条件强度
4.4 潜在校正机制
ShaLa支持从损坏输入中恢复:
- 对异常潜在编码施加K步前向扩散添加噪声
- 通过逆向扩散过程恢复语义一致的生成
- 展示了扩散先验在退化输入设置下的鲁棒推理能力
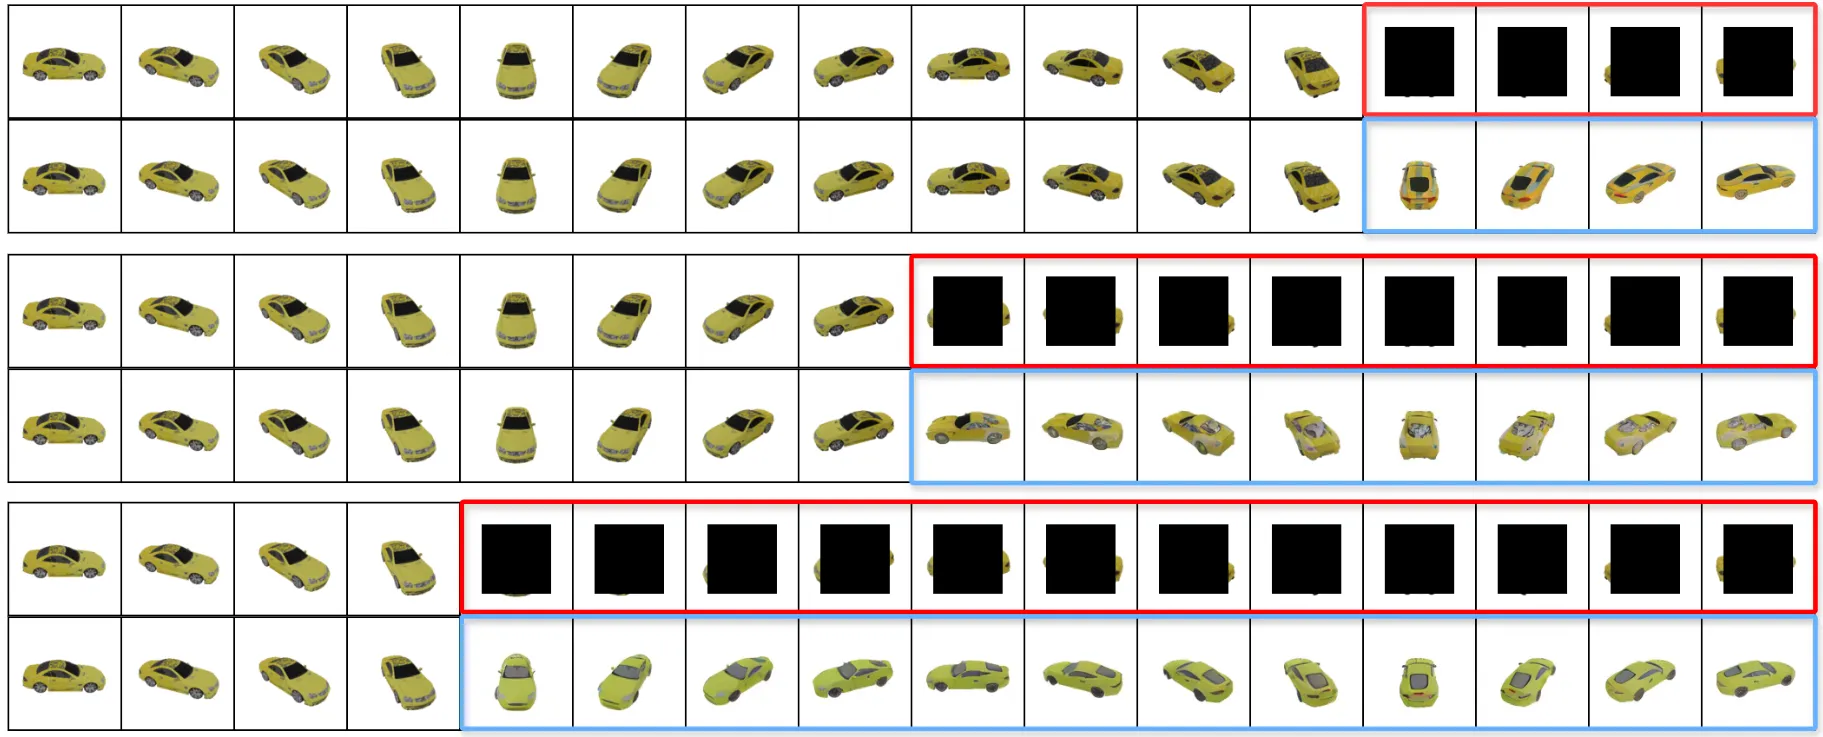 图10:潜在校正。红色框表示损坏的模态,蓝色框表示校正后的结果。
五、实验结果 (Experimental Results)
5.1 数据集与基准
| 数据集 | 说明 | 评估任务 |
|---|---|---|
| PolyMNIST | 多视角MNIST变体 | 联合生成、跨模态推理 |
| MST | MNIST-SVHN-Text | 联合生成、跨模态推理 |
| CUB | Caltech UCSD Birds | 联合生成、跨模态推理、FID评估 |
| ShapeNet | 多视角3D物体 | 新视角合成、风格迁移 |
5.2 基准方法
MVAE, MVTCAE, mmJSD, MoPoE, MMVAE, MMVAE+, CMVAE, MVEBM
5.3 多模态一致性评估
表1:无条件和条件跨模态生成的一致性(↑)
| 方法 | PolyMNIST (无条件) | PolyMNIST (条件) | MST (无条件) | MST (条件) |
|---|---|---|---|---|
| MVAE | 0.008 | 0.298 | 0.12 | 0.27 |
| MVTCAE | 0.003 | 0.591 | - | - |
| mmJSD | 0.060 | 0.778 | - | 0.72 |
| MoPoE | 0.141 | 0.720 | 0.31 | 0.69 |
| MMVAE | 0.232 | 0.844 | 0.28 | 0.68 |
| MMVAE+ | 0.344 | 0.869 | - | - |
| MVEBM | 0.735 | 0.857 | 0.42 | 0.43 |
| CMVAE | 0.781 | 0.897 | - | - |
| ShaLa | 0.815 | 0.897 | 0.44 | 0.75 |
ShaLa在所有基准上均达到最优或可比的一致性分数。
5.4 生成质量评估(FID ↓)
表2:无条件联合和条件跨模态生成的FID
| 方法 | PolyMNIST (无条件) | PolyMNIST (条件) | CUB (条件) |
|---|---|---|---|
| MVAE | 50.65 | 82.59 | 172.21 |
| MVTCAE | 85.43 | 58.98 | 208.43 |
| mmJSD | 179.76 | 178.27 | 262.80 |
| MoPoE | 98.56 | 160.29 | 265.55 |
| MMVAE | 164.29 | 150.83 | 232.20 |
| MMVAE+ | 86.64 | 80.75 | 164.94 |
| MVEBM | - | - | 136.16 |
| CMVAE | 78.52 | 74.53 | 28.00 |
| ShaLa | 47.30 | 40.18 | 25.58 |
ShaLa在所有数据集上均取得最低FID,表明其扩散先验有效解决了先验空洞问题。
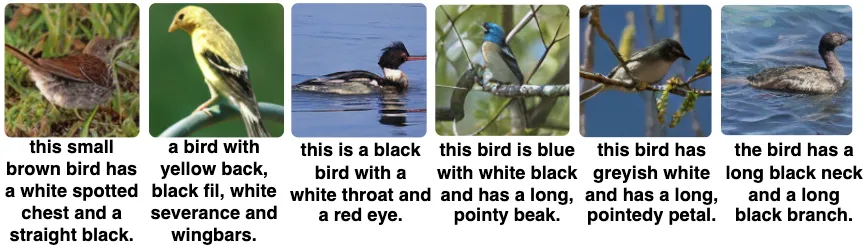 图5:CUB数据集上的联合生成结果
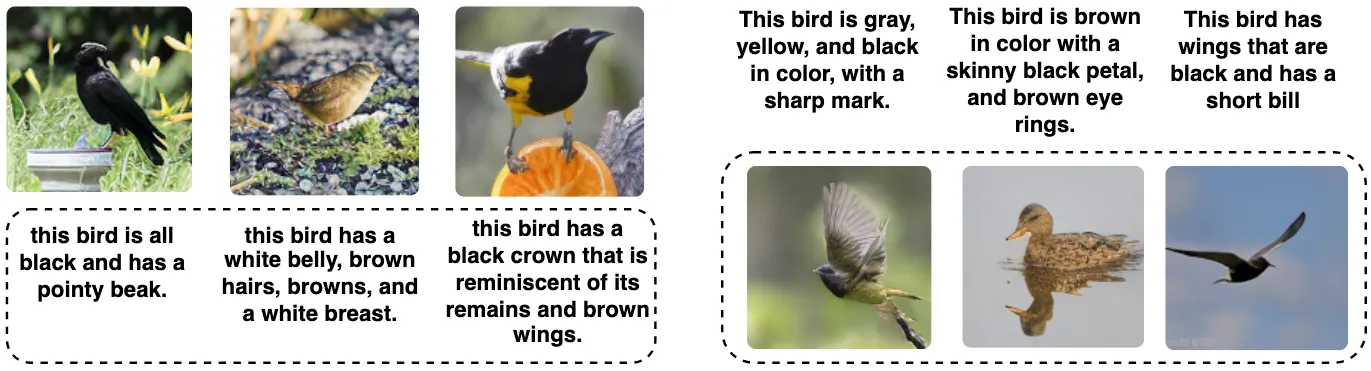 图6:CUB数据集上的跨模态生成结果
5.5 多视角合成评估
表3:新视角合成的PSNR(↑)和SSIM(↑)
| 方法 | PSNR | SSIM |
|---|---|---|
| MMVAE+ | 19.3 | 0.59 |
| CMVAE | 20.5 | 0.64 |
| Px-NeRF | 23.2 | 0.90 |
| EG3D | 21.8 | 0.71 |
| RenderD | 25.4 | 0.81 |
| SyncD | 21.9 | 0.88 |
| ShaLa | 24.7 | 0.89 |
| ShaLa* (256×256) | 22.2 | 0.88 |
ShaLa在共享潜在变量模型中表现最优,与专用3D方法相比也具有竞争力。
表4:不同模态数量下的扩展性
| 视角数 | 方法 | PSNR ↑ | SSIM ↑ |
|---|---|---|---|
| 3 views | ShaLa | 26.4 | 0.94 |
| 3 views | MMVAE+ | 22.5 | 0.67 |
| 3 views | CMVAE | 23.3 | 0.72 |
| 8 views | ShaLa | 25.6 | 0.92 |
| 8 views | MMVAE+ | 20.2 | 0.61 |
| 8 views | CMVAE | 21.8 | 0.68 |
随着模态数量增加,ShaLa保持稳定性能,而基准方法显著退化。
5.6 消融研究
表5:条件信号的影响
| 条件信号 | PolyMNIST (无条件) | PolyMNIST (条件) | MST (无条件) | MST (条件) |
|---|---|---|---|---|
| (原始输入) | 0.584 | 0.612 | 0.23 | 0.35 |
| (确定性特征) | 0.815 | 0.897 | 0.44 | 0.75 |
使用确定性特征作为条件信号显著优于直接使用原始输入。
表6:扩散网络规模的影响
| 参数规模 | 2× #P | 1× #P | 1/2× #P | 1/4× #P |
|---|---|---|---|---|
| 无条件 FID | 45.24 | 47.30 | 50.24 | 56.44 |
| 条件 FID | 37.15 | 40.18 | 45.86 | 49.75 |
增加扩散网络容量持续提升生成质量。
六、相关工作 (Related Work)
6.1 多模态深度生成模型
ShaLa定位于多模态生成模型的研究脉络中:
| 方法类别 | 代表工作 | 特点 | 局限性 |
|---|---|---|---|
| 单流模型 | Stable Diffusion, DALL-E | 特定跨模态映射 | 无法支持多方向推理 |
| 多流模型 | CoDi, NExT-GPT | 多模态输入输出 | 计算复杂度高 |
| 多模态VAE | MVAE, MMVAE, CMVAE | 共享潜在空间 | 推理模型限制/合成质量低 |
| ShaLa | 本文 | 架构推理+扩散先验 | 251 NFE推理开销 |
6.2 多模态VAE发展脉络
MVAE (PoE) → MoPoE → mmJSD
    ↓
MMVAE (MoE) → MMVAE+ → CMVAE
    ↓
MVTCAE → MVEBM
    ↓
ShaLa (架构推理 + 扩散先验)
6.3 潜在扩散模型
- LDM (Rombach et al., 2022):单模态潜在扩散
- DiffusionVAE (Vahdat et al., 2021):二阶段VAE+扩散
- ShaLa:首次将二阶段扩散扩展到多模态共享潜在空间
七、总结 (Conclusion)
7.1 主要贡献
- 新颖框架:提出ShaLa,统一架构推理和扩散模型用于多模态共享潜在空间建模
- 卓越性能:在标准基准上实现最先进的一致性和合成质量
- 可扩展性:成功扩展到16视角的多视角生成任务
7.2 技术优势
- 解决了PoE和MoE的表达性与跨模态推理权衡问题
- 通过扩散先验有效缓解先验空洞问题
- 随机条件策略支持灵活的模态组合
7.3 局限性
| 局限性 | 说明 |
|---|---|
| 细粒度控制 | 共享潜在变量难以实现局部或高频细节控制 |
| 推理开销 | 需要251次函数评估(NFE),远高于单步VAE解码 |
| 未见模态泛化 | 训练于固定模态集,不支持零样本模态迁移 |
7.4 未来方向
- 探索更高效的扩散采样策略降低推理开销
- 引入模态无关嵌入支持开放模态设置
- 结合元学习策略提升未见模态泛化能力
八、参考资源 (Resources)
8.1 论文链接
- arXiv: https://arxiv.org/abs/2508.17376
- PDF: https://arxiv.org/pdf/2508.17376
- HTML: https://arxiv.org/html/2508.17376v1
8.2 关键术语表
| 术语 | 英文 | 说明 |
|---|---|---|
| 共享潜在空间 | Shared Latent Space | 跨模态共享的低维语义表示空间 |
| 先验空洞问题 | Prior-hole Problem | 聚合后验与固定先验的分布不匹配 |
| 乘积专家 | Product of Experts (PoE) | 通过模态后验乘积构建联合后验 |
| 混合专家 | Mixture of Experts (MoE) | 通过模态后验平均构建联合后验 |
| 架构推理 | Architectural Inference | 直接从融合特征参数化联合后验 |
| 扩散先验 | Diffusion Prior | 基于扩散模型的灵活先验分布 |
| 随机条件 | Random Conditioning | 训练时随机丢弃条件信号的策略 |
8.3 核心算法
Algorithm 1: ShaLa训练算法
输入: 多模态数据集 D = {X_i}, 模态数 M
输出: 训练好的推理模型 φ, 解码器 θ, 扩散先验 β

// 第一阶段:架构推理模型
for each batch in D:
    for each modality m in 1..M:
        h_m = Encoder_m(x_m)           // 编码为确定性特征
    ℏ = Fusion(h_1, ..., h_M)           // 融合特征
    z ~ N(μ_φ(ℏ), V_φ(ℏ))              // 采样潜在变量
    更新 φ, θ 以最小化重构损失 + KL散度

// 第二阶段:扩散先验
for each batch in D:
    z_0 ~ q_φ(z)                         // 从聚合后验采样
    t ~ Uniform(1, T)                    // 随机时间步
    ε ~ N(0, I)                          // 随机噪声
    j ~ Uniform(1, M)                    // 随机选择条件模态
    更新 β 以最小化去噪损失
8.4 下载的图表
| 文件名 | 说明 |
|---|---|
fig1_illustration.png | 多模态建模范式比较 |
fig3_architecture.jpg | ShaLa架构详解 |
fig6_cub_joint.jpg | CUB联合生成结果 |
fig7_cross_cub.jpg | CUB跨模态生成结果 |
fig7_style_transfer.png | 多视角风格迁移示例 |
fig10_inpainting.jpg | 潜在校正机制 |
fig11_polymnist.png | PolyMNIST联合生成 |
fig13_uncond_car.png | ShapeNet无条件生成 |
fig14_cross_car.jpg | ShapeNet跨视角生成 |
分析完成时间: 2025-05-30 分析工具: Claude Code