TMA-Adaptive FP8 Grouped GEMM: Eliminating Padding
消除 Hopper GPU 上低精度训练和推理的填充需求
TMA-Adaptive FP8 Grouped GEMM: Eliminating Padding Requirements in Low-Precision Training and Inference on Hopper
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | TMA-Adaptive FP8 Grouped GEMM: Eliminating Padding Requirements in Low-Precision Training and Inference on Hopper |
| 作者 | 未在摘要中明确列出 |
| 机构 | 上海市科技重大项目支持 |
| 论文 | arXiv:2508.16584 |
| 代码 | 匿名开源仓库 |
| 发布 | 2025年8月 |
| 许可 | 未明确 |
| 硬件平台 | NVIDIA H800 GPU |
二、核心思想
问题定义
当前的 FP8 Grouped GEMM 实现要求将每个组填充到固定对齐(如 128),导致内存和计算开销。这在 Mixture-of-Experts (MoE) 架构中尤为突出,因为动态组大小来自 top-k 路由选择的可变序列长度。
关键挑战:
- 静态 TMA 描述符限制: TMA 描述符是静态配置的,无法处理可变维度
- 内存边界不对齐: 16 字节全局内存对齐和 128 字节共享内存对齐要求
- 填充开销: 填充操作消耗额外内存和计算
解决方案概述
本文提出 TMA-Adaptive FP8 Grouped GEMM,通过以下两个关键创新消除填充:
- TMA 描述符池: 使用 log₂(block_M) 个预配置描述符,通过动态运行时选择处理所有残差行情况
- TMA 对齐感知管理: 满足 16 字节全局内存对齐和 128 字节共享内存对齐要求
核心性能
- 加速: 1.7% - 20.4% 端到端加速
- 内存节省: 最高 23.8% 内存减少
- 数值等价: 有效数据完全位级等价
三、技术架构
整体框架
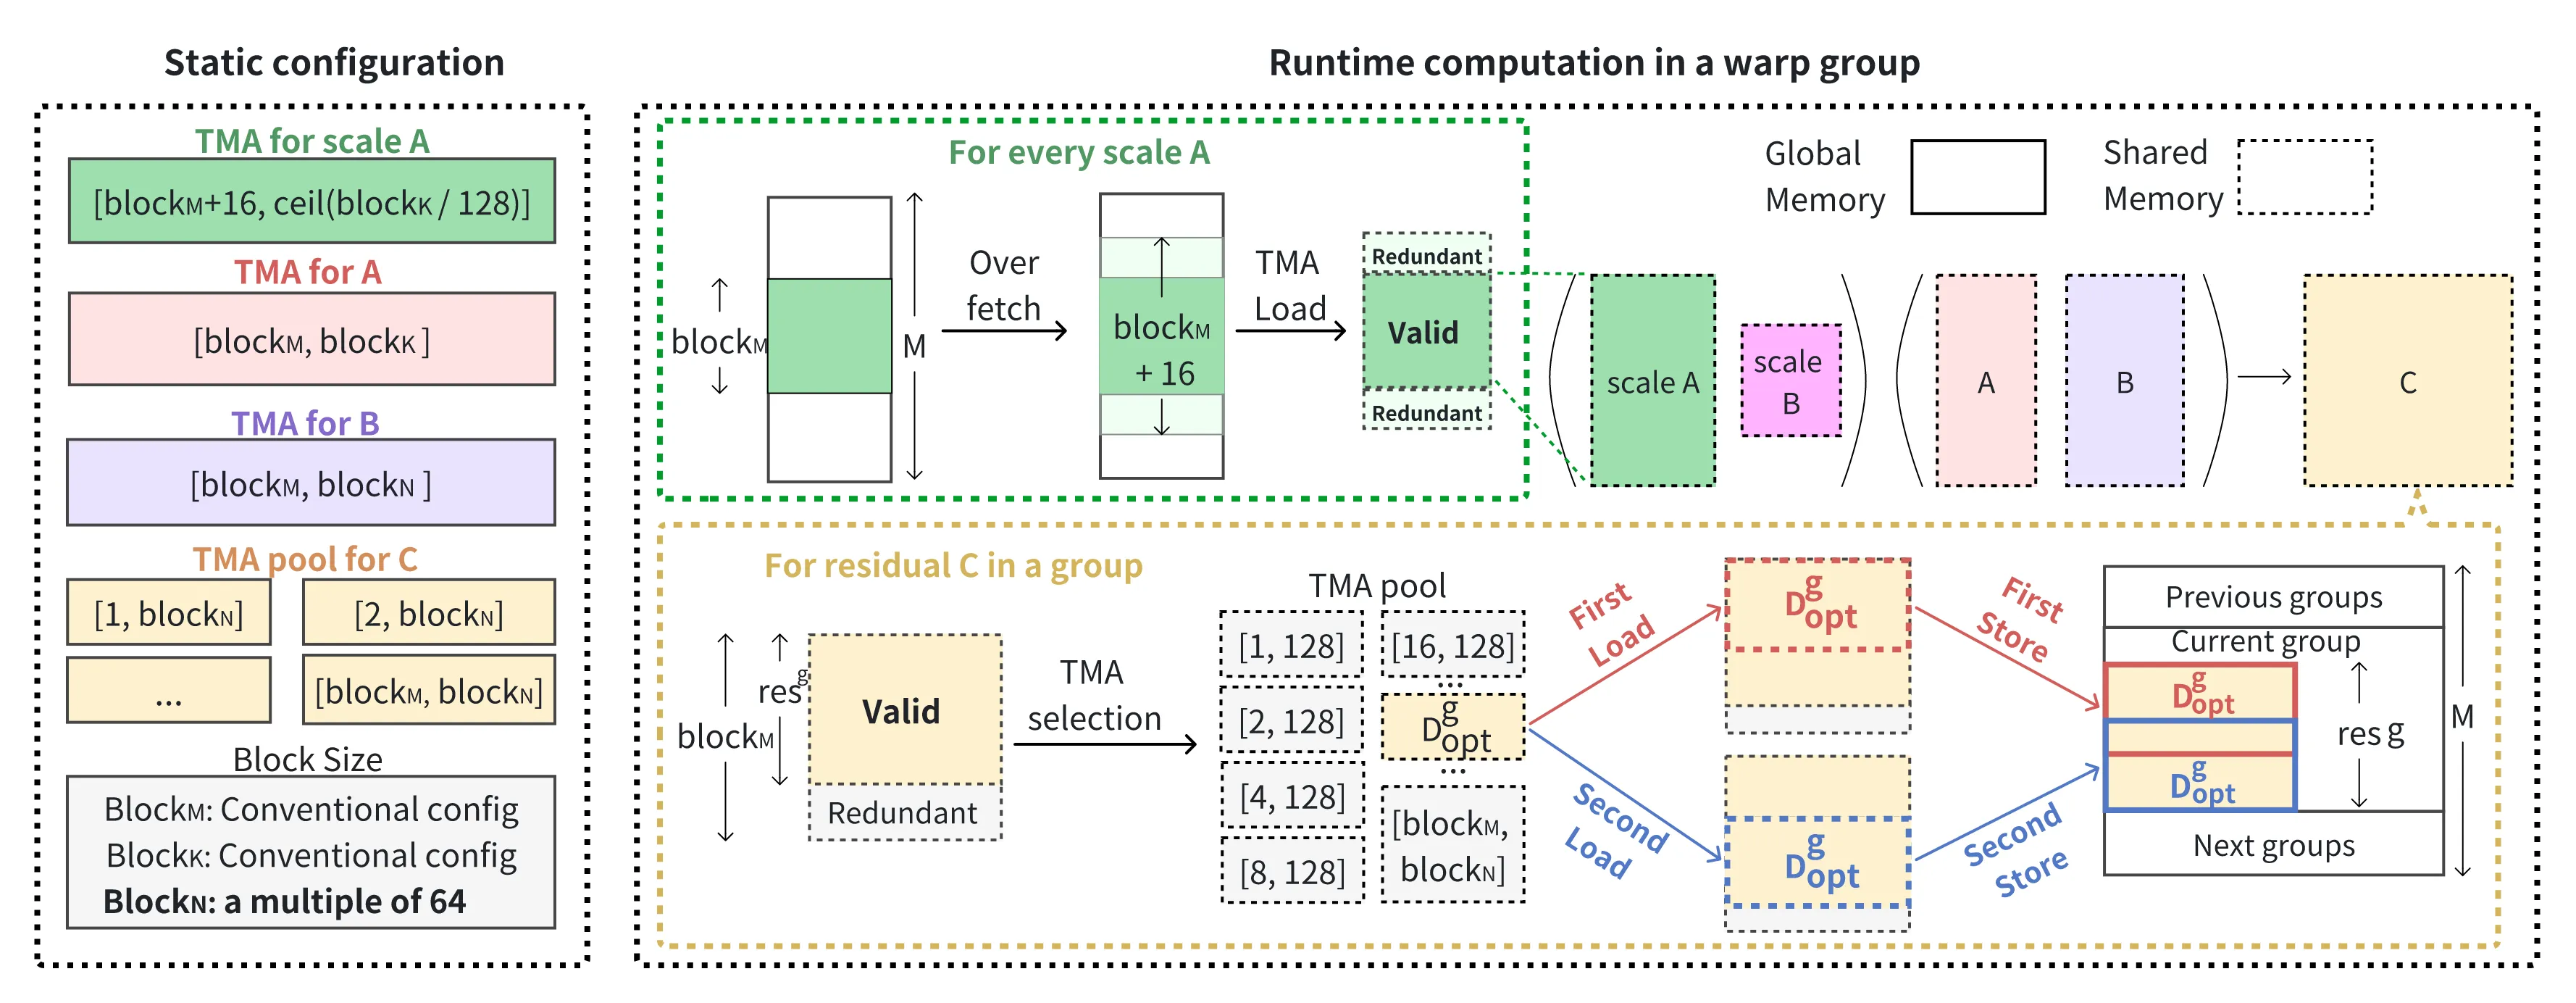
Figure 1: TMA-Adaptive FP8 Grouped GEMM 框架
左侧(静态配置):
- TMA 描述符池用于矩阵 C
- N 维度的 block 大小约束
右侧(运行时计算):
- Warp group 内的运行时计算
- 关键创新 1(绿色):矩阵 A 缩放块的全局内存预取
- 关键创新 2(黄色):矩阵 C 残差元素的动态描述符选择与两阶段加载-存储
核心公式
Grouped GEMM 定义:
对于 G 个组,每个组 g 的计算:
其中:
- :组 g 的左矩阵
- :组 g 的右矩阵
- :组 g 的输出矩阵
- :组 g 的可变行维度
填充问题: 传统方法要求 被填充到 block_M 的倍数(如 128),导致:
TMA 描述符池
关键创新:使用 log₂(block_M) 个预配置描述符覆盖所有残差情况
描述符配置:
- 描述符 0: 处理残差大小 1
- 描述符 1: 处理残差大小 2
- 描述符 2: 处理残差大小 4
- …
- 描述符 k: 处理残差大小 2^k
动态选择: 运行时根据实际残差大小选择合适的描述符,无需填充。
两阶段加载-存储
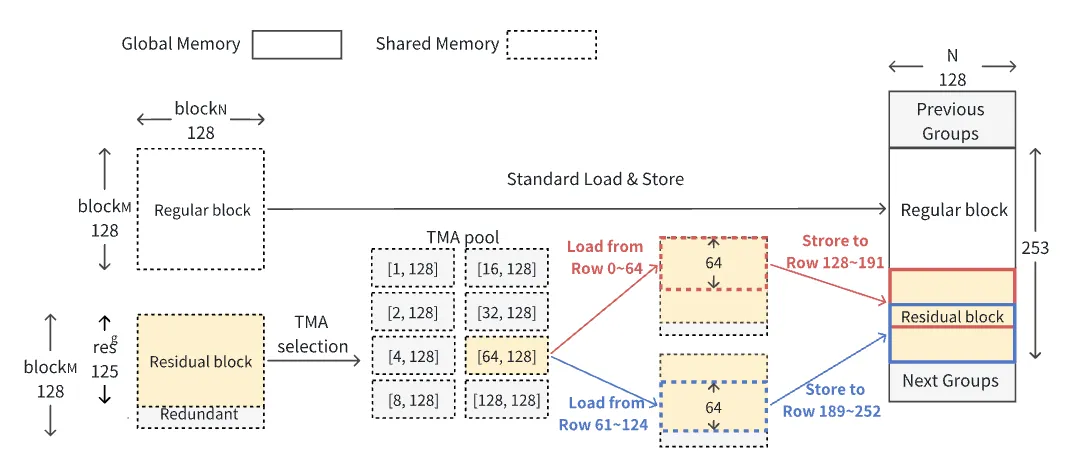
Figure 3: TMA 运行时选择和两阶段加载-存储操作示例
配置: ,
阶段 1:加载完整块
- 使用标准 TMA 描述符加载完整的 block_M 行
- 处理 行
阶段 2:处理残差
- 使用动态选择的描述符加载残差行
- 处理 行
TMA 对齐感知管理
全局内存对齐:16 字节
- 确保 TMA 操作的起始地址满足 16 字节对齐
共享内存对齐:128 字节
- 确保共享内存中的数据布局满足 128 字节对齐
Block N 约束:
- 限制为 64 的倍数(如 64, 128, 192)
- 这些值在实践中是 N 维度的最优或近最优配置
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| TMA 描述符池 | log₂(block_M) 个预配置描述符 | 覆盖所有残差情况,最小开销 |
| 动态描述符选择 | 运行时选择合适描述符 | 无需填充即可处理可变维度 |
| 两阶段加载-存储 | 完整块 + 残差分别处理 | 全面覆盖,高效执行 |
| 对齐感知管理 | 16 字节全局 + 128 字节共享对齐 | 满足硬件要求 |
| Block N 约束 | 限制为 64 的倍数 | 实践最优配置 |
五、实验结果
实验设置
平台:
- NVIDIA H800 GPU
- PyTorch 2.6.0
- CUDA 12.6
参数空间:
- N, K ∈ {3072, 4096, 5120, 6144, 7168, 8192}
- 组数 ∈ {4, 8, 16, 32}
- 序列长度 M ∈ {8192, 16384, 32768, 65536}
- 每个组维度 随机生成
基线:
- 显式输入填充 + DeepGEMM(当前最先进的高性能 FP8 GEMM 实现)
性能分析
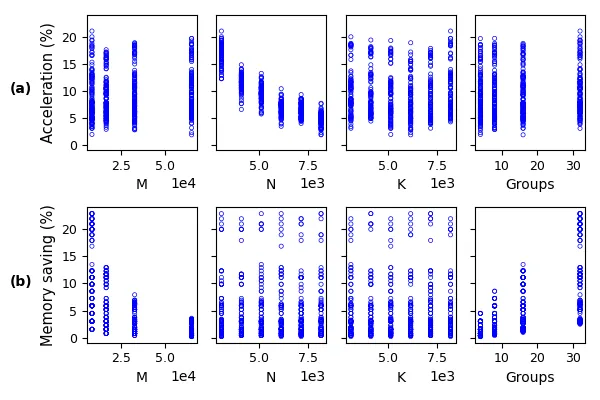
Figure 2: 优化实现与基线实现的性能对比
加速比:
- 范围:1.7% - 20.4%
- 随组数增加而提升
- 随序列长度增加而提升
内存节省:
- 最高 23.8% 内存减少
- 消除了填充操作的内存开销
数值等价性
验证结果:
- 有效数据完全位级等价
- 无精度损失
- 保持原始数据的数值准确性
关键发现
| 发现 | 详情 |
|---|---|
| 加速来源 | 消除填充操作 + 减少计算量 |
| 内存节省 | 消除填充矩阵的存储 |
| 适用场景 | MoE 架构中的动态路由 |
| 兼容性 | 即插即用,无需修改内核 |
六、与现有方法对比
| 方法 | 填充需求 | 内存开销 | 计算开销 | 精度 |
|---|---|---|---|---|
| TMA-Adaptive | 无 | 最小 | 最小 | 完全等价 |
| 填充 + DeepGEMM | 128 对齐 | 高 | 高 | 完全等价 |
| 标准 Grouped GEMM | 128 对齐 | 高 | 高 | 完全等价 |
TMA-Adaptive 优势:
- 消除填充需求
- 减少内存占用
- 提高计算效率
- 保持数值等价
七、总结
核心贡献
- TMA 描述符池: 使用 log₂(block_M) 个预配置描述符覆盖所有残差情况
- 动态描述符选择: 运行时选择合适描述符,无需填充
- 两阶段加载-存储: 完整块 + 残差分别处理
- 对齐感知管理: 满足硬件对齐要求
- 开源实现: 匿名仓库提供可复现代码
技术影响
- MoE 架构: 直接增强 MoE 模型的训练和推理效率
- 动态路由: 支持动态路由的即插即用兼容性
- 内存优化: 最高 23.8% 内存减少
- 计算加速: 1.7% - 20.4% 端到端加速
局限性
- Block N 限制为 64 的倍数
- 仅针对 FP8 精度
- 需要 Hopper 架构支持
适用场景
- Mixture-of-Experts (MoE) 架构
- 动态序列长度的 Grouped GEMM
- 低精度训练和推理
- 内存受限场景
八、参考资源
- 论文: arXiv:2508.16584
- PDF: arXiv PDF
- HTML: arXiv HTML
- 硬件: NVIDIA H800 GPU (Hopper)
- 软件: PyTorch 2.6.0, CUDA 12.6
- 相关工作: DeepGEMM, TMA (Tensor Memory Accelerator)