X-MoE: 在HPC平台上实现新兴混合专家架构的可扩展训练
X-MoE是一种新型MoE训练系统,通过无填充训练管道、冗余绕过分发和序列分片MoE块等技术,在AMD GPU上实现DeepSeek风格MoE的高效可扩展训练
X-MoE: 在HPC平台上实现新兴混合专家架构的可扩展训练
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | X-MoE: Enabling Scalable Training for Emerging Mixture-of-Experts Architectures on HPC Platforms |
| 作者 | Yueming Yuan, Ahan Gupta, Jianping Li, Sajal Dash, Feiyi Wang, Minjia Zhang |
| 机构 | UIUC (伊利诺伊大学厄巴纳-香槟分校), Oak Ridge National Laboratory (橡树岭国家实验室) |
| 论文 | arXiv:2508.13337 |
| 代码 | GitHub: Supercomputing-System-AI-Lab/X-MoE |
| 发布 | 2025年8月18日 |
| 许可 | CC BY 4.0 |
| 会议 | SC 2025 (国际高性能计算会议) |
二、核心思想
问题定义
随着大语言模型(LLM)的发展,混合专家(Mixture-of-Experts, MoE)架构因其能够实现亚线性计算与模型参数的关系而成为降低训练成本的关键技术。特别是以DeepSeek-MoE为代表的专家专业化MoE架构,通过细粒度专家分割和大top-k路由实现了更强的专家特化能力。
然而,训练这类新兴MoE架构面临三大挑战:
- 缺乏高效的跨平台内核:现有MoE训练系统(如DeepSpeed-MoE、Tutel)严重依赖CUDA特定实现,在非NVIDIA平台(如AMD GPU)上效率低下,难以移植
- 内存瓶颈转移:专家专业化MoE将内存瓶颈从模型参数转移到了激活内存,特别是dispatch和combine阶段的激活张量
- 昂贵的All-to-All通信:在具有异构和层次化网络的HPC平台上,All-to-All通信成本极高
解决方案概述
X-MoE提出了一套系统级优化技术来解决上述挑战:
- 无填充稀疏MoE训练管道(PFT):设计新的稀疏数据结构,消除零填充带来的内存和通信开销
- 冗余绕过分发(RBD):利用HPC系统的拓扑感知,通过层次化两阶段分发算法减少通信冗余
- 序列分片MoE块(SSMB):在MoE块中实现序列分片,解决激活内存瓶颈
三、技术架构
整体框架图
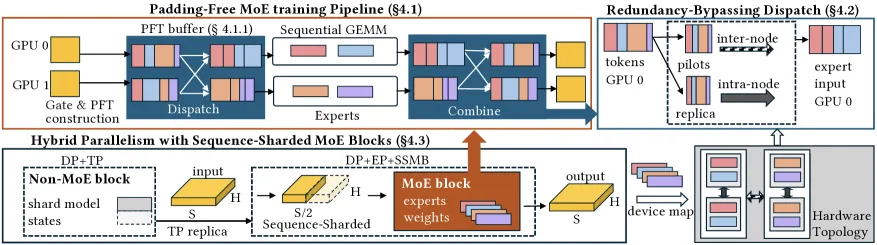
X-MoE的整体架构如上图所示,包含三个核心组件:
- PFT (Padding-Free Token buffers):无填充的稀疏数据结构,消除零填充
- RBD (Redundancy-Bypassing Dispatch):层次化冗余绕过分发,减少跨节点通信
- SSMB (Sequence-Sharded MoE Blocks):序列分片MoE块,解决激活内存瓶颈
核心公式
专家专业化MoE的激活内存分析:
在专家专业化MoE中,激活内存主要由以下张量决定:
其中:
- :序列长度
- :top-k路由因子
- :隐藏维度
- :细粒度因子(专家数量相对于标准MoE的倍数)
PFT复杂度分析:
标准GShard风格的dispatching策略内存复杂度为:
其中是专家数量,是固定容量,是隐藏维度。
PFT策略的内存复杂度降低为:
其中是实际路由的token数量()。
Redundancy Rate分析:
对于每个token的个目标专家,如果多个专家位于同一节点,会产生通信冗余。冗余率定义为:
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| PFT数据结构 | 无填充token缓冲区,包含token_ids、expert_ids、num_ids等ERI数组 | 消除零填充,仅存储有效token |
| Triton内核 | 跨平台稀疏和不规则工作负载内核 | 硬件无关,支持合并内存访问 |
| RBD分发器 | 层次化两阶段分发:Pilot token选择 + 本地副本重建 | 减少跨节点通信冗余 |
| SSMB | 序列分片MoE块,在EP工作者间分片输入序列 | 解决激活内存瓶颈 |
训练流程
X-MoE的训练流程如下:
- PFT构建:将top_experts数组展平和排序,构建token_ids和expert_ids数组
- 无填充Gating:使用PFT格式进行门控计算,避免构造dispatch_mask
- 无填充Dispatch:使用PFT直接dispatch,无需零填充
- RBD分发:
- Stage 0 (S0):Pilot token选择和实例化
- Stage 1 (S1):本地副本重建
- 专家计算:使用顺序GEMM处理不均匀token缓冲区
- 无填充Combine:使用PFT进行combine操作
- SSMB执行:在MoE块中使用序列分片执行
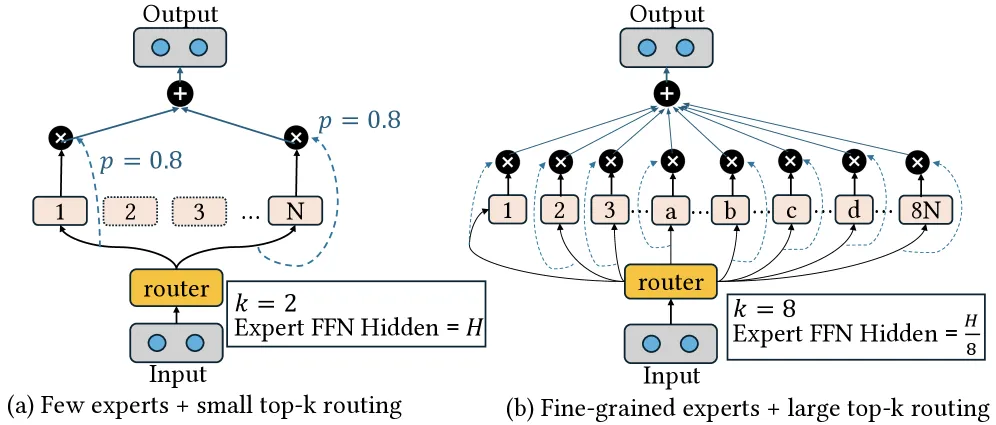
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| PFT (Padding-Free Token buffers) | 设计新的稀疏数据结构,消除MoE训练中的零填充 | 内存节省70%+,通信量减少50%+ |
| Triton跨平台内核 | 设计硬件无关的稀疏和不规则内核 | 支持AMD和NVIDIA GPU,无需CUDA特定代码 |
| RBD (Redundancy-Bypassing Dispatch) | 层次化两阶段分发算法,减少跨节点通信冗余 | 分发延迟降低30%+ |
| SSMB (Sequence-Sharded MoE Blocks) | 在MoE块中实现序列分片,解决激活内存瓶颈 | 内存使用降低,支持更大模型训练 |
| 拓扑感知并行策略 | 结合EP-first和DP-first策略,优化HPC平台上的通信 | 在Frontier超级计算机上验证 |
五、实验结果
基准测试
评估平台: Frontier超级计算机(AMD MI250X GPU)
模型配置:
| 模型 | 序列长度 | H_model | H_FFN | 专家数 | top-k | 层数 | 参数量 | 激活参数 |
|---|---|---|---|---|---|---|---|---|
| Small | 2048 | 2048 | 1408 | 64 | 6 | 28 | 10.1B | 1.3B |
| Medium | 4096 | 5120 | 1536 | 128 | 6 | 28 | 55.2B | 5.2B |
| Large | 4096 | 7168 | 2048 | 256 | 8 | 28 | 201.4B | 11.5B |
| Super | 4096 | 7168 | 2560 | 256 | 8 | 61 | 545.4B | 28.7B |
主要结果:
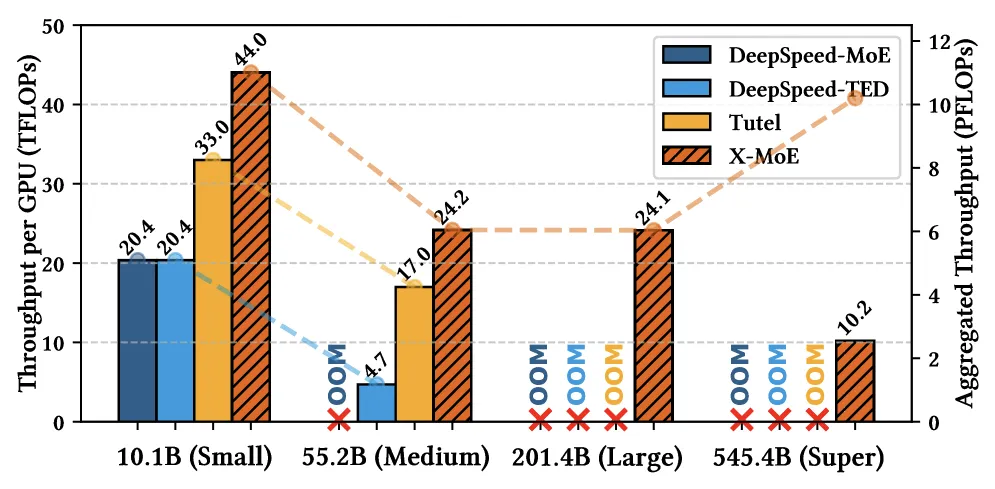
- X-MoE在256 GPU上成功训练Small (10.1B)、Medium (55.2B)和Large (201B)模型
- 在Medium模型上,X-MoE相比DeepSpeed-TED和Tutel分别实现5.15x和1.42x加速
- X-MoE在1024 GPU上成功训练Super (545B)模型,比现有方法可训练模型大10倍
消融实验
PFT效果分析:
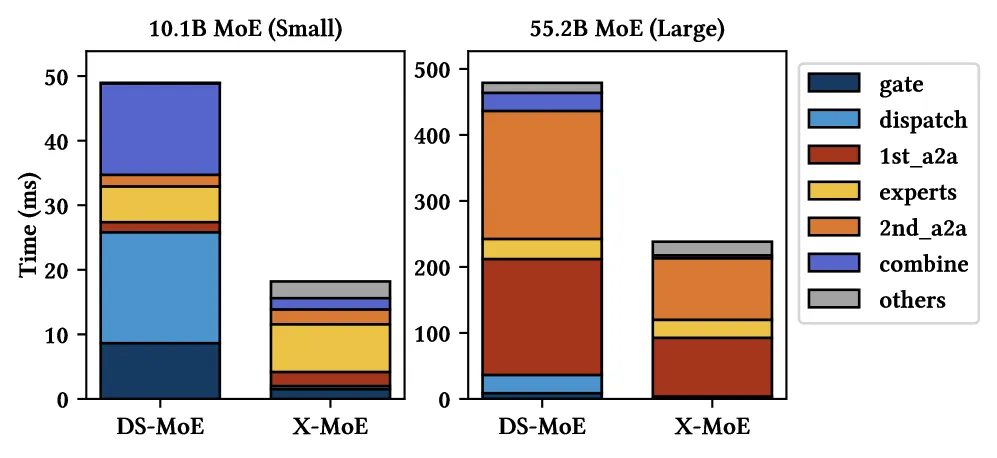
- 在Small模型上,X-MoE的gating、buffer dispatch和buffer combine阶段分别加速5.7x、35.7x和8.1x
- 整体layer时间减少62.3%
- 在Large模型上,All-to-All时间减少50.7%
RBD效果分析:
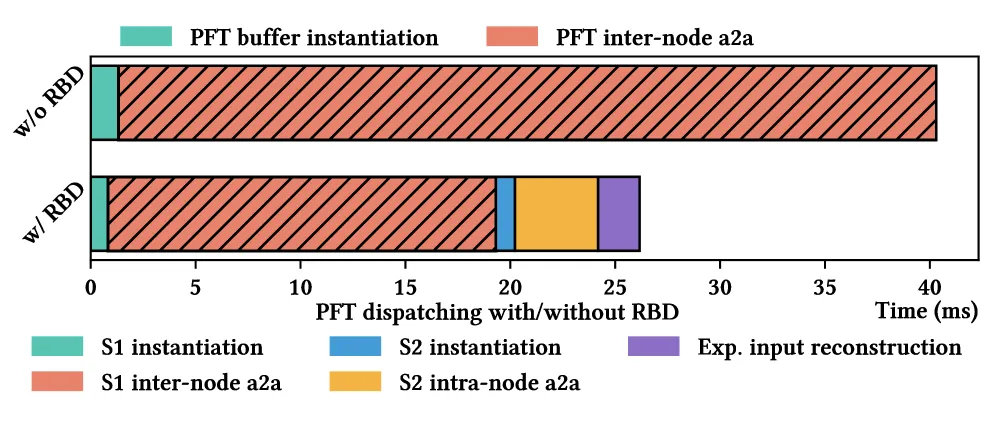
- RBD通过层次化分发减少跨节点通信冗余
- 在大规模训练中显著降低分发延迟
SSMB效果分析:
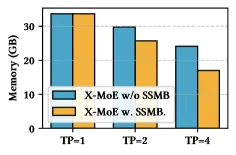
- SSMB在不同TP度数下均显著降低内存使用
- 相比激活重计算,SSMB在相似内存节省下实现更高吞吐量
与现有方法对比
跨平台性能对比(8x NVIDIA A100 40GB GPU):
| 模型配置 | DeepSpeed-MoE | Tutel | X-MoE |
|---|---|---|---|
| Small (s=2048, l=28) | OOM | OOM | 46.87 TFLOPS |
| Small-SR (s=1024, l=28) | 27.08 TFLOPS | 28.26 TFLOPS | 27.33 TFLOPS |
| Small-LR (s=2048, l=14) | 52.15 TFLOPS | 64.00 TFLOPS | 62.51 TFLOPS |
- 在完整配置下,DeepSpeed-MoE和Tutel均OOM,X-MoE成功训练
- 在减小配置下,X-MoE与现有方法性能相当,但内存效率更高
实现验证:
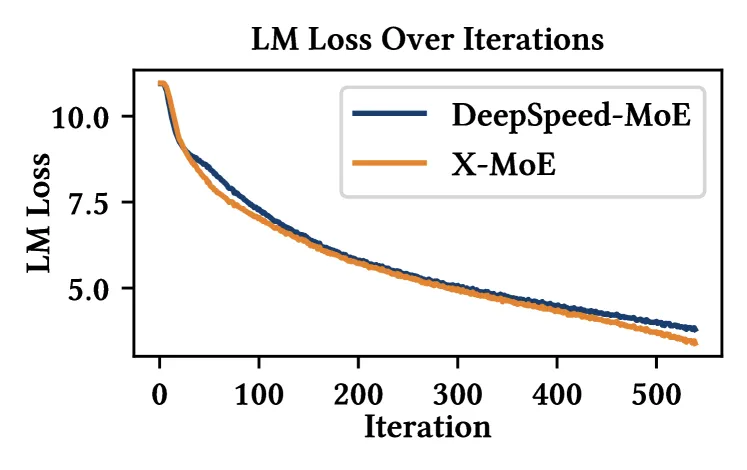
- X-MoE与DeepSpeed-MoE的训练loss曲线紧密跟踪
- 微小差异源于token dropping逻辑的不同
六、相关工作
MoE推理框架
- SGLang、vLLM、TensorRT-LLM:通用推理框架,可服务MoE,但存在padding问题或仅支持小规模MoE
- FlashInfer:vLLM的后端,提供硬件无关的Triton内核,但仅支持最多7B参数的MoE
高效通信原语
- DeepEP:DeepSeek的开源EP实现,仅支持NVIDIA Hopper GPU
- TCCL:修改NCCL以优化PCIe GPU集群的ring-based集合通信
- Centauri:自动化调度计算-通信重叠
MoE训练框架
- DeepSpeed-MoE:微软的MoE训练框架,支持大规模MoE训练
- DeepSpeed-TED:支持Tensor-Expert-Data并行
- Tutel:自适应MoE训练框架
- MegaBlocks:高效稀疏训练框架
X-MoE的区别
X-MoE专注于系统级优化,使专家专业化MoE能够在非NVIDIA平台上进行可扩展训练,填补了这一领域的空白。
七、总结
核心贡献
- PFT数据结构:设计了无填充的稀疏数据结构,消除了MoE训练中的零填充,显著降低内存和通信开销
- Triton跨平台内核:实现了硬件无关的稀疏和不规则内核,支持AMD和NVIDIA GPU
- RBD分发算法:提出了层次化冗余绕过分发算法,减少了跨节点通信冗余
- SSMB并行策略:设计了序列分片MoE块,解决了专家专业化MoE的激活内存瓶颈
- 系统实现与验证:在Frontier超级计算机上实现了X-MoE,成功训练545B参数的MoE模型
技术影响
- 打破NVIDIA垄断:X-MoE首次在AMD GPU上实现了大规模专家专业化MoE的高效训练
- 推动HPC+AI融合:为在HPC平台上训练超大规模MoE提供了系统蓝图
- 促进MoE架构发展:使DeepSeek风格的专家专业化MoE能够在更多硬件平台上训练
局限性
- 仅验证于AMD GPU:虽然设计为跨平台,但主要实验在AMD MI250X上进行
- 未涉及推理优化:X-MoE专注于训练,未涉及MoE推理优化
- 特定网络拓扑:RBD优化针对Frontier的Slingshot网络,其他网络拓扑可能需要调整
- 未与DeepEP对比:由于DeepEP仅支持NVIDIA Hopper,无法直接对比
八、参考资源
- 论文: arXiv:2508.13337
- 代码: GitHub: Supercomputing-System-AI-Lab/X-MoE
- Frontier超级计算机: ORNL Frontier
- DeepSpeed-MoE: Microsoft DeepSpeed
- Tutel: GitHub: microsoft/tutel
- DeepSeek-MoE: arXiv:2401.06066