Fewer Denoising Steps or Cheaper Per-Step Inference: Towards Compute-Optimal Diffusion Model Deployment
PostDiff:免训练扩散模型压缩框架,通过混合分辨率去噪和混合模块缓存降低单步推理成本
Fewer Denoising Steps or Cheaper Per-Step Inference: Towards Compute-Optimal Diffusion Model Deployment
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Fewer Denoising Steps or Cheaper Per-Step Inference: Towards Compute-Optimal Diffusion Model Deployment |
| 作者 | Zhenbang Du, Yonggan Fu, Lifu Wang, Jiayi Qian, Xiao Luo, Yingyan (Celine) Lin |
| 论文 | arXiv:2508.06160 |
| 发布 | 2025-08-08 |
| 主题 | cs.CV (Computer Vision and Pattern Recognition) |
二、核心思想
问题定义
扩散模型在生成任务中表现出色,但其高计算需求限制了在资源受限平台上的部署。本文研究一个关键问题:
在后训练(post-training)设置下(不进行微调),减少去噪步数 vs 降低单步推理成本,哪种策略更有效?
解决方案概述
PostDiff是一个免训练的扩散模型压缩框架,从两个维度降低预训练扩散模型的单步推理成本:
-
输入级:混合分辨率去噪(Mixed-Resolution Denoising)
- 早期去噪步使用低分辨率,后期切换到高分辨率
- 利用低频分量主导早期去噪步的观察
- 实现精度和效率的双赢
-
模块级:混合模块缓存(Hybrid Module Caching)
- 结合DeepCache和交叉注意力缓存
- 跨步复用特征图,减少冗余计算
核心发现
- 降低单步推理成本通常比减少去噪步数更有效,能在保持高生成质量的同时提升效率
- PostDiff推进了SOTA扩散模型的精度-效率前沿
三、技术架构
整体框架图
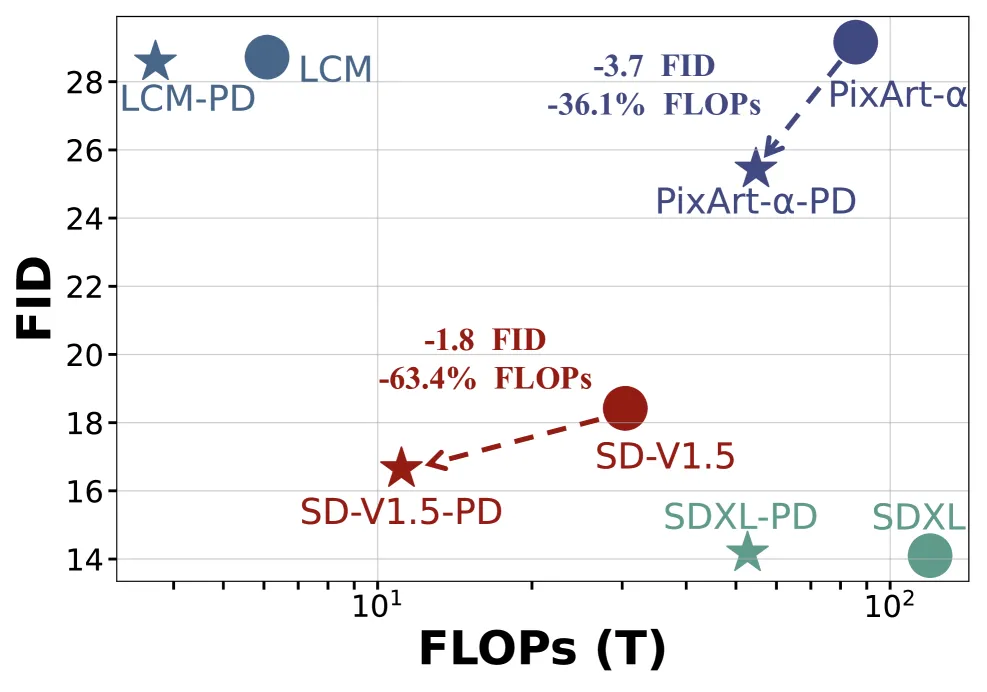
Figure 1: 将PostDiff应用于SOTA扩散模型,“-PD”表示由PostDiff交付的模型。
混合分辨率去噪
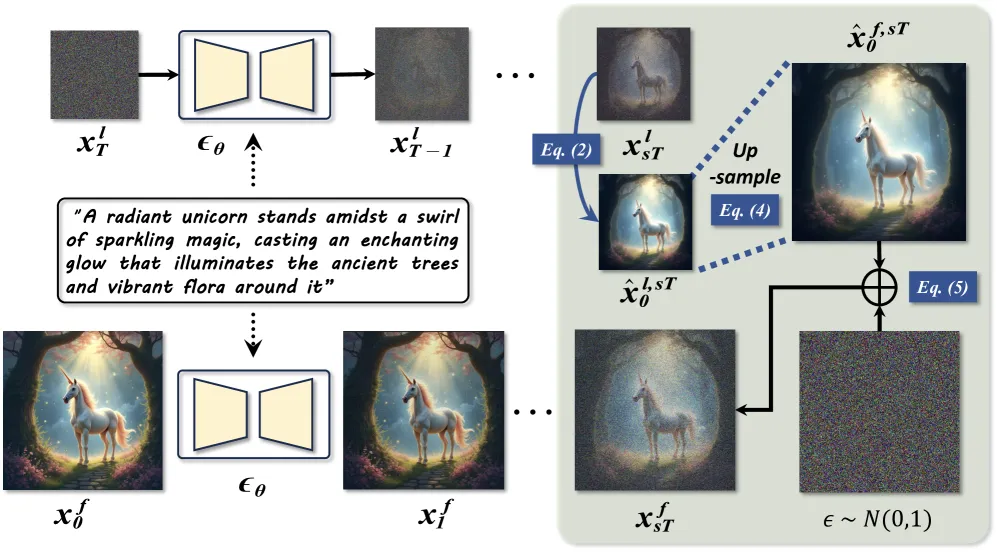
Figure 2: 混合分辨率去噪策略示意图。
核心公式
标准去噪过程:
给定形状为 的图像,从形状为 的高斯噪声 开始:
其中 是预测噪声的模型, 是控制前向噪声添加过程的系数。
混合分辨率去噪:
引入低分辨率潜在表示 ,形状为 ,其中 是分辨率缩放超参数。
-
在低分辨率下执行前 步去噪:
-
上采样到全分辨率:
-
在全分辨率下执行剩余去噪步。
交叉注意力缓存策略:
四种设计选择:
- Ave:
- Cond:
- Uncond:
- CFG:
动机分析
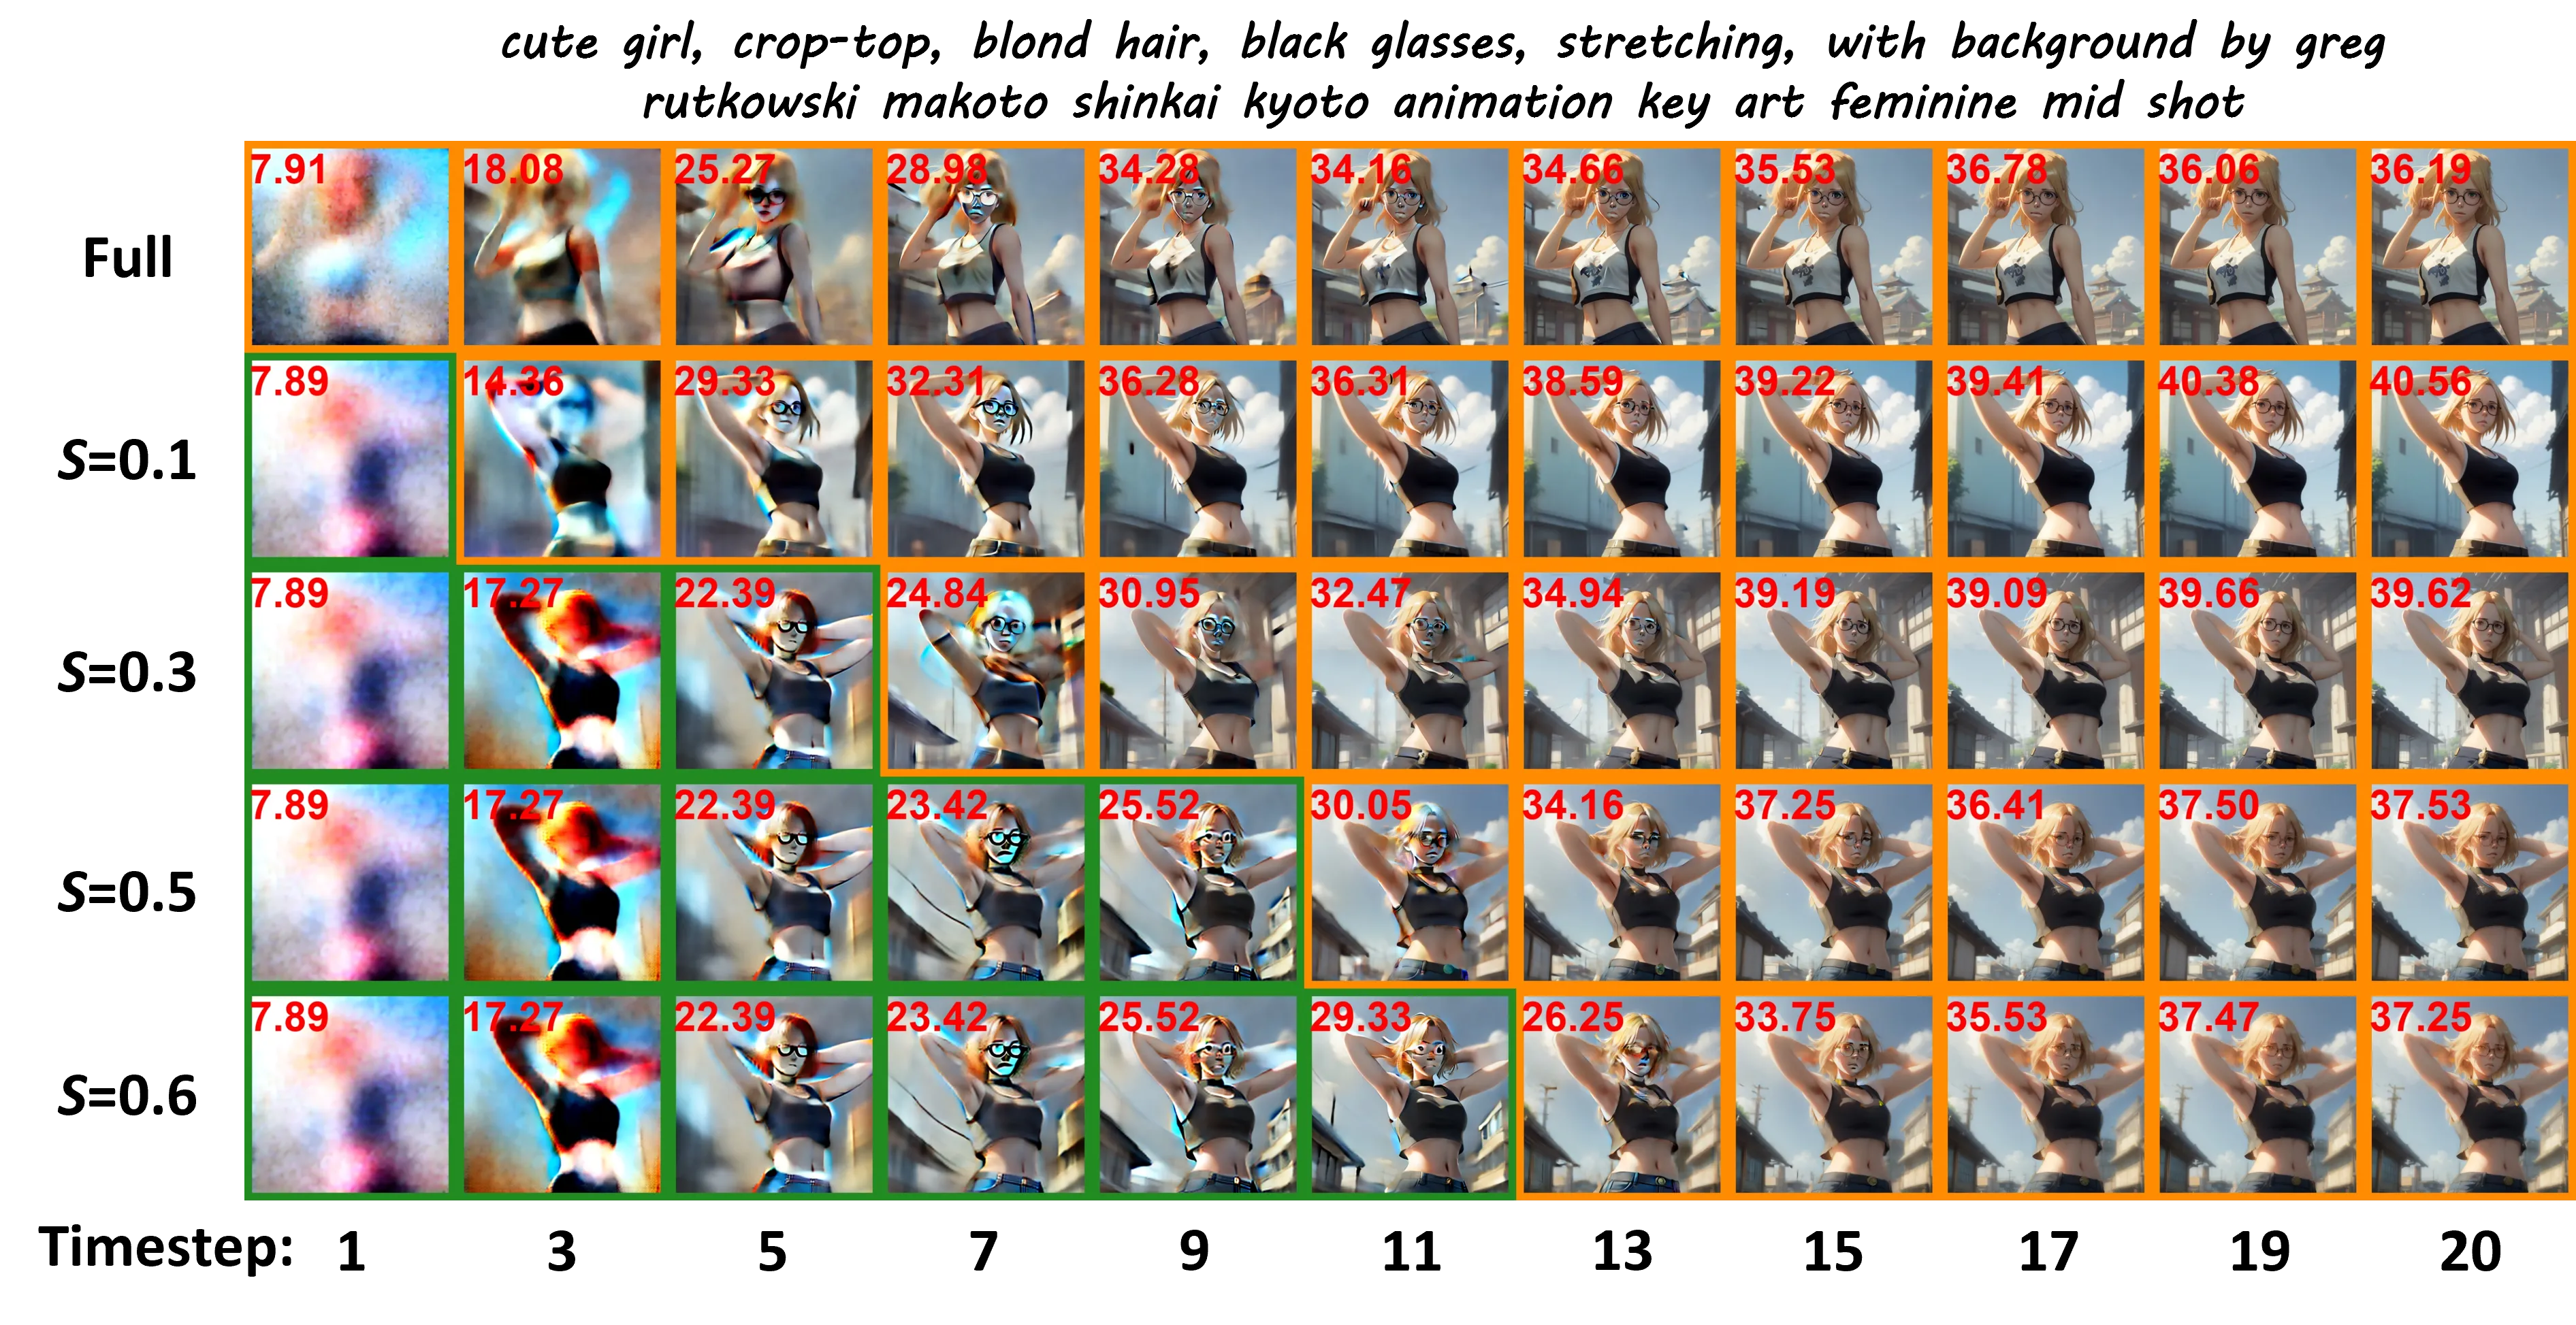
Figure 3: 从profiling和前人工作中得到的模块级冗余动机。
关键观察:
- 低频分量主导早期去噪步(语义规划阶段)
- 高频细节在后期逐步添加(保真度提升阶段)
- 低分辨率在早期步骤中可增强低频分量并提升最终输出质量
可视化分析
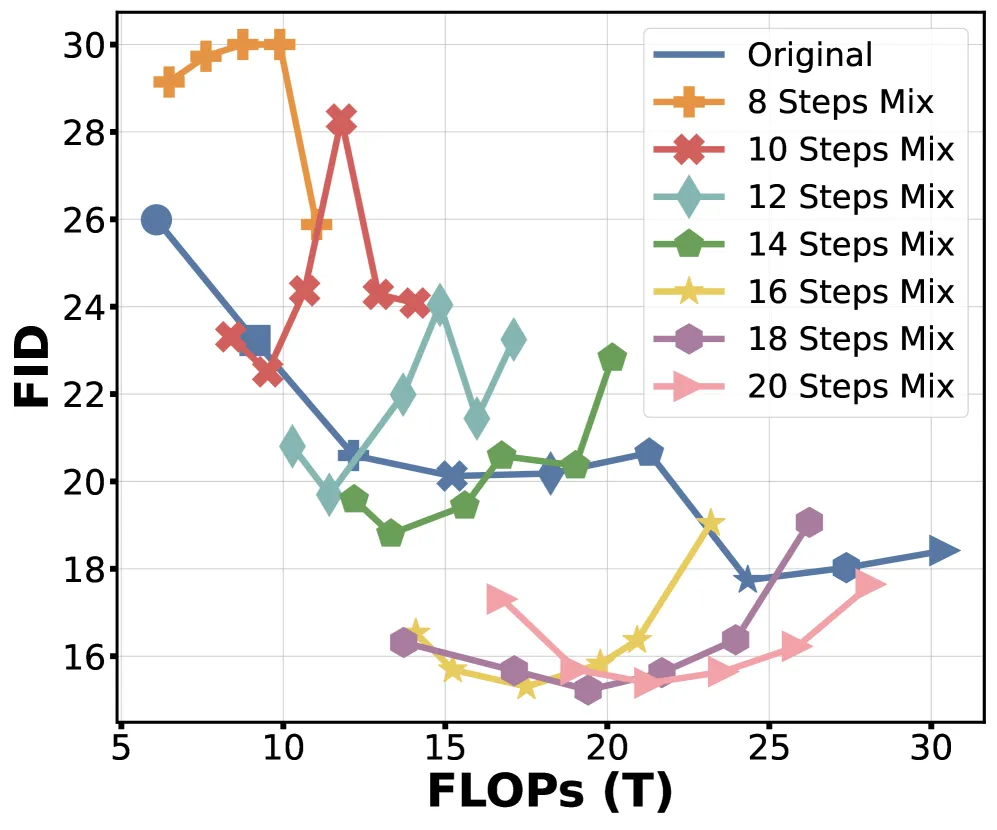
Figure 4: 低分辨率去噪如何有助于提升最终性能的可视化。
四、实验结果
Fewer Steps vs Cheaper Per-Step
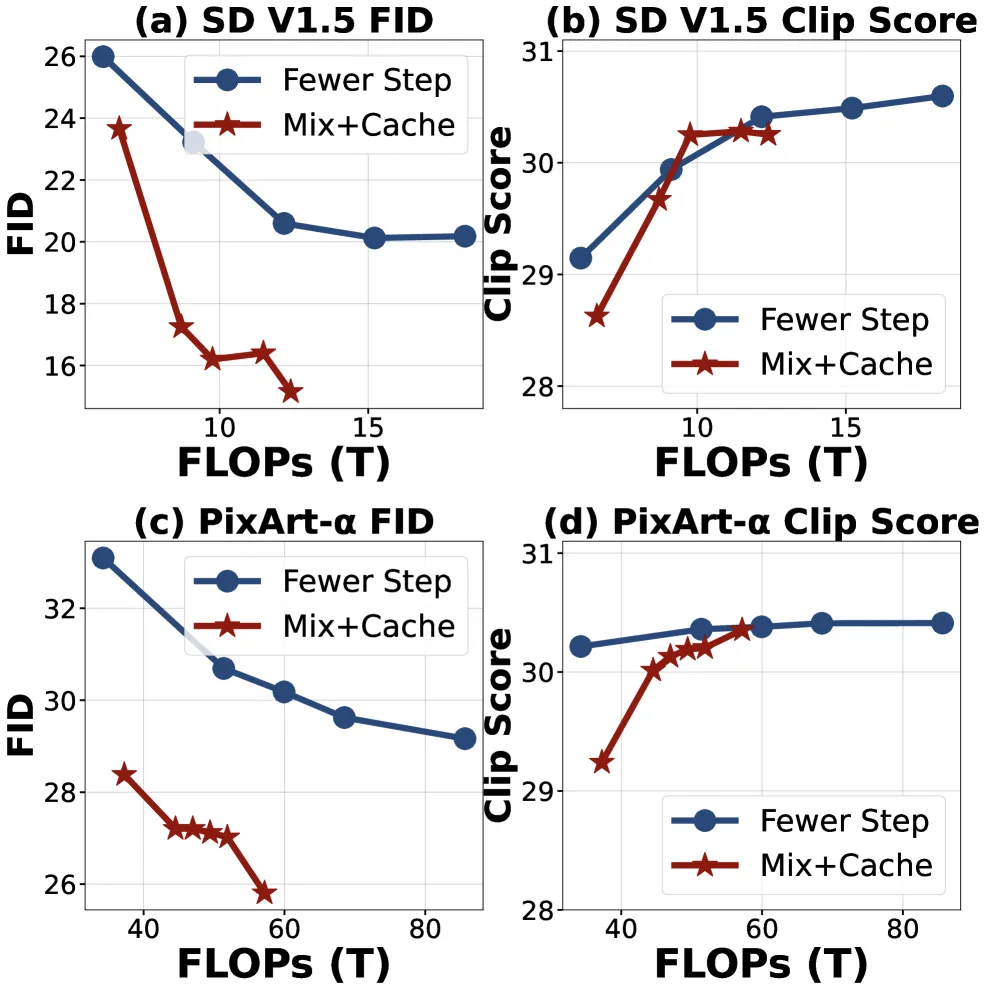
Figure 5: 减少去噪步数 vs 降低单步推理成本的FID-FLOPs权衡。
关键发现:
- 完整的PostDiff框架(结合两种技术)在所有FLOPs范围内实现最佳FID-FLOPs权衡
- 在输入和模块级别利用冗余可获得更好的FID-FLOPs权衡
- 降低单步推理成本比减少去噪步数更有效
SOTA模型评估
Table 2: PostDiff在SOTA扩散模型上的结果
| 模型 | 步数 | Mix | Cache | FID ↓ | Clip Score ↑ | FLOPs (T) ↓ | 延迟 (s) ↓ |
|---|---|---|---|---|---|---|---|
| SD V1.5 | 8 | 20.60 | 30.41 | 12.168 | 1.298 | ||
| 16 | 17.74 | 30.76 | 24.336 | 2.377 | |||
| 20 | 18.42 | 30.80 | 30.420 | 2.930 | |||
| 20 | ✓ | 15.69 | 30.78 | 19.035 | 1.945 | ||
| 20 | ✓ | ✓ | 16.65 | 30.25 | 11.129 | 1.139 | |
| LCM | 4 | 23.55 | 28.64 | 3.042 | 0.523 | ||
| 8 | 22.96 | 28.72 | 6.084 | 0.825 | |||
| 8 | ✓ | 21.01 | 28.92 | 3.807 | 0.666 | ||
| 8 | ✓ | ✓ | 22.76 | 28.58 | 3.686 | 0.651 |
关键结果:
- SD V1.5: 延迟从2.930s降至1.139s(2.57倍加速),FID从18.42改善至16.65
- LCM: 延迟从0.825s降至0.651s(1.27倍加速)
与其他压缩方法对比
Table 3: SD V1.5上的基准对比
| 方法 | FID ↓ | Clip Score ↑ | 延迟 (s) ↓ |
|---|---|---|---|
| Original | 18.42 | 30.80 | 2.930 |
| DeepCache | 17.79 | 30.75 | 1.737 |
| TGATE | 19.51 | 29.55 | 1.992 |
| ToDo | 18.28 | 30.75 | 2.520 |
| ToMe | 17.43 | 30.55 | 2.730 |
| Faster Diffusion | 17.90 | 30.40 | 2.005 |
| CA-ToMe | 20.49 | 30.41 | 2.112 |
| PostDiff | 16.65 | 30.25 | 1.139 |
Table 4: PixArt-α上的基准对比
| 方法 | FID ↓ | Clip Score ↑ | 延迟 (s) ↓ |
|---|---|---|---|
| Original | 29.16 | 30.41 | 1.752 |
| TGATE | 29.54 | 29.59 | 1.275 |
| DiTFastAttn | 45.46 | 30.13 | 1.103 |
| DuCa | 28.08 | 30.12 | 1.724 |
| PostDiff | 25.44 | 30.23 | 1.382 |
缓存策略消融
Table 1: 不同缓存策略的消融研究
| 设置 | FLOPs (T) ↓ | FID ↓ | Clip Score ↑ |
|---|---|---|---|
| Original | 30.420 | 18.42 | 30.80 |
| Original w/o CFG | 15.210 | 31.98 | 25.52 |
| DC | 17.787 | 17.79 | 30.75 |
| DC+CA (5, Ave) | 11.610 | 18.77 | 28.40 |
| DC+CA (10, Cond) | - | 21.26 | 30.11 |
关键发现:
- 完全放弃CFG会导致严重质量下降
- Cond策略在保持质量的同时有效减少计算
超参数消融
Table 5: k和m的消融研究
| 设置 | FID ↓ | Clip Score ↑ | 延迟 (s) ↓ |
|---|---|---|---|
| Original | 18.42 | 30.80 | 2.93 |
| k=2 | 16.65 | 30.25 | 1.14 |
| k=3 | 26.96 | 27.68 | 0.97 |
| k=4 | 39.22 | 26.16 | 0.94 |
| m=0.75 | 16.65 | 30.25 | 1.14 |
| m=0.9 | 16.49 | 30.06 | 1.26 |
关键发现:
- k=2(缓存间隔)是最佳选择
- m=0.75(CFG放弃步数比例)在质量和效率间取得最佳平衡
SOTA评估结果
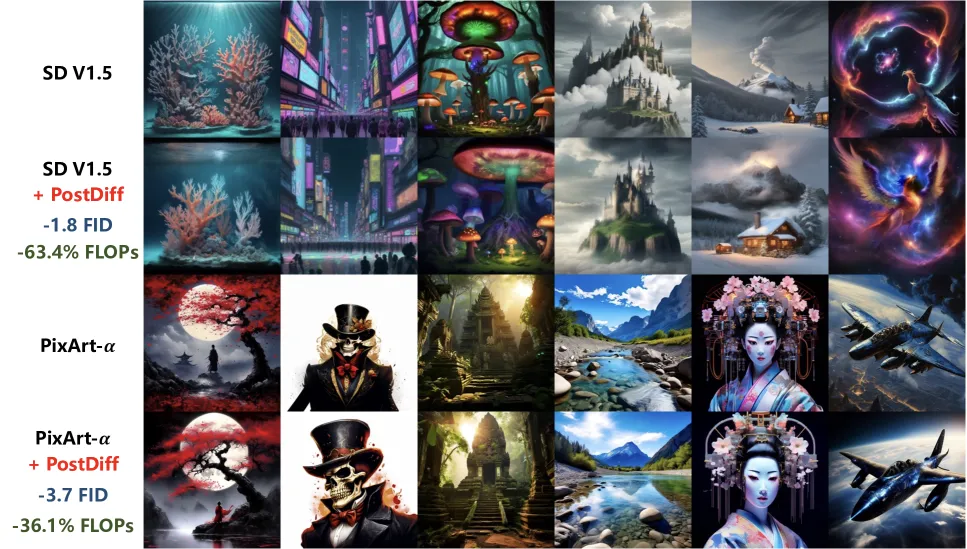
Figure 6: 在SOTA扩散模型上的评估结果。
Ablation Profile
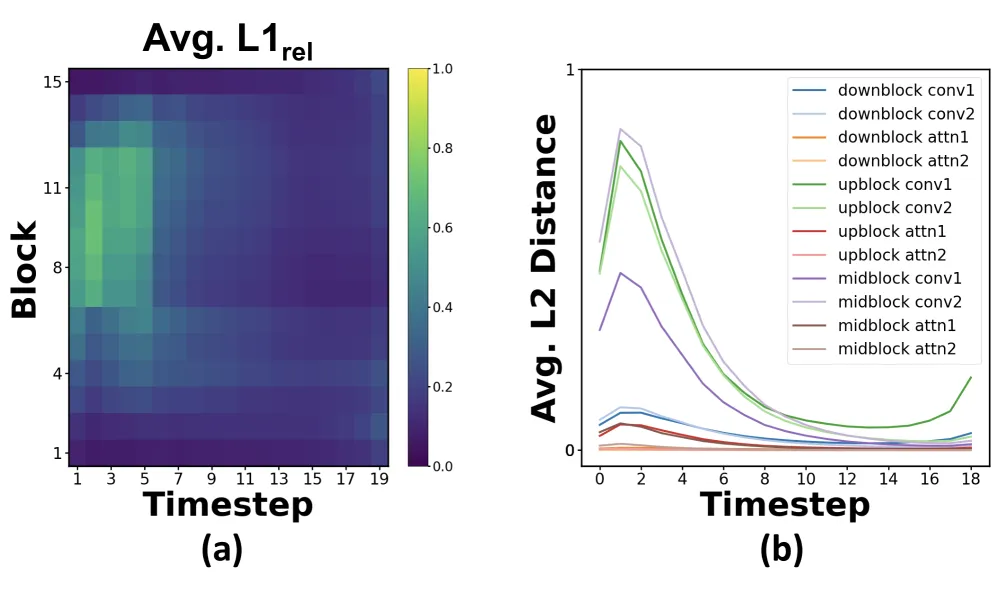
Figure 7: 消融实验的profiling分析。
分辨率缩放影响
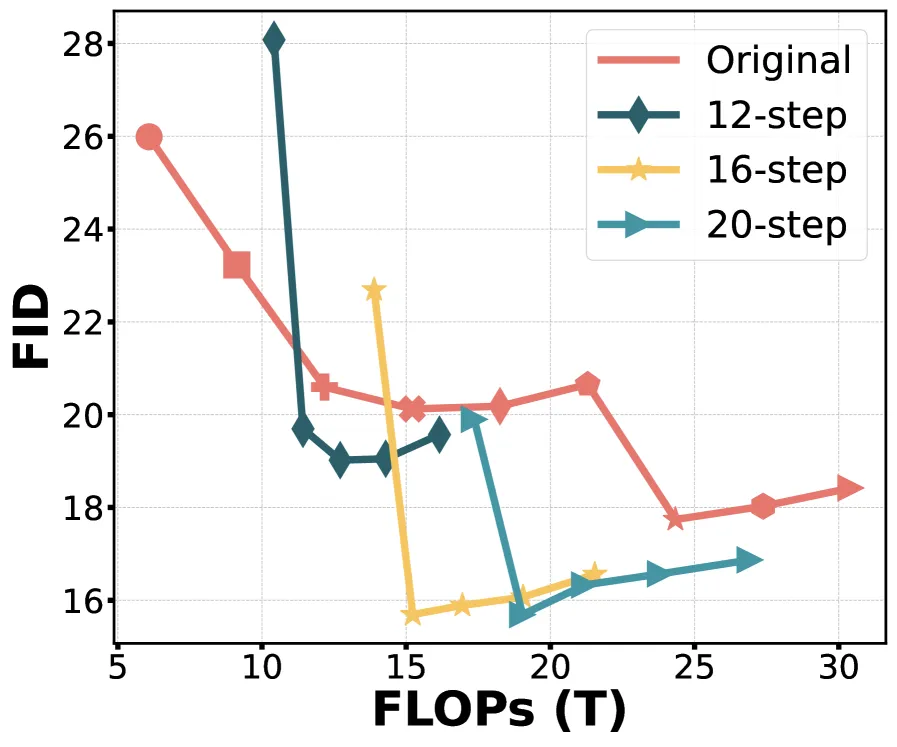
Figure 8: 不同分辨率缩放参数β的影响。
校准集效果
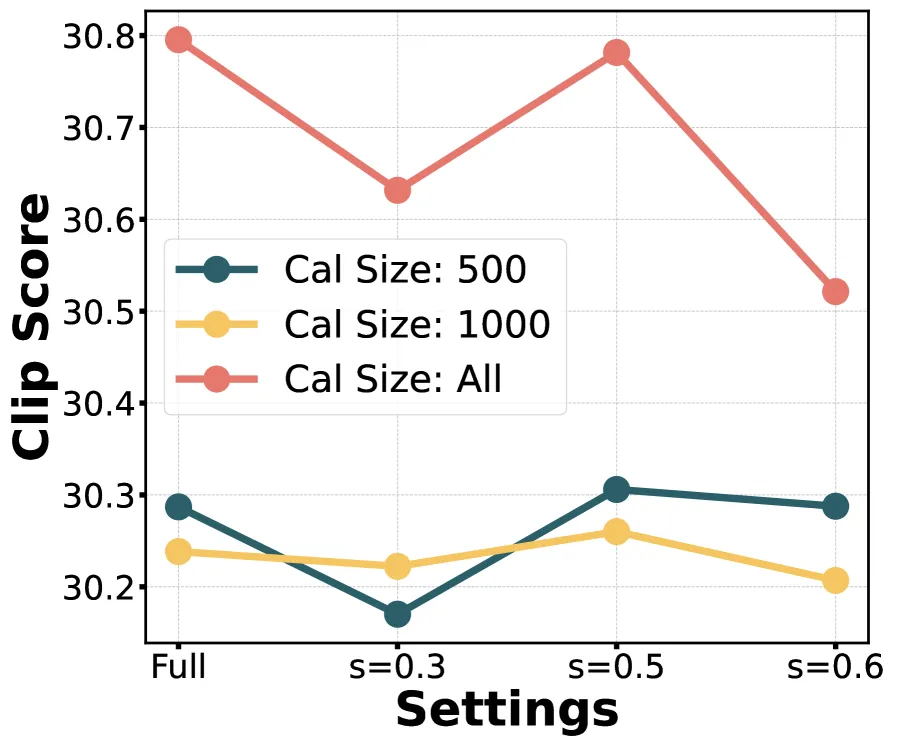
Figure 9: 小型校准集的有效性。
与前人工作对比
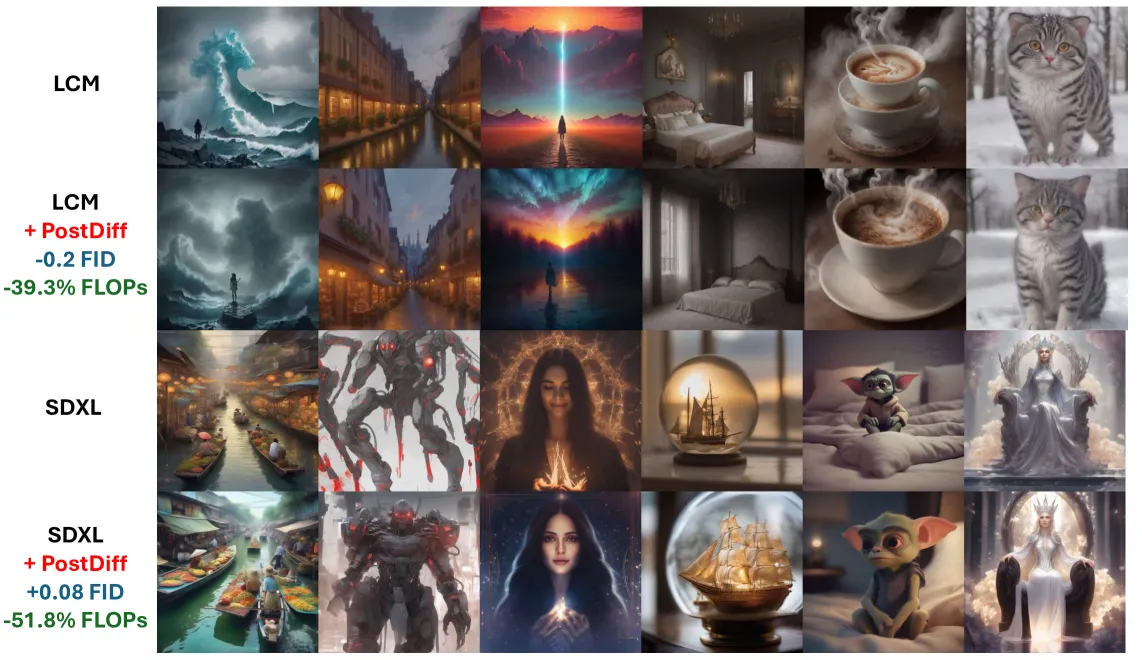
Figure 11: 与前人工作的详细对比。
混合模块缓存
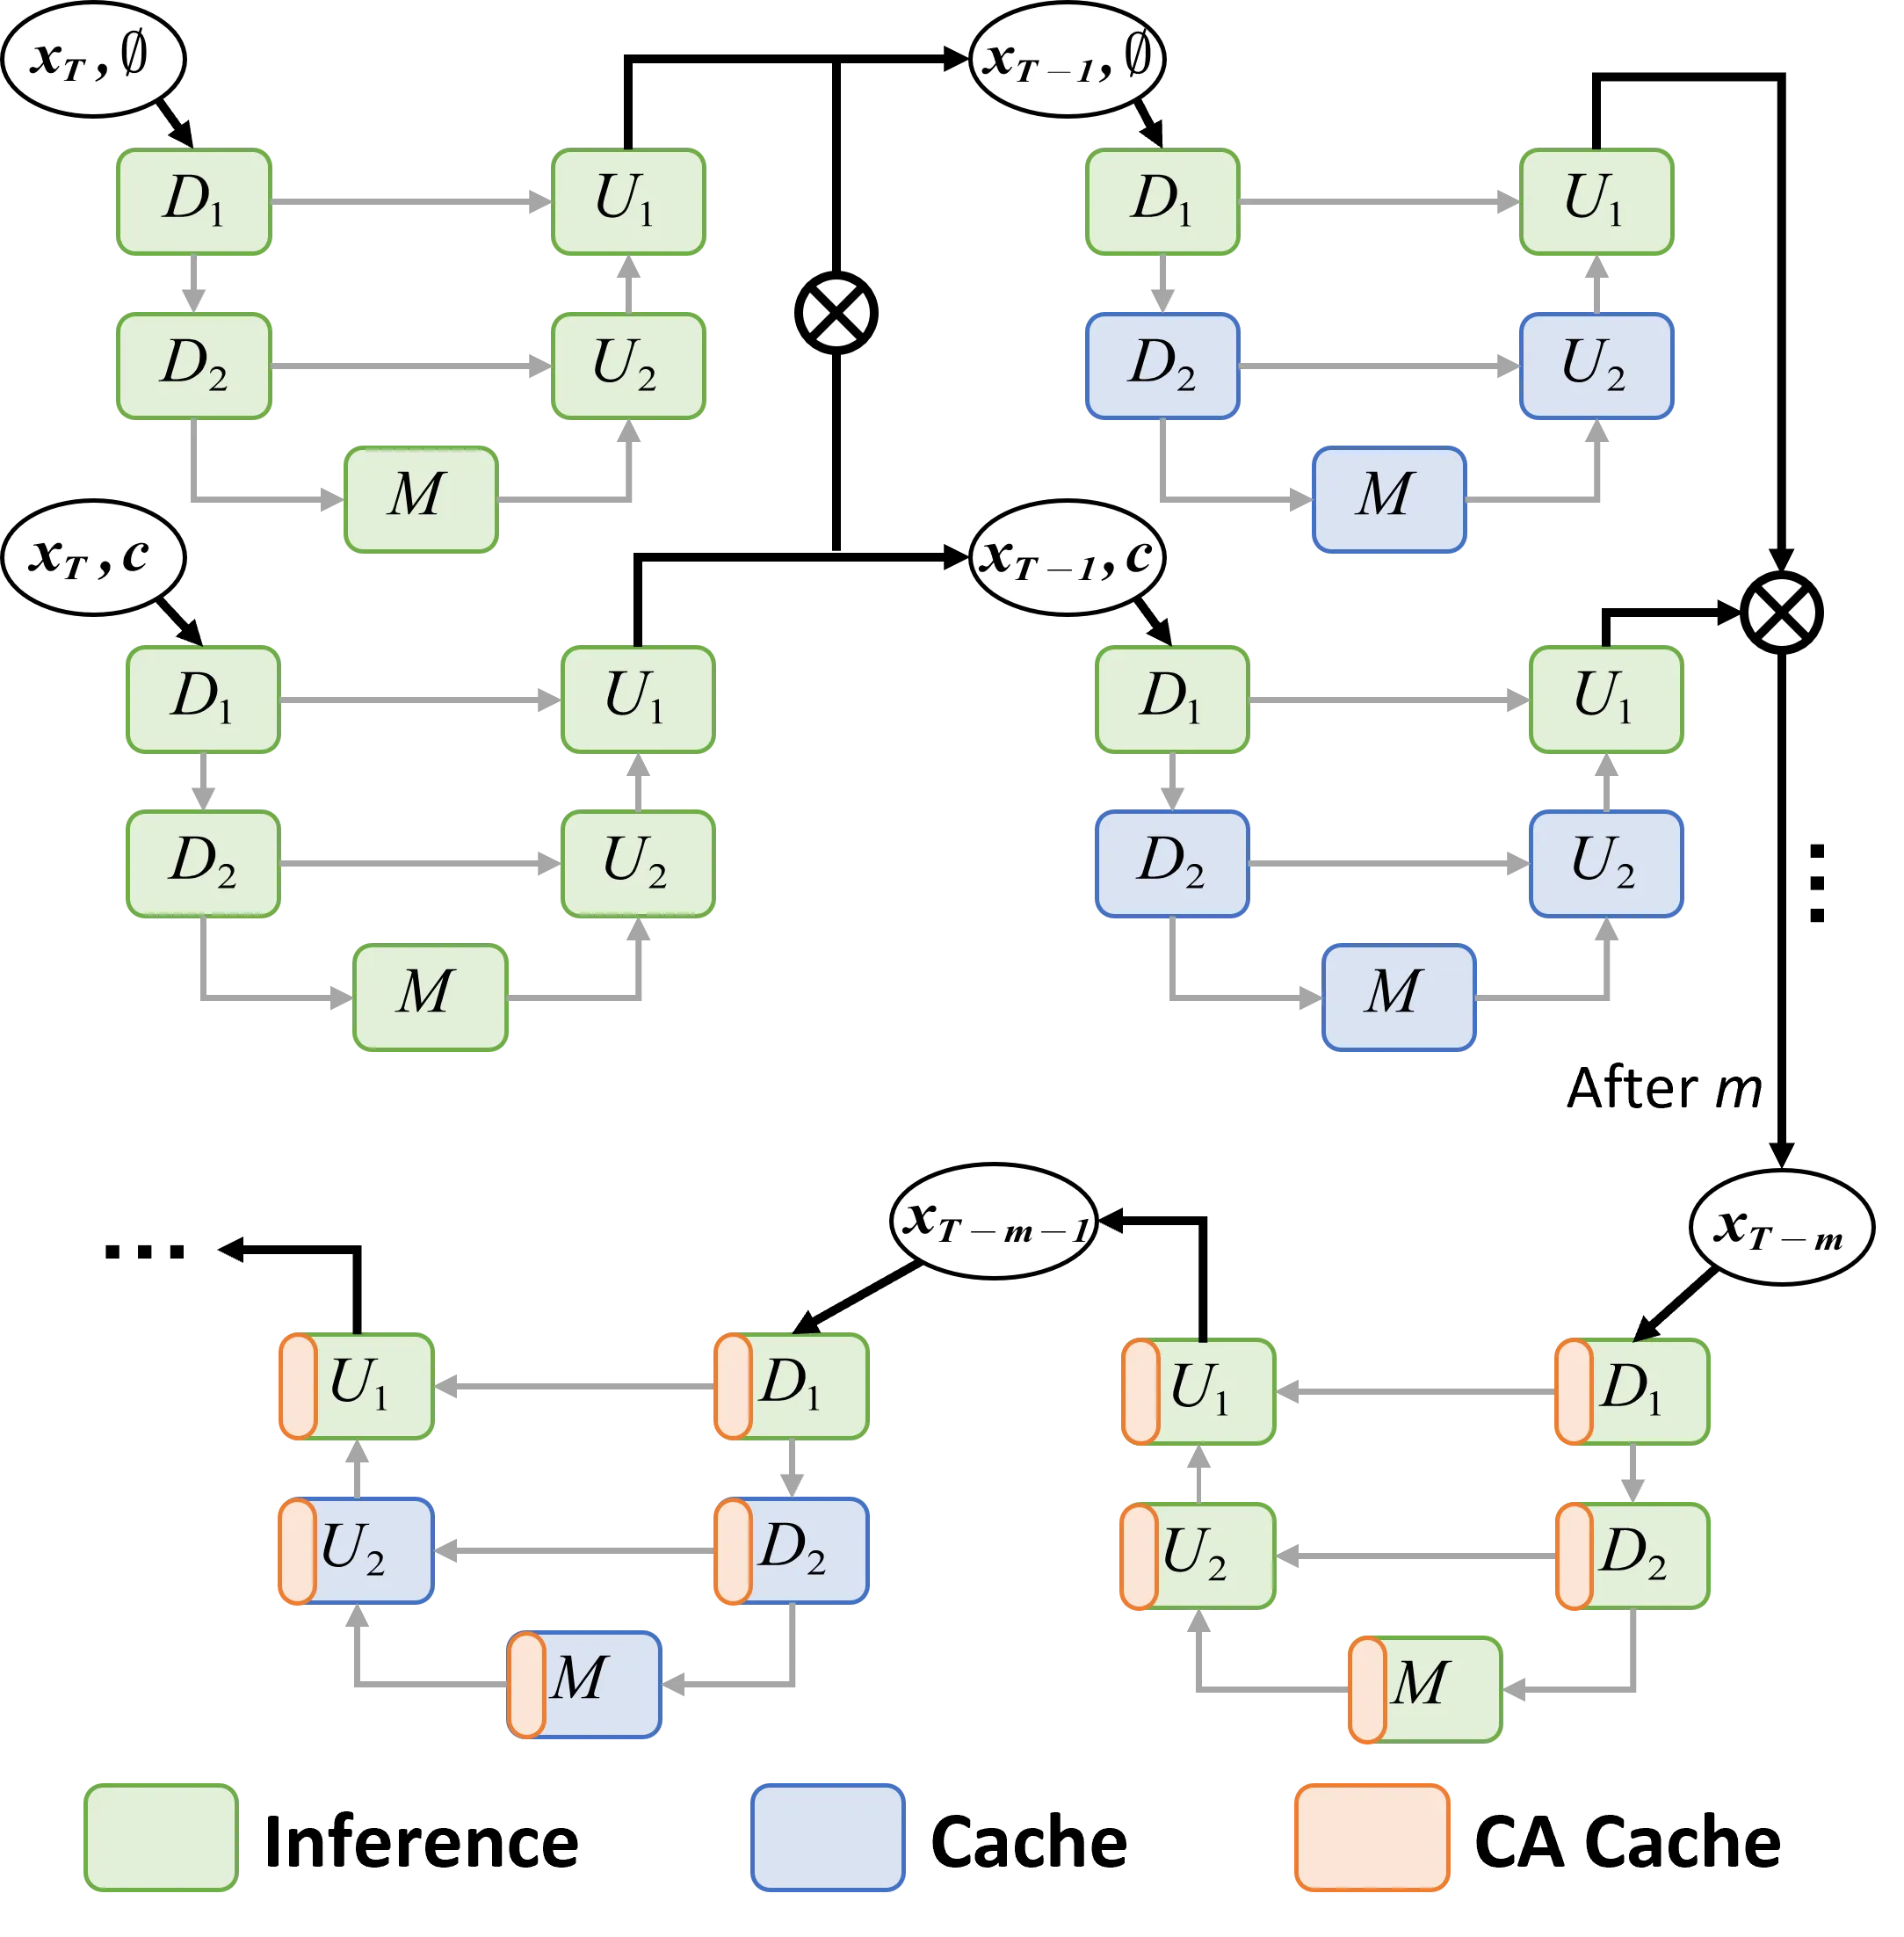
Figure 10: 混合模块缓存策略示意图。
五、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 混合分辨率去噪 | 早期低分辨率、后期高分辨率的二元策略 | 低频分量主导早期步骤的观察 |
| 混合模块缓存 | 结合DeepCache和交叉注意力缓存 | 跨步特征图相似性验证 |
| CFG-aware缓存 | 条件/无条件注意力的选择性缓存 | 消融实验验证Cond策略最优 |
| 后训练框架 | 免训练,无需微调 | 即插即用,快速部署 |
| 关键洞察 | 降低单步成本 > 减少步数 | FID-FLOPs权衡实验验证 |
六、相关工作对比
| 方法 | 特点 | PostDiff优势 |
|---|---|---|
| DeepCache | 模块级缓存 | 同时利用输入级和模块级冗余 |
| TGATE | 早期步缓存 | 更灵活的缓存策略 |
| ToMe/ToDo | Token合并/丢弃 | 结合分辨率优化 |
| Faster Diffusion | 步长优化 | 免训练,更通用 |
| DiTFastAttn | 注意力优化 | 更好的质量保持 |
| DuCa | 双缓存 | 更全面的框架 |
七、总结
核心贡献
- 首次研究关键问题:在后训练设置下,减少去噪步数 vs 降低单步推理成本哪个更有效
- PostDiff框架:免训练的扩散模型压缩框架,结合输入级和模块级优化
- 混合分辨率去噪:利用早期低分辨率去噪增强低频分量的策略
- 混合模块缓存:结合DeepCache和交叉注意力缓存的优化方案
- 关键洞察:降低单步推理成本通常比减少去噪步数更有效
性能总结
| 指标 | SD V1.5 | LCM | PixArt-α |
|---|---|---|---|
| 延迟降低 | 2.57倍 | 1.27倍 | 1.27倍 |
| FID改善 | 18.42→16.65 | 22.96→22.76 | 29.16→25.44 |
| 训练需求 | 免训练 | 免训练 | 免训练 |
技术影响
PostDiff展示了后训练扩散模型优化的重要性:
- 输入级冗余:分辨率是一个有效的优化维度
- 模块级冗余:跨步特征复用可显著减少计算
- 免训练方法:在实际部署中更具优势
- 关键洞察:指导未来的高效扩散模型部署策略
实际部署建议
| 场景 | 推荐策略 |
|---|---|
| 资源受限 | 混合分辨率去噪 + 模块缓存 |
| 高质量需求 | 保持最大步数 + PostDiff |
| 快速部署 | 免训练后训练压缩 |
| 多模型适配 | 小型校准集确定最优超参数 |
八、参考资源
- 论文: arXiv:2508.06160
- 相关工作: