LLM Serving Optimization with Variable Prefill and Decode Lengths
在固定 KV-cache 显存预算下研究异构 prefill/decode 长度的离线 LLM 服务调度:证明问题 NP-hard、FCFS/最短输出优先/总长度优先均有无界近似比;提出 Sorted-F 算法——用 F-metric(平均输出长度 / 批大小)平衡批并发与下游解码成本,证明常数因子近似比 ≤48;配三种 Phase-1 求解器(精确 DP、局部交换、分位贪心)与 LP 引导 / receding-horizon 变体。真实混合负载上相对 FCFS 提速 4.87×、相对 MC-SF 提速 2.09×,与 LP 下界差距仅 1.03-1.09×
LLM Serving Optimization with Variable Prefill and Decode Lengths
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LLM Serving Optimization with Variable Prefill and Decode Lengths |
| 作者 | Meixuan Wang, Yinyu Ye, Zijie Zhou |
| 论文 | arXiv:2508.06133(v4,2026-06-28) |
| 发布 | 2025 年 8 月 8 日(v1),2026 年 6 月 28 日(v4) |
| 领域 | math.OC(最优化与控制); cs.AI; cs.LG |
| 性质 | 理论 + 算法 + 实验(调度理论,非系统实现) |
| 基线数据集 | LMSYS-Chat-1M(短对话)+ Arxiv 长文摘要(Cohan 2018) |
二、核心思想
问题定义
LLM 推理分两阶段:Prefill(处理输入 prompt)与 Decode(自回归逐 token 生成)。每个计算 worker 有固定 KV-cache 显存容量 ,其消耗有两个关键行为:(1) 必须保留 prefill 输入的全部 token;(2) decode 阶段每生成一个 token,KV-cache 线性增长。这使显存压力动态变化——一个 worker 能并发处理多少请求随各请求生成进度而波动。
Jaillet et al. (2025) 建立了单 worker LLM 推理调度的理论模型,提出最短优先策略(优先输出 token 少的请求),但仅在输入长度均匀()假设下理论与实验有效。而实际中 worker 常处理混合负载(短对话 + 长文档摘要)。
放松均匀输入假设从根本上改变问题:考虑请求 满足 但 ——请求 每步显存低但持续时间长, 显存高但很快完成。最优优先级取决于与其他请求的全局交互,权衡非平凡。
模型设定(离线/积压模型):
- 个请求在 同时到达,每个由 刻画(prefill 大小、输出 token 数);
- 缩放假设:峰值单请求显存 (每个请求占显存的比例随 趋于 0);
- 过载假设:(总负载远超单批容量,否则调度平凡);
- 生成请求 第 个 token 的显存为 ;批显存约束 ;
- 目标:最小化总端到端时延(Total End-to-end Latency, TEL)——所有请求完成时间之和 。
解决方案概述
论文提出 Sorted-F 调度算法,核心是批级质量度量 F-metric,平衡批并发与下游解码成本,并证明常数因子近似比 ≤48(独立于问题规模),相比现有方法的无界近似比是重大改进。
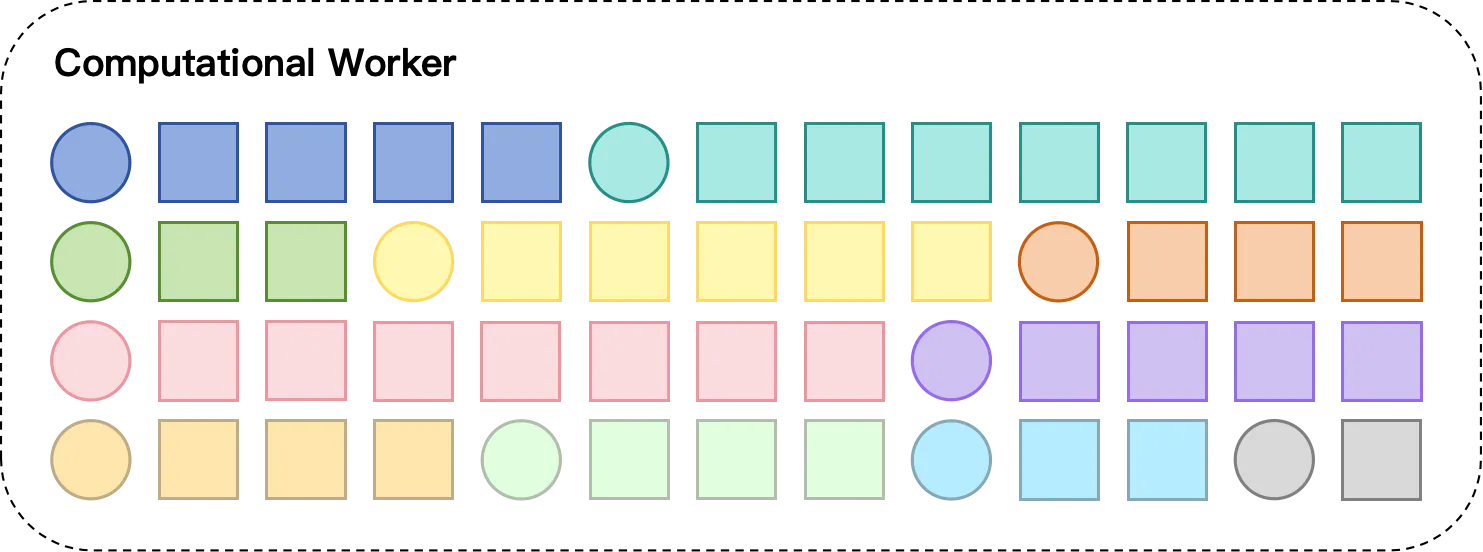
图 1:LLM 推理调度示意——prefill/decode 混合 + 连续批处理。圆圈表示 prefill 操作,方块表示 decode token,颜色区分不同请求。
三、负面结果与 NP-hardness
论文首先分析 Jaillet et al. (2025) 的 MC-SF(memory-constrained shortest-first,按输出长度 优先)在异构输入下的表现。MC-SF 在加入请求前会验证所有未来时间步的显存约束(式 1)。
定理 2.1(MC-SF 无界近似比):当 、、 时,()。附录还证明按总长度 优先同样无界。
定理 2.2(NP-hard):在同样条件下,最小化总端到端时延是 NP-hard(通过 restricted 3-Partition 问题归约,,强 NP-hard)。
这些结果将本问题置于经典资源约束批调度的复杂度版图中:精确优化计算困难,但精心设计的优先/近似算法仍可提供可证明的最坏情况保证。关键区别在于——本模型的资源消耗由 KV-cache 诱导、并在自回归解码中演变,故优先规则必须同时考虑批吞吐与随时间的显存可行性。
四、Sorted-F 算法
核心度量 F-metric
对任意请求集 :
越小优先级越高。设平均响应长度 ,则:
直观解释: 是吞吐密度——单位平均解码时间完成的请求数。优先选 小的批等价于优先高吞吐密度批。这是经典调度中最短处理时间规则()与 Smith 规则(加权 SPT,)的批级类比——被排序的「作业」是可行批而非单个请求,有效处理速率同时依赖批大小与解码长度。
数值例(Example 3.1):,两类请求:
| 类型 | Prompt 大小 | 响应长度 | 数量 |
|---|---|---|---|
| 1 | 63 | 1 | 1 |
| 2 | 1 | 2 | 21 |
- MC-SF(优先短输出):先调度 Type 1(), 完成;再批处理 21 个 Type 2(每批容纳 个),TEL ;
- Sorted-F:,,故优先 Type 2; 完成,Type 1 于 处理,TEL ——降低 29.7%。
引理 3.2(防长尾):Phase 1 选中的任意批 ,——确保批内无单个请求输出长度主导平均值,避免掉队者,也为第四节证明提供分析杠杆。
两阶段流程
- Phase 1(批构造):反复选取可行批 最小化 (先最小化 ,平局时偏好更大批),批内按 非降排序,串接成有序列表 ;
- Phase 2(执行):按时间步执行,维护待处理 、活跃 、新准入 ;(i) 移除已完成请求,(ii) 按 顺序在显存可行前提下准入新请求,(iii) 每活跃请求并发生成一个 token。未来时间步 的显存消耗:
常数近似比证明(§4)
定理 4.1:当 Phase 1 精确求解时,Sorted-F 达到至多 48 的常数近似比,独立于问题规模。证明引入处理可变输入/输出的新技术(通过 Sorted-F → Sorted-F → Sorted-F → Sorted-F 一系列变换,及 Optimal → Optimal),可能对类似调度问题的理论分析有独立价值。
五、实用实现(§5)
Phase 1 需求解组合优化 (含显存可行约束),穷举不可行,故提供一个精确解 + 两个可扩展启发式:
| 算法 | Phase 1 求解器 | 复杂度 | 推荐规模 | 保近似比 |
|---|---|---|---|---|
| 精确动态规划 | 精确 | 是 | ||
| 局部交换搜索 | 启发式 | 否 | ||
| 分位贪心选择 | 启发式 | 否 |
- 精确 DP:状态 = 任意 请求、消耗 显存的批的最小输出长度和;目标 ;反向遍历防重复计入;
- 局部交换搜索:从按 升序贪心选择的初始批 出发,反复做成对交换(换入 、换出 ,需满足显存可行 + 改善),至局部最小;
- 分位贪心:Phase 1(核心选择),Phase 2(容量填充)用剩余请求填满显存;分位阈值 由负载采样导出。
预测不确定性处理(§5.5,Sorted-F+):现实中输出长度需预测。采用 Chen et al. (2025) 的区间预测 ( 度量置信度)。核心思想是乐观起步 + 推理中自适应:初始用下界 ,运行时维护估计 ;显存溢出时按 递增顺序有序逐出(越接近完成的越先逐出,被逐出者退回待处理队列)。相比保守法 (用 ,过度预留显存降吞吐), 即使预测很差仍表现良好。
六、扩展(§6)
LP 引导启发式
Jaillet et al. (2025) 将离线最优表为整数规划(Optimal-IP,决策变量 表示请求 于 开始,式 2-5)。求解 IP 计算不可行,松弛整数约束得 Relaxed-LP(式 6-9),其目标值提供离线最优时延的有效下界。
- Sorted-LP:解 Relaxed-LP 得分数解 ,计算 LP 诱导期望开始时间 ,按 升序执行(用 Phase 2 准入规则);
- LP-Swap:从 Sorted-LP 排序出发,加 F-metric 引导的局部交换细化(混合全局 LP 视角 + 局部优化)。
在线到达(§6.2,Sorted-F-Online)
Receding-horizon 变体:每次迭代观察当前待处理积压,用 F-metric 批选择原则构造优先序,按活跃请求的实时残余 KV-cache 剖面准入最长可行前缀。双时间尺度实现——慢尺度每 10 次迭代(或缓存序耗尽 / 积压增长超 50% 时)重算 F 优先序;快尺度每次迭代复用缓存序。F-planning 步限于至多 300 个待处理请求的前瞻窗,其余按 升序 fallback。
定理 6.1(Jaillet et al. 2025):在线对抗到达下,即便 ,任何在线确定性算法都无法达到常数竞争比。故 Sorted-F-Online 仅通过数值实验评估。
七、实验结果(§7)
数据集与设置
- LMSYS-Chat(短对话):输入均值 41.84 token(中位 12),输出均值 85.35(中位 43);
- Arxiv 长文摘要(Cohan 2018):输入均值 2546.39 token(中位 2667.5),输出均值 296.08(中位 161);
- 混合:随机取 1600 短 + 400 长 = 2000 样本;输入均值 542.75(中位 18),输出均值 127.5;
- 显存预算 token(LLaMA2-70B 双 A100 部署);批处理时间用 Vidur 模拟器(Agrawal 2024a)线性回归时序模型估计;5 个随机种子报告均值 ± 标准差。
图 2(上):LMSYS-Chat 短对话数据的输入 prompt 与输出响应 token 数分布。
主结果(80/20 混合,n=2000)
| 策略 | 平均端到端时延 (秒) |
|---|---|
| Sorted-F + 局部交换 | 154.1 ± 2.3 |
| LP-Swap | 157.4 ± 1.6 |
| Sorted-LP | 235.1 ± 1.6 |
| Sorted-F + 分位贪心 | 243.7 ± 2.7 |
| MC-SF | 321.5 ± 2.0 |
| FCFS | 750.0 ± 29.8 |
Sorted-F(局部交换)时延最低,全面超越基线。MC-SF 表现差表明纯输出长度优先在 prompt 大小变化大时不足。Sorted-F 与 LP-Swap 高度重合,说明 F-metric 引导的细化主导最终调度质量——局部交换后 LP 初始化几乎无额外收益,故 Sorted-F(无需解 LP、实现更简单)为首选实用方法。
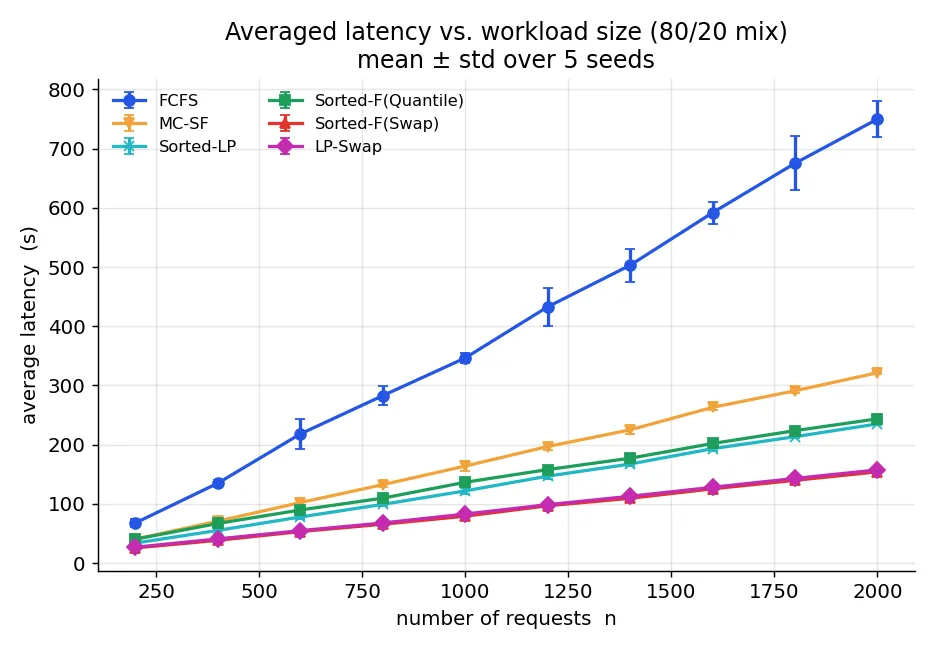
图 3:80/20 短/长负载下的每请求平均端到端时延(5 种子,误差棒为 ±1 标准差)。
负载组成敏感性
| 短/长比例 | Sorted-F 相对 FCFS 提速 |
|---|---|
| 100/0 | 3.36× |
| 80/20 | 4.87×(相对 MC-SF 2.09×) |
| 50/50 | 2.50× |
| 20/80 | 1.65× |
异构调度在混合负载最有价值:全短时多数策略都能高效打包;长请求主导时显存对几乎所有策略都是瓶颈;混合负载下调度器须权衡大量短请求 vs 少量显存密集长请求。实用诊断——当请求长度离散度高且 server 接近 KV-cache 容量时,可期待内存感知调度最大收益。
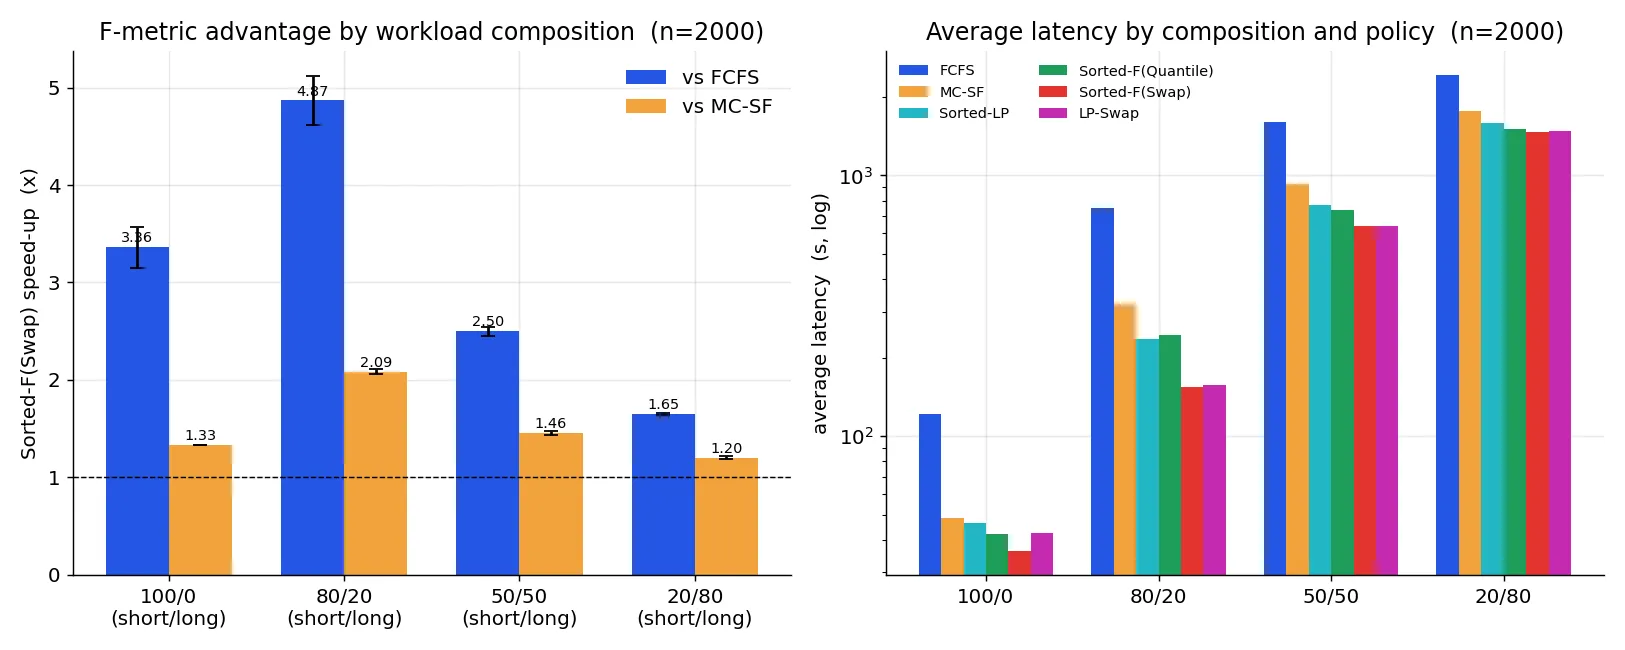
图 4:n=2000 时调度性能对负载组成的敏感性。左:Sorted-F 相对 FCFS/MC-SF 提速;右:各策略各组成的平均时延。
LP 下界最优性差距
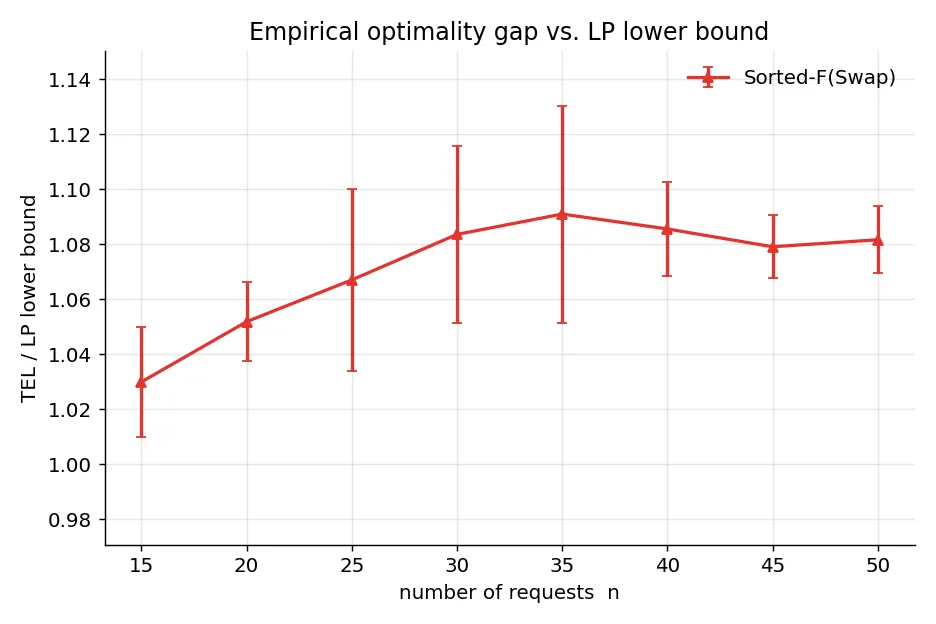
图 5:小型可解实例上 Sorted-F(局部交换)相对 LP 松弛下界的经验最优性差距。
在可解小实例上,Sorted-F(局部交换)的 TEL 与 LP 目标之比保持在 1.03–1.09 之间——尽管定理 4.1 的常数 48 是最坏情况保证,实际性能远接近 LP 下界。
尾时延与运行时
- 尾时延:n=2000 时 Sorted-F(局部交换)p95 时延 953.2 秒,FCFS 为 1413.9 秒;
- 调度运行时(80/20, n=2000):分位贪心 ~0.053 秒、局部交换 ~0.073 秒——相对整个服务周期极小,可作为低开销决策层。
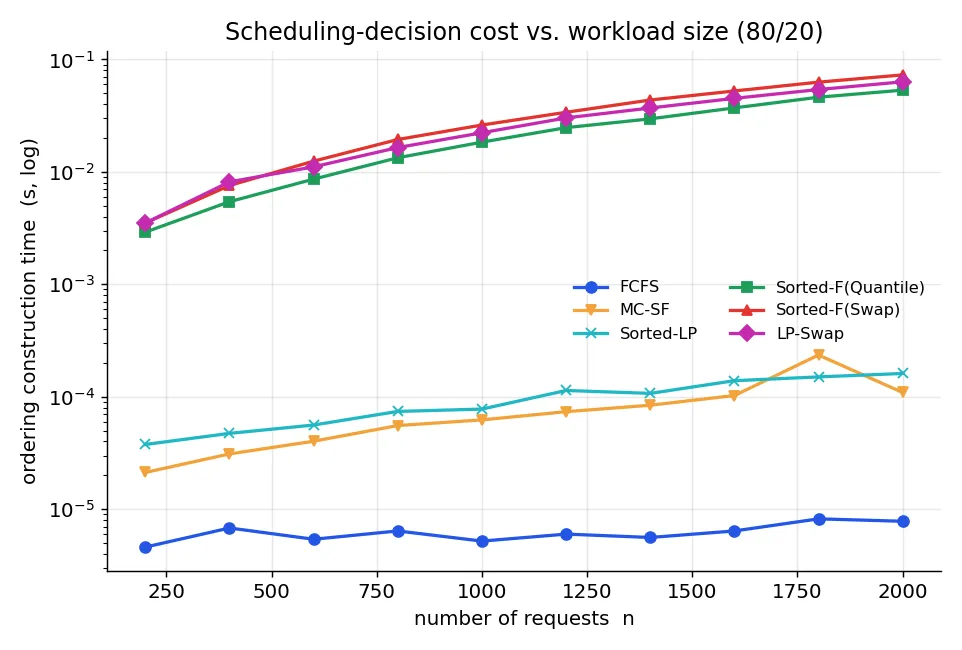
图 6:80/20 负载下各策略的调度序构造时间(y 轴对数刻度)。
Prefill 加权鲁棒性
用广义度量 ( 为 prefill token 相对 decode token 权重, 恢复 F-metric)。当 校准到真实相对计算成本(compute-matched ,因 prefill 并行摄入而 decode 串行)时,Sorted-G 与 Sorted-F 统计不可区分——本工作负载下 prefill 计算是二阶效应。 升高时时延退化:(按总长度排序)退化 ~5.5%(印证总长度优先不鲁棒的负面结果), 退化达 ~19%。支持了本文以解码为中心的建模选择。
在线 Poisson 到达
迭代、80/20 混合、到达率 对应归一化负载 ()从 0.48 到 2.88。收益依赖负载区间:稳定/轻临界区(积压浅)Sorted-F-Online 与 MC-SF 相近;过载时积压变深、批选择变重要—— 时相对 MC-SF 降时延 15.1%, 时降 40.0%,相对 FCFS 降 83%-88%。这与离线模型动机一致:峰值/瞬态过载期,选对可行批比单纯优先短输出更重要。
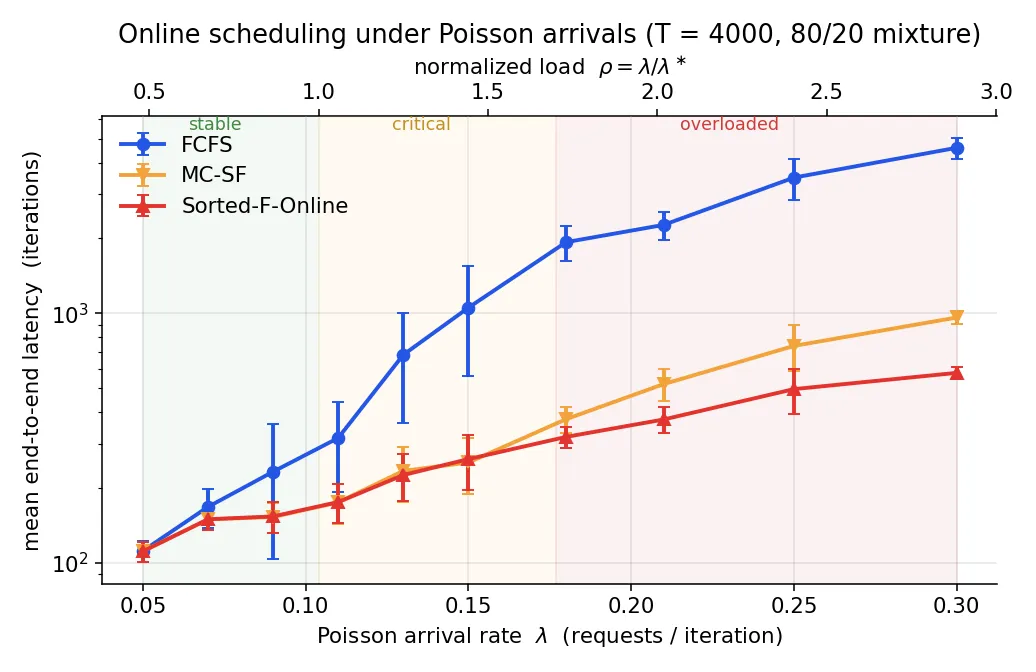
图 7:Poisson 到达下的在线调度。y 轴为平均端到端时延(迭代数),顶轴为归一化负载 。
八、总结
核心贡献
- 负面结果 + NP-hardness:证明放松均匀输入假设后,FCFS、最短输出优先、总长度优先均有无界近似比,问题 NP-hard;
- Sorted-F + 常数近似比:基于 F-metric(批级质量度量,平衡批基数与下游解码成本)的多项式时间算法,精确求解 Phase 1 时近似比 ≤48;
- 实用近似算法:精确 DP、局部交换、分位贪心三种 Phase-1 求解器,附规模选择指南与预测不确定性处理(Sorted-F+);
- LP 引导启发式:IP/LP 松弛、Sorted-LP 与 LP-Swap;
- 全面实验:真实混合负载上一致降时延,接近 LP 下界,含 Poisson 在线初步实验。
管理洞察
- 异构调度在请求长度高度离散 + 显存紧张时最重要;
- Phase-1 求解器选择应依部署规模与时延敏感度(小积压用精确 DP、中等用局部交换、大峰值用分位贪心,可混合动态切换);
- 输出长度预测的价值应通过下游时延影响而非单纯预测误差来评估。
局限性
- 理论模型与近似保证在离线设定(所有请求 到达)下建立,未完全捕获在线序列到达;正式在线理论(竞争比分析、生产 trace 上的墙钟评估)留待未来;
- 常数因子保证仅适用于 Phase 1 精确求解的理想 Sorted-F,局部交换/分位贪心的最坏情况性质待刻画;
- LP 松弛的整数间隙与 LP 舍入过程性能尚不完全清楚;
- 理论分析假设已知解码长度,预测不确定性下的可证明保证(robust / learning-augmented 调度)是重要方向。
九、参考资源
- arXiv 论文:https://arxiv.org/abs/2508.06133
- 前置工作:Jaillet et al. (2025) — 单 worker LLM 推理调度理论模型与 MC-SF 算法
- 预测不确定性方法:Chen et al. (2025) — 自适应输出长度细化
- 数据集:LMSYS-Chat-1M(Zheng 2023a)、Arxiv 长文摘要(Cohan 2018)
- 时序模型:Vidur 模拟器(Agrawal 2024a)