Qwen-Image Technical Report
Qwen 图像生成基础模型技术报告
Qwen-Image Technical Report
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Qwen-Image Technical Report |
| 作者 | Chenfei Wu, Jiahao Li, Jingren Zhou, Junyang Lin 等 39 人(Qwen 团队) |
| 论文 | arXiv:2508.02324 |
| 代码 | GitHub: QwenLM/Qwen-Image |
| 发布 | 2025年8月4日 |
二、核心思想
问题定义
图像生成模型面临两大关键挑战:
挑战 1:复杂文本渲染
- 现有模型在图像中渲染文本时经常出现错误(拼写错误、字符缺失)
- 对于非字母语言(如中文)的支持尤其困难
- 段落级文本渲染几乎无法实现
挑战 2:图像编辑一致性
- 传统编辑方法难以同时保持语义一致性和视觉保真度
- 编辑后的图像容易出现内容偏移或细节丢失
解决方案概述
本文提出 Qwen-Image,Qwen 系列中的图像生成基础模型:
- 复杂文本渲染:设计全面的数据管线 + 渐进式训练策略
- 图像编辑一致性:改进的多任务训练范式 + 双编码机制
- 多语言支持:特别针对中文等表意文字进行优化
关键创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| 7 阶段数据管线 | 收集、过滤、标注、合成、平衡 | 高质量训练数据 |
| 渐进式训练策略 | 从非文本到文本,从简单到复杂 | 逐步提升文本渲染能力 |
| MSRoPE 位置编码 | 多尺度可扩展位置编码 | 支持多种分辨率 |
| 双编码机制 | Qwen2.5-VL + VAE 分别编码 | 语义一致性 + 视觉保真度 |
| DPO + GRPO | 双重强化学习策略 | 提升生成质量 |
三、技术架构
模型架构概览
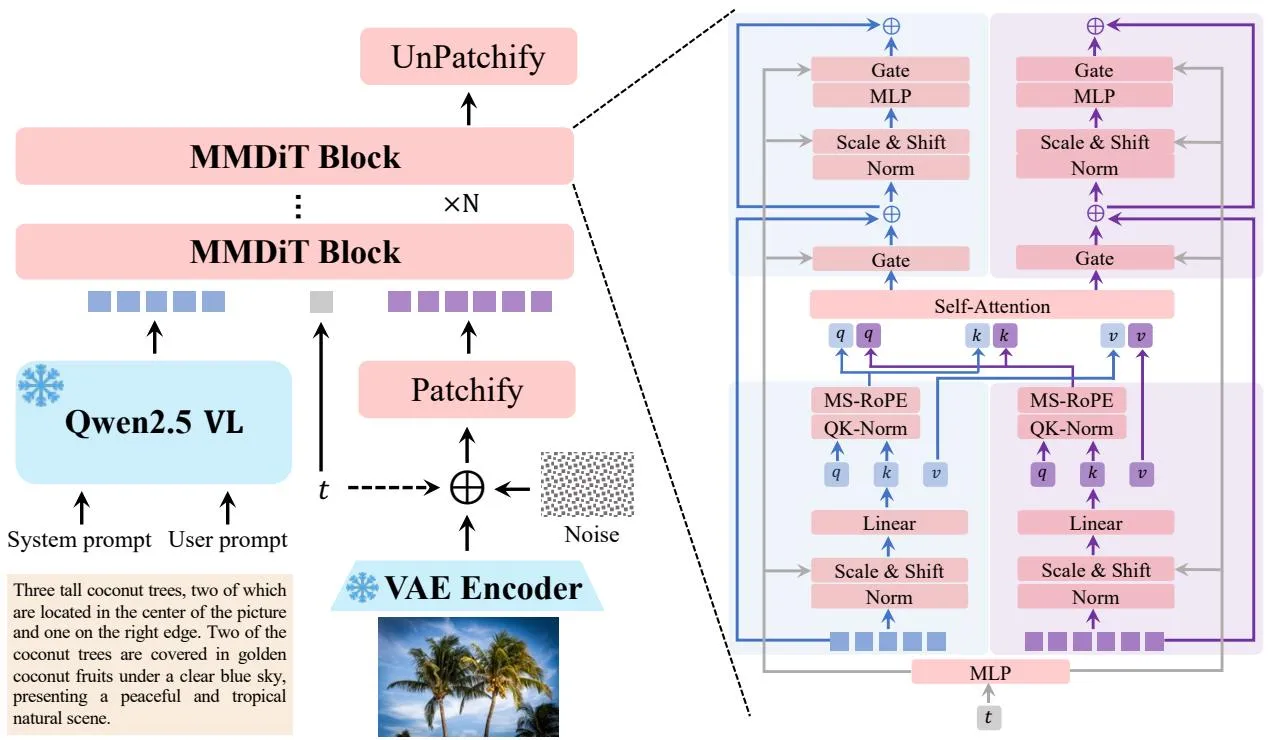
Qwen-Image 由三个核心组件组成:
1. 多模态大语言模型 (MLLM)
- 基础模型:Qwen2.5-VL-3B/7B(预训练语言模型)
- 输入:文本 prompt + 图像 token
- 输出:中间层隐藏状态作为 MMDiT 的条件
- 特殊 token:
<image_start>/<image_end>:图像 token 边界<|image_pad|>:填充 token
2. 变分自编码器 (VAE)
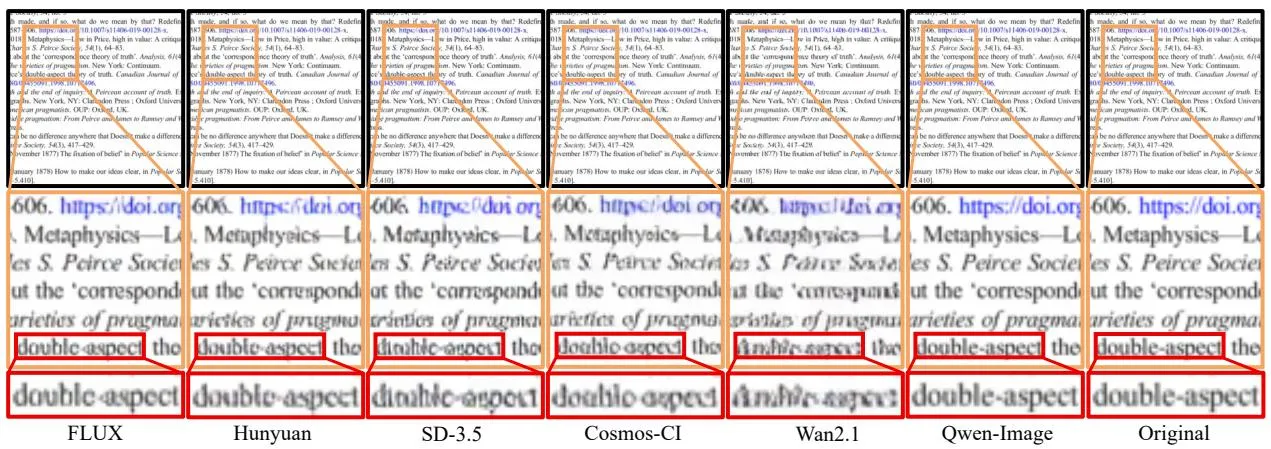
- 架构:基于 FLUX 的共享编码器
- 压缩率:空间 8×8,时间 4×
- 训练数据:混合文本/非文本文档图像
- 特点:专为文本渲染优化,保留小文本和细粒度细节
3. 多模态扩散 Transformer (MMDiT)
- 架构:双流(文本流 + 图像流)全注意力 Transformer
- 层数:38 层
- 隐藏维度:4,096
- 注意力头:28/28(Q/K/V)
- 图像分辨率:支持多种分辨率(576-1328)
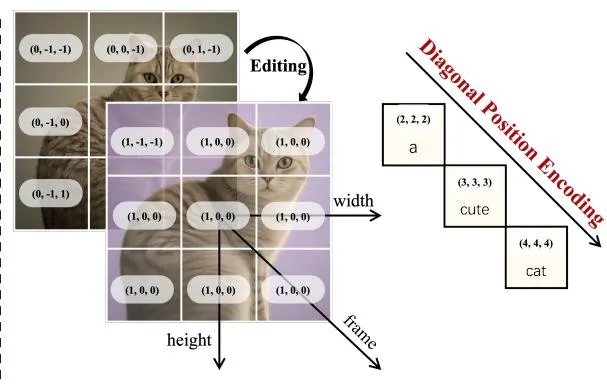
MSRoPE 位置编码
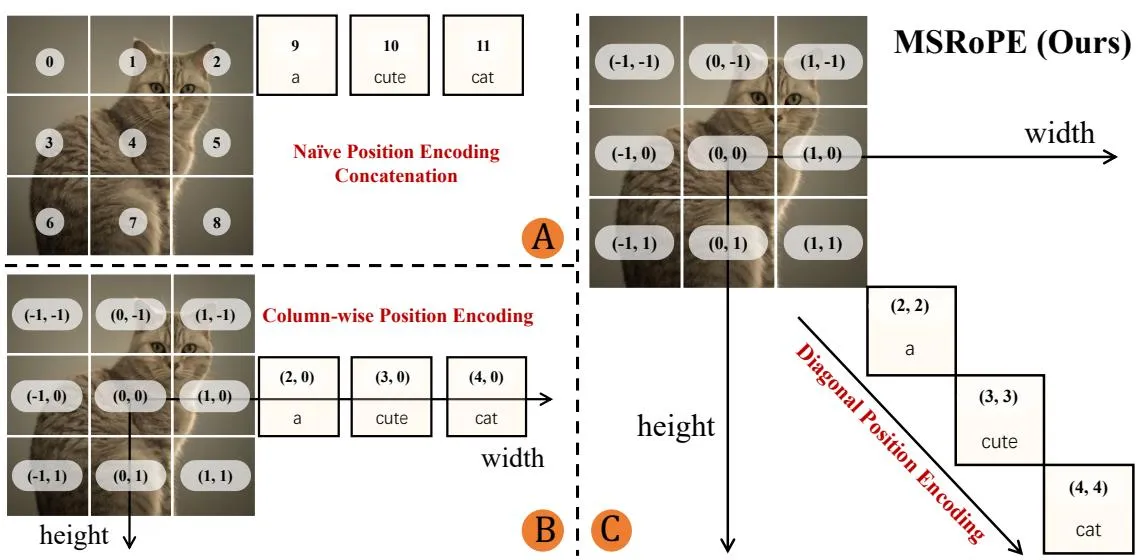
传统问题:ScalingROPE 假设图像为正方形,导致非正方形图像的纵横比信息丢失。
MSRoPE 解决方案:
- 将图像视为 2D 网格(m × n)
- 沿高度和宽度方向分别应用缩放
- 保持纵横比信息,支持任意分辨率
训练配置
| 组件 | 参数 |
|---|---|
| MLLM | Qwen2.5-VL-3B/7B |
| VAE | 24 层,C=192 |
| MMDiT | 38 层,D=4096,28 heads |
| 总参数量 | 3B / 7B |
四、数据管线
7 阶段数据处理
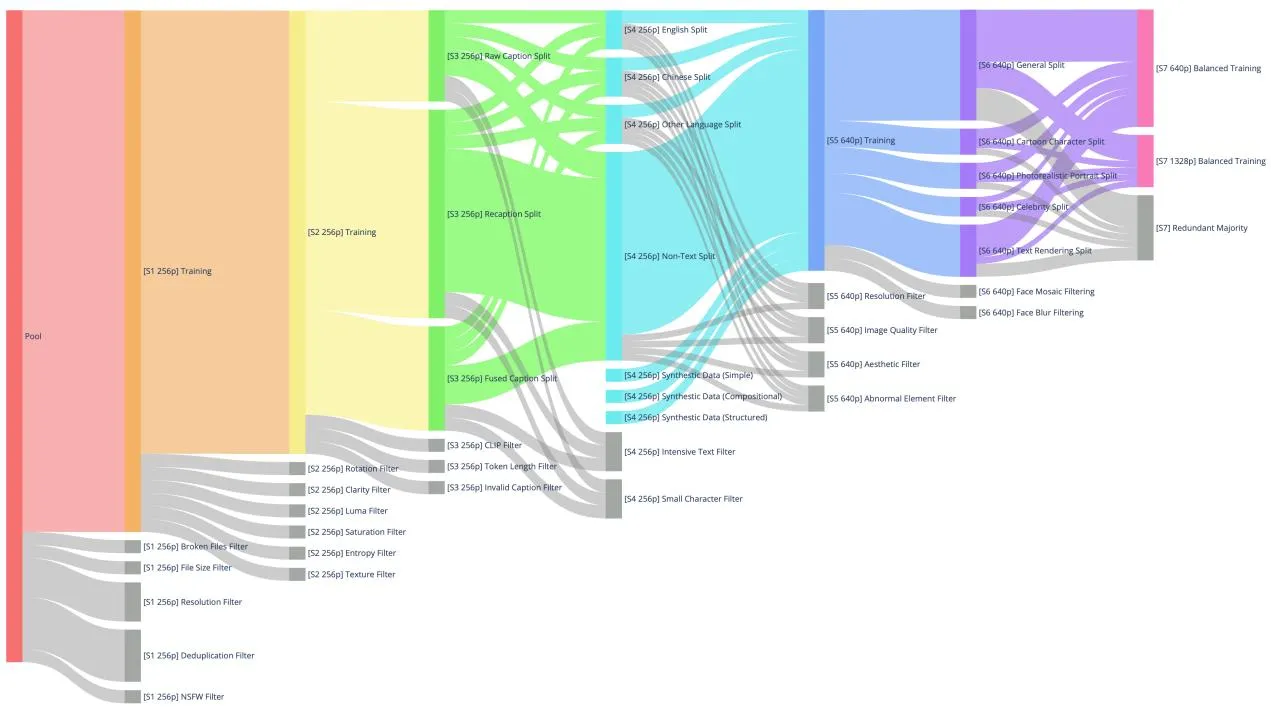
Stage 1:初始策划数据
- 从网络和内部来源收集图像
- 多级去重(感知哈希 + LSH + MinHash + 文本嵌入)
- 基于规则的过滤
Stage 2:图像质量增强
- 旋转过滤器:去除方向异常图像
- 多样性过滤器:移除重复模式
- 美学过滤器:低质量图像
- 图像质量过滤器:水印、文本、噪声检测
Stage 3:文本-图像对齐改进
- CLIPScore 过滤
- Qwen2.5-VL 重新标注
- 支持中英文双语描述
Stage 4:文本渲染增强
- 识别图像中的文本区域
- OCR 准确性验证
- 低质量文本图像过滤
Stage 5:高分辨率精炼
- 逐步提升分辨率至 1328 像素
- 放大伪影检测
- 美学评分过滤
Stage 6:类别平衡和肖像增强
- 关键词驱动的过采样
- 肖像增强(表情、照明、构图合成)
Stage 7:平衡多尺度训练
- 基于 WeTokenNet 的采样策略
- 支持文本/非文本图像平衡
- 渐进式分辨率提升
数据集组成
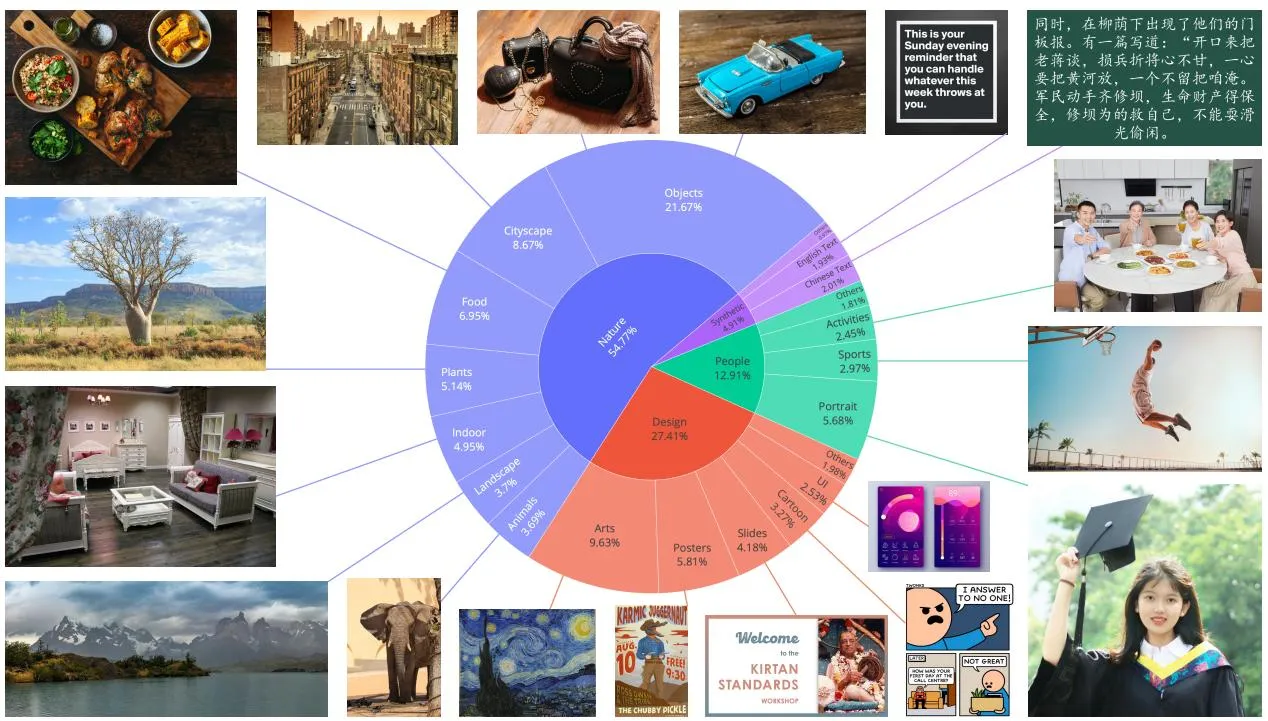
| 类别 | 占比 | 说明 |
|---|---|---|
| 自然 | ~40% | 风景、动物、植物等 |
| 设计 | ~20% | 图形、插图、海报等 |
| 人物 | ~27% | 肖像、人体姿态等 |
| 合成 | ~3% | 3D 渲染、AI 生成等 |
数据合成
| 方法 | 说明 |
|---|---|
| 纯渲染 | 无背景的文本图像 |
| 组合渲染 | 文本 + 背景图像合成 |
| 复杂渲染 | 完整场景中的文本渲染 |
五、训练策略
预训练
渐进式训练策略:
| 阶段 | 分辨率 | 数据 | 目标 |
|---|---|---|---|
| 初始 | 256-576 | 非文本图像 | 基础视觉表示 |
| 中期 | 576-1024 | 文本图像 | 文本渲染能力 |
| 后期 | 1024-1328 | 高质量数据 | 细节和质量 |
关键设计:
- 激活检查点:节省内存
- 梯度累积:5 步
- 梯度裁剪:1.0
- 优化器:AdamW (β₁=0.9, β₂=0.95)
- 学习率:cosine 调度
后训练
监督微调 (SFT)
- 分层组织的语义类别数据集
- 精细的人工标注
- 重点提升真实性和细节
强化学习 (RL)
双重 RL 策略:
1. Direct Preference Optimization (DPO)
- 构建偏好对(chosen/rejected)
- 基于人工标注的偏好数据
- 目标:提升人类偏好对齐
2. Group Relative Policy Optimization (GRPO)
- 组内相对奖励标准化
- 无需单独的 Critic 网络
- 公式:
六、实验结果
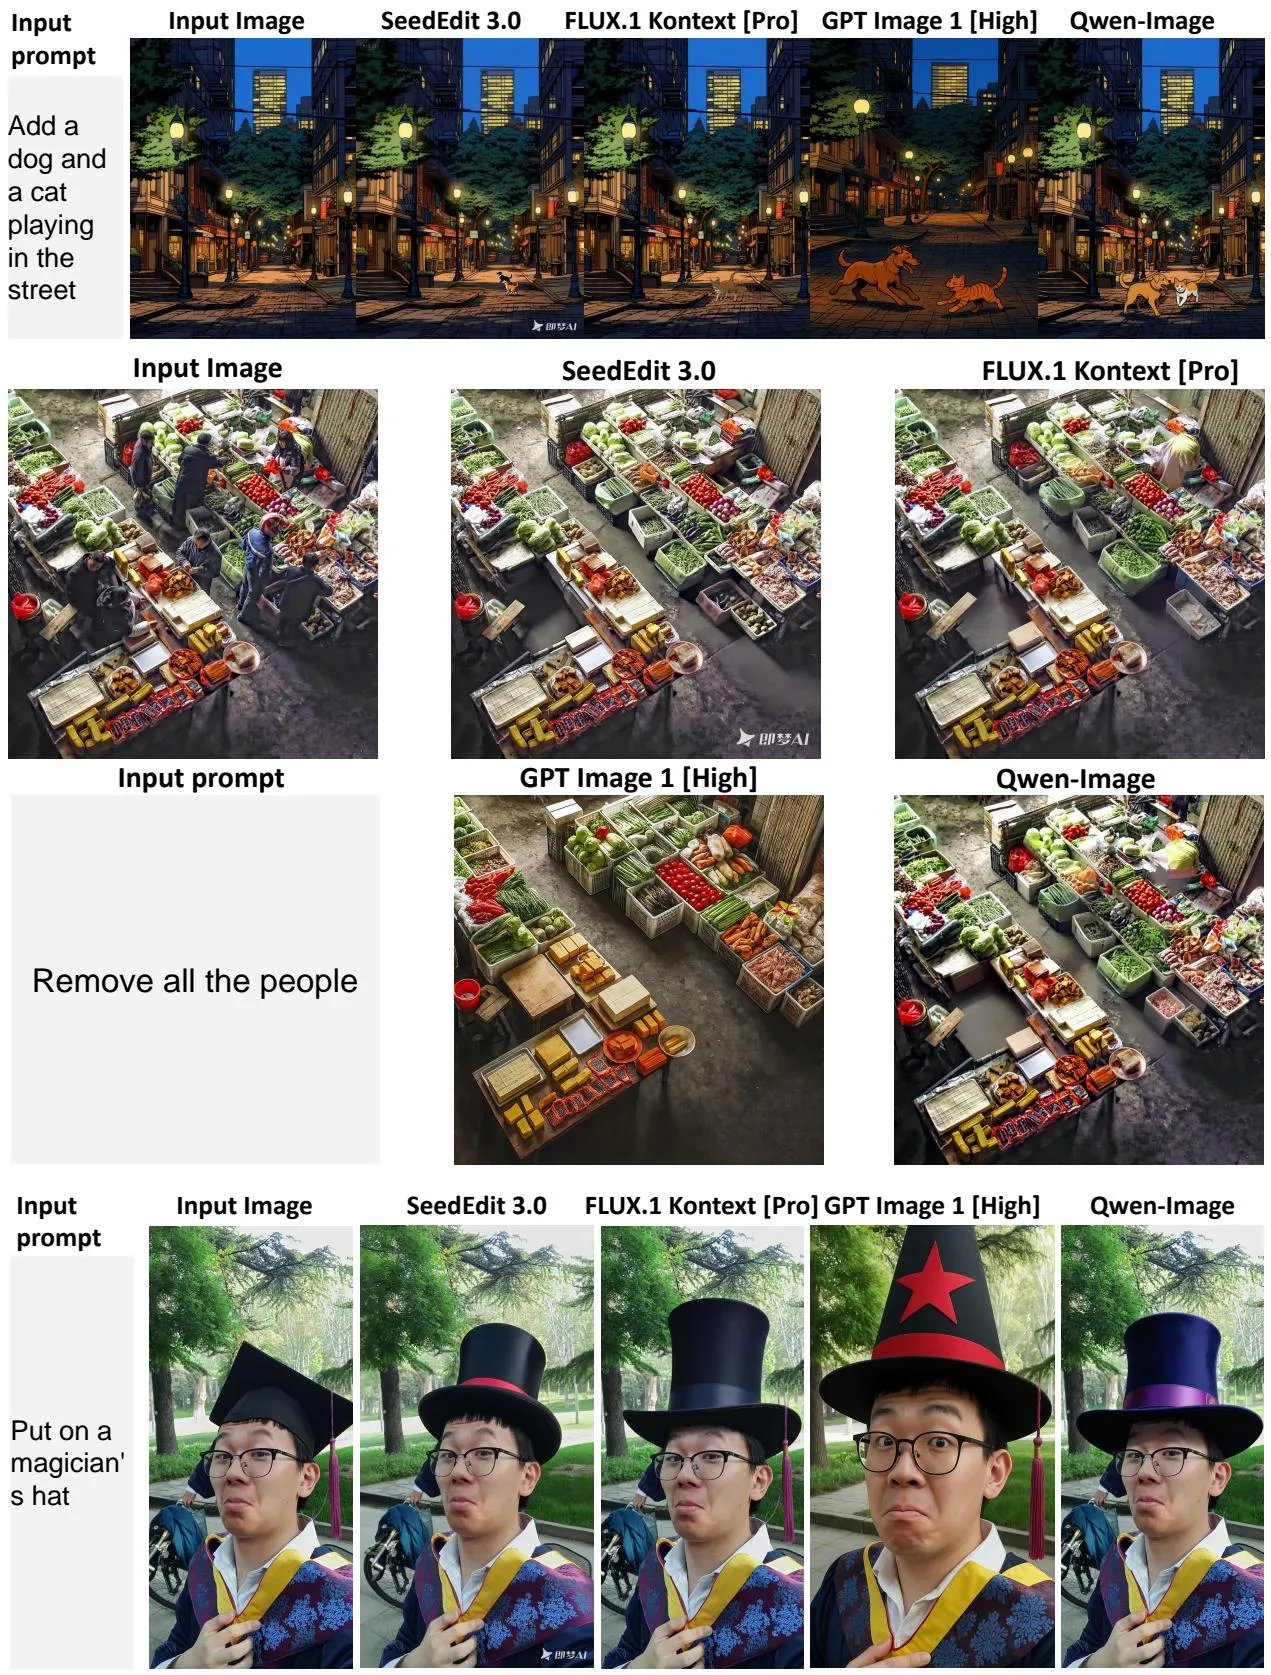
对象编辑对比
DPG-Bench 评估
| 模型 | Global | Entity | Attribute | Relation | Overall |
|---|---|---|---|---|---|
| SD 1.5 | 74.63 | 72.23 | 75.39 | 71.80 | 63.18 |
| Playground v2.5 | 85.09 | 82.43 | 86.43 | 85.61 | 83.50 |
| FLUX.1-dev | 84.08 | 82.43 | 84.53 | 86.50 | 82.58 |
| Seedream 3.0 | 84.55 | 83.43 | 83.44 | 86.51 | 83.60 |
| GPT Image 1 (High) | 90.73 | 91.20 | 89.26 | 90.46 | 86.54 |
| Qwen-Image | 91.32 | 91.56 | 92.02 | 94.31 | 92.73 |
关键发现:
- Global 一致性: 91.32(最高)
- Entity 一致性: 91.56(最高)
- Attribute 一致性: 92.02(最高)
- Relation 一致性: 94.31(最高)
- Overall: 88.32(第二,仅次于 GPT Image 1)
GenEval 评估
| 模型 | 单对象 | 双对象 | 计数 | 颜色 | 位置 | 属性 | Overall |
|---|---|---|---|---|---|---|---|
| Show-o | 0.95 | 0.80 | 0.68 | 0.49 | 0.42 | 0.57 | 0.53 |
| Emu3-Gen | 0.98 | 0.80 | 0.72 | 0.69 | 0.44 | 0.59 | 0.56 |
| FLUX.1-dev | 0.99 | 0.95 | 0.81 | 0.79 | 0.28 | 0.75 | 0.66 |
| Janus-Pro-7B | 0.97 | 0.96 | 0.86 | 0.76 | 0.70 | 0.84 | 0.81 |
| GPT Image 1 | 1.00 | 0.99 | 0.87 | 0.86 | 0.86 | 0.97 | 0.94 |
| Qwen-Image | 1.00 | 0.98 | 0.84 | 0.84 | 0.89 | 0.95 | 0.91 |
关键发现:
- 位置理解: 0.89(最高)
- 属性理解: 0.95(第二)
- Overall: 0.91(第二,仅次于 GPT Image 1)
文本渲染能力
英文文本渲染(Figure 18-19):
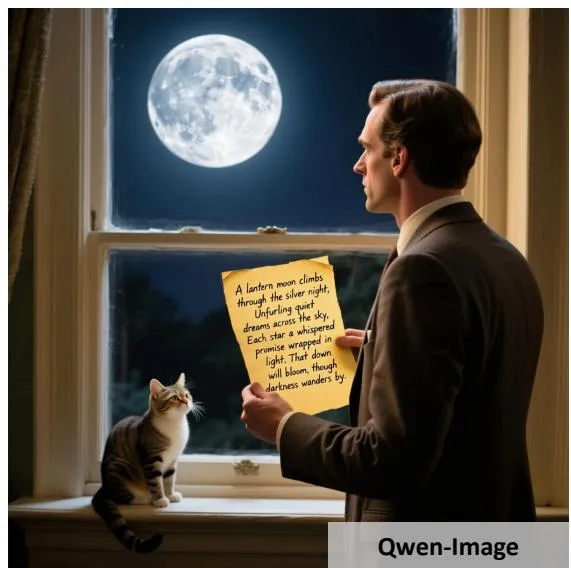
- 段落级文本准确渲染
- 多位置文本一致性
- 接近 GPT Image 1 的质量
中文文本渲染(Figure 20-21):
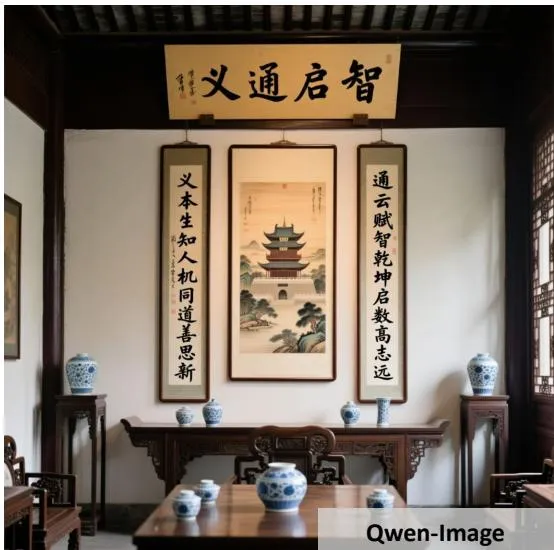
- 唯一能准确渲染长中文文本的模型
- 多对象文本一致性
- 复杂场景中的文本保持
图像编辑能力
- 风格迁移
- 文本编辑
- 背景更改
- 对象添加/删除/替换
- 姿态操作
- 漫画生成
七、与现有方法对比
| 方法 | 类型 | 文本渲染 | 图像编辑 | 多语言 | 开源 |
|---|---|---|---|---|---|
| Stable Diffusion | 扩散模型 | 一般 | 基础 | 英文 | ✓ |
| FLUX.1 | 扩散模型 | 良好 | 良好 | 英文 | ✓ |
| Seedream 3.0 | 扩散模型 | 良好 | 良好 | 中英文 | × |
| GPT Image 1 | 闭源模型 | 优秀 | 优秀 | 多语言 | × |
| Qwen-Image | 扩散模型 | 优秀 | 优秀 | 中英文 | ✓ |
独特优势:
- 中文文本渲染最强:唯一能准确渲染长中文文本的开源模型
- 全面能力:文本渲染 + 图像编辑 + 多语言支持
- 开源可用:代码和模型权重公开
八、相关工作
| 方向 | 代表工作 | 与 Qwen-Image 的关系 |
|---|---|---|
| 文本到图像 | Stable Diffusion, FLUX | 基础架构 |
| 文本渲染 | GlyphFLUX, TextCtrl | 文本渲染技术 |
| 图像编辑 | InstructPix2Pix, IP2P | 编辑任务 |
| 多模态 LLM | Qwen2.5-VL | 语义理解基础 |
| 扩散 Transformer | MMDiT, DiT | 核心架构 |
九、总结
核心贡献
- 复杂文本渲染:首个能准确渲染段落级中文文本的开源模型
- 7 阶段数据管线:从收集到平衡的完整数据处理流程
- 渐进式训练策略:从非文本到文本,从简单到复杂
- MSRoPE 位置编码:支持多种分辨率,保持纵横比
- 双编码机制:Qwen2.5-VL + VAE,语义一致性 + 视觉保真度
- DPO + GRPO:双重强化学习提升生成质量
- SOTA 性能:DPG-Bench 91.32,GenEval 0.91
技术影响
- 为中文文本图像生成树立了新标杆
- 开源模型中综合能力最强
- 渐进式训练策略可推广到其他生成任务
- 数据管线设计为大规模图像生成提供了参考
局限性
- 模型较大(3B/7B),推理资源需求高
- 高分辨率生成速度较慢
- 某些极端复杂场景仍有提升空间
- 代码开源但完整训练流程未公开
十、参考资源
- 论文: arXiv:2508.02324
- 代码: GitHub: QwenLM/Qwen-Image
- 关键引用:
- Qwen2.5-VL — 语义理解基础
- FLUX.1 — VAE 架构
- MMDiT — 扩散 Transformer
- DPO — 偏好优化
- GRPO — 组相对策略优化
分析日期: 2026-06-05