TaiChi: Prefill-Decode Aggregation or Disaggregation? Unifying Both for Goodput-Optimized LLM Serving
TaiChi提出一种统一的LLM推理服务系统,通过混合模式推理和延迟迁移调度策略,在任意TTFT和TPOT SLO组合下实现最优goodput。
TaiChi: Prefill-Decode Aggregation or Disaggregation? Unifying Both for Goodput-Optimized LLM Serving
一、论文概述 (Overview)
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 标题 | TaiChi: Prefill-Decode Aggregation or Disaggregation? Unifying Both for Goodput-Optimized LLM Serving |
| arXiv ID | 2508.01989 |
| 作者 | Chao Wang, Pengfei Zuo, Zhangyu Chen, Yunkai Liang, Zhou Yu, Ming-Chang Yang |
| 机构 | 香港中文大学 (CUHK), 华为云, 中山大学 |
| 发表日期 | 2025-08-01 |
| 领域 | cs.DC (分布式系统), cs.LG (机器学习) |
1.2 摘要
LLM推理服务中存在一个持续争论:预填充-解码(PD)聚合与PD分离哪种方式更优。本文系统比较了两种方法,发现各自在不同服务等级目标(SLO)下各有优势:聚合模式在严格TTFT和宽松TPOT下最优,而分离模式在严格TPOT和宽松TTFT下最优。然而在平衡TTFT和TPOT SLO的场景下,两种方式都无法提供最优goodput。
基于此洞察,本文提出TaiChi——一种统一的LLM推理服务系统,通过三种可配置滑块控制预填充密集型(P-heavy)和解码密集型(D-heavy)GPU实例的比例和chunk大小,实现任意TTFT/TPOT SLO组合下的最优goodput。核心创新是延迟迁移(Latency Shifting):将满足SLO请求的富余GPU资源重新分配给面临SLO违规风险的请求。TaiChi在平衡SLO下相比最先进系统最多提升77% goodput。
1.3 核心贡献
- 系统性对比分析: 首次全面比较PD聚合与分离,揭示各自在不同SLO下的优劣边界
- 发现平衡SLO困境: 证明在平衡TTFT和TPOT约束下,两种方法都无法达到最优goodput
- 延迟迁移调度范式: 提出跨相位、跨请求的细粒度延迟迁移机制
- 混合模式推理: 统一聚合的批处理效率和分离的请求级精细控制
- 两个调度算法: 流动解码调度(Flowing Decode)和长度感知预填充调度(Length-aware Prefill)
- 原型实现与评估: 基于vLLM实现,在Qwen2.5模型上验证,最高77% goodput提升
二、核心思想 (Core Ideas)
2.1 问题定义
LLM推理服务面临的核心挑战是在满足SLO约束的前提下最大化goodput:
- TTFT (Time-to-First-Token): 预填充阶段延迟,反映系统响应速度
- TPOT (Time-per-Output-Token): 解码阶段平均延迟,反映用户感受到的生成速度
- Goodput: 同时满足TTFT和TPOT SLO约束的请求吞吐量
2.2 PD聚合与PD分离的困境
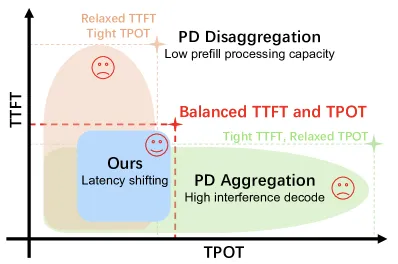
| 方法 | 优势 | 劣势 | 适用场景 |
|---|---|---|---|
| PD聚合 (如Orca, Sarathi-Serve) | 优秀TTFT,高GPU利用率 | 高TPOT(预填充干扰) | 严格TTFT + 宽松TPOT |
| PD分离 (如Splitwise, DistServe) | 优秀TPOT,消除干扰 | 高TTFT(请求排队) | 严格TPOT + 宽松TTOT |
| TaiChi | 两者兼得 | 需要差异化实例配置 | 任意SLO组合 |
关键观察 (Observation 1): PD聚合在严格TTFT和宽松TPOT约束下表现最佳,PD分离在严格TPOT和宽松TTFT下更有效。然而当TTFT和TPOT约束平衡时,两种方法都难以有效满足SLO。
实验数据 (QPS=12, 平衡SLO: TTFT≤6s, TPOT≤100ms):
- PD聚合 SLO达成率: 16%
- PD分离 SLO达成率: 50%
- TaiChi目标: 显著超越两者
2.3 瓶颈根因分析
TPOT瓶颈 (PD聚合):
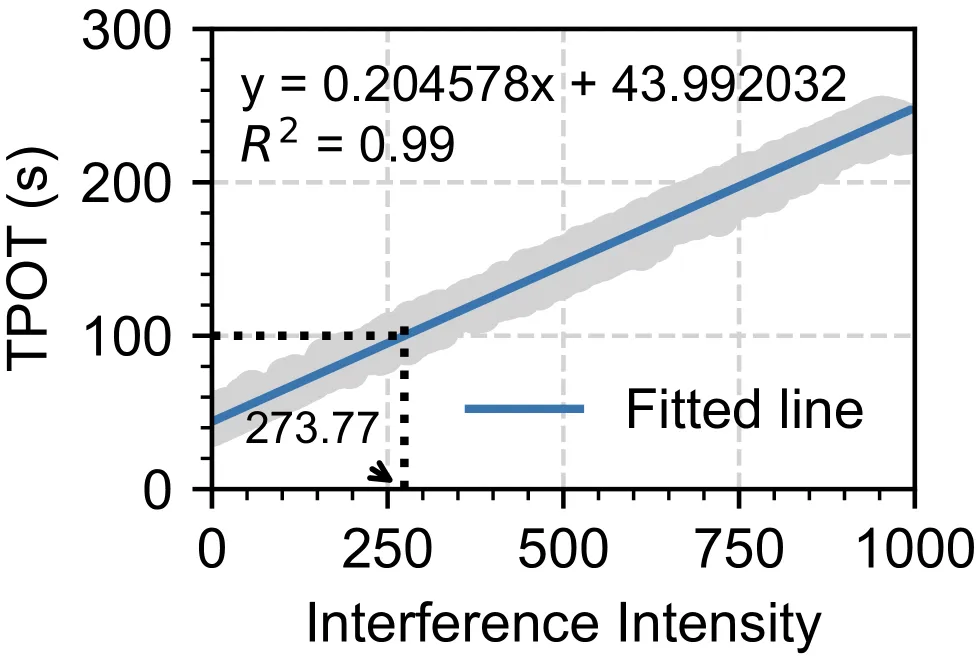
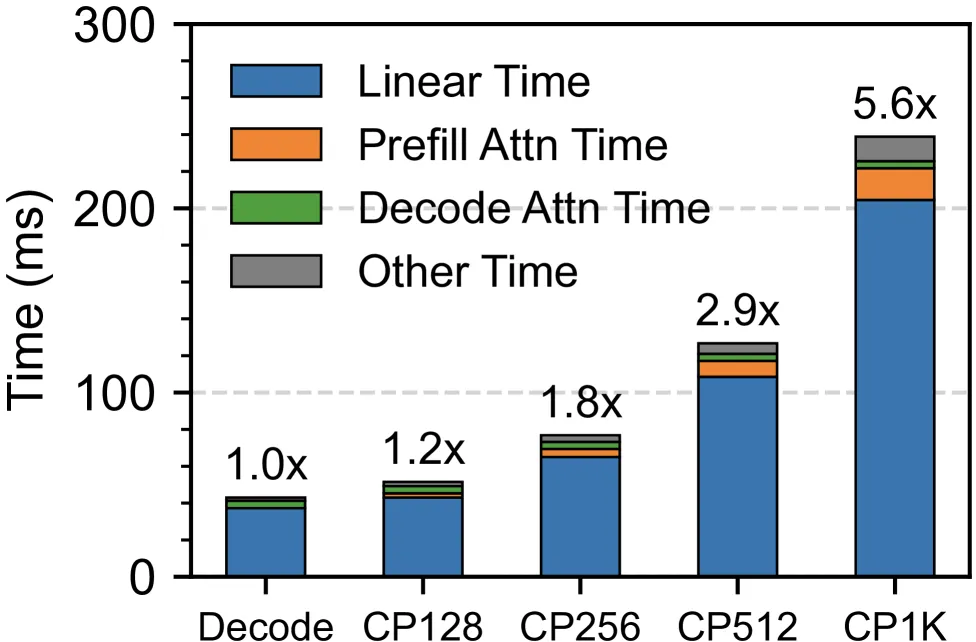
Observation 2: PD聚合的高TPOT源于计算绑定的线性操作的预填充干扰,干扰强度与TPOT呈强线性关系(R²=0.99)。
定义干扰强度 = 解码请求期间计算的预填充token总数 / 输出长度 (预填充token per output token)
TPOT拟合方程: TPOT = 0.2ms × 干扰强度 + 44ms
若要保持TPOT≤100ms,必须将干扰强度限制在<273.77。
TTFT瓶颈 (PD分离):
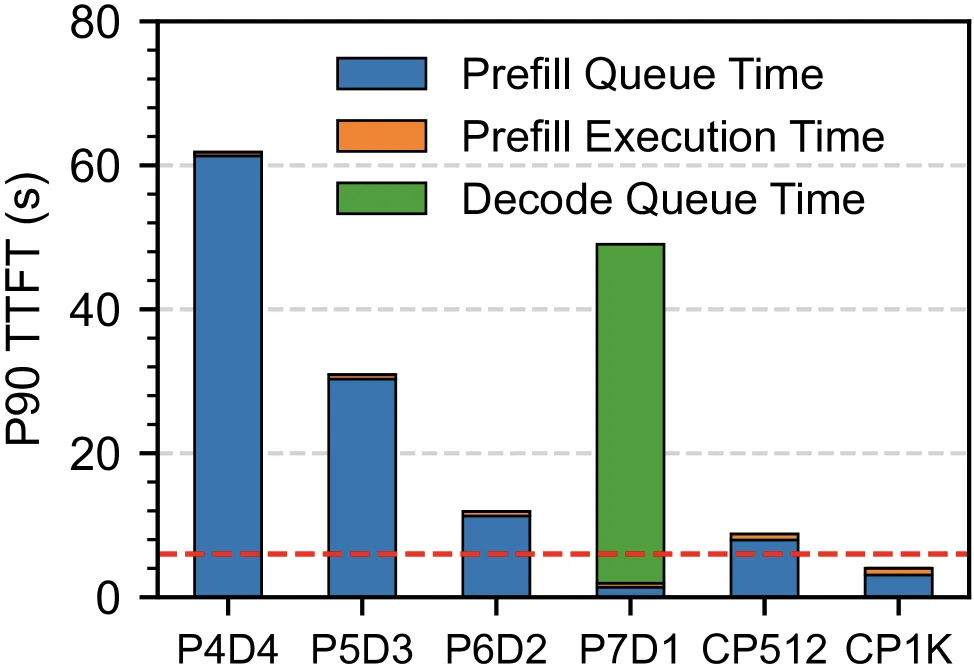
Observation 3: PD分离的高TTFT源于请求排队,因为PD分离提供的预填充处理能力低于PD聚合。
2.4 延迟迁移调度范式
核心思想:将超出SLO约束请求的延迟转移到显著满足SLO要求的请求上,最大化SLO合规的请求数量。
两大机会:
- 富余延迟空间: PD聚合中>75%请求TTFT<60% SLO约束;PD分离中100%请求TPOT<60% SLO约束,留有大量延迟容纳空间
- 跨相位延迟转移: 通过调度策略优先分配GPU时间给特定请求,可实现TTFT/TPOT的跨相位转移
三、技术架构 (Technical Architecture)
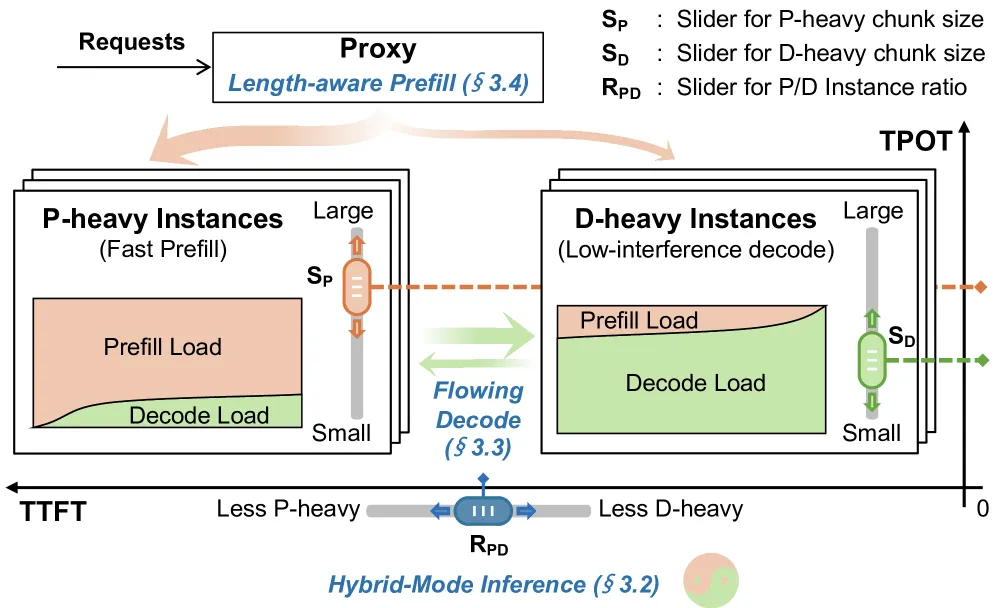
3.1 系统架构
TaiChi由代理(proxy)和多种推理实例组成:
| 实例类型 | Chunk大小 | 预填充能力 | 解码干扰 | 适用场景 |
|---|---|---|---|---|
| P-heavy (预填充密集型) | 大 (如1024) | 高 | 高 (TPOT高) | 低TTFT需求 |
| D-heavy (解码密集型) | 小 (如128-512) | 低 | 低 (TPOT低) | 低TPOT需求 |
三个可配置滑块:
- P-heavy与D-heavy实例比例
- P-heavy实例的chunk大小
- D-heavy实例的chunk大小
3.2 混合模式推理 (Hybrid-Mode Inference)
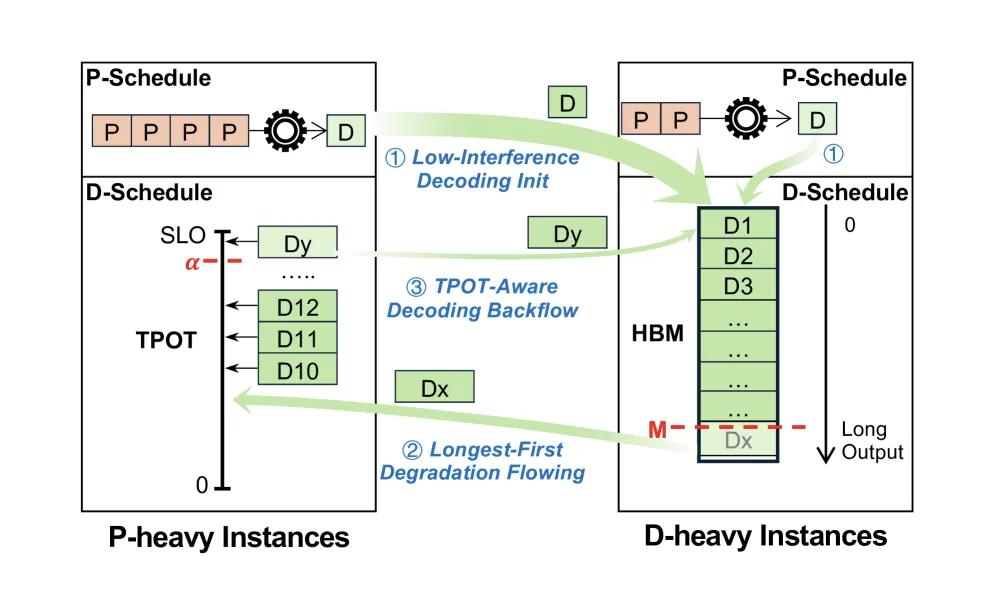
混合模式统一了两个调度原则:
| 原则 | 来源 | 目的 |
|---|---|---|
| 聚合批处理 (Aggregated Batch Handling) | PD聚合 | 高资源利用率 |
| 分离请求处理 (Disaggregated Request Handling) | PD分离 | 细粒度延迟控制 |
关键创新: 单个请求的预填充和解码可以在不同实例上执行。例如:
- 正常请求: 预填充→P-heavy (低TTFT),解码→D-heavy (低TPOT)
- 降级请求: 预填充→D-heavy,解码→P-heavy (释放专用资源给关键请求)
3.3 流动解码调度 (Flowing Decode Scheduling)
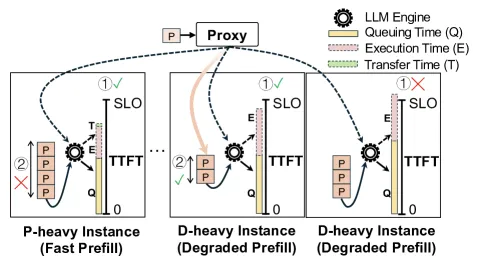
三个阶段:
-
低干扰解码启动: 请求预填充完成后,首先调度到D-heavy实例开始低干扰解码,防止过早TPOT违规
- 若预填充在P-heavy: 调度到D-heavy中decode负载最低的实例
- 若预填充在D-heavy: 就地decode,最小化KV cache传输
-
最长优先降级流动: 当D-heavy实例HBM使用率达到水线M (如95%)时,选择性地将部分解码请求卸载到P-heavy实例
- 选择策略: 按当前输出长度降序,优先卸载长输出请求
- 释放内存:
m_release += r_memory*,直到剩余容量<M
-
P-heavy安全TPOT保障: P-heavy实例上的请求集合O只包含已接近TPOT SLO的请求
O = {r ∈ S | r_tpot > τ_tpot × α}(α为approaching因子)
算法1伪代码 (解码调度):
输入: 解码请求集S, TPOT SLO τ_tpot, 当前内存m, 实例类型type, 逼近因子α, 内存水线M
输出: 优化集O或降级集D

if type == P-heavy then
    O ← {r ∈ S | r_tpot > τ_tpot * α}    ▷ 接近SLO的请求
    return O
else if type == D-heavy then
    D ← ∅, m_release ← 0
    while m - m_release > M do
        r* ← argmax_{r∈S\D} (r_current_output_len)   ▷ 最长输出优先
        D ← D ∪ {r*}
        m_release ← m_release + r*_memory
    return D
3.4 长度感知预填充调度 (Length-aware Prefill Scheduling)
核心思想: 利用短预填充请求的低紧迫性,将它们路由到D-heavy实例,故意减慢其执行以释放P-heavy实例给更耗时、更长时间的预填充请求。
代理调度算法:
输入: 请求r, 实例集I, TTFT SLO τ_ttft
输出: 调度实例i* 或 ∅

I' ← ∅    // 可行实例集
for each i ∈ I do
    Q ← Σ_{r'∈i.queue} Estimate(r'.len, i.chunk, i.batch)    // 排队时间
    E ← Estimate(r.len, i.chunk, i.batch)                      // 执行时间
    T ← I{i_type=P-heavy} · r_transfer_size / link_bw          // 传输时间
    if Q + E + T < τ_ttft then
        I' ← I' ∪ {i}    // 加入可行集

if I' == ∅ then
    return 任意实例 (SLO已无法满足)
else
return argmin_{i∈I'} (i_queued_tokens) // 选择排队token最少估计函数: Estimate(len, chunk, batch) 基于Vidur模型,考虑请求长度、实例配置和批处理信息。
3.5 实现
基于开源vLLM框架构建:
- 使用vLLM的chunked prefill实现,为P-heavy和D-heavy实例配置不同chunk大小
- 扩展vLLM的KV传输模块,支持任意两实例间通过NCCL通信
- 将KV传输从模型执行关键路径解耦,实现异步传输
- 使用fused CUDA算子存储接收的KV cache到vLLM的paged memory,降低CPU开销
四、核心创新 (Key Innovations)
| 创新点 | 说明 | 影响 |
|---|---|---|
| 延迟迁移范式 | 首次提出跨相位、跨请求的细粒度延迟重新分配 | 解决平衡SLO下的goodopt困境 |
| 混合模式推理 | 统一聚合批处理效率和分离请求级控制 | 打破PD聚合/分离的二选一局限 |
| 差异化能力实例 | 纯通过chunk大小配置实现能力分化 | 无需额外硬件改动 |
| 流动解码调度 | 动态迁移解码请求到P-heavy实例释放内存 | 请求级TPOT精细控制 |
| 长度感知预填充调度 | 基于估计TTFT和实例队列状态的智能路由 | 请求级TTFT精细控制 |
| 三个可调滑块 | 实例比例+两种chunk大小 | 灵活适配任意SLO regime |
五、实验结果 (Experimental Results)
5.1 实验设置
| 配置项 | 详情 |
|---|---|
| 硬件 | 8× NVIDIA SXM A100-80GB GPUs (NVLink连接) |
| 模型 | Qwen2.5-14B, Qwen2.5-32B (FP16) |
| 数据集 | ShareGPT (聊天), Arxiv Summarization (摘要) |
| SLO配置 | SLO1: 低TTFT/高TPOT; SLO2: 高TTFT/低TPOT |
| 基线 | PD聚合 (Sarathi-Serve/Chunked Prefill), PD分离 (Splitwise/DistServe) |
5.2 Goodput提升 (端到端)
Chatbot (ShareGPT) 结果:
| 模型 | SLO | vs PD聚合 | vs PD分离 |
|---|---|---|---|
| Qwen2.5-14B | SLO1 | +9~11% | +43~49% |
| Qwen2.5-14B | SLO2 | +24~25% | +29~37% |
| Qwen2.5-32B | SLO1 | 类似趋势 | 类似趋势 |
| Qwen2.5-32B | SLO2 | 类似趋势 | 类似趋势 |
摘要任务 (Arxiv) 结果: 摘要任务使用更长预填充提示,要求更快输出,TTFT更高但TPOT约束更紧,TaiChi优势更明显。
5.3 延迟降低
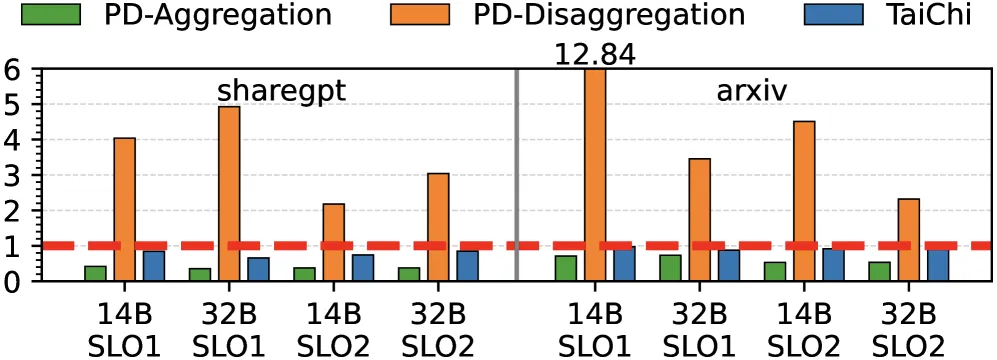
| 对比 | P90延迟降低倍数 |
|---|---|
| TTFT vs PD分离 | 2.42× ~ 13.20× |
| TPOT vs PD聚合 | 1.11× ~ 1.69× |
5.4 性能分解 (逐步添加技术)
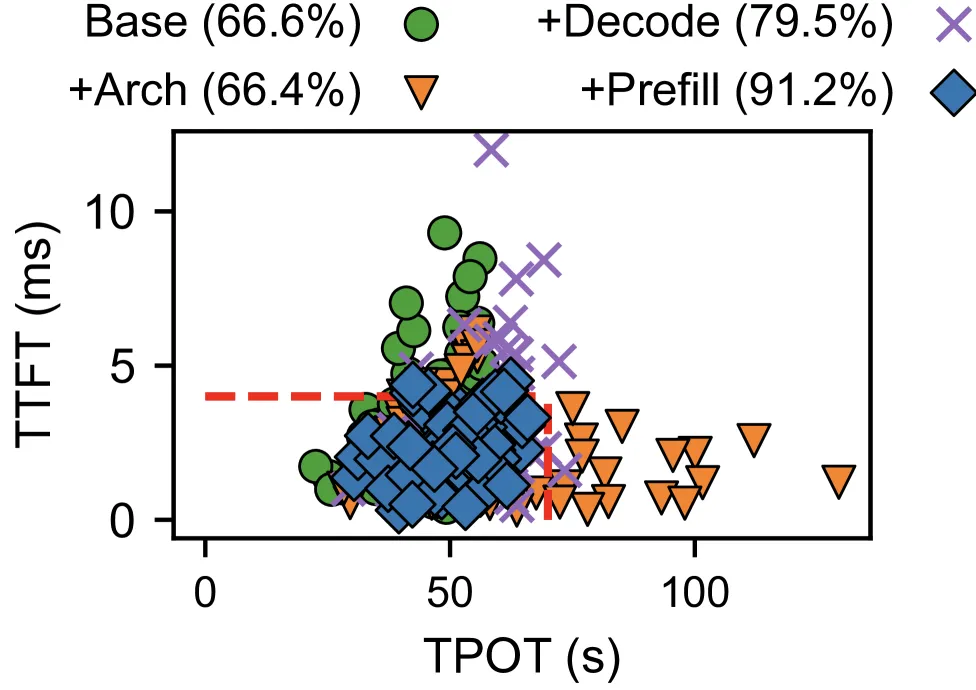
从基础PD聚合(CP256)逐步添加技术:
- Base (CP256): SLO达成率 66.6%
- +Arch (混合架构): 提供延迟迁移基础
- +Flowing Decode: TPOT改善,SLO达成率+12.9%
- +Length-Aware Prefill: TTFT改善,SLO达成率再+11.7%
- 最终: 91.2% SLO达成率
5.5 开销分析
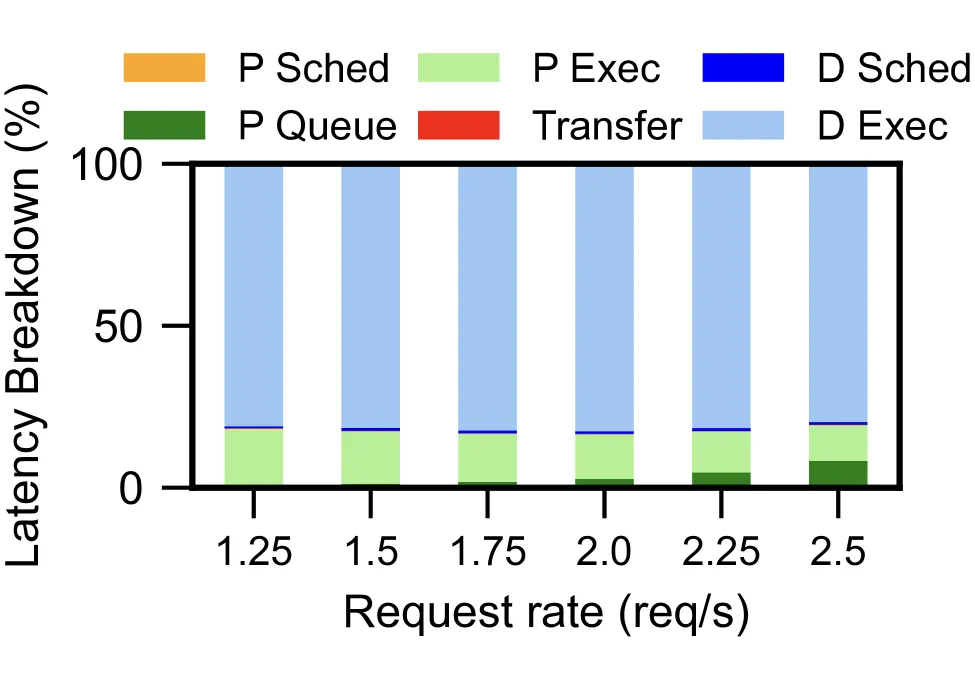
| 开销源 | 占总请求时间比例 |
|---|---|
| KV Cache传输 | 0.20% |
| 预填充调度 | 0.01% |
| 解码调度 | 0.89% |
| 总开销 | ~1.1% |
传输开销得益于现代高速互联,调度开销得益于轻量级算法设计。
5.6 预填充处理能力
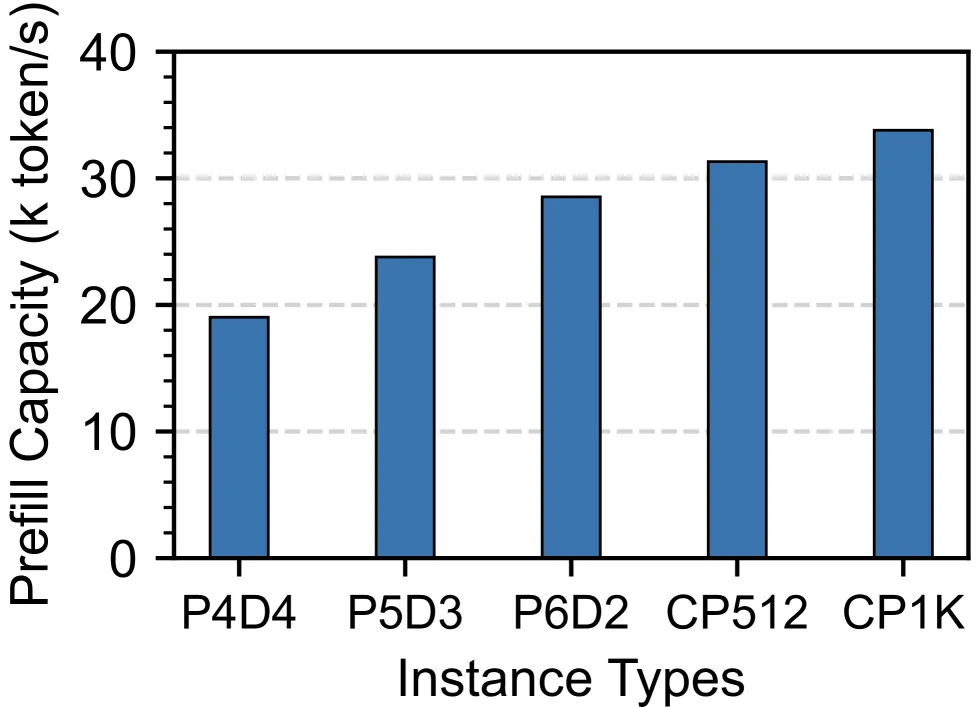
TaiChi的D-heavy实例可补充PD分离缺乏的预填充处理能力,这是TaiChi相比纯PD分离获得更高goodput的关键原因之一。
六、相关工作 (Related Work)
PD聚合系统
| 系统 | 关键思想 | 与TaiChi区别 |
|---|---|---|
| Orca | 连续批处理,迭代级请求进出 | 仅优化聚合,不考虑分离 |
| Sarathi-Serve | Chunked prefill减少decode stall | 专注聚合,无法消除预填充干扰 |
| FastServe | 迭代级抢占式调度 | 仅聚合场景 |
| NanoFlow | 纳米批重叠计算/内存/网络 | 正交于TaiChi |
| SOLA | PD聚合优化模型 | 仅聚合 |
PD分离系统
| 系统 | 关键思想 | 与TaiChi区别 |
|---|---|---|
| DistServe | 物理分离预填充/解码 | 仅分离,无法聚合 |
| Splitwise | 独立扩缩预填充/解码 | 仅分离 |
| Adrenaline | 卸载decode的attention计算 | 仅分离优化 |
| DynaServe | 虚拟子请求拆分 (同期独立开发) | 不同于延迟迁移范式 |
TaiChi的独特性
TaiChi是首个统一PD聚合和PD分离的系统,在单一架构内实现两者的优势互补,而非在两者之间做选择。
七、总结 (Conclusion)
7.1 核心成就
- 系统性洞察: 揭示了PD聚合与分离在不同SLO下的优劣边界,以及平衡SLO下的固有困境
- 架构创新: 提出差异化能力实例+混合模式推理的统一架构
- 调度创新: 流动解码调度和长度感知预填充调度实现请求级延迟精细控制
- 性能突破: 平衡SLO下最高77% goodput提升,P90 TTFT降低高达13.2×
- 低开销: 总调度+传输开销仅~1.1%,实际部署可行
7.2 适用场景
TaiChi特别适合:
- 需要同时满足TTFT和TPOT SLO的生产环境
- SLO要求多样化的多租户LLM服务
- 需要灵活调整TTFT/TPOT权衡的服务提供商
- 已有多GPU集群且可通过chunk配置实现能力差异化的场景
7.3 局限性
- 当前仅在单节点8 GPU上验证,需要多节点扩展评估
- 依赖NCCL高速互联进行KV cache传输,对网络带宽有一定要求
- 三个滑块需要运维人员根据SLO手动调优(未来可自动化)
- 未评估与Speculative Decoding、MoE等技术的结合
八、参考资源 (References)
论文链接
关键参考文献
| 编号 | 论文 | 关键贡献 |
|---|---|---|
| [1] | Vidur (Agrawal et al., 2024) | LLM推理仿真框架,高精度内核延迟模拟 |
| [2] | Sarathi-Serve (Agrawal et al., 2024) | Chunked prefill减少decode stall |
| [3] | DistServe (Zhong et al., 2024) | PD分离推理系统 |
| [4] | Splitwise (Patel et al., 2024) | 物理分离预填充/解码 |
| [5] | Orca (Yu et al., 2022) | 连续批处理LLM推理 |
| [6] | vLLM | 主流LLM推理引擎 |
| [7] | SOLA (Hong et al., 2025) | PD聚合优化模型 |
| [8] | DynaServe (Ruan et al., 2025) | 同期独立开发的goodput优化系统 |
图表索引
| 图号 | 描述 | 文件名 |
|---|---|---|
| Figure 1 | 不同调度方法的请求TTFT/TPOT分布 | figure-1-ttft-tpot-distribution.png |
| Figure 2 | 不同QPS级别的TTFT/TPOT分布 | figure-2a-low-qps.png, figure-2b-high-qps.png |
| Figure 3 | 不同chunk大小的批执行时间分解 | figure-3-batch-execution-time.png |
| Figure 4 | TPOT与干扰强度的散点图(R²=0.99) | figure-4-tpot-interference-scatter.png |
| Figure 5 | PD聚合不同配置的延迟分布 | figure-5-pd-aggregation-latency.png |
| Figure 6 | PD分离不同配置的延迟分布 | figure-6-pd-disaggregation-latency.png |
| Figure 7 | P90 TTFT分解对比 | figure-7-p90-ttft-breakdown.png |
| Figure 8 | 不同配置的预填充处理能力 | figure-8-prefill-processing-capacity.png |
| Figure 9 | TTFT/TPOT CDF对比 | figure-9a-ttft-cdf-pd-aggregation.png, figure-9b-tpot-cdf-pd-disaggregation.png |
| Figure 10 | TPOT与解码长度的关系 | figure-10-tpot-decode-length.png |
| Figure 11 | TaiChi系统架构总览 | figure-11-system-overview.png |
| Figure 12 | 流动解码调度示意图 | figure-12-flowing-decode-scheduling.png |
| Figure 13 | 长度感知预填充调度示意图 | figure-13-length-aware-prefill-scheduling.png |
| Figure 14 | 数据集长度分布 | figure-14a-sharegpt-dist.png, figure-14b-arxiv-dist.png |
| Figure 15 | Goodput对比实验结果 | figure-15a-14b-slo1-goodput.png 等 |
| Figure 16 | SLO达成率对比 | figure-15a-14b-slo1-slo-attainment.png 等 |
| Figure 17 | 归一化延迟对比 | figure-17a-ttft-normalized.png, figure-17b-tpot-normalized.png |
| Figure 18 | 技术逐步添加的SLO达成率分解 | figure-18-slo-attainment-breakdown.png |
| Figure 19 | 请求延迟分解(开销分析) | figure-19-latency-breakdown.png |
分析日期: 2026-07-07 分析师: AI Paper Analyzer