H2SGEMM: Emulating FP32 GEMM on Ascend NPUs using FP16 Units with Precision Recovery
在华为 Ascend NPU 上使用 FP16 单元模拟 FP32 GEMM 的精度恢复方法
H2SGEMM: Emulating FP32 GEMM on Ascend NPUs using FP16 Units with Precision Recovery
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | H2SGEMM: Emulating FP32 GEMM on Ascend NPUs using FP16 Units with Precision Recovery and Cache-Aware Optimization |
| 作者 | 未在摘要中明确列出 |
| 机构 | 华为 Ascend 相关研究团队 |
| 论文 | arXiv:2507.23387 |
| 代码 | 未开源 |
| 发布 | 2025年7月 |
| 许可 | 未明确 |
二、核心思想
问题定义
现代 AI 加速器提供高吞吐量的低精度矩阵引擎,但它们对 FP32 GEMM 的支持通常有限或低效。例如:
- NVIDIA H100: FP8 Tensor Core 吞吐量约为 FP64 吞吐量的 60×
- 华为 Ascend 910A: FP16 吞吐量约 256 TFLOPS,但缺乏高效的 FP32 矩阵单元
这造成了一个关键挑战:最强大的计算平台针对与许多科学计算工作负载精度要求不兼容的格式进行了优化。
解决方案概述
本文提出 H2SGEMM(又称 SGEMM-cube),一种在 Ascend NPU 上使用 FP16 Cube 单元实现的精度恢复 FP32 GEMM 近似方法。
核心策略:两分量 FP32-to-FP16 分解(与 Ozaki-style 和 Ootomo-style 方案相关):
- 每个 FP32 操作数表示为一个 FP16 高位分量和一个缩放的 FP16 残差分量
- 矩阵乘积从主导的 high-high 和 high-low 项重建,省略 low-low 项
核心性能
- 精度: 对中等范围输入接近 FP32 SGEMM 精度
- 性能: 达到 65.3 TFLOPS,相当于 FP32 等效峰值的 77%
- 应用场景: 科学计算、需要 FP32 精度但硬件仅支持 FP16 的场景
三、技术架构
FP32 分解算法
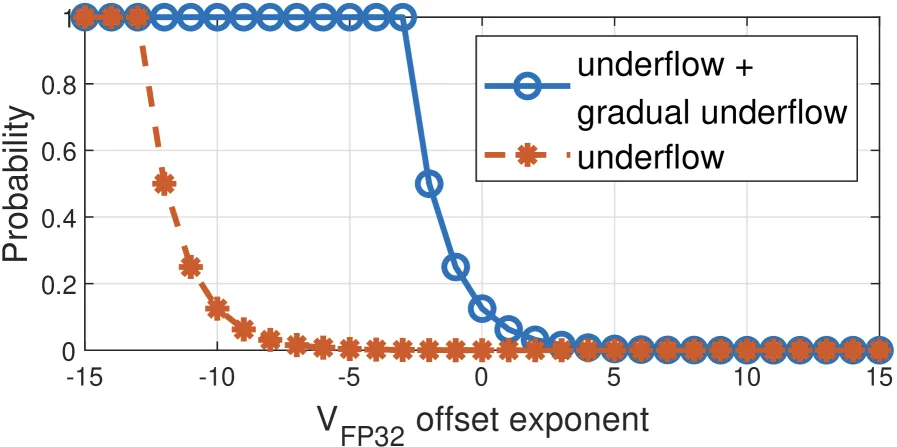
Figure 1: 将单个 FP32 浮点数分解为两个 FP16 浮点数
IEEE-754 FP32 格式
其中:
- : 符号位(1 位)
- : 指数位(8 位)
- : 无偏指数
- : 尾数位(23 位),带有隐含的前导 1
分解过程
FP32 值 可分解为高位部分 和低位部分 :
- 高位分量: 使用 round-to-nearest-even (RN) 规则计算
- 残差分量: ,缩放后表示为 FP16
矩阵乘积重建
对于矩阵乘法 ,使用分解后的分量:
省略 low-low 项: 被忽略,因为它对最终结果的贡献很小。
DaVinci 架构
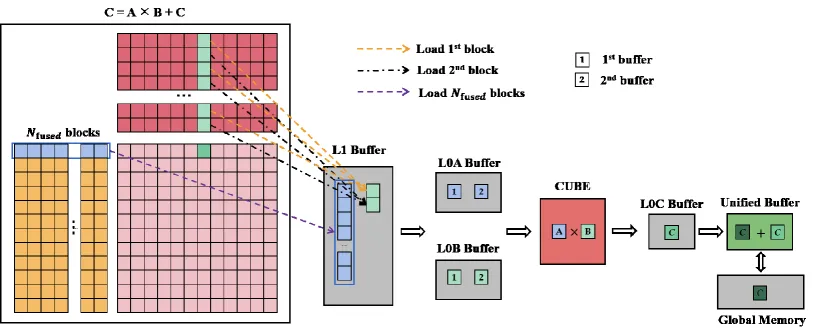
Figure 3: 华为 Ascend NPU AI Core 的 DaVinci 架构
Ascend 910A 配置:
- 32 个 AI Core,1 GHz 时钟
- 1.2 TB/s 内存带宽
- 无原生 FP32 矩阵单元
- FP16 吞吐量: ~256 TFLOPS
Ascend 910B3 配置:
- 20 个 AI Core,1.8 GHz 时钟
- 1.6 TB/s 内存带宽
- 支持原生 FP32 GEMM(理论峰值 73.73 TFLOPS)
L1 缓存感知分块
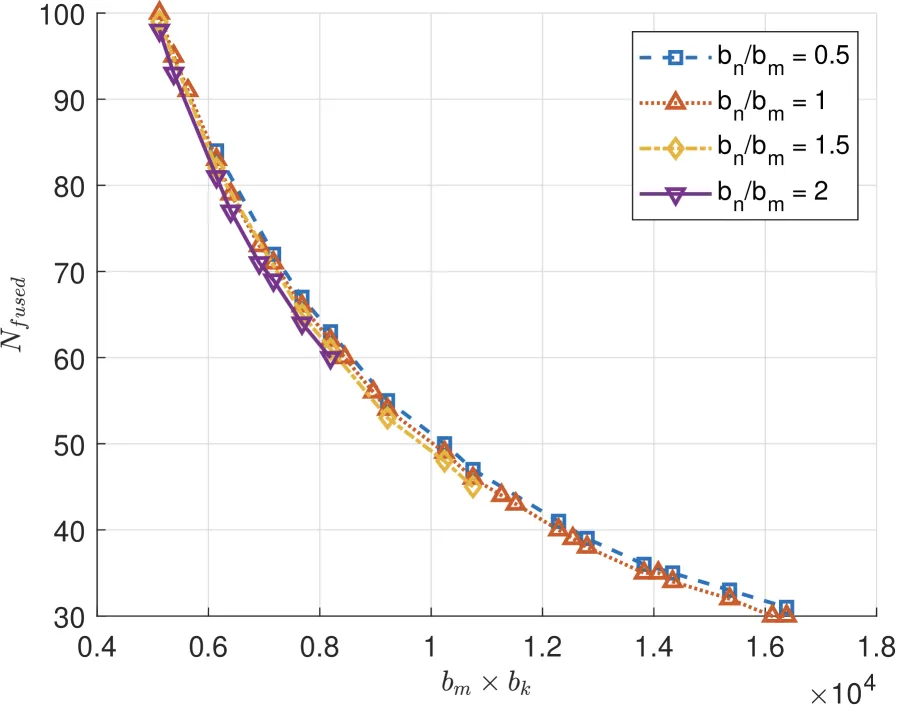
Figure 4: 基于 L1 缓存重用的矩阵分块
关键优化:
- 根据 L1 缓存大小选择最优的 分块大小
- 最大化 L1 缓存命中率
- 融合因子 优化数据重用
双缓冲流水线
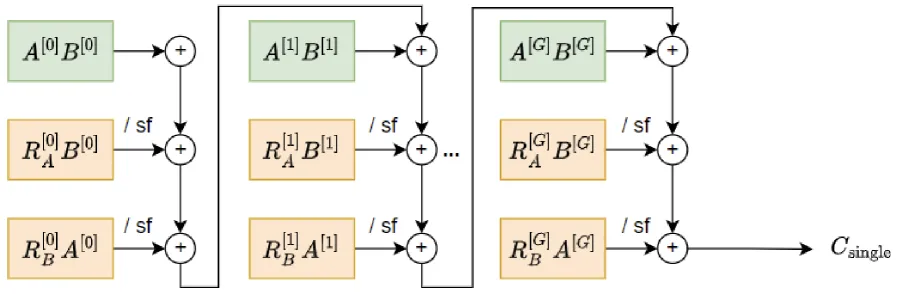
Figure 6: 基于 L1 重用的单缓冲和双缓冲流水线对比
双缓冲优化:
- 在计算当前 tile 的同时预取下一个 tile
- 隐藏内存访问延迟
- 提高计算单元利用率
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| FP32-to-FP16 分解 | 将 FP32 操作数分解为高位和残差分量 | 精度恢复接近 FP32 |
| 省略 low-low 项 | 忽略残差-残差乘积项 | 减少 33% 计算量 |
| L1 缓存感知分块 | 根据缓存大小优化分块 | 最大化数据重用 |
| 双缓冲流水线 | 重叠计算与数据加载 | 隐藏内存延迟 |
| 累积顺序优化 | 分析不同累积顺序对精度的影响 | 最小化数值误差 |
精度分析
下溢与渐进下溢
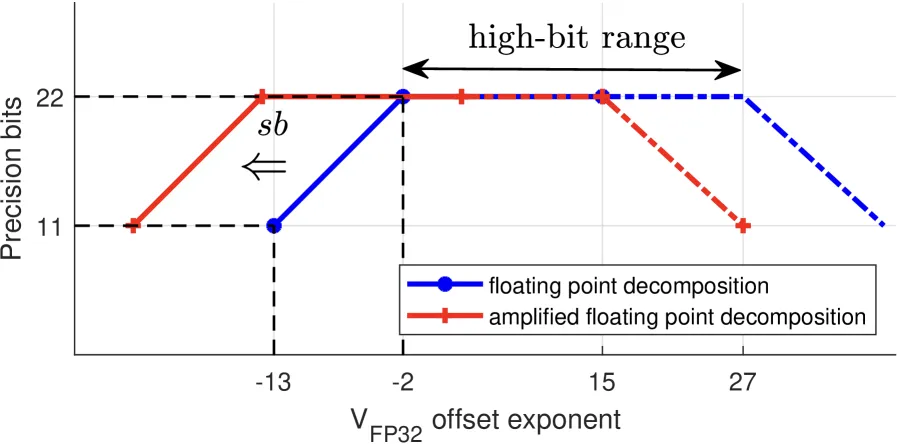
Figure 2(a): 下溢/渐进下溢的概率
- 残差分量可能下溢,导致精度损失
- 通过适当的缩放策略缓解
相对误差分析
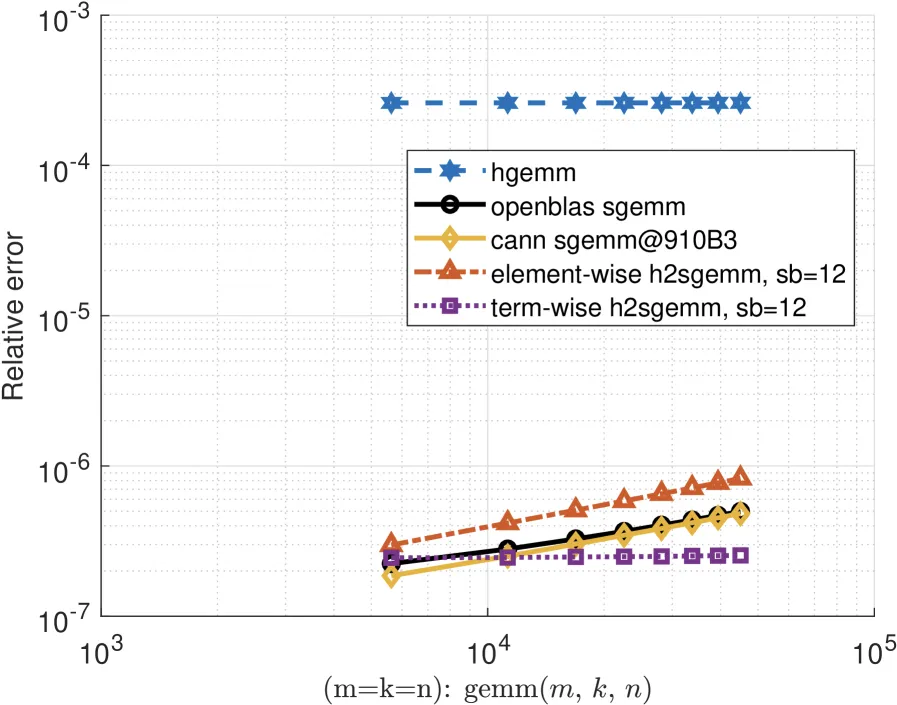
Figure 9: 相对误差与矩阵维度的关系
关键发现:
- 相对误差随矩阵维度增加而增加
- H2SGEMM 的精度显著优于原生 FP16 GEMM
- 对中等范围输入,精度接近 FP32 SGEMM
核心公式
FP32 分解:
矩阵乘积重建:
其中 是高位分量, 是缩放后的残差分量。
计算成本:
- 原生 FP32 GEMM: 1 次 GEMM
- H2SGEMM: 3 次 FP16 GEMM(high-high, high-low, low-high)
- 等效 FP32 峰值:
五、实验结果
精度评估
实验设置:
- OpenBLAS SGEMM: 192 核 Kunpeng ARM CPU
- HGEMM / H2SGEMM: Ascend 910A NPU
- CANN SGEMM: Ascend 910B3 平台
| 方法 | 精度等级 | 相对误差范围 |
|---|---|---|
| FP16 GEMM (HGEMM) | 低 | - |
| H2SGEMM | 中-高 | - |
| FP32 SGEMM (OpenBLAS) | 高 | - |
关键发现:
- H2SGEMM 比原生 FP16 GEMM 精度提高 2-4 个数量级
- 对中等范围输入(),精度接近 FP32 SGEMM
- 大范围输入()精度下降,因为 FP16 动态范围限制
性能评估
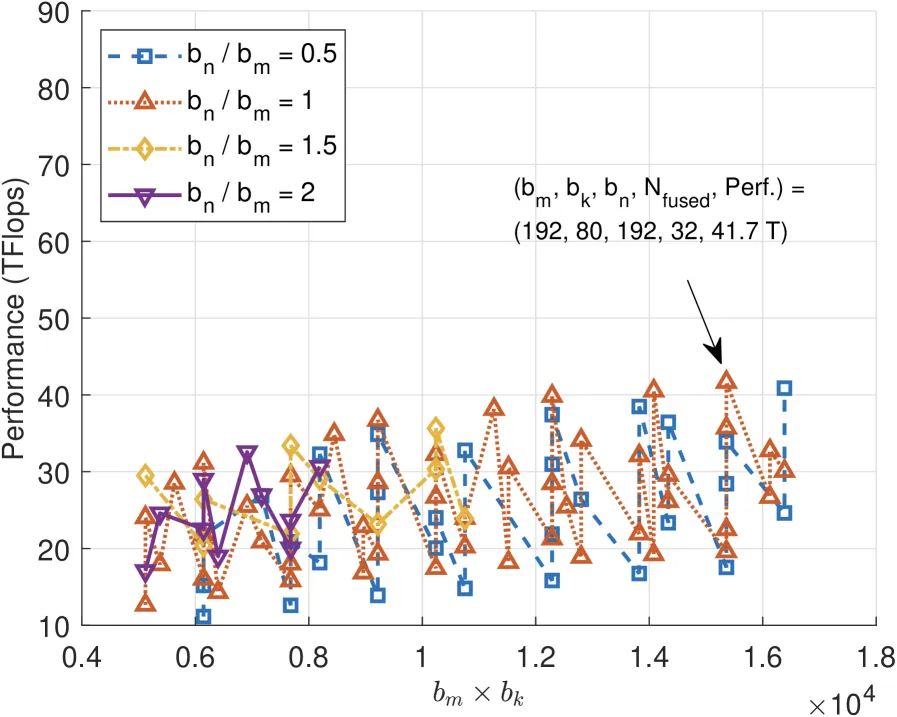
Figure 11: 性能与矩阵维度的关系
| 平台 | 方法 | 峰值 TFLOPS | 实测 TFLOPS | 利用率 |
|---|---|---|---|---|
| Ascend 910A | H2SGEMM | 84.7* | 65.3 | 77% |
| Ascend 910A | HGEMM | 256 | ~200 | ~78% |
| Ascend 910B3 | CANN SGEMM | 73.73 | ~60 | ~81% |
*注:H2SGEMM 的等效 FP32 峰值 = FP16 峰值 / 3 × 3 = FP16 峰值
关键洞察:
- H2SGEMM 在 910A 上达到 65.3 TFLOPS,是 FP32 等效峰值的 77%
- 相比原生 FP16 GEMM,H2SGEMM 仅损失约 3× 性能(因为需要 3 次 FP16 GEMM)
- 但获得了接近 FP32 的精度,对于科学计算非常有价值
双缓冲优化效果
| 流水线策略 | 性能提升 |
|---|---|
| 单缓冲 | 基准 |
| 双缓冲 | +15-25% |
六、与现有方法对比
| 方法 | 精度 | 性能 | 硬件要求 |
|---|---|---|---|
| H2SGEMM | 接近 FP32 | 65.3 TFLOPS | FP16 Cube |
| FP16 GEMM | 低 | ~200 TFLOPS | FP16 Cube |
| FP32 SGEMM (CANN) | FP32 | ~60 TFLOPS | FP32 单元 (910B3) |
| Ozaki scheme | FP32 | 取决于实现 | 通用 |
| Ootomo scheme | FP32 | 取决于实现 | 通用 |
H2SGEMM 优势:
- 在仅支持 FP16 的硬件上实现 FP32 级精度
- 不需要原生 FP32 矩阵单元
- 性能损失可控(3× vs FP16)
七、总结
核心贡献
- 架构特定实现: 在 Ascend NPU 上实现精度恢复 FP32 GEMM
- 数值分析: 深入分析舍入转换、下溢、残差缩放、累积顺序的影响
- 缓存优化: L1 感知分块和双缓冲流水线适配 Ascend 软件管理内存层次
- 性能验证: 达到 65.3 TFLOPS,FP32 等效峰值的 77%
技术影响
- 科学计算: 在 AI 加速器上运行需要 FP32 精度的科学计算工作负载
- 硬件利用: 充分利用 FP16 矩阵引擎的高吞吐量
- 精度-性能权衡: 为 FP32 精度需求提供可行的近似方案
局限性
- 动态范围限制: 仅适用于 FP16 动态范围内的输入
- 精度损失: 大范围输入精度下降
- 计算成本: 需要 3 次 FP16 GEMM(vs 1 次 FP32 GEMM)
- low-low 项省略: 对某些工作负载可能引入不可忽略的误差
适用场景
- 科学计算(矩阵求解、有限元分析)
- 需要 FP32 精度但硬件仅支持 FP16 的场景
- 中等范围数值()的工作负载
八、参考资源
- 论文: arXiv:2507.23387
- PDF: arXiv PDF
- HTML: arXiv HTML
- 相关工作: Ozaki scheme, Ootomo scheme, IEEE-754 标准
- 硬件平台: 华为 Ascend 910A, 910B3