Unveiling Super Experts in Mixture-of-Experts Large Language Models
发现MoE大语言模型中的超级专家:少量关键专家对模型性能的决定性影响
Unveiling Super Experts in Mixture-of-Experts Large Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Unveiling Super Experts in Mixture-of-Experts Large Language Models |
| 作者 | Zunhai Su, Qingyuan Li, Hao Zhang, Weihao Ye, Qibo Xue, YuLei Qian, Yuchen Xie, Ngai Wong, Kehong Yuan |
| 机构 | 清华大学等 |
| 论文 | arXiv:2507.23279 |
| 代码 | GitHub |
| 发布 | 2025年7月31日(v1),2026年2月11日(v3) |
| 会议 | ICLR 2026 |
| 主题 | Computer Science > Computation and Language (cs.CL) |
二、核心思想
问题定义
稀疏激活的混合专家(MoE)模型通过动态路由和稀疏激活增强了大语言模型的学习能力,但其庞大的参数量给部署带来了巨大挑战。现有专家级压缩方法依赖经验性标准来识别关键专家,缺乏对专家异质重要性的深入理解。
解决方案概述
本文首次发现并系统研究了 MoE LLMs 中一类特殊的专家子集——超级专家(Super Experts, SEs)。这些专家虽然数量极少(不到所有专家的 0.5%),但对模型的前向推理机制至关重要。剪枝 SEs 会导致模型性能急剧下降,甚至产生重复且无信息的输出。
核心发现
- SEs 的特征: SEs 在 down_proj 输出中产生罕见但极端的激活异常值,这些异常值通过残差求和传播到隐藏状态,形成 massive activations
- SEs 的分布: SEs 分布是模型特有的,不受后训练过程影响,在不同数据域上高度稳定
- SEs 的重要性: 剪枝 SEs 对数学推理能力影响最为严重(AIME 2024/2025 下降 100%)
- SEs 与 Attention Sinks: MoE LLMs 依赖 SEs 来诱导 attention sinks,SE 剪枝会破坏 attention score 分布
三、技术架构
MoE LLM 架构
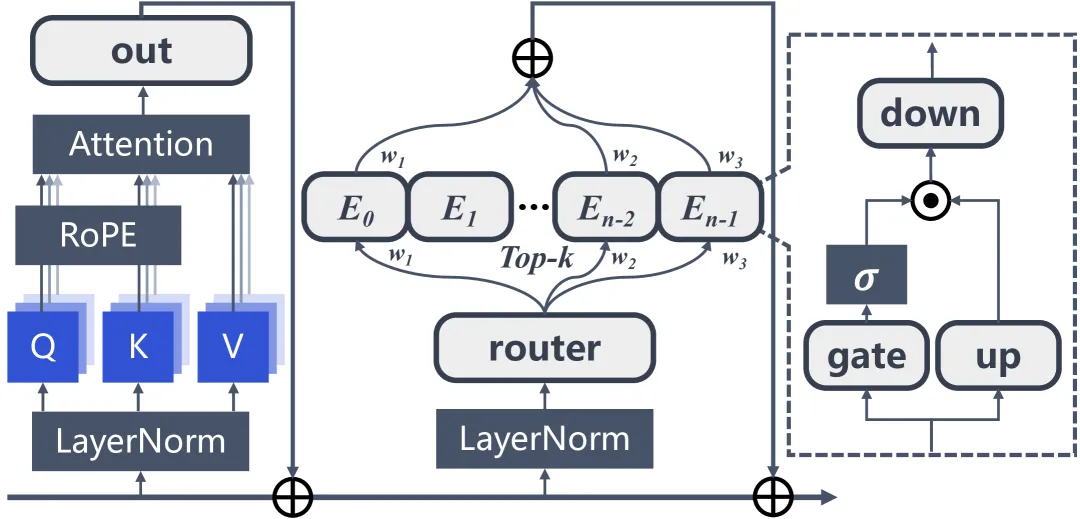
Figure 2: MoE LLM 的 Decoder 架构
MoE LLM 的每个 Decoder Block 包含:
- MHSA 层: 多头自注意力
- MoE 层: 替代标准 FFN,包含多个专家(每个专家是一个 FFN)
Decoder Block 公式:
MHSA 公式:
MoE 路由:
FFN 定义(SwiGLU):
超级专家的发现
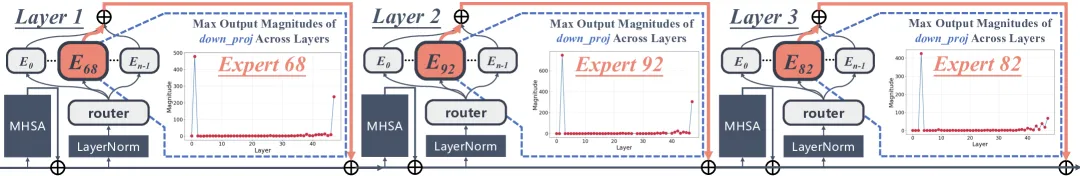
Figure 3: Qwen3-30B-A3B 中的超级专家机制。折线图展示了各层专家 68/92/82 的 down_proj 最大输出幅度。Massive activation 通过 Layer 1 的 Expert 68、Layer 2 的 Expert 92、Layer 3 的 Expert 82 逐步放大。
超级专家的定位
SE 分类准则(Equation 8):
其中:
- : 所有 的 99.5 百分位数
- : 所有 的最大值
- : 层 l 中专家 e 的 down_proj 最大输出幅度
- : 负责 massive activations 形成的层集合
SEs 在不同模型中的分布
| 模型 | 超级专家 | SE 数量 | SE 占比 |
|---|---|---|---|
| Qwen3-30B-A3B | Layer 1 Expert 68, Layer 2 Expert 92, Layer 3 Expert 82 | 3 | 0.05% |
| DeepSeek-V2-Lite-Chat | Layer 2 Expert 54, Layer 3 Expert 38 | 2 | 0.22% |
| Mixtral-8x7B-Instruct-v0.1 | Layer 1 Expert 3 | 1 | 0.39% |
| DeepSeek-R1 | Layer 8/12/13/14/22/33/35 的多个专家和 Shared Expert | 10 | 0.06% |
关键发现:
- SEs 在所有被调查的模型中一致存在,占比不到 0.5%
- 后训练(SFT/RLHF)不改变 SEs 的分布
- SEs 分布在不同数据域上高度稳定
SEs 的激活幅度
| 模型 | 总专家数 | SE 数量 | Top 1 激活 | Top 2 激活 | Top 1 × 0.1 |
|---|---|---|---|---|---|
| Qwen3-30B-3B | 6,144 | 3 | 744.0 | 540.0 | 74.4 |
| DeepSeek-R1 | 15,677 | 10 | 616.0 | 536.0 | 61.6 |
| DeepSeek-V2-Lite-Chat | 1,782 | 2 | 1,424.0 | 462.0 | 142.4 |
| Mixtral-8x7B-Instruct-v0.1 | 256 | 1 | 5,600.0 | 302.0 | 560.0 |
关键发现: SE 的激活幅度比其他专家高出一个数量级(Top 1 vs Top 1×0.1 对比)。
四、SEs 的重要性
对非推理模型的影响
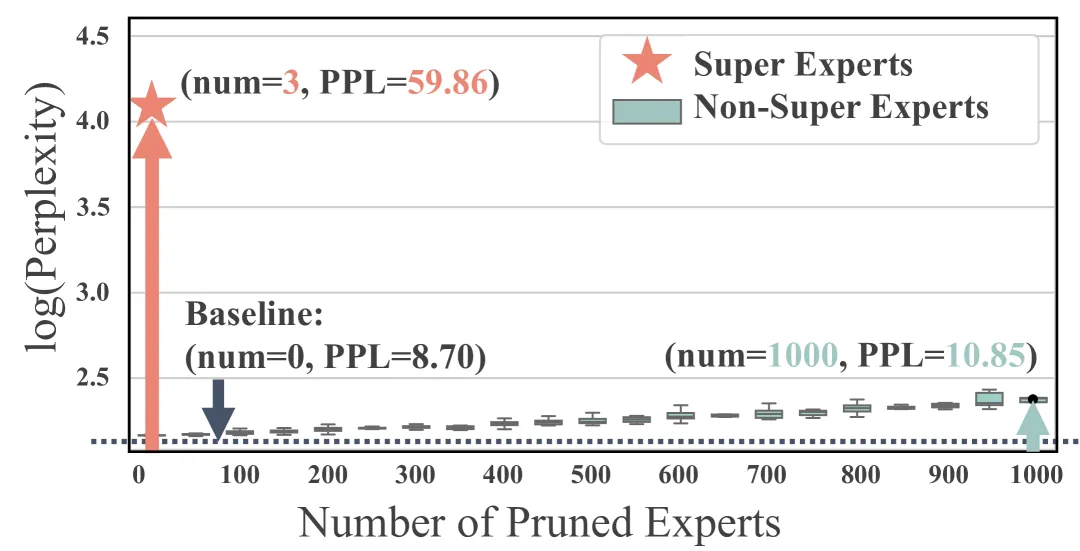
Figure 1: 在 Qwen3-30B-A3B 上使用 WikiText-2 数据集的专家剪枝分析。剪枝三个超级专家导致困惑度(PPL)显著退化。
Qwen3-30B-A3B:
| 设置 | PPL | 平均 | ARC-c | GSM8K | MMLU |
|---|---|---|---|---|---|
| Baseline | 8.70 | 70.22 | 52.65 | 89.61 | 77.82 |
| 剪枝 SEs | 59.86 | 0.55 | 46.08 | 42.38 | 56.03 |
| 下降率 | - | 21.68% | 12.48% | 52.71% | 28.00% |
DeepSeek-V2-Lite:
| 设置 | PPL | 平均 | ARC-c | GSM8K | MMLU |
|---|---|---|---|---|---|
| Baseline | 6.31 | 60.27 | 46.59 | 37.83 | 55.03 |
| 剪枝 SEs | 10.75 | 43.90 | 29.27 | 9.78 | 41.77 |
| 下降率 | - | 27.17% | 37.18% | 74.15% | 24.10% |
Mixtral-8x7B-v0.1:
| 设置 | PPL | 平均 | ARC-c | GSM8K | MMLU |
|---|---|---|---|---|---|
| Baseline | 3.84 | 67.84 | 56.57 | 57.32 | 67.83 |
| 剪枝 SEs | 6.23 | 49.38 | 36.01 | 24.34 | 42.47 |
| 下降率 | - | 27.21% | 36.34% | 57.54% | 37.39% |
对推理模型的影响
DeepSeek-R1:
| 设置 | PPL | 平均 | GPQA Diamond | Math-500 | AIME 2024 | AIME 2025 | LiveCodeBench |
|---|---|---|---|---|---|---|---|
| Baseline | 3.33 | 75.64 | 71.50 | 97.60 | 79.33 | 66.33 | 63.44 |
| 剪枝 SEs | 5.18 | 1.81 | 5.05 | 4.00 | 0.00 | 0.00 | 0.00 |
| 下降率 | - | 97.61% | 93.0% | 95.9% | 100% | 100% | 100% |
Qwen3-30B-A3B:
| 设置 | PPL | 平均 | GPQA Diamond | Math-500 | AIME 2024 | AIME 2025 | HumanEval |
|---|---|---|---|---|---|---|---|
| Baseline | 8.70 | 69.37 | 61.62 | 88.00 | 80.00 | 73.33 | 43.90 |
| 剪枝 SEs | 59.86 | 4.02 | 18.69 | 1.40 | 0.00 | 0.00 | 0.00 |
| 下降率 | - | 93.62% | 69.7% | 98.4% | 100% | 100% | 100% |
关键发现: 剪枝 SEs 后,模型在几乎所有测试中都产生重复响应,直到达到最大输出长度,表明模型完全失去了推理能力。
五、SEs 与 Attention Sinks
SEs 诱导 Attention Sinks
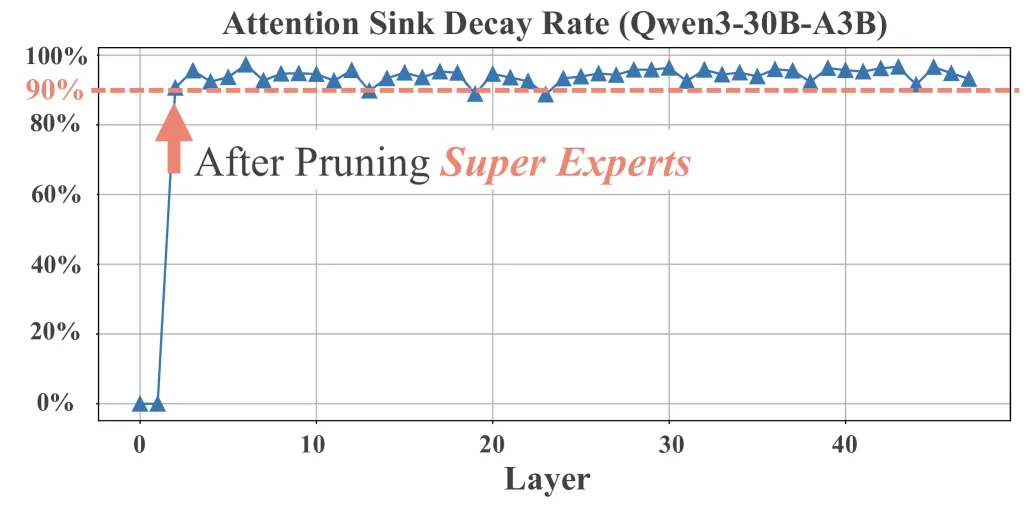
Figure 7: 跨层的 Attention Sink 衰减率
Massive activations 在 MHSA 层中吸引不成比例的高注意力分数,导致初始 token 成为 attention sinks。剪枝 SEs 不仅消除 massive activations,还破坏底层的 attention sink 机制。
Attention Sink 衰减率(Equation 9):
其中:
- : 总头数
- : 剪枝前 Query token t 与 Key token i 之间的注意力分数
- : 剪枝后的注意力分数
- : sink token 集合
结果: 剪枝 SEs 后,attention sink 衰减率保持在约 90% 甚至更高,表明对 attention sinks 的破坏性影响。
Attention Score 对比
原始模型: 第一个 token 明确作为 attention sink 剪枝 SEs 后: attention sink 完全消失
六、SEs vs Outlier Experts
| 特性 | Super Experts (SEs) | Outlier Experts |
|---|---|---|
| 位置 | 浅层(Layer 1-3) | 深层(如 Layer 47, 60) |
| 分布稳定性 | 高度稳定,不受数据域影响 | 随输入数据集变化 |
| 剪枝影响 | PPL 暴涨,推理能力丧失 | PPL 几乎不变 |
| 功能 | 诱导 massive activations 和 attention sinks | 无关键功能 |
| 后训练影响 | 不受后训练影响 | 可能受后训练影响 |
Qwen3-30B-A3B 对比:
- 剪枝 3 个 SEs: PPL 8.70 → 59.86
- 剪枝 3 个 Outlier Experts: PPL 8.70 → 8.71
七、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首次发现 SEs | MoE LLMs 中存在一类对推理至关重要的专家子集 | 跨越 Qwen、DeepSeek、Mixtral 等模型验证 |
| SE 分类准则 | 基于 down_proj 输出幅度的定量定义 | 99.5 百分位 + 1/10 最大值阈值 |
| SEs 与 Massive Activations | SEs 通过极端激活异常值诱导 massive activations | 跨层传播机制分析 |
| SEs 与 Attention Sinks | SEs 诱导 attention sinks,剪枝后衰减率 >90% | 注意力分数可视化验证 |
| SEs 对推理的关键性 | 剪枝 SEs 导致 AIME 2024/2025 得分归零 | DeepSeek-R1 和 Qwen3-30B-A3B 实验 |
| SEs 分布稳定性 | 不受后训练和数据域影响 | Base vs Chat 模型对比 |
| 自动 SE 分析工具 | 快速精确分析新 MoE LLM 的 SEs | GitHub |
八、实验结果总结
关键实验数据
| 模型 | 剪枝 SEs 数量 | GSM8K 下降 | AIME 下降 | 平均下降 |
|---|---|---|---|---|
| Qwen3-30B-A3B | 3 | 52.71% | 100% | 93.62% |
| DeepSeek-V2-Lite | 2 | 74.15% | - | 27.17% |
| Mixtral-8x7B | 1 | 57.54% | - | 27.21% |
| DeepSeek-R1 | 10 | - | 100% | 97.61% |
与现有方法对比
| 方法 | 类型 | 关键区别 |
|---|---|---|
| M-SMoE | 专家合并 | 基于激活频率,无 SE 概念 |
| NAEE | 专家剪枝/跳过 | 基于重建损失,无 SE 概念 |
| MC | 混合精度量化 | 基于专家和 token 重要性 |
| MC-Suite | 综述 | 回顾各种经验性标准 |
| 本文 | SE 发现与分析 | 首次发现 SEs 及其与 attention sinks 的关系 |
九、总结
核心贡献
- 首次发现超级专家(SEs): 在 MoE LLMs 中发现一类对前向推理至关重要的专家子集,占比不到 0.5%
- SE 定量分类准则: 提出基于 down_proj 输出幅度的 SE 分类方法(99.5 百分位 + 1/10 最大值)
- SEs 与 Massive Activations: 揭示 SEs 通过极端激活异常值诱导 massive activations 的机制
- SEs 与 Attention Sinks: 证明 SEs 诱导 attention sinks,剪枝后衰减率 >90%
- SEs 对推理的关键性: 剪枝 SEs 导致数学推理能力完全丧失(AIME 得分归零)
- SEs 分布稳定性: 证明 SEs 分布不受后训练和数据域影响
- 自动 SE 分析工具: 开源工具用于快速分析新 MoE LLM 的 SEs
技术影响
- MoE 压缩: 为 MoE LLMs 的压缩提供了新的视角——保护 SEs 是关键
- 模型理解: 深化了对 MoE LLMs 内部机制的理解
- 推理能力: 揭示了 SEs 对数学推理能力的决定性作用
- Attention 机制: 建立了 SEs、massive activations 和 attention sinks 之间的联系
局限性
- SE 分类准则基于经验观察,缺乏理论解释
- 仅研究了 decoder-only 架构的 MoE LLMs
- 未探索 SEs 的保护性压缩方法
- SEs 的功能机制仍需更深入的理论分析
十、参考资源
- 论文: arXiv:2507.23279
- 代码: GitHub - Super-Experts-Profilling
- 会议: ICLR 2026
- 主题: cs.CL