RailX: A Flexible, Scalable, and Low-Cost Network Architecture for Hyper-Scale LLM Training Systems
基于哈密顿分解的电路交换网络架构,支持超大规模 LLM 训练的灵活、可扩展、低成本互连
RailX: A Flexible, Scalable, and Low-Cost Network Architecture for Hyper-Scale LLM Training Systems
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | RailX: A Flexible, Scalable, and Low-Cost Network Architecture for Hyper-Scale LLM Training Systems |
| 作者 | Yinxiao Feng, Tiancheng Chen, Yuchen Wei, Siyuan Shen, Shiju Wang, Wei Li, Kaisheng Ma, Torsten Hoefler |
| 机构 | 鹏城实验室、Tencent AI Lab、ETH Zurich、清华大学 |
| 论文 | arXiv:2507.18889 |
| 代码 | 无公开代码(含模拟器) |
| 发布 | 2025-07-25 |
| 许可 | arXiv 非独占分发许可 |
| 规模 | 25 页,21 张图,6 张表 |
二、核心思想
问题定义
随着 LLM 规模持续增长(如 LLaMA-3 405B 需要 16K H100 GPU),传统网络架构面临三大挑战:
| 网络架构 | 核心问题 |
|---|---|
| Fat-Tree | 高基数交换机昂贵,扩展到超大规模时成本急剧上升 |
| Torus | 二分带宽不足,无法支持 All-to-All 通信(如 MoE) |
| HammingMesh | 本地带宽受限,路由跳数多 |
核心矛盾:现有拓扑在可扩展性、二分带宽、成本三者之间无法同时最优。
解决方案概述
RailX 提出了一种基于**哈密顿分解(Hamiltonian Decomposition)**的电路交换网络架构,通过三个核心创新解决上述挑战:
- Rail-Ring 互连:利用哈密顿分解将完整图的边分配到 k-1 个 rail 环上,构建超大规模 All-to-All 拓扑
- 2D 组织电路交换:节点和光开关物理上 2D 排列,支持超过 100K 芯片的平面交换层
- 维度分裂(Dimension Splitting):灵活分配带宽到不同并行维度(TP/CP/EP/DP/PP)
三、技术架构
整体框架图
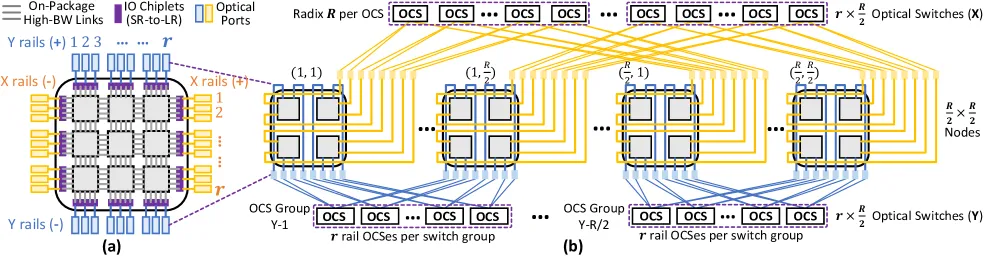
RailX 的物理架构分为三个层次:
┌─────────────────────────────────────────────────────────────────┐
│                    RailX Physical Architecture                  │
├─────────────────────────────────────────────────────────────────┤
│                                                                 │
│  ┌─────────────┐  ┌─────────────┐  ┌─────────────┐            │
│  │   Chip      │  │   Node      │  │   System    │            │
│  │  (m×m mesh) │──│ (r×r OCS)   │──│ (R/2 × R/2) │            │
│  └─────────────┘  └─────────────┘  └─────────────┘            │
│                                                                 │
│  Layer 1: 芯片内     Layer 2: 节点间     Layer 3: 系统级         │
│  2D-mesh 高带宽      光电路交换          2D 排列                 │
│  (UCIe/UALink)      (OCS)              (R²/4 × R²/4 节点)     │
│                                                                 │
└─────────────────────────────────────────────────────────────────┘
核心创新:Rail-Ring 互连
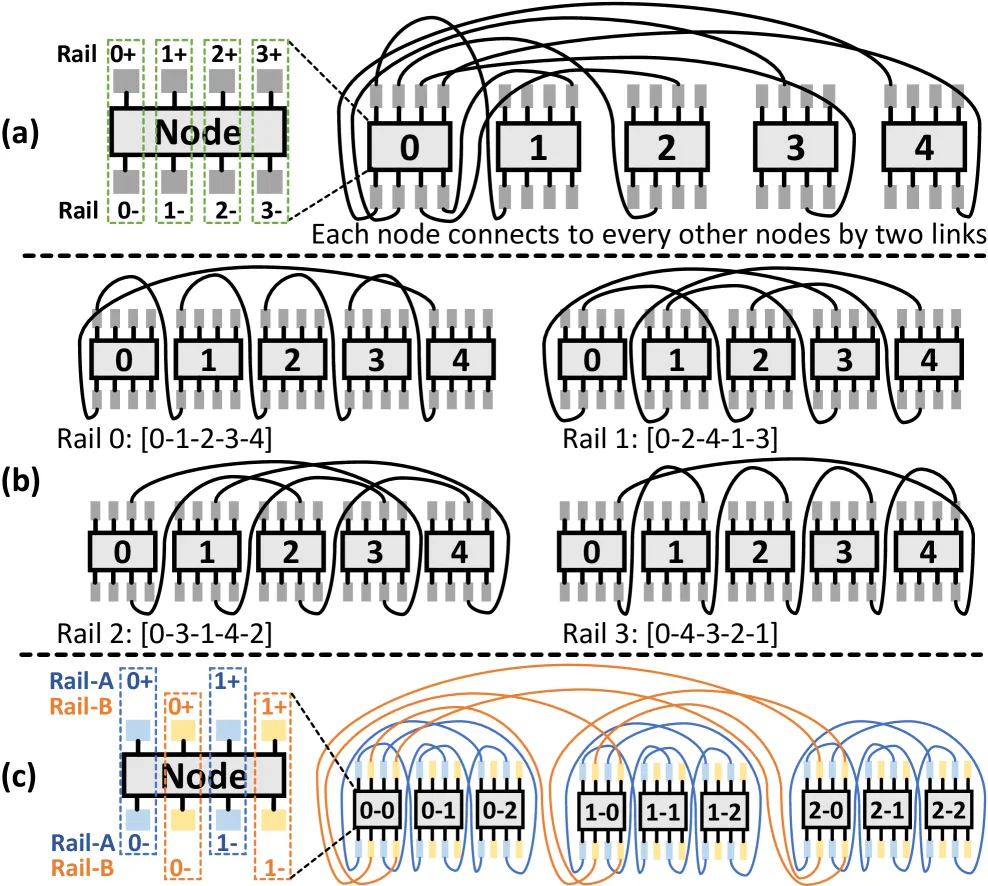
哈密顿分解定理(Lemma 3.1):
给定一个具有 k-1 个 rail 的节点(每个 rail 有 +/- 两个端口),k 个节点的 All-to-All 拓扑可以通过 k-1 个 rail 环构建。任意两个节点 (A,B) 在两个不同的 rail 环 ra 和 rb 上直接连接。
关键性质:
- 直径短:仅 2 个 hop 即可到达任意节点
- 二分带宽高:支持 All-to-All 通信
- 可扩展:k 个节点需要 k-1 个 rail
拓扑配置
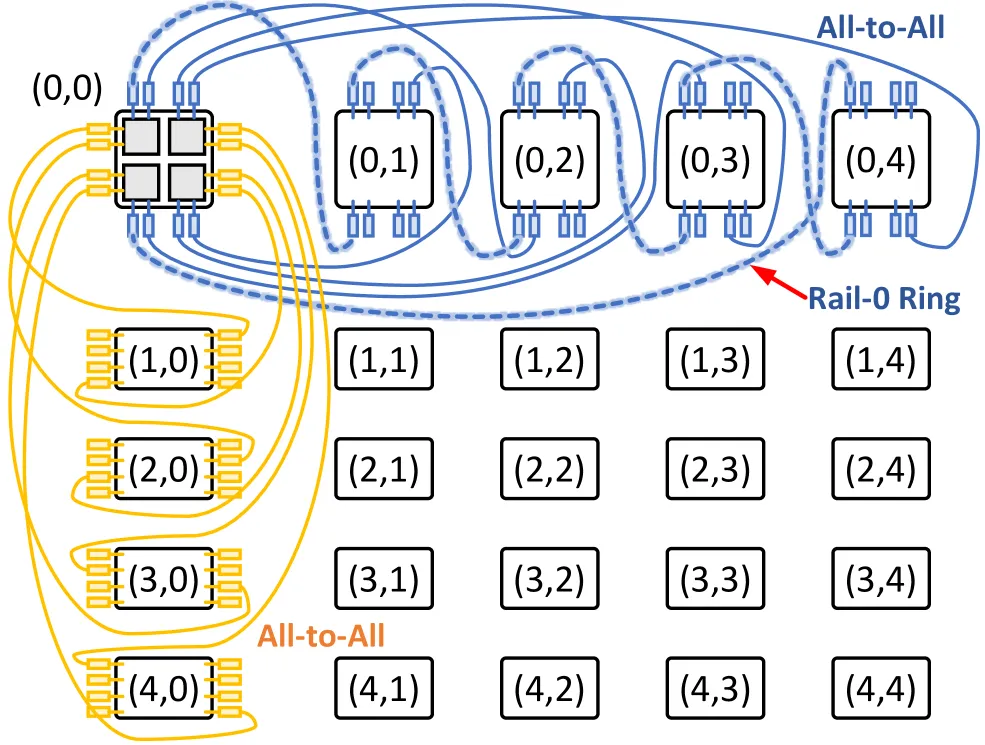
RailX 支持三种基础拓扑配置:
| 拓扑 | 可扩展性 | 直径 | 二分带宽 | 适用场景 |
|---|---|---|---|---|
| 2D-Torus | (R/2)²m² | R | 16n/(Rm) | All-Reduce 流量 |
| 2D-HyperX | (r+1)²m² | 2 | 2n/m | All-to-All 流量 |
| Dragonfly | (r+1)(R/2)m² | 3 | 2n/m | 混合流量 |
高维异构并行映射
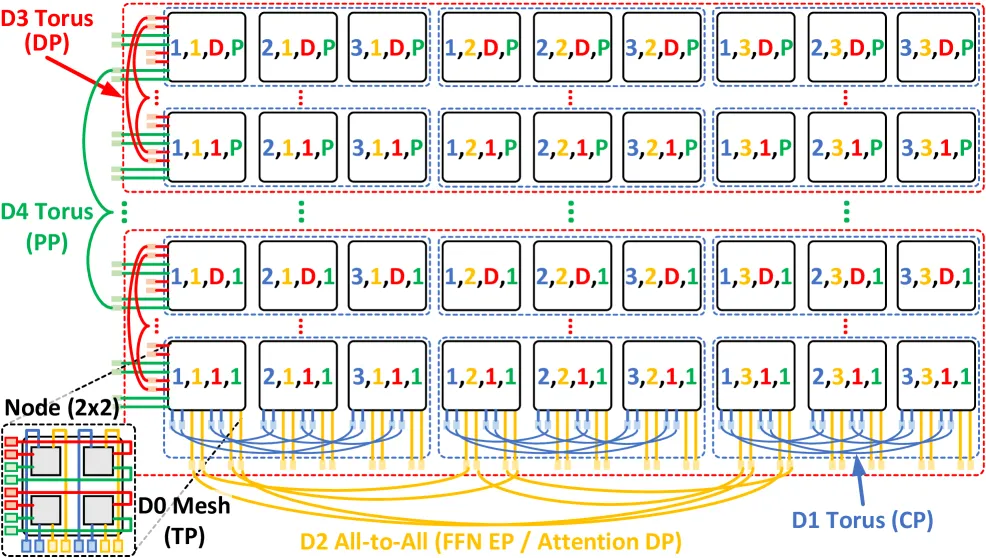
RailX 支持 5D 异构并行(TP × CP × EP × DP × PP),通过维度分裂灵活分配带宽:
节点 rail 分配示例(n=9, r=63):
┌─────────────────────────────────────────┐
│  X-rail (63 rails):                      │
│  ├── TP: 2 rails (最内层,最高带宽)       │
│  ├── CP: 4 rails                         │
│  └── DP: 1 rail                          │
│  Y-rail (63 rails):                      │
│  ├── EP: 8 rails                         │
│  └── PP: 1 rail                          │
└─────────────────────────────────────────┘
通信算法
点对点路由
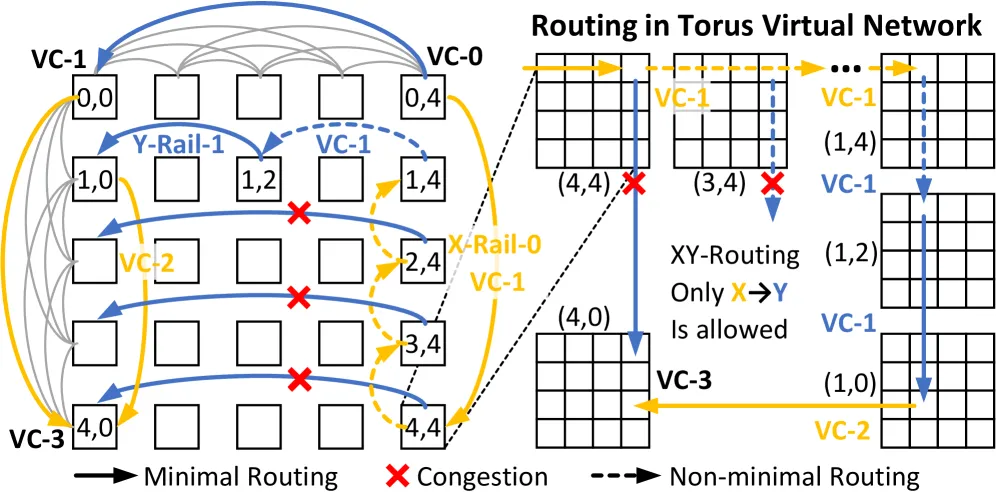
RailX 在 HyperX 拓扑上使用最小路由算法,额外需要在本地 2D-mesh 上路由。关键性质:
- 路由跳数:最多 2(m/2-1) + (m-1) 内部跳
- 无死锁:通过增加虚拟通道数(VC = do + 1)
- 支持确定性和自适应路由
集合通信
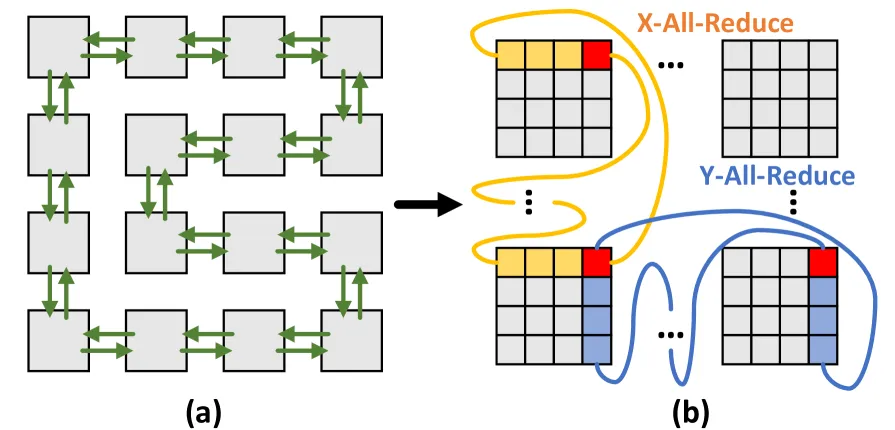
2D-Ring-based All-Reduce:
其中:
- p: 处理器数量
- α: 光学跳延迟
- V: 数据量
- nB: 每芯片边总带宽
层次化 All-Reduce:
- 本地 2D-mesh 上使用双向环
- 全局使用 2D-ring 算法
- 充分利用芯片内高带宽
映射与调度
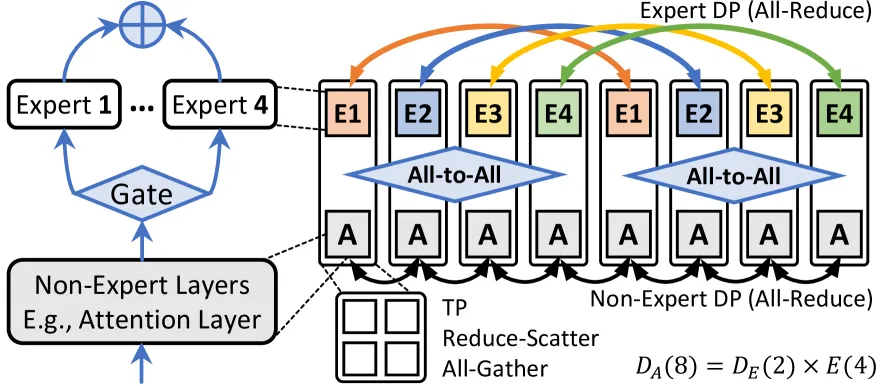
静态分配
目标:最小化实际训练时间
其中 TComp*/TComm* 是可与计算重叠的通信时间。
动态分配
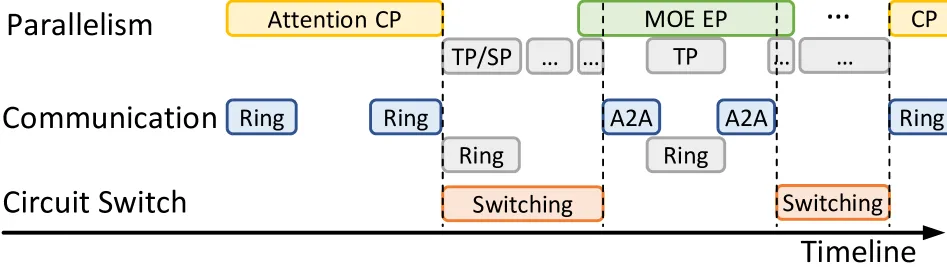
利用电路交换的可重构性,在训练迭代间动态调整带宽分配:
- CP 和 EP 通信不重叠,间隔约几毫秒
- 可在训练过程中重新配置 OCS
- 两个通信均可独占一个物理维度的全部带宽
四、核心发现
成本对比
| 拓扑 | 规模 | 成本 | 每注入带宽成本 | 全局带宽成本比 |
|---|---|---|---|---|
| 2-Tier Fat-Tree | 2,048 | $415.9M | 1× | 1× |
| 1:3 Tapered FT | 3,072 | $395.7M | 0.65× | 1.90× |
| TPUv4 | 4,096 | $185.7M | 0.22× | 5.52× |
| RailX4Mesh | 65,536 | $751.1M | 0.06× | 0.45× |
| RailX7Mesh | 200,704 | $1,314.4M | 0.03× | 0.45× |
| 4-Tier Fat-Tree | 196,608 | $83,718M | 2.10× | 2.10× |
关键发现:
- RailX 每注入/All-Reduce 带宽成本不到 Fat-Tree 的 10%
- RailX 每二分/All-to-All 带宽成本不到 Fat-Tree 的 50%
- 仅需 ~$1.3B 即可互连 200K 芯片,带宽达 1.8TB
All-to-All 性能
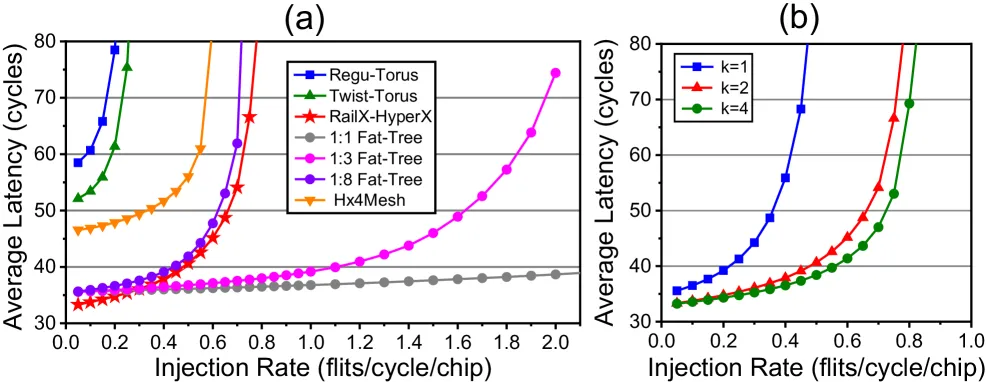
- RailX 达到 0.8 flits/cycle/chip 吞吐量,接近理论最大值 1.0
- 在 1.3K 芯片规模下,比其他拓扑具有更高的成本效益
- 内部带宽是关键:2× 内部带宽即可接近最优性能
All-Reduce 性能
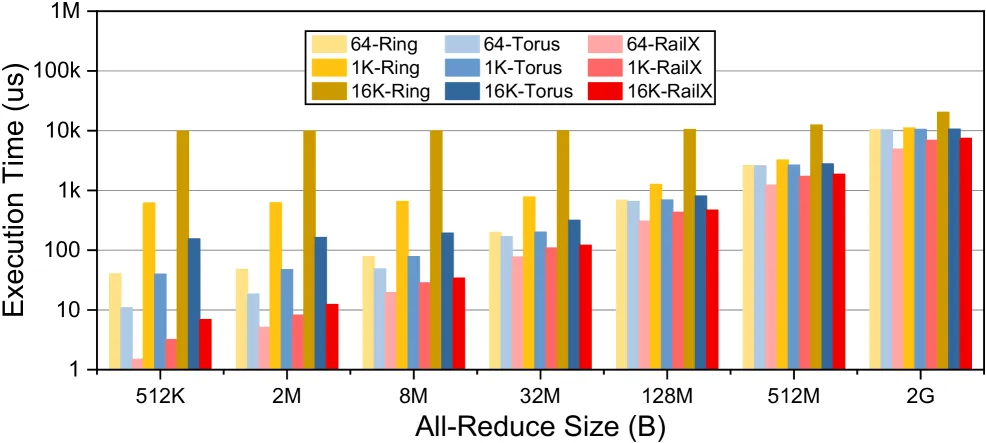
- 层次化 2D-Torus 算法在 RailX 上始终表现最佳
- 大规模 All-Reduce:各算法接近带宽最优
- 小规模 All-Reduce:层次化算法显著优于 1D-ring
带宽分配探索
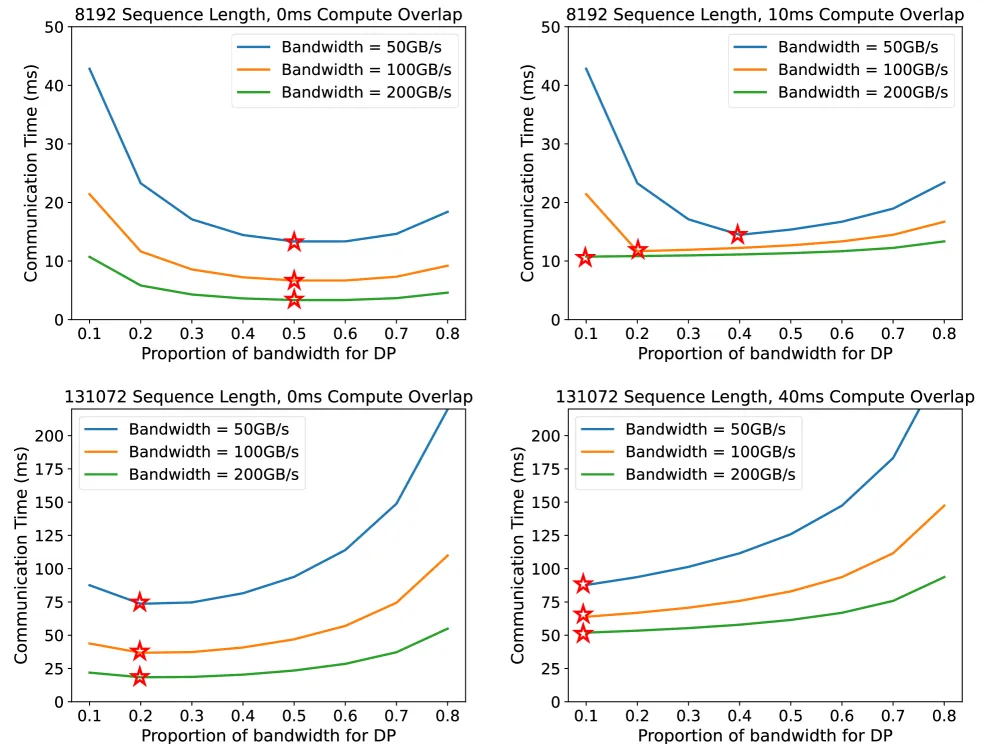
- 小序列长度:更多带宽分配给 DP
- 大序列长度:更多带宽分配给 CP
- 考虑计算/通信重叠后,应进一步增加 CP 带宽
可靠性与可用性
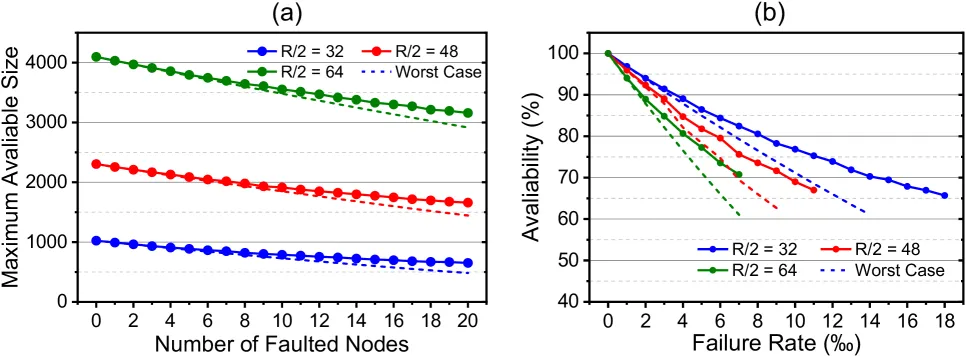
- 故障节点导致行和列断开
- 最大可用规模随故障节点数线性下降
- 典型故障率 0.1% 时,可用性 >90%
- 支持 MLaaS 场景下的灵活调度
五、实验设置
评估方法
| 方法 | 说明 |
|---|---|
| 分析模型 | 硬件验证的分析模型,估计计算和通信 |
| 周期级模拟器 | 基于 CNSim 框架,支持微架构建模 |
| Trace 合成 | 由分析模型生成通信流量 |
模拟器配置
| 参数 | 值 |
|---|---|
| 外部带宽 | 1 flit/cycle(64 Gb/s) |
| 内部带宽 | k × 外部带宽 |
| 缓冲区大小 | 16 flits/VC |
| 外部延迟 | 10 cycles |
| 内部延迟 | 1 cycle |
成本模型
| 组件 | 价格 |
|---|---|
| 400G 被动铜缆 | $250 |
| 400G 有源光收发器 | $1,000 |
| 64 端口 400G 包交换机 | $35K |
| 128 端口 OCS | $35K |
六、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 哈密顿分解互连 | k-1 个 rail 环构建 All-to-All | Lemma 3.1,图论基础 |
| 2D 组织 OCS | 节点和光开关 2D 排列 | 支持 100K+ 芯片 |
| 维度分裂 | 灵活分配带宽到并行维度 | 支持 5D 异构并行 |
| 电路交换动态重配 | 训练迭代间调整拓扑 | CP/EP 动态带宽分配 |
| 层次化集合通信 | 本地 2D-mesh + 全局 2D-ring | 充分利用高带宽 |
七、相关工作对比
| 工作 | 拓扑 | 成本 | 可扩展性 | 本文差异 |
|---|---|---|---|---|
| Fat-Tree (NVIDIA DGX) | 树状 | 高 | 中 | RailX 成本 <10% |
| TPUv4 | 3D-Torus+OCS | 中 | 中 | RailX 2D 组织,更高带宽 |
| HammingMesh | 2D-mesh | 低 | 中 | RailX 内部带宽更高 |
| TopoOpt | 可重构 | 中 | 中 | RailX 基于哈密顿分解 |
八、总结
核心贡献
- 提出 RailX 网络架构:基于哈密顿分解的电路交换网络,支持超大规模 LLM 训练
- 实现极低成本:每注入/All-Reduce 带宽成本不到 Fat-Tree 的 10%
- 支持灵活并行:维度分裂方法支持 5D 异构并行的灵活映射
- 验证超大规模:支持超过 200K 芯片的互连,仅需 ~$1.3B
- 支持 MLaaS:电路交换允许灵活调度和故障绕过
技术影响
- 成本优化:为超大规模 LLM 训练提供经济高效的网络解决方案
- 架构创新:哈密顿分解理论在网络设计中的首次应用
- 产业应用:可指导下一代 AI 集群的网络架构设计
- 学术价值:建立了拓扑理论与实际网络设计的桥梁
局限性
- 电路交换延迟:OCS 重配置需要毫秒级时间,不适合细粒度动态调整
- 故障影响:2D 组织导致故障节点影响整行整列
- 实现复杂度:哈密顿分解的物理布线可能增加制造难度
- 成本估算:基于公开价格,实际成本可能有偏差
- 未实测:评估基于模拟器,未在真实硬件上验证
九、参考资源
- 论文: arXiv:2507.18889
- 相关系统:
- NVIDIA DGX - Fat-Tree 网络
- TPUv4 - 3D-Torus+OCS
- HammingMesh - 2D-mesh 网络
- 关键理论:
- Hamiltonian Decomposition (Tillson, 1980) - 图论基础
- HyperX (Ahn et al., 2009) - k-D 拓扑
- Dragonfly (Kim et al., 2008) - 低直径拓扑
- 相关论文:
- Rail-Only (Wang et al., 2024) - 2D Fat-Tree
- TopoOpt (Wang et al., 2023) - 拓扑优化
- CASSINI (Rajasekaran et al., 2024) - 调度方法