Towards Greater Leverage
MoE语言模型的效率杠杆缩放定律,通过300+模型训练验证高效MoE架构设计原则
Towards Greater Leverage: Scaling Laws for Efficient Mixture-of-Experts Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Towards Greater Leverage: Scaling Laws for Efficient Mixture-of-Experts Language Models |
| 作者 | Changxin Tian, Kunlong Chen, Jia Liu, Ziqi Liu, Zhiqiang Zhang, Jun Zhou |
| 机构 | Ling Team (Ling-2.0 series) |
| 论文 | arXiv:2507.17702 |
| 发布 | 2025-07-23 (v4: 2025-10-21) |
| 许可 | arXiv nonexclusive |
二、核心思想
问题定义
Mixture-of-Experts (MoE) 通过稀疏激活实现了总参数量与计算成本的解耦,但这种解耦带来了一个关键挑战:如何预测特定MoE配置(专家激活比例、粒度等)的有效模型容量? 现有研究对MoE缩放行为的结论不一致,缺乏统一的框架来量化MoE架构选择如何影响计算效率。
解决方案概述
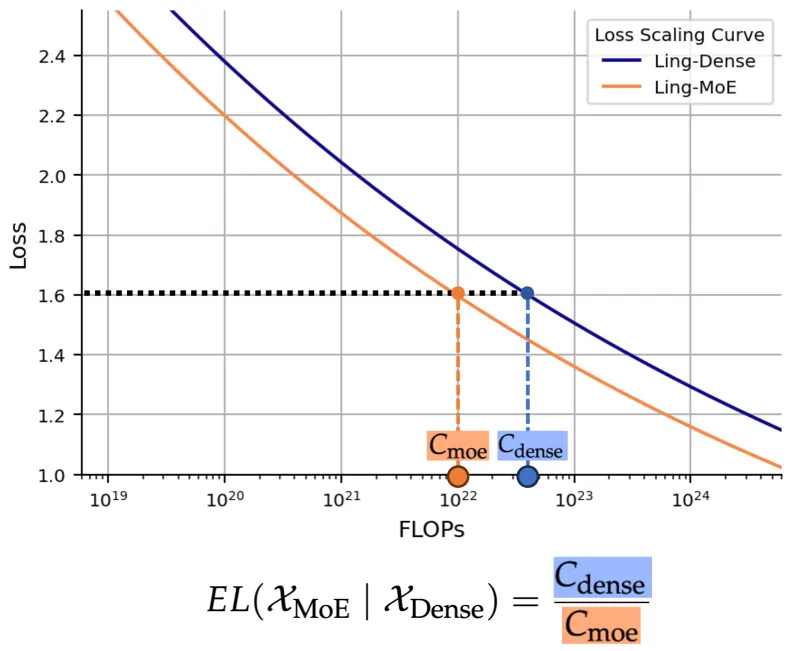
本文引入效率杠杆 (Efficiency Leverage, EL) 指标,量化MoE模型相比稠密模型的计算优势。通过训练超过300个模型(最大28B参数),系统性地研究MoE架构配置与EL的关系,发现:
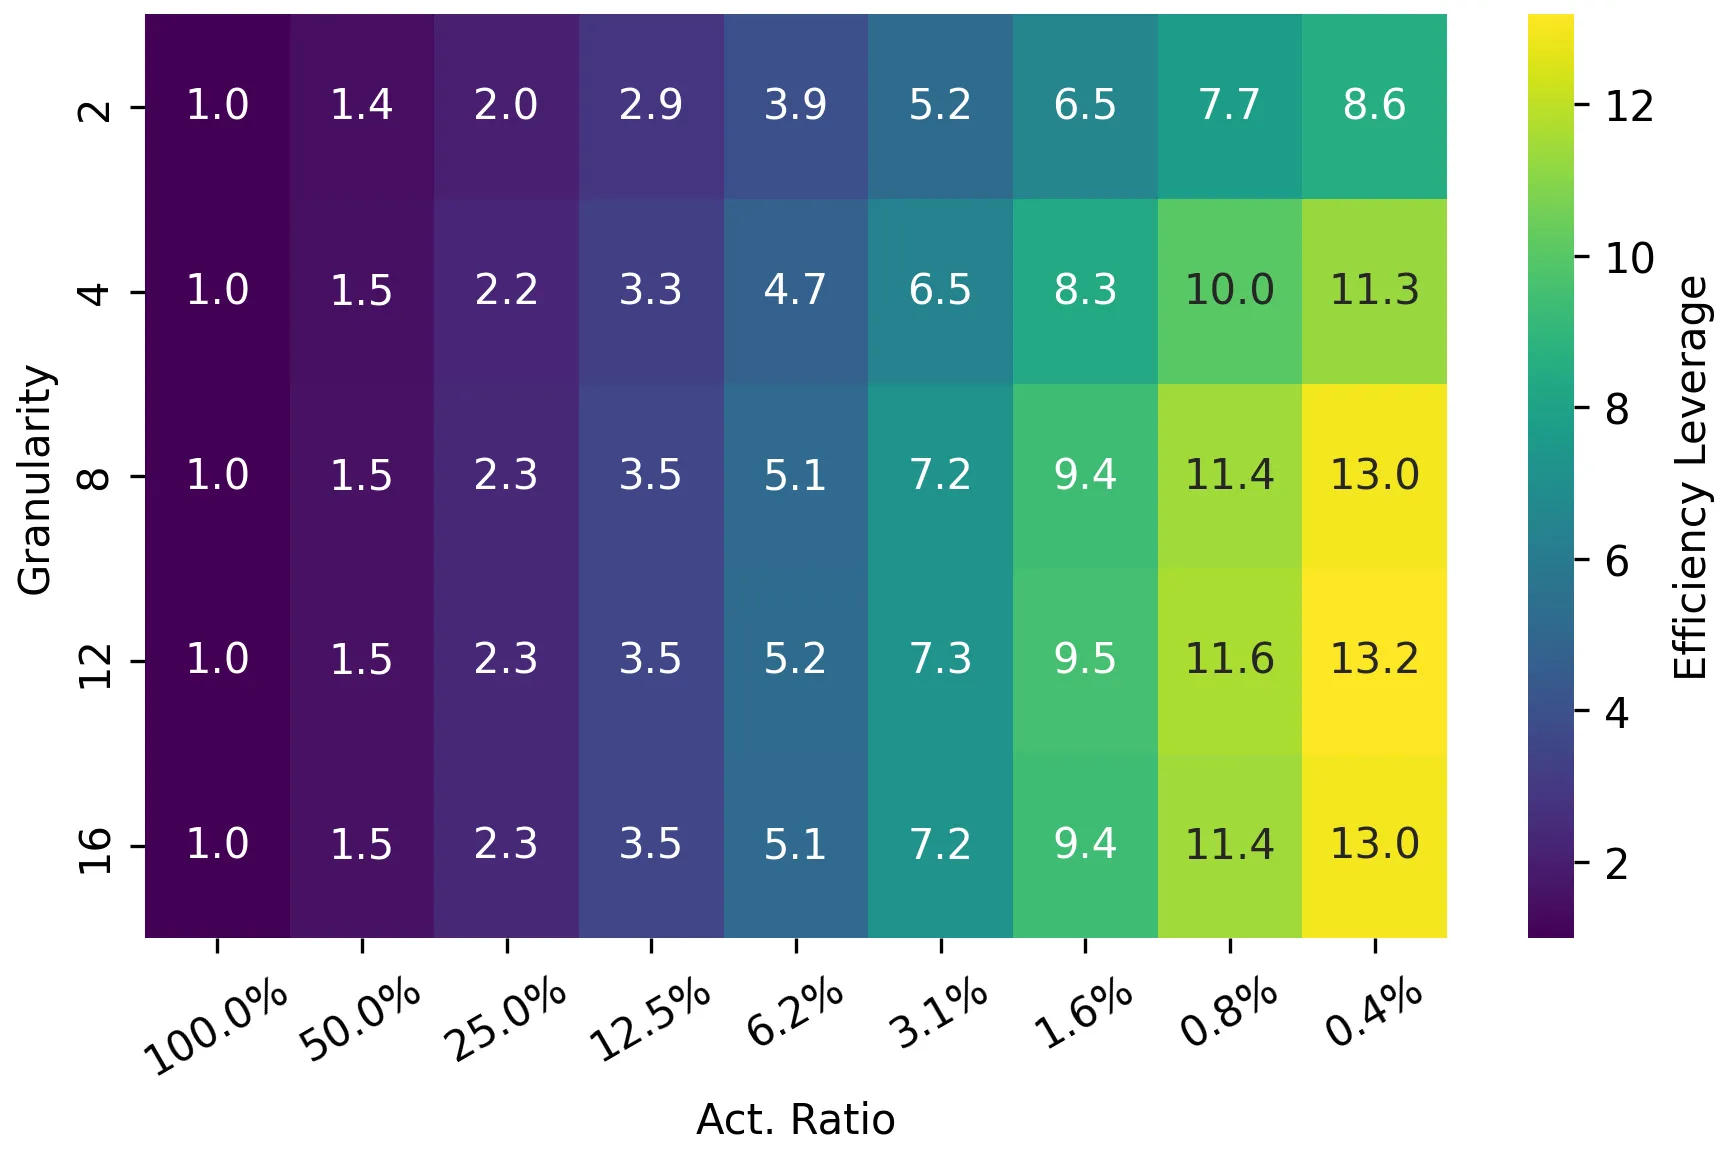
- EL主要由专家激活比例和总计算预算驱动,均遵循可预测的幂律
- 专家粒度作为非线性调制器,存在明确的最优范围
- 基于这些发现构建统一缩放定律,可准确预测任意MoE配置的EL
三、技术架构
整体框架图
核心公式
效率杠杆定义 (Efficiency Leverage):
其中 和 分别是达到相同性能水平所需的稠密和MoE模型的计算预算。
激活比例缩放 (Activation Ratio Scaling):
其中 是经过饱和变换的激活比例, 是计算依赖的指数。
粒度缩放 (Granularity Scaling):
其中 是粒度无关的基础EL, 控制曲率强度, 决定最优粒度位置。
计算预算缩放 (Compute Budget Scaling):
统一缩放定律 (Joint Scaling Law):
其中 是计算依赖的指数, 和 建模粒度的非线性影响。
关键定义
| 符号 | 定义 | 说明 |
|---|---|---|
| 激活比例 | ||
| 专家粒度 | ||
| 共享专家比例 | ||
| 总计算预算 | (FLOPs) | |
| 模型计算量 | 每token前向FLOPs (不含embedding) | |
| 总参数量 | 包含所有专家 | |
| 激活参数量 | 仅激活的专家参数 |
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| MoE层 | 替换标准FFN,包含多个专家和门控机制 | E个可路由专家 + Es个共享专家 |
| GQA注意力 | 分组查询注意力 | 与稠密模型相同 |
| RoPE | 旋转位置编码 | 支持8K序列长度 |
| 路由网络 | 为每个token选择Top-N个专家 | 负载平衡损失 + z-loss |
训练流程
预实验阶段:
- 超参数缩放定律:在3e17到3e20 FLOPs范围内搜索最优学习率和batch size
- 模型-数据分配定律:确定给定计算预算下的最优模型大小和数据量
主实验阶段:
- 从基线MoE架构(2/64专家激活 + 1共享专家)开始
- 系统性变化一个维度(A, G, 或S),保持其他因素不变
- 训练范围:3e18到3e20 FLOPs
- 每个模型训练超过其最优token数的3倍,模拟过训练状态
验证实验:
- 设计Ling-mini-beta:17.5B总参数,0.85B激活参数
- 配置:G=12, A=3.4%
- 训练1T tokens,与6.1B稠密模型对比
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 效率杠杆 (EL) 指标 | 量化MoE相比稠密模型的计算优势 | 定义3.1,基于幂律拟合 |
| 激活比例与EL的幂律关系 | 降低激活比例一致提升EL,遵循幂律 | 图5,300+模型训练验证 |
| 粒度的非线性调制 | 存在最优粒度范围(~12),呈U型关系 | 图6,log-polynomial拟合 |
| 统一缩放定律 | 整合A, G, C三因素预测EL | 公式(13),Huber loss + BFGS优化 |
| 7x效率验证 | Ling-mini-beta以0.85B参数匹配6.1B稠密模型 | 图10-11,1T tokens训练 |
五、代码实现分析
项目结构(基于论文描述):
- 基于Ling系列模型架构
- GQA注意力 + RoPE位置编码
- 词表大小:126,464
- 序列长度:4,096(训练)/ 8,080(推理)
路由策略:
- 门控分数:
- 输出:
- 辅助损失:负载平衡损失(系数0.01)+ z-loss(系数0.001)
优化器配置:
- AdamW: β1=0.9, β2=0.95, weight decay=0.1
- 梯度裁剪范数:1.0
- WSD学习率调度
六、实验结果
基准测试
Ling-mini-beta vs Dense-6.1B 详细对比
| 任务类别 | Dense-6.1B | Ling-mini-beta | 差异 |
|---|---|---|---|
| 通用知识/推理 | 55.8 | 56.2 | +0.4 |
| 专业知识 | 44.0 | 44.7 | +0.7 |
| 语言理解 | 69.2 | 71.6 | +2.4 |
| 代码 | 36.9 | 39.8 | +2.9 |
| 数学 | 32.9 | 34.7 | +1.8 |
| 总体平均 | 44.0 | 45.5 | +1.5 |
关键发现:
- Ling-mini-beta以0.85B激活参数(Dense-6.1B的13%)实现45.5分
- 在HumanEval-Plus上领先16分(51.8 vs 35.4)
- 在MATH上领先6分(29.8 vs 23.7)
- 在OpenBookQA上领先6.6分(75.2 vs 68.6)
消融实验
激活比例 (A) 影响
| 激活比例 | 0.8% | 3.1% | 7.8% | 10.9% | 100% (Dense) |
|---|---|---|---|---|---|
| 相对性能 | 最优 | 次优 | 中等 | 较差 | 基准 |
结论:固定计算成本下,更低的激活比例(更高稀疏性)一致提升参数效率。
专家粒度 (G) 影响
| 粒度 | 2 | 4 | 8 | 12 | 16 |
|---|---|---|---|---|---|
| 相对性能 | 基准 | 提升 | 提升 | 最优 | 下降 |
结论:粒度与EL呈U型关系,最优范围在12左右,跨不同计算预算保持稳定。
共享专家比例 (S) 影响
| 共享比例 | 0% | 8.3% | 16.7% | 33.3% | 83.3% |
|---|---|---|---|---|---|
| 相对性能 | 较差 | 最优 | 次优 | 中等 | 较差 |
结论:最优共享比例随计算预算变化,大规模训练(>1e20 FLOPs)推荐8.3%(1个共享专家)。
与现有方法对比
| 方法 | 结论 | 本文差异 |
|---|---|---|
| Clark et al. (2022) | MoE效率在某规模后减弱 | 本文发现MoE在所有规模都更高效 |
| Ludziejewski et al. (2024) | 细粒度一致提升性能 | 本文发现存在最优粒度范围 |
| Abnar et al. (2025) | 最优稀疏性缩放 | 本文扩展到粒度和共享专家分析 |
差异原因:
- Clark et al. 使用固定数据集,导致MoE欠训练
- Ludziejewski et al. 使用不同粒度定义和固定超参数
- 本文采用最优计算分配和动态超参数缩放
七、相关工作
| 方向 | 代表工作 | 本文贡献 |
|---|---|---|
| 语言模型缩放定律 | Kaplan et al. (2020), Hoffmann et al. (2022) | 扩展到MoE架构 |
| MoE缩放定律 | Clark et al. (2022), Ludziejewski et al. (2024) | 提出EL指标,统一框架 |
| MoE架构优化 | DeepSeekMoE, Zoph et al. (2022) | 系统性消融A, G, S |
| 计算最优训练 | Bi et al. (2024), Gadre et al. (2024) | 推导MoE特定分配定律 |
八、总结
核心贡献
- 提出效率杠杆 (EL) 指标:量化MoE相比稠密模型的计算优势,独立于特定训练数据
- 大规模实证研究:训练300+模型,系统性研究A, G, S对EL的影响
- 发现可预测的缩放原则:
- 激活比例与EL遵循幂律
- 粒度存在最优范围(~12),呈log-polynomial关系
- EL随计算预算增长而放大
- 构建统一缩放定律:公式(13)准确预测任意MoE配置的EL
- 实验验证7x效率:Ling-mini-beta以0.85B参数匹配6.1B稠密模型
技术影响
- 架构设计指导:为MoE模型提供原则性的设计基础
- 资源优化:帮助在给定计算预算下选择最优MoE配置
- 公平比较框架:EL指标消除数据集偏差,实现架构间公平对比
- 工业应用:Ling-mini-beta验证了缩放定律的实用性
局限性
- 仅考虑FLOPs:未纳入内存限制和通信开销
- 独立性假设:假设A, G, S的影响相互独立,可能忽略交互效应
- 理论与实际差距:FLOPs与实际墙钟时间存在差异
- 粒度定义差异:与Ludziejewski et al. (2024)使用不同定义,导致结论差异
九、参考资源
- 论文:arXiv:2507.17702
- 模型:Ling-mini-beta (17B-A0.8B) - Ling-2.0系列先导模型
- 对比基线:Dense-6.1B
- 训练数据:1T tokens多语言语料(Ling Team构建)
- 相关工作:
- DeepSeekMoE: 细粒度专家设计
- Chinchilla: 计算最优训练
- Ludziejewski et al. (2024/2025): MoE缩放定律
- Abnar et al. (2025): 最优稀疏性缩放