Filter-And-Refine: A MLLM Based Cascade System for Industrial-Scale Video Content Moderation
基于多模态大语言模型的级联系统,用于工业级视频内容审核,通过路由器-排序器架构降低计算成本
Filter-And-Refine: A MLLM Based Cascade System for Industrial-Scale Video Content Moderation
论文信息: arXiv:2507.17204 [cs.LG] 23 Jul 2025
机构: 字节跳动 (ByteDance Inc.)
模型规模: Mistral-7B + ViT-Large
一、论文概述
1.1 研究背景
短视频平台(YouTube Shorts、Instagram Reels)的快速发展使内容审核变得至关重要。传统视频分类模型在处理复杂场景(如隐含有害内容和上下文歧义)时存在局限性。
核心挑战:
| 挑战 | 说明 |
|---|---|
| 计算成本 | MLLM 部署成本高昂,无法直接全量部署 |
| 模型适配 | 生成式模型难以直接用于判别式分类任务 |
| 数据需求 | 传统方法需要大量标注数据 |
| 实时性 | 工业级系统需要低延迟处理海量视频 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| 路由器-排序器级联系统 | 轻量级路由器过滤 + MLLM 精细排序 |
| 生成式到判别式转换 | 将生成式 MLLM 转换为多模态分类器 |
| 最小化微调数据 | 仅需 2% 的标注数据即可达到优异性能 |
| 工业级部署验证 | 在真实生产环境中验证系统效果 |
1.3 一句话总结
Filter-And-Refine 是一个基于 MLLM 的级联视频内容审核系统,通过路由器-排序器架构实现工业级部署,F1 分数提升 66.50%,计算成本仅为直接部署的 1.5%。
二、核心思想
2.1 设计原则
┌─────────────────────────────────────────────────────────────────┐
│                    Filter-And-Refine 设计原则                    │
├─────────────────────────────────────────────────────────────────┤
│  1. 级联架构 (Cascade Architecture)                              │
│     • 轻量级路由器:快速过滤低风险内容                            │
│     • MLLM 排序器:精细分析高风险内容                            │
│     • 降低计算成本,提高处理效率                                  │
│                                                                 │
│  2. 模型适配 (Model Adaptation)                                  │
│     • 将生成式 MLLM 转换为判别式分类器                           │
│     • 最小化微调数据需求                                        │
│     • 保持 MLLM 的推理能力                                      │
└─────────────────────────────────────────────────────────────────┘
2.2 关键技术问题
| 问题 | 现有方案的局限 | Filter-And-Refine 解决方案 |
|---|---|---|
| 计算成本 | 直接部署 MLLM 成本过高 | 级联架构,路由器过滤 97.5% 流量 |
| 模型适配 | 生成式模型不适合分类任务 | 最小化微调,将生成式转换为判别式 |
| 数据需求 | 传统方法需要大量标注数据 | 仅需 2% 的标注数据 |
| 实时性 | MLLM 推理延迟高 | 路由器无延迟,排序器仅处理高风险内容 |
三、技术架构
3.1 整体架构
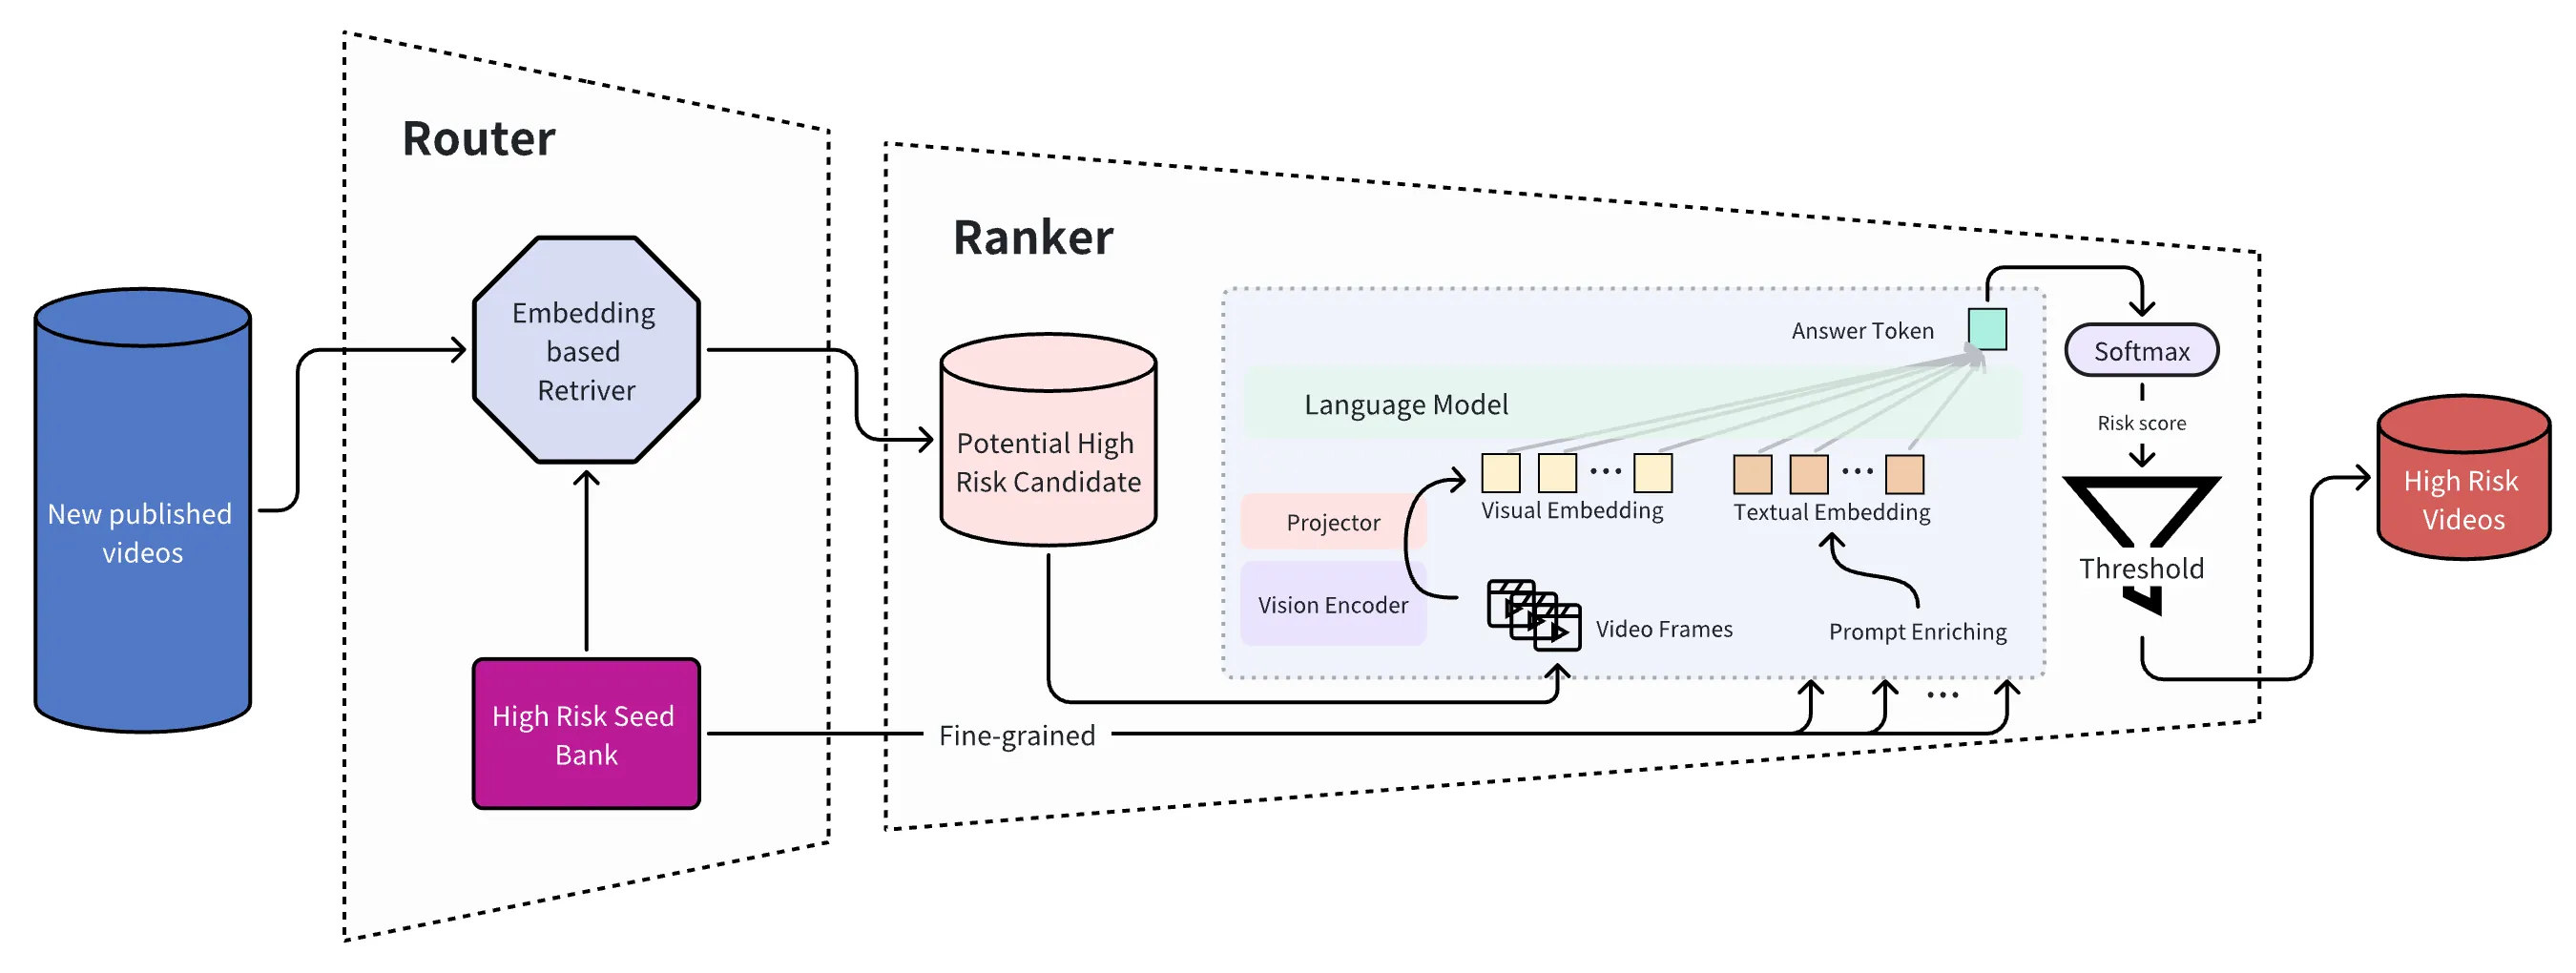 图 1:级联系统设计概览。系统由两个阶段组成:路由器和排序器。路由器过滤并选择潜在高风险内容,排序器进行精细分类以优化最终决策。
核心组件:
| 组件 | 说明 | 关键特性 |
|---|---|---|
| 路由器 (Router) | 轻量级第一阶段过滤器 | 基于嵌入检索,无监督学习 |
| 排序器 (Ranker) | MLLM 第二阶段精细分析 | Mistral-7B + ViT-Large |
| 种子库 (Seed Bank) | 高风险代表性视频库 | 支持快速适应和灵活调整 |
3.2 路由器设计
路由器采用嵌入检索系统作为第一阶段过滤器:
工作原理:
- 维护一个高风险代表性视频库(种子视频)
- 新发布视频基于语义相似性与种子视频进行匹配
- 选择高风险候选内容进入排序器
种子选择策略:
- 质心近邻种子选择:使用聚类算法识别高质量种子
- 人工种子选择:依赖标注员识别”黄金种子”
优势:
- 无需标注数据,无监督训练
- 种子库架构支持快速适应
- 高召回率,过滤 97.5% 低风险内容
3.3 排序器设计
排序器基于 LLaVA 架构:
| 组件 | 说明 | 关键参数 |
|---|---|---|
| LLM | Mistral-7B | 兼容工业部署环境 |
| 视觉编码器 | ViT-Large | 鲁棒的视觉特征提取 |
| 投影器 | 两层 MLP | 对齐视觉和语言表示 |
训练目标:
- 标准下一个 token 预测(用于 VQA 数据集)
- 单 token 预测(用于分类任务)
3.4 输出转换算法
将 MLLM 输出转换为概率分数:
算法 1:修改输出伪代码

输入:提示词 P, 模型 M, 分词器 T
输出:分数 S = [p_Y, p_N]

步骤 1:模型推理
  input_ids ← T.tokenize(P)
  output_ids ← M.generate(input_ids)
  logits ← output_ids.scores

步骤 2:计算答案概率
  ℓ_Y ← logits[Y]
  ℓ_N ← logits[N]

  计算 softmax 概率:
  p_Y ← e^ℓ_Y / (e^ℓ_Y + e^ℓ_N)
  p_N ← e^ℓ_N / (e^ℓ_Y + e^ℓ_N)

步骤 3:生成输出分数
  S ← [p_Y, p_N]  {最终概率列表}

返回 S
四、训练策略
4.1 训练数据
三部分数据集(总计约 300k 样本,1:1:1 比例):
| 数据集 | 说明 | 用途 |
|---|---|---|
| VQA 数据集 | LLaVA-Mix665k 子集 | 视觉理解基础 |
| 视频描述数据集 | 高质量视频描述 | 提供丰富上下文摘要 |
| 分类数据集 | 内容审核任务标签 | 细粒度问题标签和整体标签 |
4.2 训练策略对比
两种 SFT 策略:
| 策略 | 说明 | 训练时间 | 优势 |
|---|---|---|---|
| 多任务学习 | 直接混合 D1, D2, D3 训练 | 20 小时 (8×A100) | 性能稳定 |
| 混合序列阶段学习 | 第一阶段:视觉指令调优;第二阶段:审核导向 SFT | 10 + 10.5 小时 (8×A100) | 时间效率高 |
4.3 提示词设计
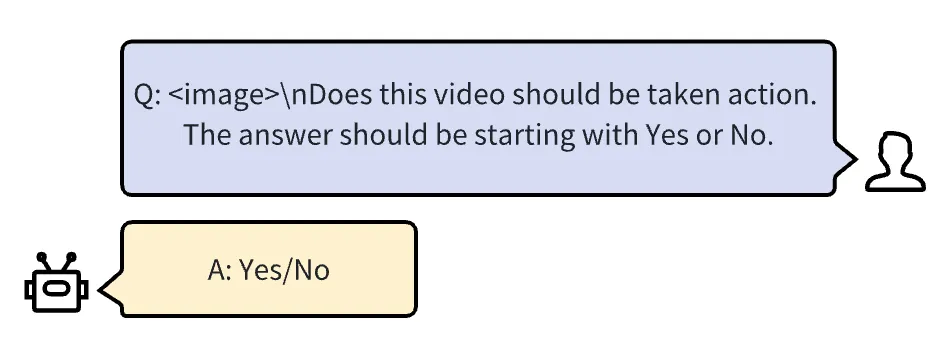 图 2:四种提示词模板示意图
| 模板 | 说明 | PR-AUC |
|---|---|---|
| P1 | 直接询问整体标签 | 66.96 |
| P2 | 分别询问细粒度标签和整体标签 | 68.10 |
| P3 | 顺序询问细粒度和整体标签,强调关系 | 62.43 |
| P4 | 提供细粒度问题定义,分别询问两个问题 | 66.97 |
五、核心创新
5.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 路由器-排序器级联 | 轻量级过滤 + MLLM 精细分析 | 计算成本降至 1.5% |
| 生成式到判别式转换 | 将 MLLM 转换为多模态分类器 | F1 提升 66.50% |
| 最小化微调数据 | 仅需 2% 的标注数据 | 与全量数据性能相当 |
| 嵌入检索路由器 | 无监督种子选择,高召回率 | 过滤 97.5% 流量 |
5.2 技术亮点
1. 级联架构设计:
- 路由器:嵌入检索,无监督学习,高召回率
- 排序器:MLLM 精细分析,高精度
- 整体:计算成本降低 98.5%
2. 模型适配方法:
- 单 token 输出(Yes/No)模拟分类
- softmax 转换为概率分数
- 支持阈值调整优化模型行为
3. 最小化数据需求:
- 传统方法需要大量标注数据
- 本方法仅需 2% 的标注数据
- 节省大量人工标注成本
六、实验结果
6.1 离线评估结果
模型架构对比:
| 模型 | 提示词 | PR-AUC (%) | ROC-AUC (%) | Max-F1 (%) |
|---|---|---|---|---|
| X-VLM | - | 30.79 | 65.31 | 36.81 |
| LLaVA | - | 23.17 | 58.59 | 31.32 |
| LLaVA w/ Caption | - | 28.85 | 65.88 | 36.71 |
| 混合序列阶段学习 | P2 | 68.10 | 87.47 | 60.98 |
| 多任务学习 | P2 | 68.73 | 87.68 | 61.29 |
关键发现:
- 模型架构:MLLM 在 F1 分数上显著超越传统多模态分类模型 66.50%
- 监督微调:微调后的 MLLM 在 PR-AUC 上超越零样本模型 45.55%
- 训练策略:多任务学习模型在所有提示词上表现更稳定
6.2 消融实验
标签组装方法对比:
| 方法 | PR-AUC (%) | ROC-AUC (%) | Max-F1 (%) |
|---|---|---|---|
| 原始 | 68.73 | 87.68 | 61.29 |
| 联合概率 | 68.78 | 87.83 | 61.28 |
| 最大概率 | 68.79 | 87.78 | 61.29 |
| 加权和概率 | 68.83 | 87.78 | 61.28 |
| 贝叶斯融合 | 68.67 | 87.79 | 61.22 |
温度调优:
- 温度范围 0.2-0.8 对模型性能影响不大
6.3 在线实验结果
A/B 实验结果(12 个代表性问题):
| 指标 | 结果 |
|---|---|
| 自动审核量提升 | +41.27% |
| 系统精度提升 | +19.16% |
| 路由器过滤流量 | 97.5% |
| 计算成本 | 仅为直接部署的 1.5% |
| 标注数据使用 | 仅需传统方法的 2% |
6.4 可视化分析
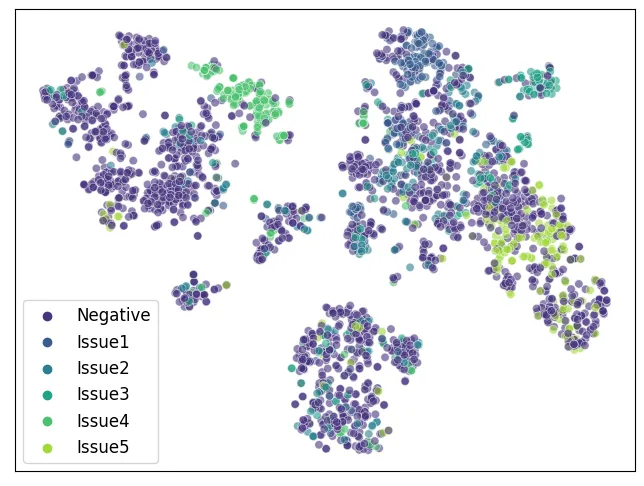 图 3:从每个模型的最后一层隐藏层提取的嵌入可视化
关键发现:
- LLaVA 原始模型:决策边界模糊
- LLaVA w/ Caption:决策边界有所改善
- 最佳微调模型:清晰的决策边界
七、应用场景
7.1 视频内容审核
- 有害内容检测:暴力、色情、仇恨言论等
- 隐含违规识别:微妙形式的虚假信息或暗示性图像
- 上下文理解:理解视频内容的上下文含义
7.2 工业级部署
- 高流量处理:每日数亿新视频上传
- 实时审核:低延迟处理海量视频
- 成本控制:计算成本降至直接部署的 1.5%
7.3 灵活适应
- 快速调整:通过修改种子库快速适应新违规类型
- 提示词工程:无需重新训练即可适应不同审核任务
- 阈值调整:通过调整阈值优化模型行为
八、相关工作
8.1 基于 ML 的内容审核
| 方法 | 特点 | 局限性 |
|---|---|---|
| 传统视频分类 | 处理明确定义的审核任务 | 难以处理复杂场景 |
| MLLM 零样本 | 无需微调即可使用 | 性能有限 |
| MLLM 微调 | 本方法 | 需要一定标注数据 |
8.2 MLLM 与监督微调
| 方法 | 特点 | 局限性 |
|---|---|---|
| LLaVA | 强大的多模态理解 | 生成式模型不适合分类 |
| X-VLM | 传统多模态分类 | 性能有限 |
| 本方法 | 生成式到判别式转换 | 需要微调数据 |
九、总结
9.1 核心贡献
- 路由器-排序器级联系统:实现工业级 MLLM 部署
- 生成式到判别式转换:将 MLLM 转换为多模态分类器
- 最小化微调数据:仅需 2% 的标注数据
- 工业级验证:在真实生产环境中验证系统效果
9.2 技术影响
| 影响领域 | 具体影响 |
|---|---|
| 内容审核 | 推动 MLLM 在内容审核中的应用 |
| 模型部署 | 提供工业级 MLLM 部署方案 |
| 数据效率 | 展示最小化数据需求的微调方法 |
| 成本控制 | 显著降低计算成本 |
9.3 局限性
- 模型规模:Mistral-7B 仍有一定计算开销
- 提示词敏感:不同提示词性能差异较大
- 温度不敏感:温度调优对性能影响有限
- 数据依赖:仍需要一定数量的标注数据
9.4 未来方向
- 模型压缩:进一步减小模型规模
- 更多任务:扩展到更多内容审核任务
- 实时优化:进一步降低推理延迟
- 主动学习:减少标注数据需求
十、参考资源
10.1 论文链接
10.2 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | 级联系统架构 | figure-1-cascade-system.png |
| 图 2 | 提示词模板 | figure-2-prompt-templates.png |
| 图 3 | 嵌入可视化 | figure-3-embedding-visualization.png |


10.3 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| LLaVA | Liu et al. | 2024 | 模型架构基础 |
| Mistral-7B | Jiang et al. | 2023 | LLM 骨干 |
| X-VLM | Zeng et al. | 2022 | 传统分类基线 |
10.4 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 级联系统 | Cascade System | 两阶段过滤-排序架构 |
| 路由器 | Router | 第一阶段轻量级过滤器 |
| 排序器 | Ranker | 第二阶段 MLLM 精细分析 |
| 嵌入检索 | Embedding Retrieval | 基于语义相似性的检索 |
| 生成式到判别式 | Generative to Discriminative | 将生成模型转换为分类器 |
分析完成时间:2026年6月17日 分析工具:Claude Code + agent-browser