LIMINAL: Exploring The Frontiers of LLM Decode Performance
An analytical performance model (LIMINAL) that abstracts application requirements and hardware capabilities to systematically explore LLM inference performance limits across current, near-future, and hypothetical hardware
LIMINAL: Exploring The Frontiers of LLM Decode Performance
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LIMINAL: Exploring The Frontiers of LLM Decode Performance |
| 副标题 | Efficient LLM Inference: Bandwidth, Compute, Synchronization, and Capacity are all you need |
| 作者 | Michael Davies, Neal Crago, Karthikeyan Sankaralingam, Christos Kozyrakis |
| 机构 | NVIDIA Research |
| 论文 | https://arxiv.org/abs/2507.14397 |
| 代码 | 未公开 |
| 发布 | arXiv:2507.14397, July 18, 2025 |
| 许可 | CC-BY-4.0 |
二、核心思想
问题定义
大型语言模型(LLM)的推理性能极限在哪里?自回归解码(auto-regressive decoding)阶段面临硬件层面的多重瓶颈:内存带宽有限、内存容量不足、分布式同步延迟过高。现有研究多为特定硬件配置的”点研究”(point studies),难以揭示根本性的性能边界。
解决方案概述
本文提出了 LIMINAL(LLM Inference Memory-bandwidth And Latency)——一个硬件无关的分析性能模型。该模型将应用抽象为依赖算子(characterized by data volume, compute, and synchronization needs),将硬件抽象为计算能力、内存带宽、内存容量和片间同步延迟。通过解析方程表达性能和能效,可以在广泛的当前、近未来和假设硬件配置上系统探索 LLM 推理性能。
模型在现有硬件上的验证显示平均绝对误差为 7.6%。
五大硬件真相(Non-negotiable Hardware Truths)
- 内存容量是第一挑战:Llama-405B 在 64K 上下文下单用户消耗 15.75 GB KV-cache,32 用户批次膨胀至 504 GB。包括模型权重在内,至少需要 385 GB 系统内存。
- 内存带宽是第二挑战:HBM3e 系统对 Llama-405B 约 750 user TPS 见顶;将带宽翻 4 倍(HBM4/3D-DRAM/SRAM)可获得约 3× 提升,达到 1500-2800 user TPS(128K 上下文)。
- 同步延迟是隐形守门员:64-128 芯片系统的 sub-μs all-reduce 对于利用高内存带宽至关重要。
- 系统级能效设定关键权衡:DRAM 设计在 TPS/$ 或 TPS/Watt 方面显著优于 SRAM 设计和晶圆级集成。
- >10,000 TPS 需要算法突破:达到 10,000+ user tokens/sec 不仅需要硬件进化,还需要减少模型规模/上下文长度或引入更多并行性的算法改进。
三、技术架构
LIMINAL 模型框架
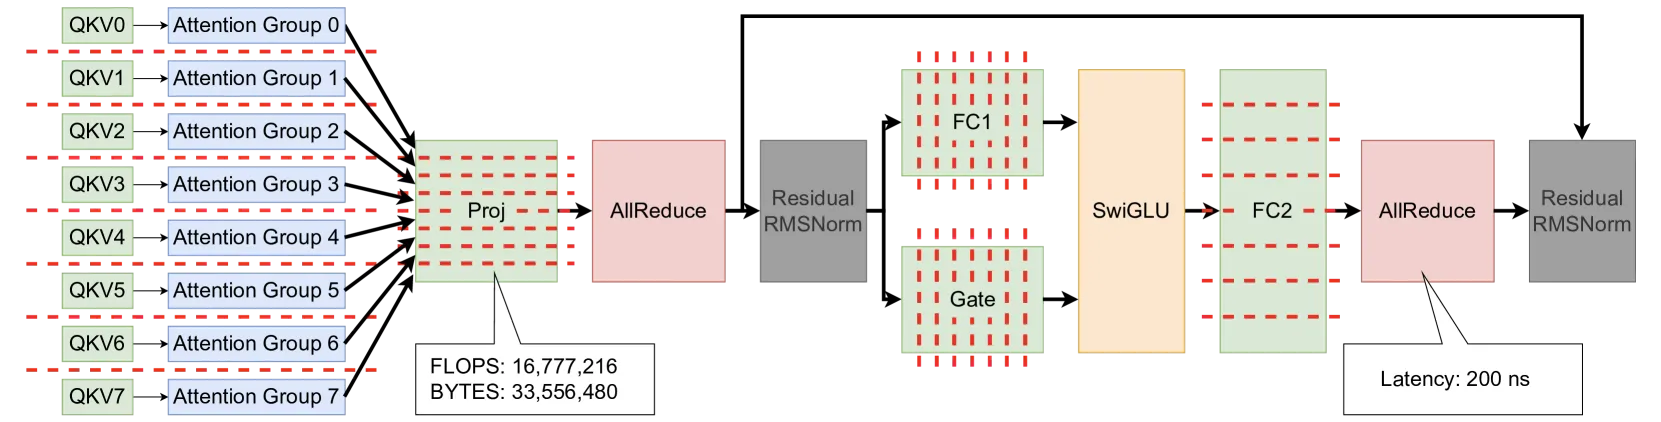
LIMINAL 将 LLM 推理分解为三个核心延迟分量:
T_Batch = max{T_Compute, T_Mem} + T_Exposed

TPS_User = 1 / T_Batch
TPS_System = N_PP * B / T_Batch
核心公式
计算延迟 (Compute Latency, Seconds/Token):
内存延迟 (Memory Latency, Seconds/Token):
暴露延迟 (Exposed Latency):
其中:
- 假设每层 3 次同步操作(context parallelism + head parallelism + FFN tensor parallelism)
- 少于 16 芯片时:
- 超过 16 芯片时:
- Pipeline 单跳通信:
Mini Batch Latency:
评估的硬件配置
| 配置 | 内存带宽 | 计算 | 容量 | 说明 |
|---|---|---|---|---|
| xPU-HBM3 | 4 TB/s | 2.25 PFLOPS/s | 96 GB | 基于 Blackwell GPU (HBM3e) |
| xPU-HBM4 | 18 TB/s | 2.25 PFLOPS/s | 192 GB | HBM4 |
| xPU-3D-DRAM | 30 TB/s | 2.25 PFLOPS/s | 36 GB | 先进 3D 堆叠 DRAM |
| xPU-SRAM | 117 TB/s | 1.13 PFLOPS/s | 512 MB | 纯片上 SRAM |
| xPU-COWS | 2250 TB/s | 28.13 PFLOPS/s | 11 GB | 集合通信优化晶圆级集成 |
评估的模型
| 模型 | 参数量 | 类型 |
|---|---|---|
| Llama3-70B | 70B | Dense |
| Llama3-405B | 405B | Dense |
| DeepSeekV3 | 671B (256×1B experts) | MoE |
上下文长度:1K ~ 128K,batch size:1 ~ 64。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 硬件无关性能模型 | 抽象掉具体芯片细节,仅保留计算/带宽/容量/同步四个维度 | 解析方程,mean absolute error 7.6% |
| 跨技术探索 | 从 HBM3 到 HBM4、3D-DRAM、SRAM、晶圆级集成全覆盖 | 5 种 xPU 配置的完整参数空间 |
| 五大非协商硬件真相 | 系统性地证明容量、带宽、同步、能效、算法五大约束 | 跨越 3 模型 × 5 硬件 × 多上下文的全面分析 |
| 10K TPS 瓶颈识别 | 证明纯硬件演进无法达到 10K TPS,需要算法协同 | 图5 显示即使最优硬件也无法突破此界限 |
五、实验结果
基准测试:各硬件配置的用户 TPS 和系统 TPS
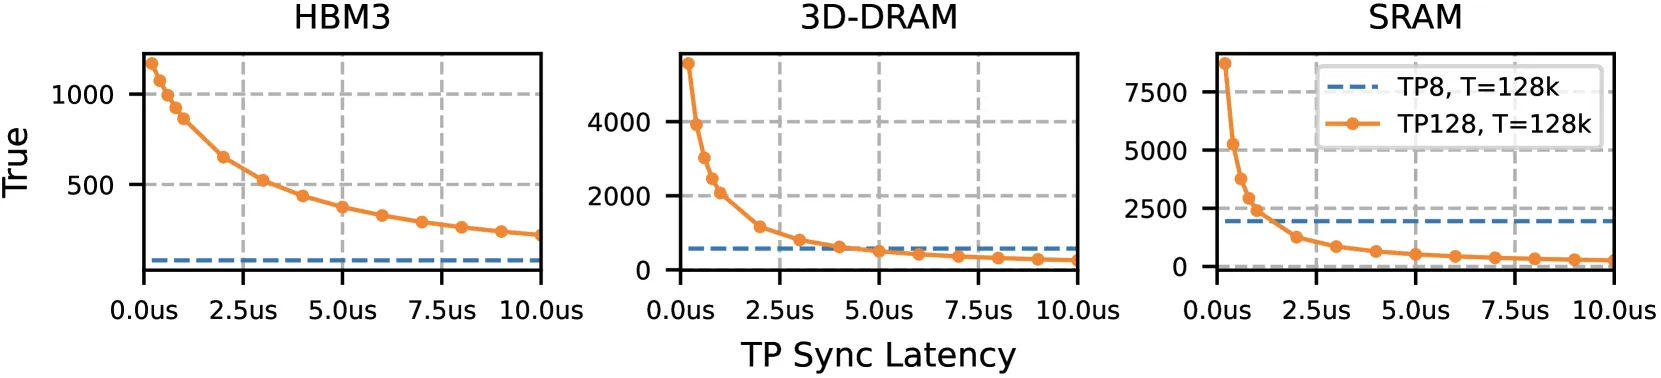
表:不同硬件配置下的最大 User TPS 和 System TPS
| 模型 | 配置 | 4K Context UTPS | 128K Context UTPS | Max STPS (UTPS@peak) |
|---|---|---|---|---|
| Llama3-70B | HBM3-TP8 | 486 | 378 | 48K (43) |
| Llama3-70B | HBM3-TP32 | 1.2K | 990 | 202K (42) |
| Llama3-70B | HBM3-TP128 | 2.1K | 1.9K | 822K (42) |
| Llama3-405B | HBM3-TP8 | 86 | 80 | 17K (43) |
| Llama3-405B | HBM3-TP32 | 290 | 271 | 84K (31) |
| Llama3-405B | HBM3-TP128 | 776 | 743 | 337K (28) |
| DeepSeekV3 | HBM3-TP8 | 52 | 52 | 44K (41) |
| DeepSeekV3 | HBM3-TP32 | 196 | 195 | 363K (20) |
| DeepSeekV3 | HBM3-TP128 | 661 | 657 | 1.5M (17) |
带宽扩展分析
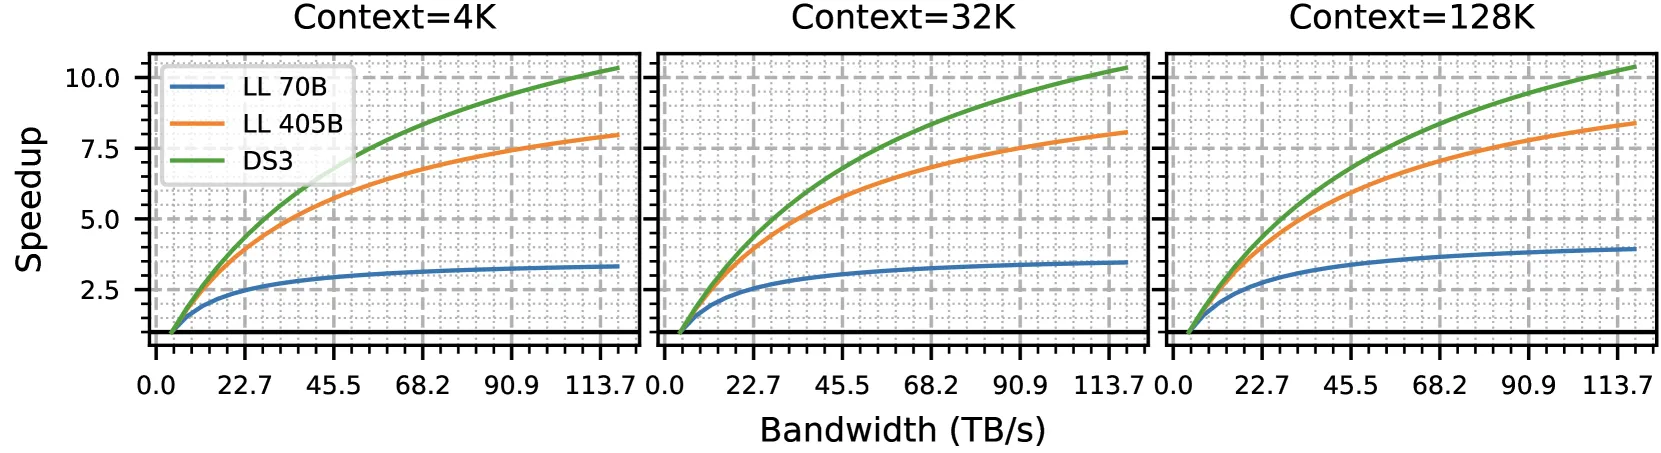
带宽翻倍或翻四倍可提供显著的 UTPS 提升,但存在边际递减效应——当带宽继续增加时,暴露的通信延迟占比越来越大,成为新的瓶颈。
能效分析
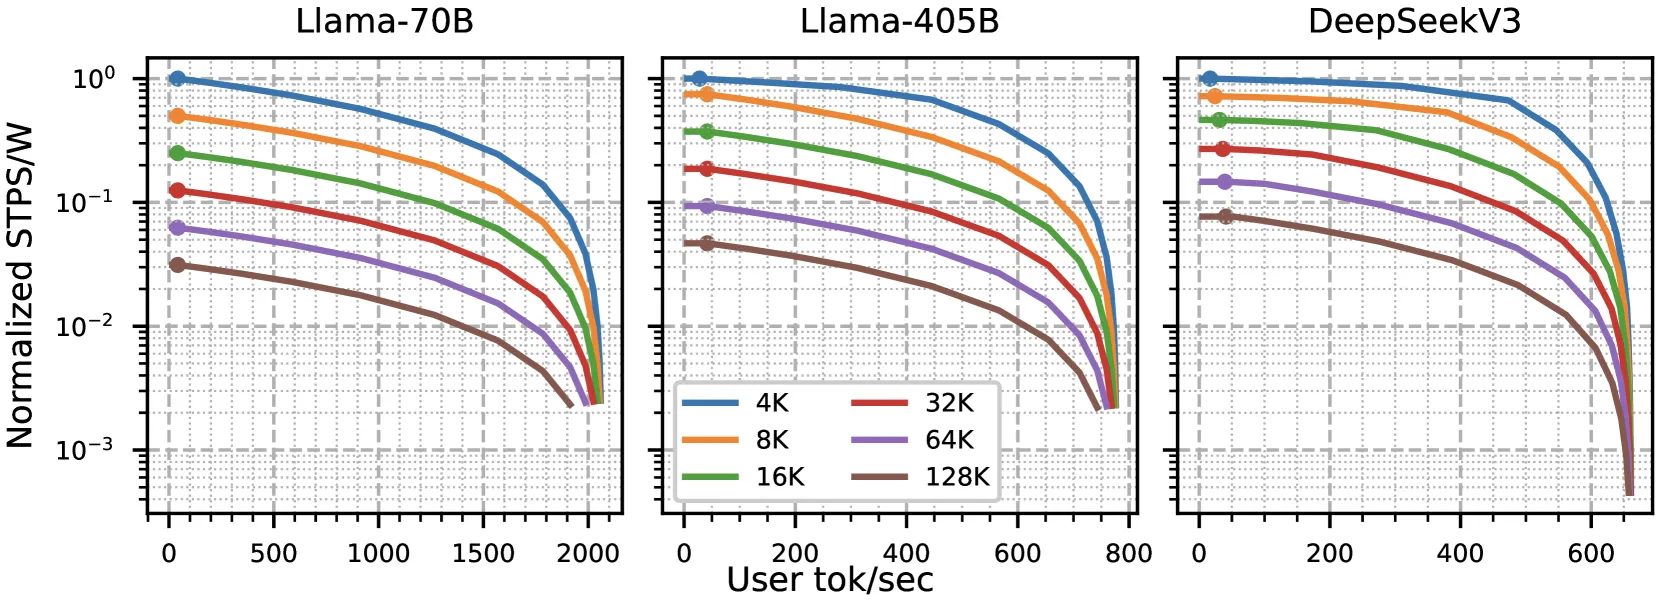
- Llama3-70B 在 4K 上下文下,UTPS 降低约 10%(从 2059 降至 1913),STPS/Watt 提升近 30×
- DeepSeekV3 的 MoE 特性使得 batch size 增加时专家利用率大幅提升,带来独特的能效增益
- 大上下文(128K)显著削弱了权重重用带来的能效优势
硬件技术对比
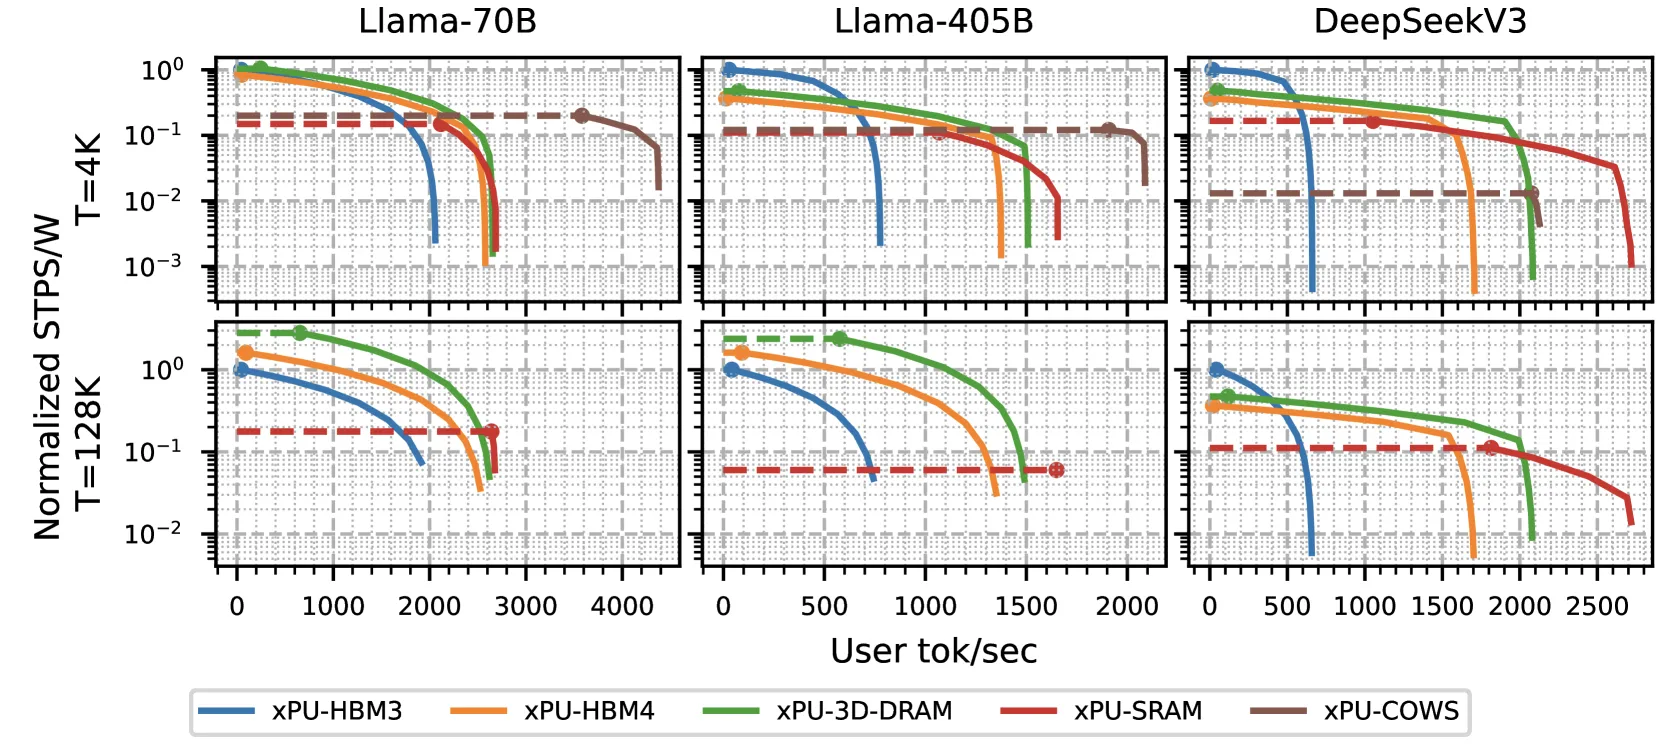
- HBM4 和 3D-DRAM:在大型模型上提供 2× UTPS 提升和更好的 STPS/Watt
- SRAM-only 和 COWS:在小模型小上下文下表现优异,但在大上下文下受容量限制无法服务
- DRAM 的弹性优势:能够在不同模型、不同上下文长度、不同用户体验-能效权衡之间灵活适配
计算瓶颈分析
LLM Decode 严重受内存带宽约束。即使在最优 SRAM 设计中,低 batch 场景下 tensor 计算利用率仍 ≤1%。仅 DeepSeekV3 在大 batch 小上下文时,部分 DRAM 设计会触及计算瓶颈。
六、相关工作
| 工作 | 关系 |
|---|---|
| NeuSight | 使用当前 GPU 预测未来 GPU 性能,目标不同 |
| SMAUG | 混合解析建模+周期级仿真,但不提供 LIMINAL 的多样化 app×hardware 分析 |
| DNNWeaver/DNNBuilder/Magnet | RTL 生成级别框架,缺乏端到端 DL 应用性能分析 |
| FlexGen | 单 GPU 极端模型服务,通过 PCIe 流式传输,不适用于大规模 decode |
| ZeRO/DeepSpeed/PaRO | 训练优化技术,不适用于推理 decode |
| ACTA (GPGPU’25) | ACTA 解决 TMA 配置自动化,LIMINAL 解决系统级性能极限分析 |
| Singe (PPoPP’14) | Warp specialization 编译器,关注 kernel 级优化 |
七、总结
核心贡献
- LIMINAL 性能模型:首个硬件无关的 LLM decode 解析性能模型,抽象为计算、带宽、容量、同步四个维度
- 系统性硬件探索:覆盖 HBM3 → HBM4 → 3D-DRAM → SRAM → COWS 五种内存技术,揭示各自的适用场景和局限
- 五大硬件真相:确立了内存容量、带宽、同步、能效、算法五个不可协商的挑战
- 10K TPS 边界:证明纯硬件演进无法达到 10,000+ user TPS,需要模型缩小、上下文缩短或解码并行化等算法突破
技术影响
LIMINAL 为 LLM 推理硬件设计提供了第一性原理的指导:
- 短期:HBM4 和 3D-DRAM 可在 128K 上下文下将 TPS 提升至 1500-2800
- 中期:sub-μs 同步延迟对于 64-128 芯片系统利用高带宽至关重要
- 长期:10K TPS 目标需要算法-硬件协同设计,而非单纯堆硬件
局限性
- 假设近乎完美的预取(near-perfect prefetching),忽略了实际系统中的内存缓存 miss 和预取失败
- 抽象掉了微架构细节(pipeline 组织、指令调度、内存控制器设计等)
- 未显式建模软件开销(OS 干扰、driver 开销、runtime 库开销)
- 仅覆盖 decode 阶段,未分析 prefill 阶段的性能特征
八、参考资源
- arXiv: https://arxiv.org/abs/2507.14397
- HTML: https://arxiv.org/html/2507.14397v1
- Appendix A: Model details (Llama3-70B, Llama3-405B, DeepSeekV3 FLOPs computation, MoE imbalance)
- Appendix B: Extended results for various context lengths
- Appendix C: PIM-based LLM serving analysis
- Appendix D: Power model details (based on TDP and DRAMPower)
- Appendix E: Model validation against real hardware