LaCache: Ladder-Shaped KV Caching for Efficient Long-Context Modeling of Large Language Models
梯形KV缓存模式,实现长上下文LLM推理的高效内存管理与连续生成
LaCache: Ladder-Shaped KV Caching for Efficient Long-Context Modeling of Large Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LaCache: Ladder-Shaped KV Caching for Efficient Long-Context Modeling of Large Language Models |
| 作者 | Jiaqi Cao, Jiaru Zhong, Zicheng Liu, Xiaoyu Li, Jiahao Fan, Yuxin Peng, Meng Wang |
| 论文 | arXiv:2507.14204 |
| 发布 | 2025-07-18 (v1) |
| 主题 | cs.CL (Computation and Language); cs.AI (Artificial Intelligence) |
二、核心思想
问题定义
现有KV缓存驱逐策略面临两难困境:
-
连续生成 vs 长程能力:
- StreamingLLM(基于最近性):支持无限长度生成,但牺牲长上下文精度
- Quest(基于检索):保持高精度,但内存复杂度O(T),长序列OOM
-
具体挑战:
- 内存随序列长度线性增长
- 长序列导致OOM
- 现有方法无法同时满足连续生成和长程能力
解决方案概述
LaCache是一个免训练的KV缓存优化框架,采用梯形存储模式:
- 梯形KV缓存模式:在浅层保留早期token的KV状态,在深层逐步聚焦到后续token,形成阶梯状结构
- 迭代压缩机制:周期性地对已压缩的KV状态应用梯形压缩,支持无限长度生成
核心优势:
- 扩展了捕获长程依赖的跨度
- 提高了所有token的整体信息保留下界
- 兼容FlashAttention,实现高效推理
三、技术架构
整体框架图
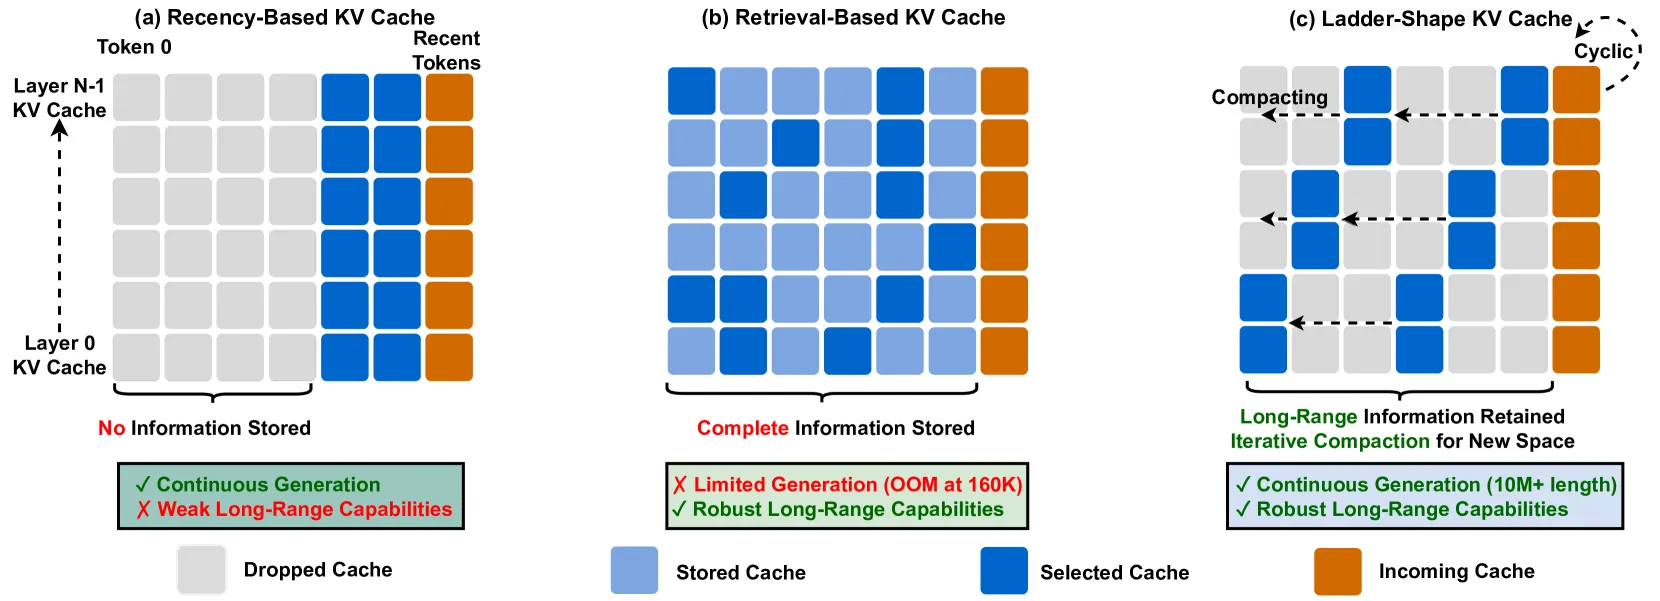
Figure 1: 三种KV缓存策略对比:(a) 基于最近性的KV缓存(StreamingLLM),(b) 基于检索的KV缓存(Quest),(c) LaCache梯形模式。
梯形KV缓存存储模式
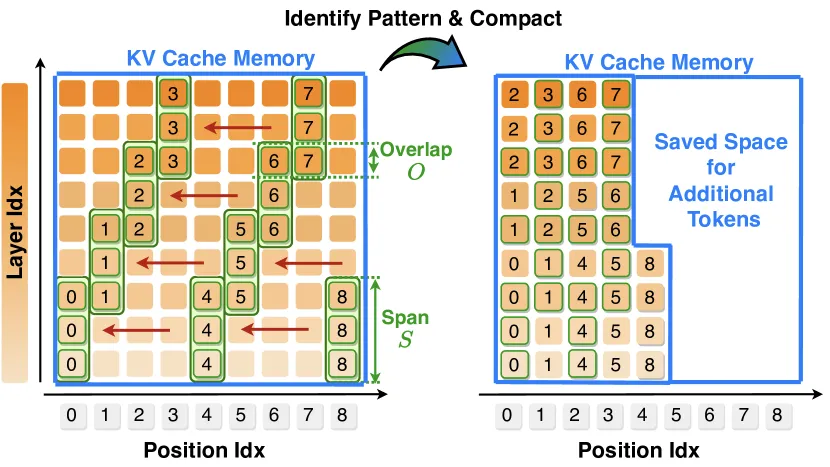
Figure 2: LaCache的KV缓存存储模式示意图。LaCache将原始完整KV缓存压缩为梯形模式,允许存储更多信息。
核心设计原则
1. 跨层梯形结构:
- 浅层保留早期token的KV状态
- 深层逐步聚焦到后续token
- 形成阶梯状结构,扩展长程依赖捕获跨度
2. 部分重叠的平滑过渡:
- 邻近token在自然语言中通常具有更高的语义相关性
- 梯形模式为每个保留的缓存段引入平滑过渡
- 不断扩展的梯形模式与部分重叠实现旧token的平滑衰减
3. 等覆盖策略:
- 不同层保留相同数量的token
- 避免覆盖最少的层出现重要token丢失
- 不等覆盖策略会导致精度下降
随机模式 vs LaCache对比
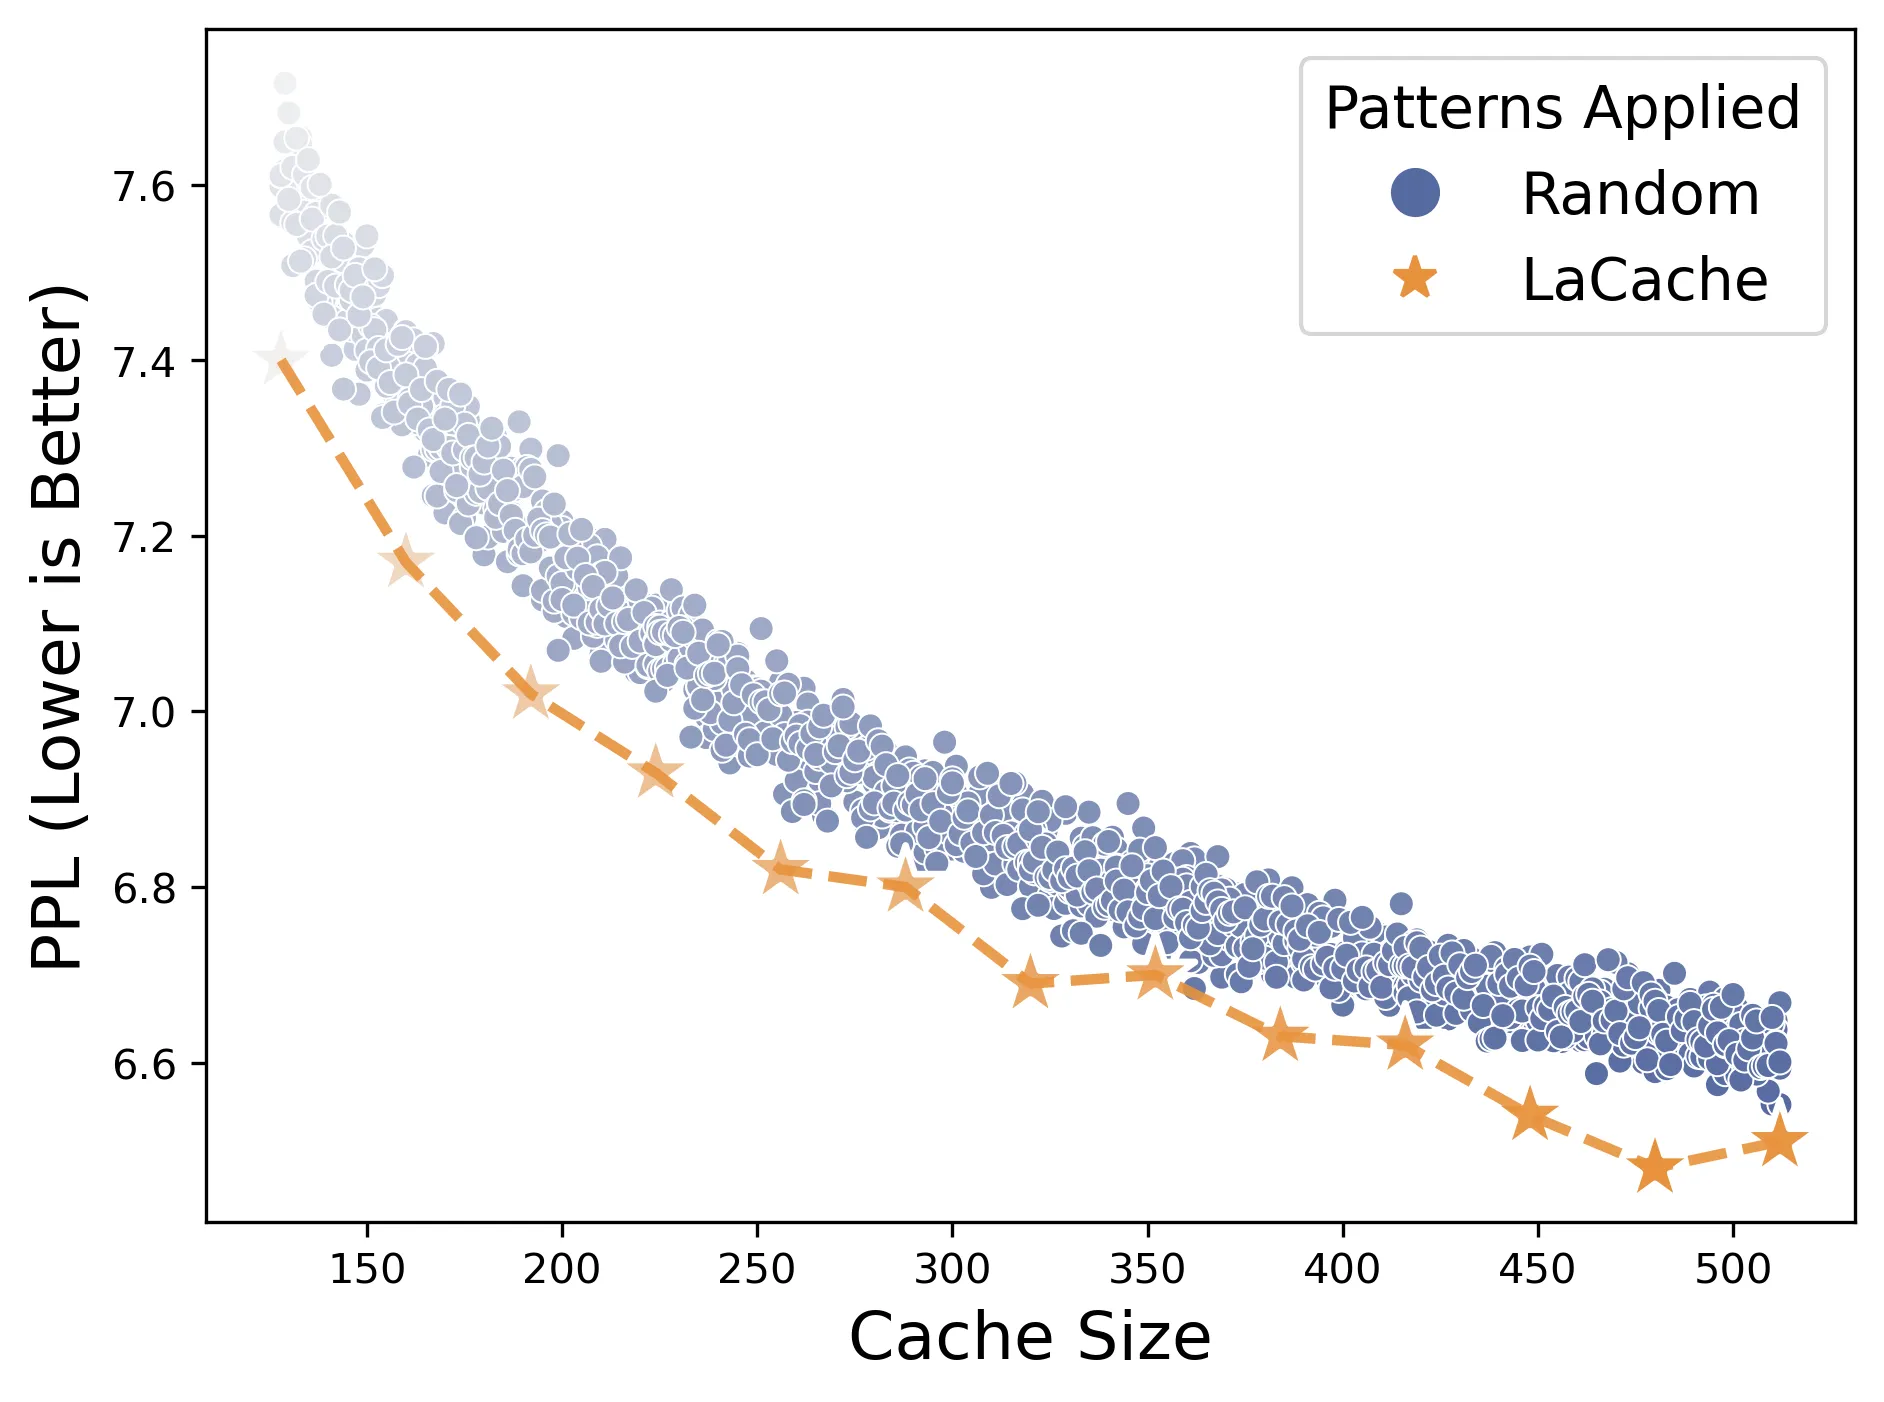
Figure 3: 可视化LaCache与1500+随机采样KV缓存模式之间的PPL与缓存大小权衡。
关键发现:LaCache在相同缓存大小下实现更低的PPL,验证了梯形模式的优越性。
迭代压缩机制
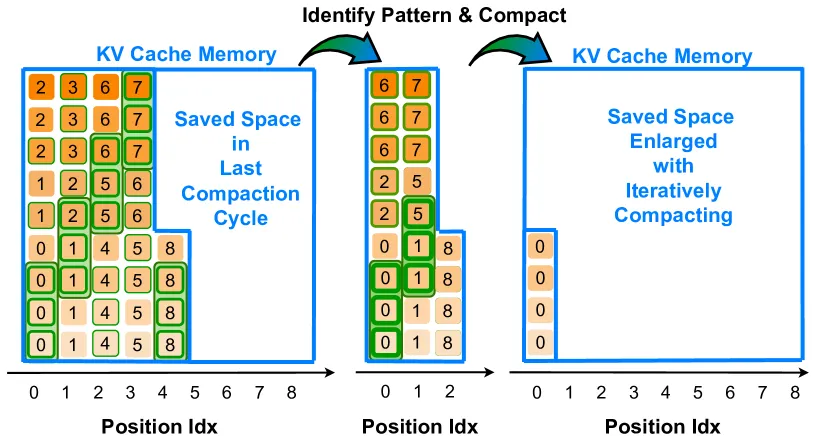
Figure 4: LaCache迭代压缩示意图。迭代压缩支持连续生成而不耗尽内存,即使是无限长度生成。
工作流程:
- 当KV缓存达到容量上限时,对已压缩的KV状态应用LaCache
- 旧token信息被更积极地压缩
- 新token被较少压缩
- 模型优先保留最近信息,同时高效管理内存
优势:
- 旧KV缓存最先被丢弃(符合最近性原则)
- 统一的解决方案和干净的接口
- 支持无限长度生成
四、实验结果
实验设置
- 模型:
- Llama2-7B/13B
- Llama3-8B
- Llama2-7B/13B-Chat
- Llama3.2-3B-Instruct
- SmolLM2-1.7B-Instruct
- LongChat-7b-v1.5
- 数据集:
- Wikitext-2(语言建模)
- PG19(语言建模)
- LongBench(长上下文理解)
- Needle-In-A-Haystack
- RULER
- 基线:StreamingLLM、H2O、TOVA、PyramidInfer、SnapKV
语言建模结果
Wikitext-2 PPL(缓存预算512):
| 模型 | 方法 | 1K | 2K | 4K | 8K | 16K |
|---|---|---|---|---|---|---|
| Llama2-7B | Full (100%) | 4.02 | 4.18 | 5.12 | nan | nan |
| StreamingLLM | 5.54 | 5.84 | 6.32 | 6.93 | 5.36 | |
| LaCache | 4.53 | 5.00 | 5.81 | 6.61 | 5.19 | |
| Llama3-8B | Full (100%) | 4.28 | 4.39 | 5.82 | 6.16 | 109.94 |
| StreamingLLM | 5.46 | 5.33 | 6.73 | 6.99 | 5.52 | |
| LaCache | 4.61 | 4.89 | 6.40 | 6.78 | 5.40 |
关键结果:
- LaCache在所有解码长度下均优于StreamingLLM
- 缓存预算512时,LaCache仅使PPL退化约0.5-1.0
- 当解码长度超过预训练长度时,全缓存模型出现PPL爆炸,而LaCache保持稳定
超长序列生成
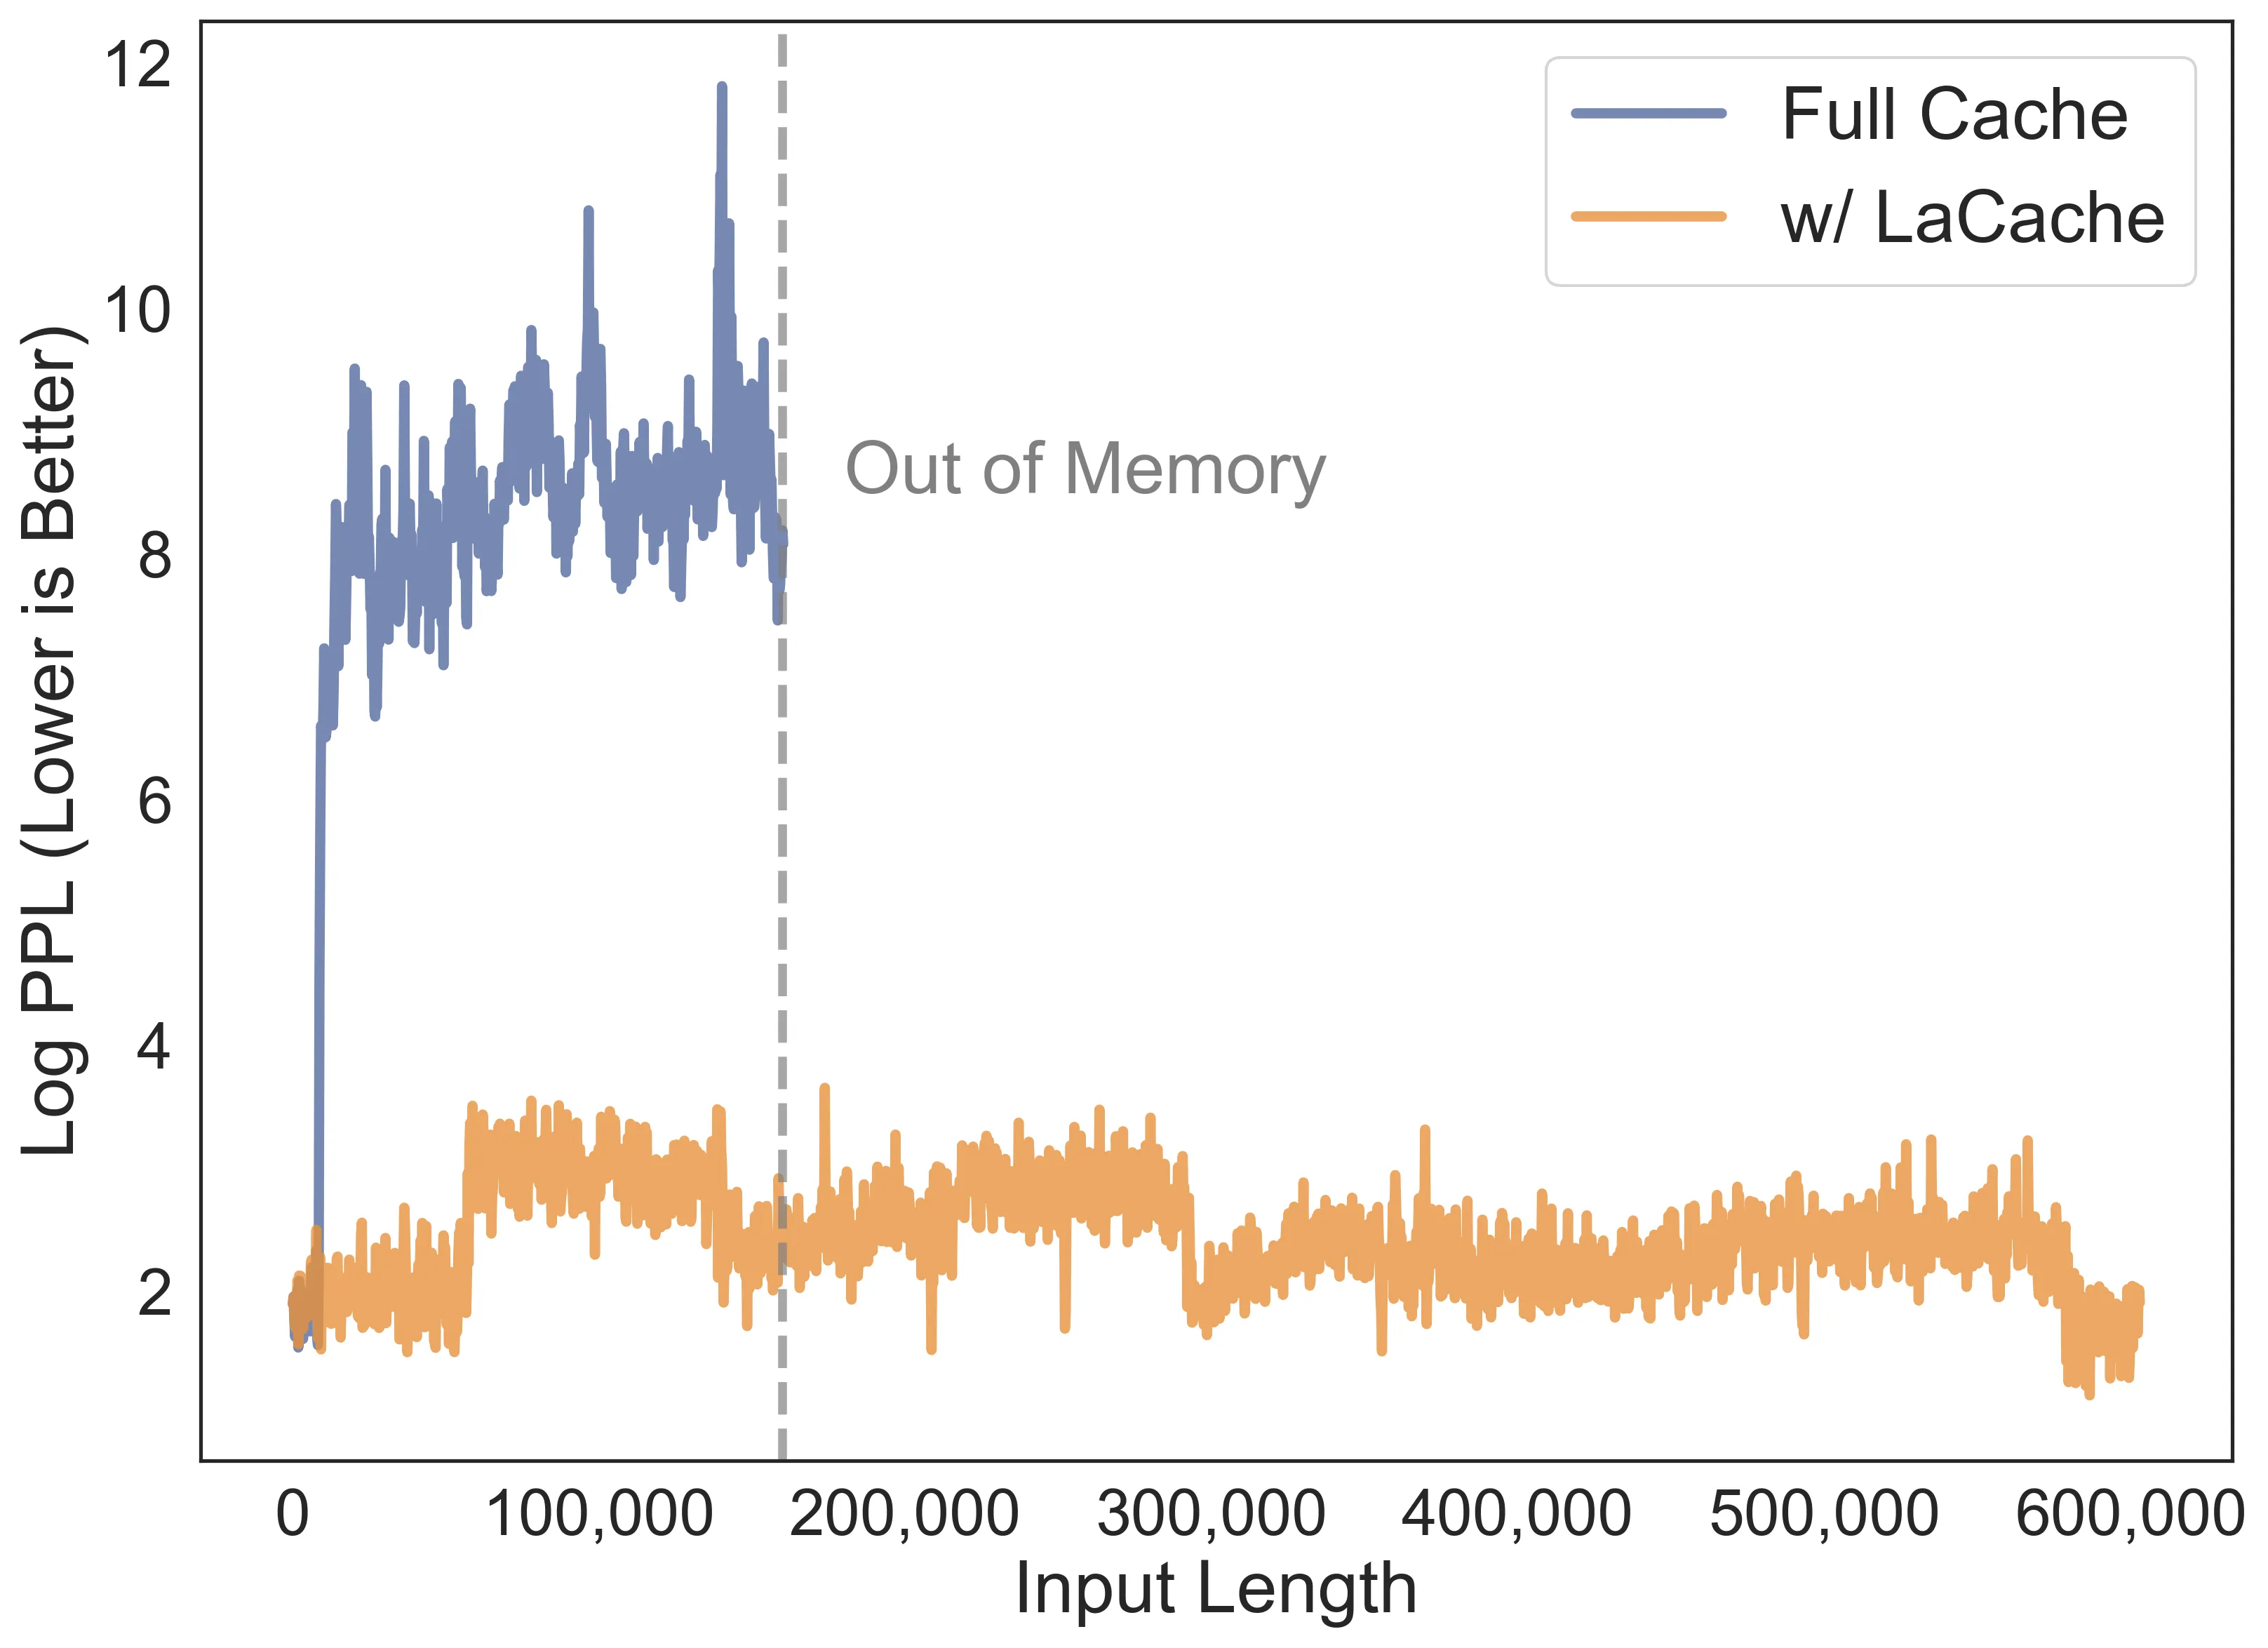
Figure 5: 在连接的PG19数据集前10本书(600K token)上评估LaCache。
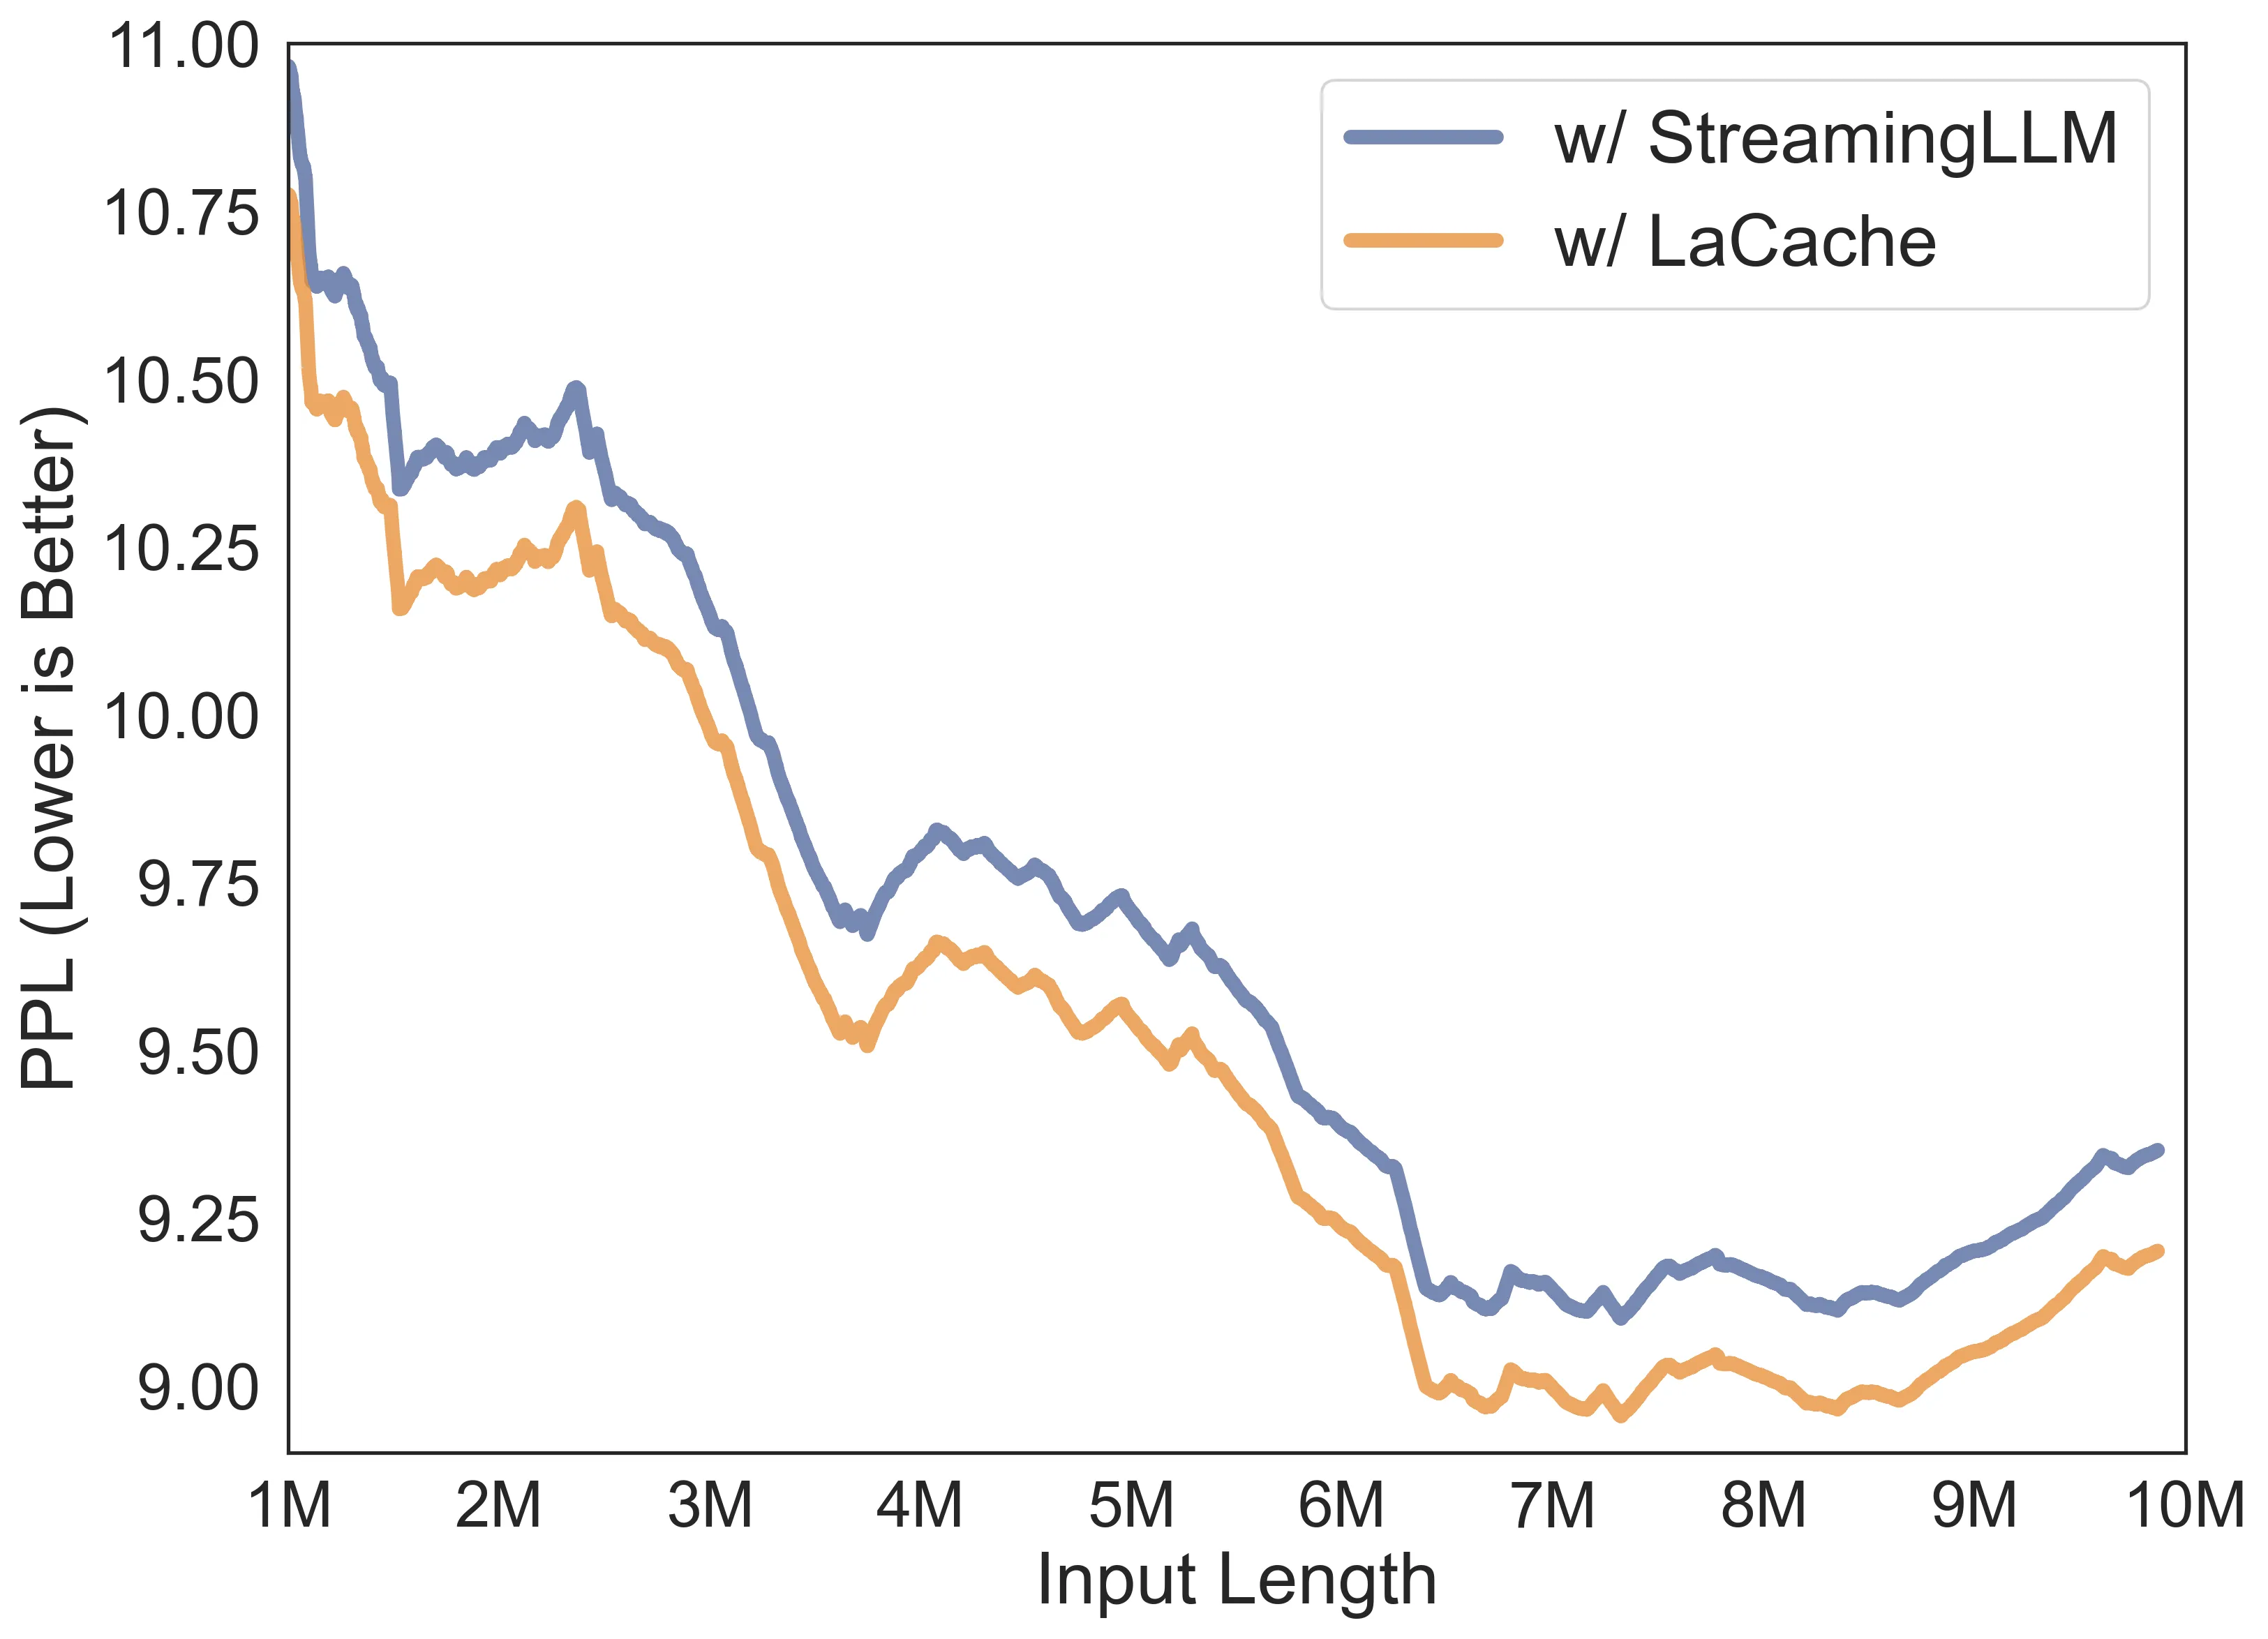
Figure 6: 在整个连接的PG19数据集(1000万token)上评估LaCache。
关键发现:LaCache支持超长序列生成(1000万token),而全缓存模型在超出预训练长度后性能崩溃。
精度-吞吐量权衡
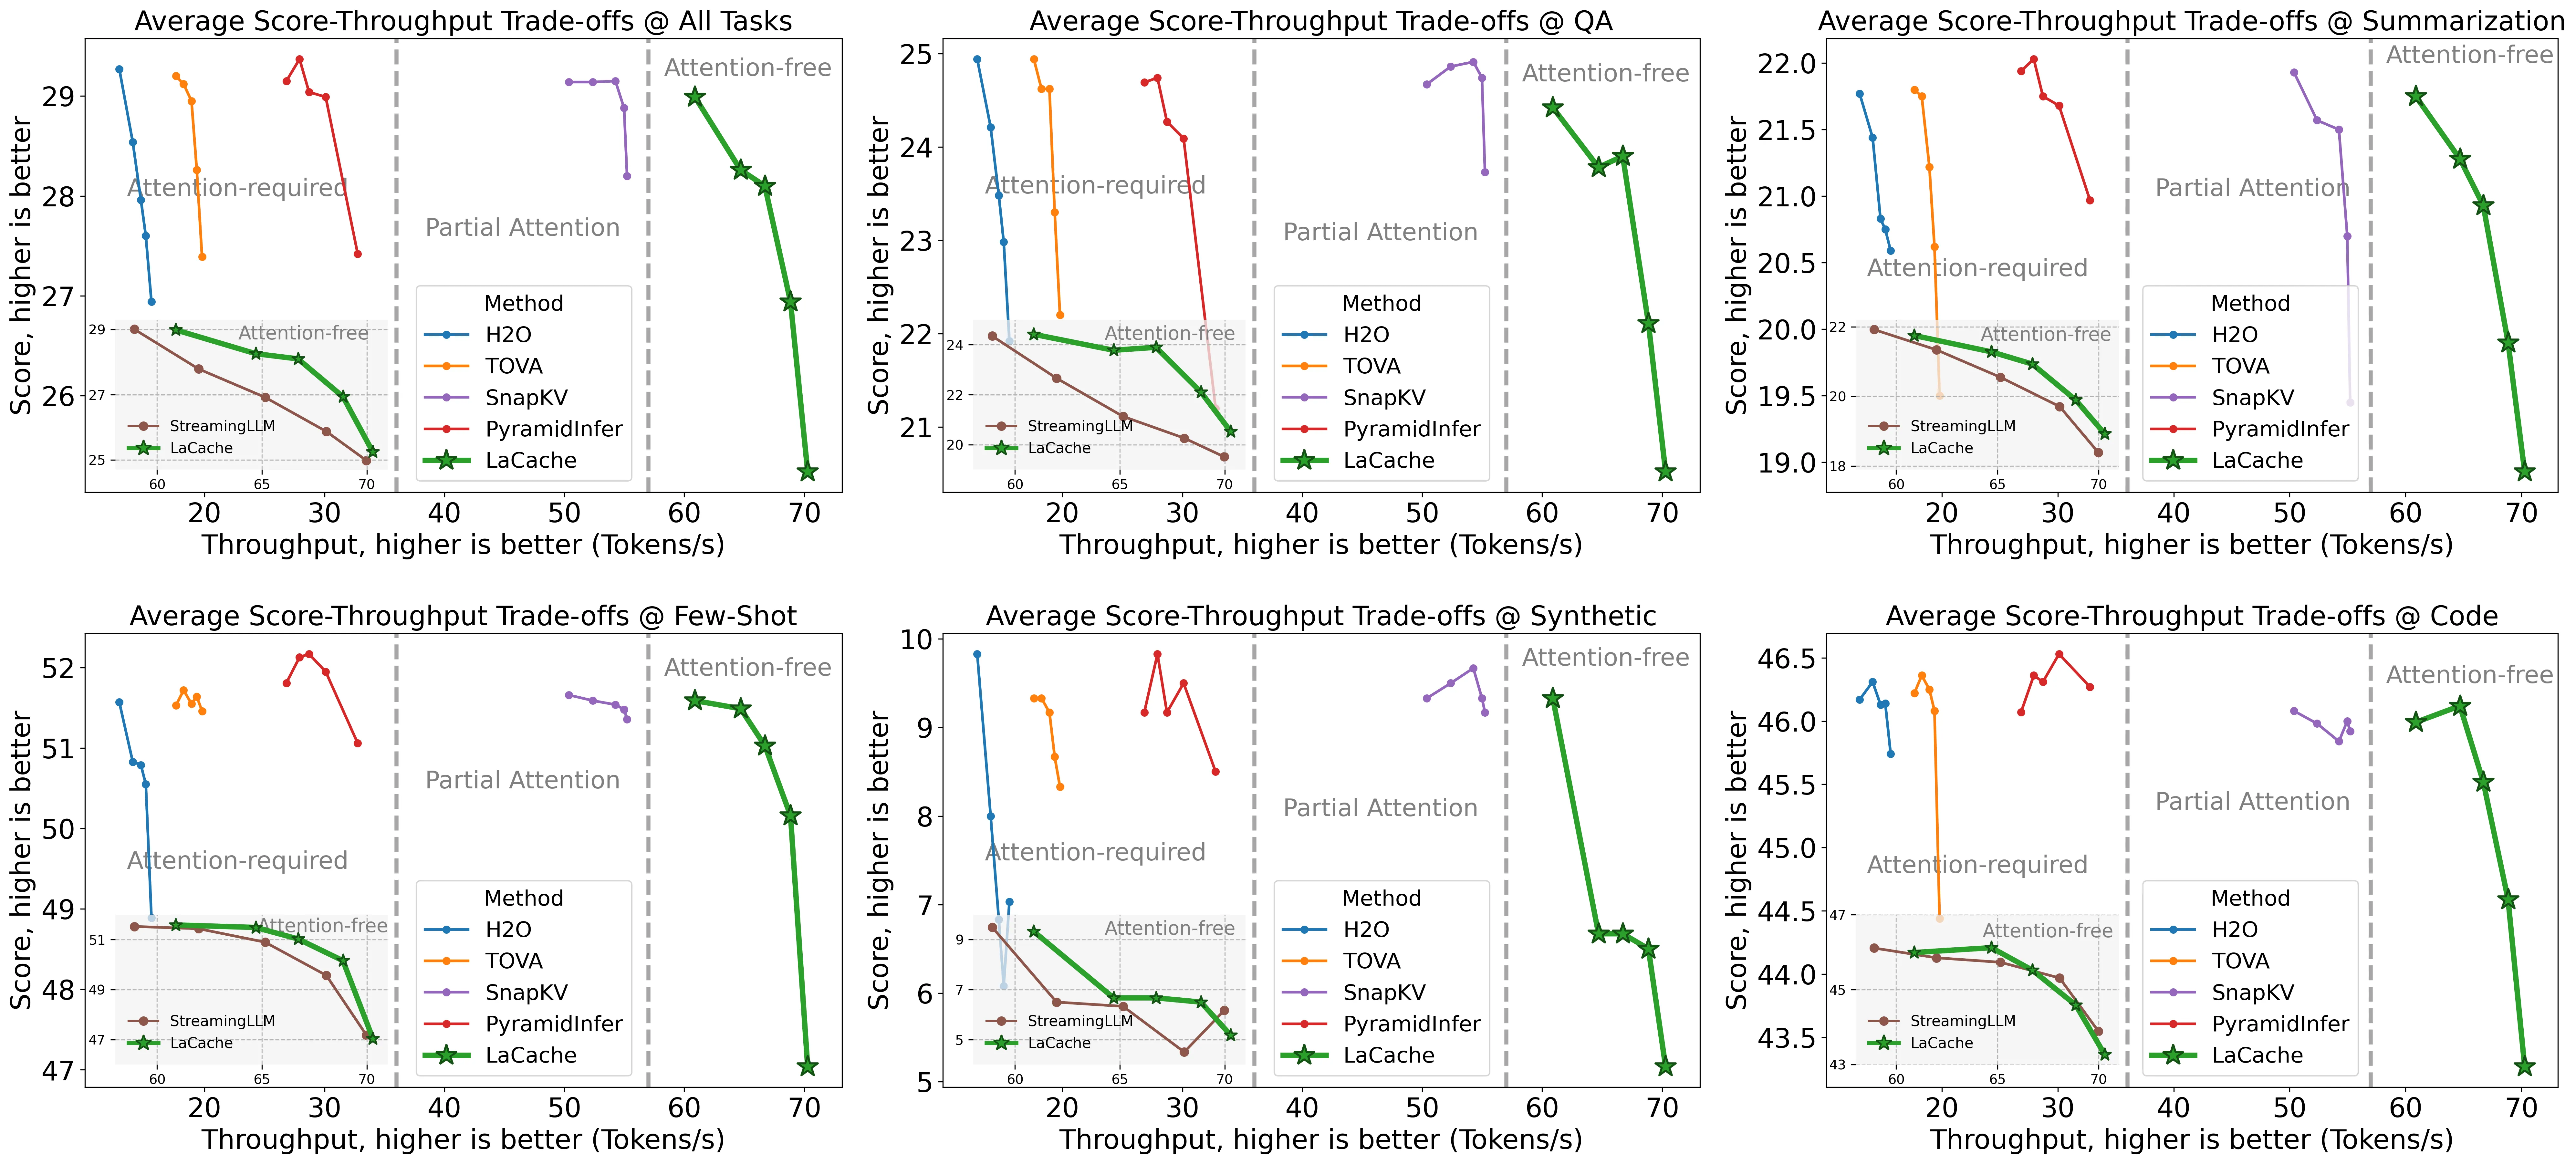
Figure 7: 在单个H200 GPU上评估StreamingLLM、H2O、TOVA、PyramidInfer和LaCache的精度-吞吐量权衡。
关键结果:
- 由于兼容FlashAttention,LaCache在精度-吞吐量权衡上优于H2O等基于重要性的方法
- 实现了更好的精度与效率平衡
Needle-In-A-Haystack测试
Figure 8: 在Llama3.2-3B-Instruct-128k上使用50%缓存预算评估LaCache和StreamingLLM。
Figure 9: 在LongChat-7b-v1.5-32k上使用25%缓存预算评估LaCache和StreamingLLM。
关键发现:
- LaCache在Needle-In-A-Haystack基准上显著优于StreamingLLM
- 更绿的颜色表示更好的性能
- LaCache在不同位置都能正确检索信息
消融实验
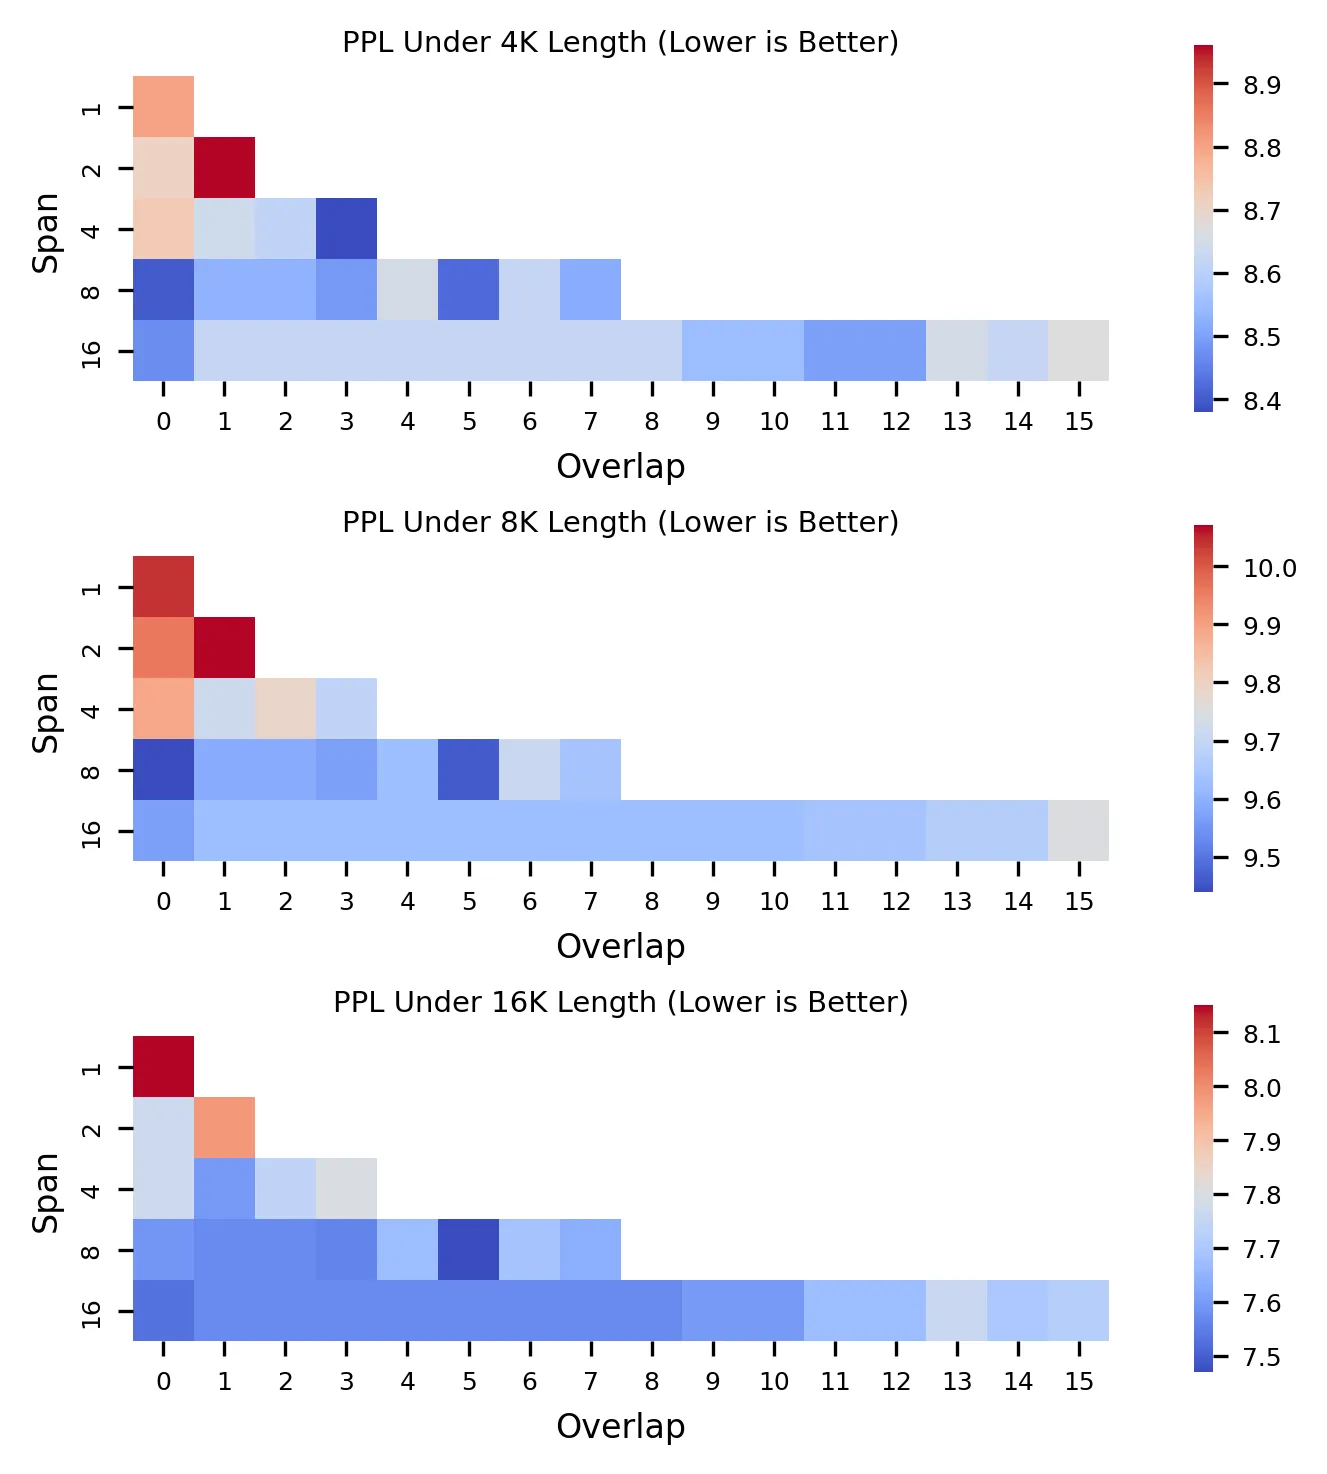
Figure 10: 超参数消融研究。图中报告了困惑度(越低越好)。
关键发现:
- 部分重叠的平滑过渡对性能至关重要
- 等覆盖策略优于不等覆盖策略
五、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 梯形KV缓存模式 | 跨层梯形结构,浅层保留早期token,深层聚焦后续token | 随机模式对比实验验证优越性 |
| 迭代压缩机制 | 周期性应用梯形压缩,支持无限长度生成 | 1000万token生成实验 |
| 等覆盖策略 | 不同层保留相同数量的token | 消融实验验证 |
| 平滑过渡 | 部分重叠实现旧token平滑衰减 | 消融实验验证 |
| FlashAttention兼容 | 无需额外注意力计算,高效推理 | 精度-吞吐量权衡实验 |
六、相关工作对比
| 方法 | 特点 | LaCache优势 |
|---|---|---|
| StreamingLLM | 基于最近性,滑动窗口 | 保留更多历史信息,长程能力更强 |
| H2O | 基于注意力分数驱逐 | 兼容FlashAttention,吞吐量更高 |
| Quest | 基于检索,全缓存 | 内存效率更高,不OOM |
| TOVA | Token级驱逐 | 跨层梯形结构更优 |
| PyramidInfer | 层级分配 | 更简单的统一框架 |
| SnapKV | 观察窗口选择 | 支持连续生成 |
七、总结
核心贡献
- 梯形KV缓存模式:新颖的跨层存储结构,扩展长程依赖捕获跨度
- 迭代压缩机制:支持无限长度连续生成而不OOM
- 免训练设计:无需额外训练或微调,易于部署
- FlashAttention兼容:实现高效推理
性能总结
| 指标 | 提升 |
|---|---|
| PPL(vs StreamingLLM) | 显著降低(约0.5-1.0) |
| 最大生成长度 | 1000万+ token |
| 内存复杂度 | O(1)(固定缓存大小) |
| 兼容性 | FlashAttention |
技术影响
LaCache展示了跨层KV缓存模式的重要性:
- 梯形结构比均匀缓存更有效地保留信息
- 迭代压缩是实现无限长度生成的关键
- 免训练方法在实际部署中更具优势
局限性
- 梯形模式可能不是所有场景的最优解
- 未探索微调对性能的进一步提升
- 特定任务可能需要不同的缓存配置