Dissecting the NVIDIA Blackwell Architecture with Microbenchmarks
用微基准测试解剖 NVIDIA Blackwell 消费级 GPU(GeForce RTX 5080, GB203)架构,并与上一代 Hopper(H100 PCIe, GH100)逐子系统对比——涵盖统一 INT32/FP32 核、精简 FP64、第五代张量核心(FP4/FP6)、内存层次(L1/L2/global)与真实负载(D-GEMM、Transformer 推理)功耗。
Dissecting the NVIDIA Blackwell Architecture with Microbenchmarks
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Dissecting the NVIDIA Blackwell Architecture with Microbenchmarks |
| 作者 | Aaron Jarmusch, Nathan Graddon, Sunita Chandrasekaran |
| 机构 | University of Delaware(特拉华大学)计算机与信息科学系 |
| 论文 | arXiv:2507.10789 |
| 发布 | 2025-07-14(v1) |
| 领域 | GPU 微架构分析、微基准测试、HPC |
| 关键词 | Blackwell, GPU, Microbenchmark, HPC |
一句话概括
这是首个针对消费级 Blackwell GPU(GeForce RTX 5080,芯片 GB203)的深度微基准测试研究。作者用手写 PTX/CUDA 微基准,把 GB203 与上一代数据中心级 Hopper(H100 PCIe,芯片 GH100)逐子系统对比,揭示 Blackwell 在统一 INT32/FP32 核、第五代张量核心(新增 FP4/FP6)、内存层次、warp 调度上的代际改进与性能回退(如 FP64 被大幅精简、消费级软件栈不成熟导致 D-GEMM 反而慢 4×),并给出面向开发者/编译器/性能工程师的实用调优指南。
与姊妹论文 arXiv:2512.02189 的区别:同一研究组(Jarmusch & Chandrasekaran, U Delaware)的两篇 Blackwell 微基准工作。本文(2507.10789)对比 消费级 RTX 5080 (GB203) vs 数据中心 H100 PCIe (GH100);而 2512.02189 对比 数据中心 B200 vs H200,并额外覆盖 TMEM、tcgen05、解压缩引擎。本文更聚焦「消费卡 vs 上代数据中心卡」的取舍。
二、核心思想
问题定义
现代商用 GPU 的微架构细节缺乏公开文档,难以深入分析。Hopper(GH100)面向大规模 AI 训练与科学计算,Blackwell 消费芯片(GB203)面向实时图形与功耗受限的推理场景——两者布局相似但硬件配置与内存层次差异巨大。核心问题是:
如何量化 Blackwell 消费级 GPU 相对上代 Hopper 的微架构改进与回退,从而指导工作负载优化?
解决方案概述
作者用 PTX + CUDA 手写微基准(PTX kernel 单独成文件、编译期不优化,并核对生成的 SASS 确认无优化),系统测量延迟、吞吐、缓存行为、调度细节,覆盖:计算流水线 → 第五代张量核心 → 内存子系统 → 真实案例(D-GEMM、Transformer 推理)。
核心贡献
- 面向 Blackwell 的新微基准套件(并对比 Hopper)
- 深入分析内存层次与 SM 子单元(张量核心、统一 INT32/FP32 核、FP64 核)
- 为软件/应用开发者提供性能指南
- 探究新增低精度类型 FP4/FP6 在张量核心中的行为与性能影响
三、Blackwell 架构总览(GB203 vs GH100)
两颗芯片实现相似的 CUDA 核编程模型,但在指令集、执行单元数量、内存层次、资源调度上差异显著。
3.1 SM 与执行单元(Table I)
| 特性 | GH100(Hopper / H100 PCIe) | GB203(Blackwell / RTX 5080) |
|---|---|---|
| 架构 | Hopper | Blackwell |
| FP32 / SM | 128 | 统一 INT32/FP32 单元 |
| INT32 / SM | 64 | 统一 INT32/FP32 单元 |
| FP64 / SM | 64 | 仅 2 |
| 张量核心 | 第 4 代 | 第 5 代(支持 FP4/FP6) |
| Transformer Engine | 第 1 代 | 第 2 代 |
设计哲学:GH100 为大规模 AI 训练与科学计算优化(大内存、高 SM 吞吐、缓冲深);GB203 为功耗高效、消费导向(游戏、渲染、小批量推理),改进了 warp 调度、降低分支发散派发延迟。
3.2 缓存层次(Table II)
| 内存单元 | GH100 | GB203 |
|---|---|---|
| L0 i-cache | 独立分区 | 统一 |
| 寄存器文件 (KB/SM) | 256 | 256 |
| L1 Cache (KB/SM) | 256(统一) | 128(统一) |
| Shared Memory (KB/SM) | 228(统一) | (统一,见下文 ≈99KB 可配) |
| L2 Cache (MB) | 50(2 分区) | 65(1 单块) |
| Global Memory | 80 GB(HBM2e) | 16 GB(GDDR7) |
GB203 用更大的 L2(65MB)补偿更小的 L1(128KB);GH100 的 HBM 支持更大 batch 与工作集,利于大模型训练。
3.3 指令集与软件兼容性
- Hopper:
wgmma、FP8 经 PTX + CUDA 11.8;向后兼容传统mma与 CUDA C++。 - Blackwell:CUDA 12.8 + PTX 8.7 扩展第五代张量核心指令
tcgen05及 FP4/FP6 操作数类型。 - Hopper 的
wgmma不兼容 Blackwell;warp-group 计算改用tcgen05。 - ⚠️
tcgen05尚未在sm_120a架构上支持(本文测试的 GB203),故实测仍用mma。
四、计算流水线(Compute Pipeline)
每个 SM 含 4 个子核(sub-core)分区,分别处理整数、浮点、张量操作。指标定义:
- True latency(真实延迟):串行依赖指令链,反映数据就绪延迟,无并行/重叠。
- Completion latency(完成延迟):一组独立指令允许重叠并行。
- 均以「时钟周期/指令」计。
4.1 时钟开销(Clock Overhead)
用 %clock64 只读寄存器测量。GB203 上两次读数间无指令时差值为 1,GH100 为 2。
4.2 INT32 与 FP32 执行单元
Volta/Ampere 时代 INT32 与 FP32 走独立流水线,单一类型主导时利用率不佳。GB203 引入统一执行单元,动态调度 INT32/FP32 混合指令,减少空闲周期。但统一核在任一周期只能作 INT32 或 FP32,混合负载可能产生 hazard。
测试(PTX fma/mad,各跑 1024 次取平均):
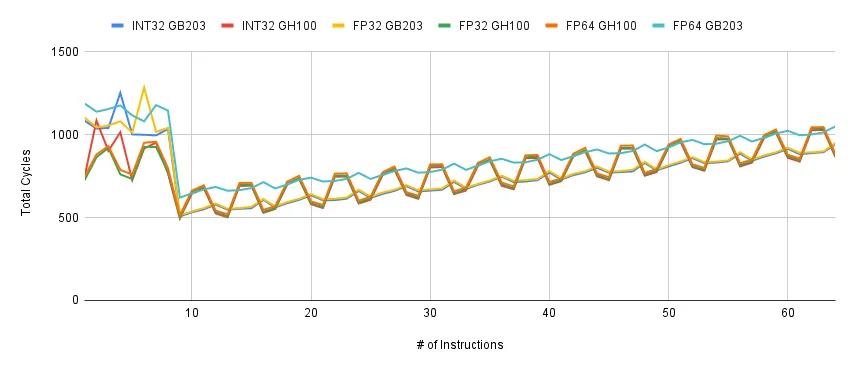
Table III — 延迟结果(true/completion,周期/指令):
| GPU | Pure INT32 | Pure FP32 | Mixed 1 | Mixed 2 | Pure FP64 |
|---|---|---|---|---|---|
| GB203 | 4 / 16.97 | 4 / 7.97 | 15.96 / 14 | 26.28 / 18 | 63.57 / 11 |
| GH100 | 4 / 16.69 | 4 / 7.86 | 31.62 / 16 | 43.54 / 20 | 8.04 / 13 |
关键发现:
- 纯 INT32/FP32 真实延迟两卡均为 4 周期;GH100 纯核完成延迟略优。
- 混合负载 GB203 明显优于 GH100(15.96 vs 31.62),证明统一核带来更高效的混合流水线。
- GB203 首跑因缓存未预热延迟偏高,已排除(Hopper 无此现象)。
- 结论:Blackwell 混合负载更强,Hopper 纯指令负载略好。
4.3 FP64 执行单元
FP64 对科学计算高精度至关重要。GH100 有 64 个 FP64 单元/SM,GB203 仅 2 个/SM。
- GH100 在 1024 条依赖 FP64 指令下延迟远低于 GB203。
- GB203 仅 2 条依赖指令时延迟降至 37.5 周期;增加指令数无法隐藏延迟(只有 2 个单元)。
- 推断:这 2 个单元仅为类型/指令支持,实际 FP64 计算应由 FP32 单元或张量核心模拟。
- 启示:跨数据中心/消费级 GPU 移植性能时,理解 FP64 瓶颈可指导精度权衡与算法设计。
4.4 Warp 调度行为
串行 pointer-chase 基准,依赖指令数 1→1024(重点看 1→64,>64 后约 400 迭代趋于平台):
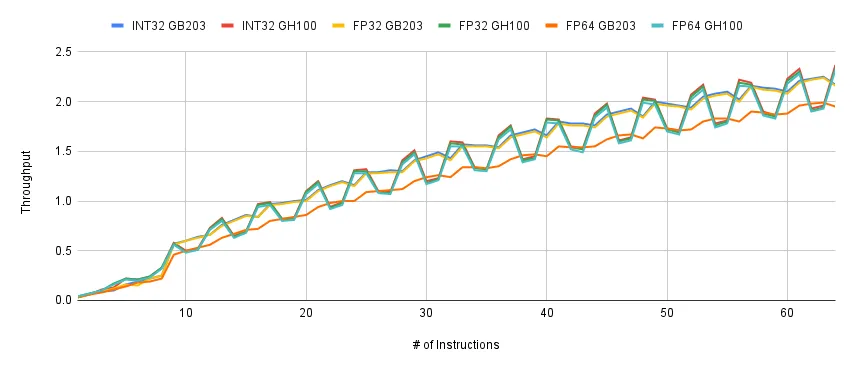
- 吞吐:1–9 条指令稳增;此后流水线分化。GB203 增长更平滑一致;GB203 FP64 吞吐低于 INT32/FP32。
- 总周期:GH100 在 <8 条指令时总周期更低(短依赖链隐藏延迟更好);8 条后两卡骤降。GH100 随指令增多更不稳定(sporadic)。
- 解读:GH100 缓冲更深、warp 调度更激进(高压下容忍依赖),但大指令数下不稳定;GB203 发射策略更保守稳健。
- 结论:GH100 擅长短延迟受限序列,GB203 为规则高 ILP 内核优化。
五、第五代张量核心(5th Gen Tensor Core)
5.1 指令集与支持的数据类型(Table IV)
| GB203(第 5 代) | GH100(第 4 代) | |
|---|---|---|
| 支持数据类型 | FP4, FP6, FP8, INT8, FP16, BF16, TF32, FP64 | FP8, INT8, FP16, BF16, TF32, FP64 |
| MMA 指令 | mma, wmma, tcgen05 | mma, wmma, wgmma |
注:
tcgen05在sm_120a(GB203)上尚未实现,故实测用mma。
5.2 可变 MMA 与 Tile 指令
mma 指令指定 tile 形状 M×N×K。例(Eq.1):
mma.sync.aligned.m16n8k32.f32.f16.f16.f32计算 16×8 输出(FP16 输入、FP32 累加/输出)。CUDA 12.9 起,FP6/FP4 须在 PTX 显式加 .kind::f8f6f4 后缀,否则(或在 GH100 上)报 PTX 错误。
Table V — FP4/FP6/FP8 格式与 PTX 指令:
| 格式 | 数据类型 | PTX 指令(mma.sync.aligned.kind::f8f6f4 后缀) |
|---|---|---|
| e2m1 | FP4 | .m16n8k32.row.col.f32.e2m1.e2m1.f32 |
| e3m2 | FP6 | .m16n8k32.row.col.f32.e3m2.e3m2.f32 |
| e2m3 | FP6 | .m16n8k32.row.col.f32.e2m3.e2m3.f32 |
| e4m3 | FP8 | .m16n8k32.row.col.f32.e4m3.e4m3.f32 |
| e5m2 | FP8 | .m16n8k32.row.col.f32.e5m2.e5m2.f32 |
SASS 映射发现:GH100 所有 mma.sync 均编译为 HMMA。Blackwell 中 FP8/FP6 输入用 QMMA;FP4 本应用 OMMA,但实测回退为 QMMA——仅当用 FP8 ue8m0 做 block scaling 时才观察到 OMMA。说明当前软件下 QMMA 是 FP4 的 fallback。
5.3 精度-功耗权衡(Table VI)
低精度减少内存占用、提升吞吐(尤利于推理)。测量功耗(瓦):
| 数据格式 | Blackwell (W) | Hopper (W) |
|---|---|---|
| FP4 e2m1 | 16.75 | n/a |
| FP6 e2m3 | 39.38 | n/a |
| FP6 e3m2 | 46.72 | n/a |
| FP8 e4m3 | 46.66 | 55.82 |
| FP8 e5m2 | 46.81 | 55.79 |
- GH100 不支持 FP4/FP6,FP8 功耗约 55W;GB203 相同格式最高 46W。
- 功耗随精度降低而下降:FP4 仅 16.75W 最低,FP6/FP8 分别 >39W/>46W。
- 体现 Blackwell 低精度下的架构能效优势,及数值表达力与能耗的权衡。
5.4 Warp 缩放与共享内存访问
变化 ILP 与 warp 数:
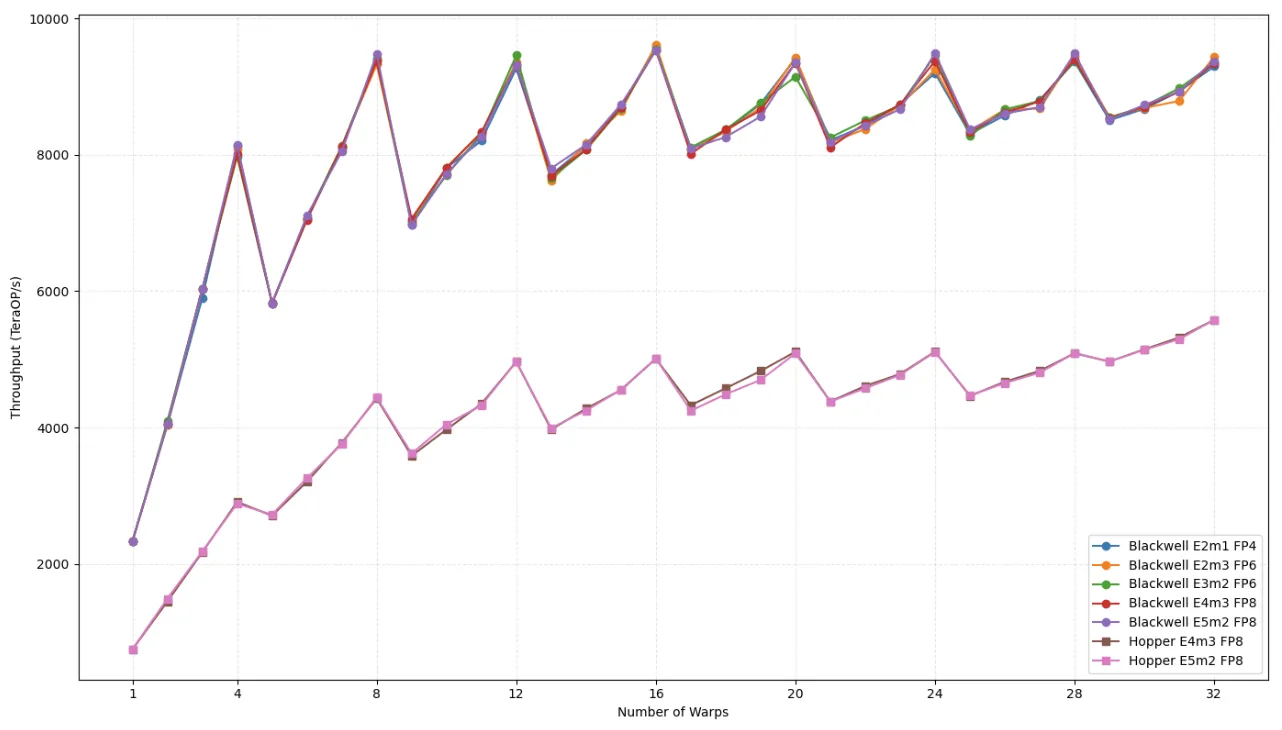
- 持续吞吐的最大 ILP:GH100 为 ILP=5 @ 29 warps,GB203 为 ILP=6 @ 25 warps → Blackwell 每线程可发射更多独立
mma。 - 完成延迟(ILP=1, warps=1):GB203 所有精度 1.21 周期,GH100 1.66 周期 → 各架构所有低精度
mma共用同一执行流水线。 - GB203 吞吐全面高于 GH100,ILP=6 @ 32 warps 时峰值 >11 TFLOP/s。
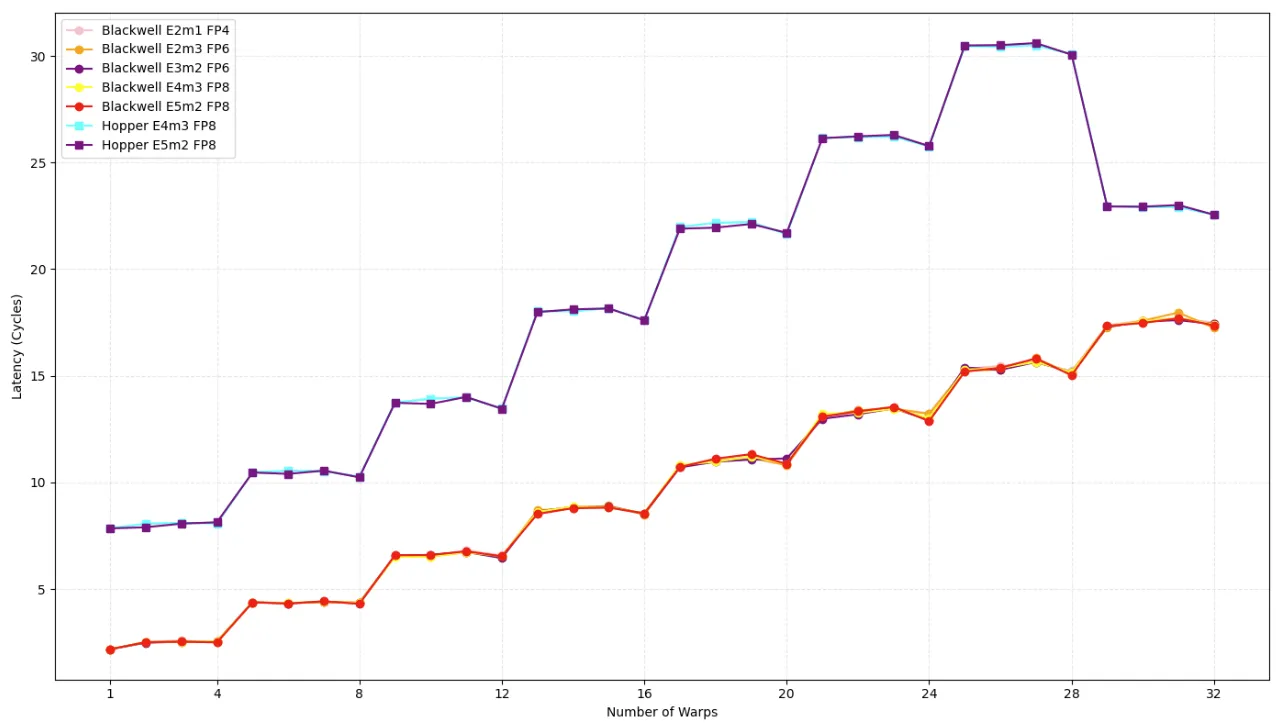
- GB203 延迟持续更低(尤其 FP4/FP6);GH100 随 warp 增加呈阶梯式上升(更深但不灵活的调度队列)。
- 结论:Blackwell warp 调度为低精度、高 ILP、干净控制流优化;Hopper 靠大并发与深缓冲维持在不规则条件下的性能。
六、内存子系统(Memory Subsystem)
用随机化串行 pointer-chase 隔离延迟特征。
6.1 内存层次总览
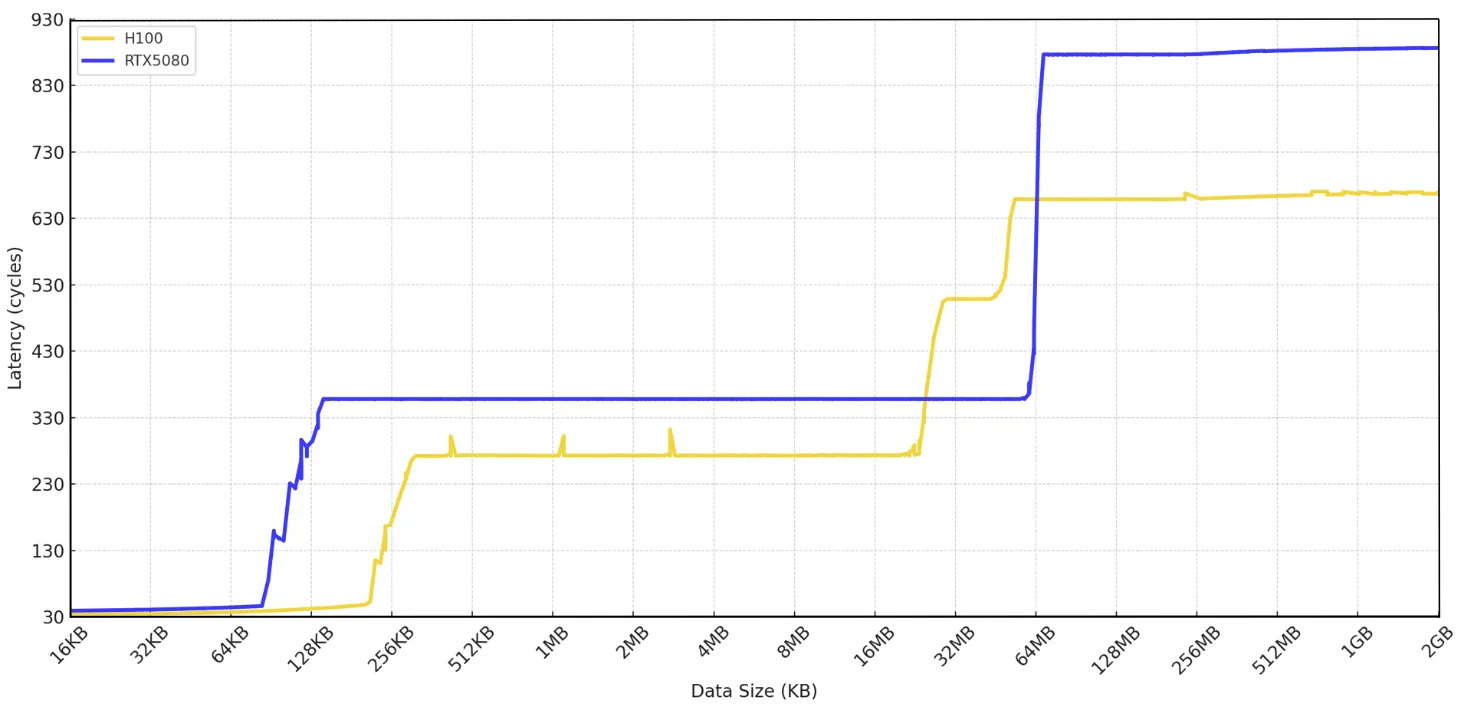
三个缓存区随数据量增大依次出现延迟跳变:
- L1:0 → ≈128KB(GB203)/ ≈256KB(GH100)
- L2:L1 末 → ≈30MB(GB203)/ ≈60MB(GH100)
- Global:L2 之外
延迟尖峰对应缓存边界,与 Table II 规格一致。
6.2 Shared Memory 与 L1 Cache
L1/Shared 统一在每 SM 空间内。
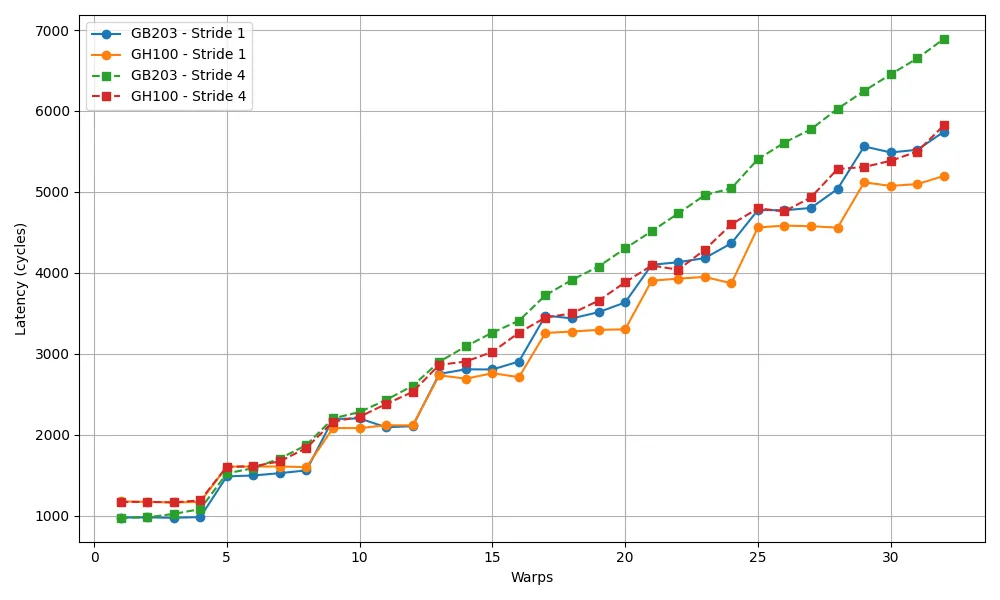
- L1 命中延迟两卡近乎相同,30–40 周期(访问路径均优化良好)。
- 容量:GH100 up to 256KB L1/shared per SM,GB203 减至 128KB。
- 可配 Shared Memory 上限(
cudaFuncAttributeMaxDynamicSharedMemorySize):GH100 ≈227KB/SM,GB203 ≈99KB/SM;无动态分配时两卡默认静态上限均为 48KB/SM。 - Shared memory 延迟(Fig.7):低 warp(1–4)GB203 更低;高 warp(6–32)GH100 反超(更大容量 + 更强 bank 冲突缓解)。stride 4 下 GH100 缩放更平滑,GB203 因 bank 争用陡增。
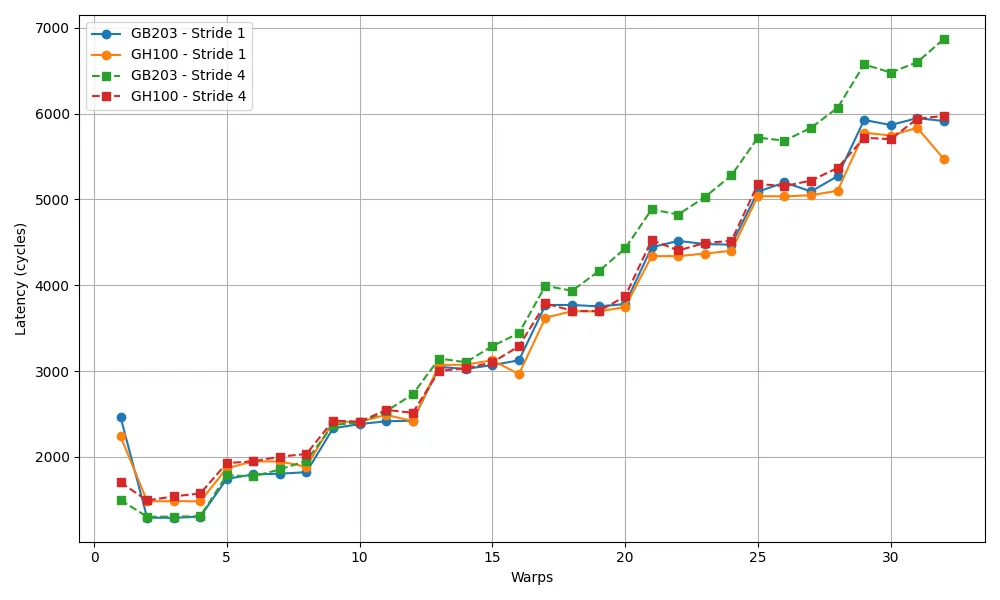
- L1(Fig.8):比 shared memory 更平坦、对冲突更耐受。GB203 在 stride 1、2–11 warps 时延迟略低;stride 4 下 GB203 陡增(更小分区易饱和)。两卡在 32 warps 时 shared/L1 延迟趋同。
- 总结:GH100 大统一内存 + 平滑 warp 缩放,利于密集复用的高线程内核;GB203 在小 warp 下低延迟访问与冲突解决更优(多端口 bank / warp 感知调度等微架构增强)。
6.3 L2 Cache
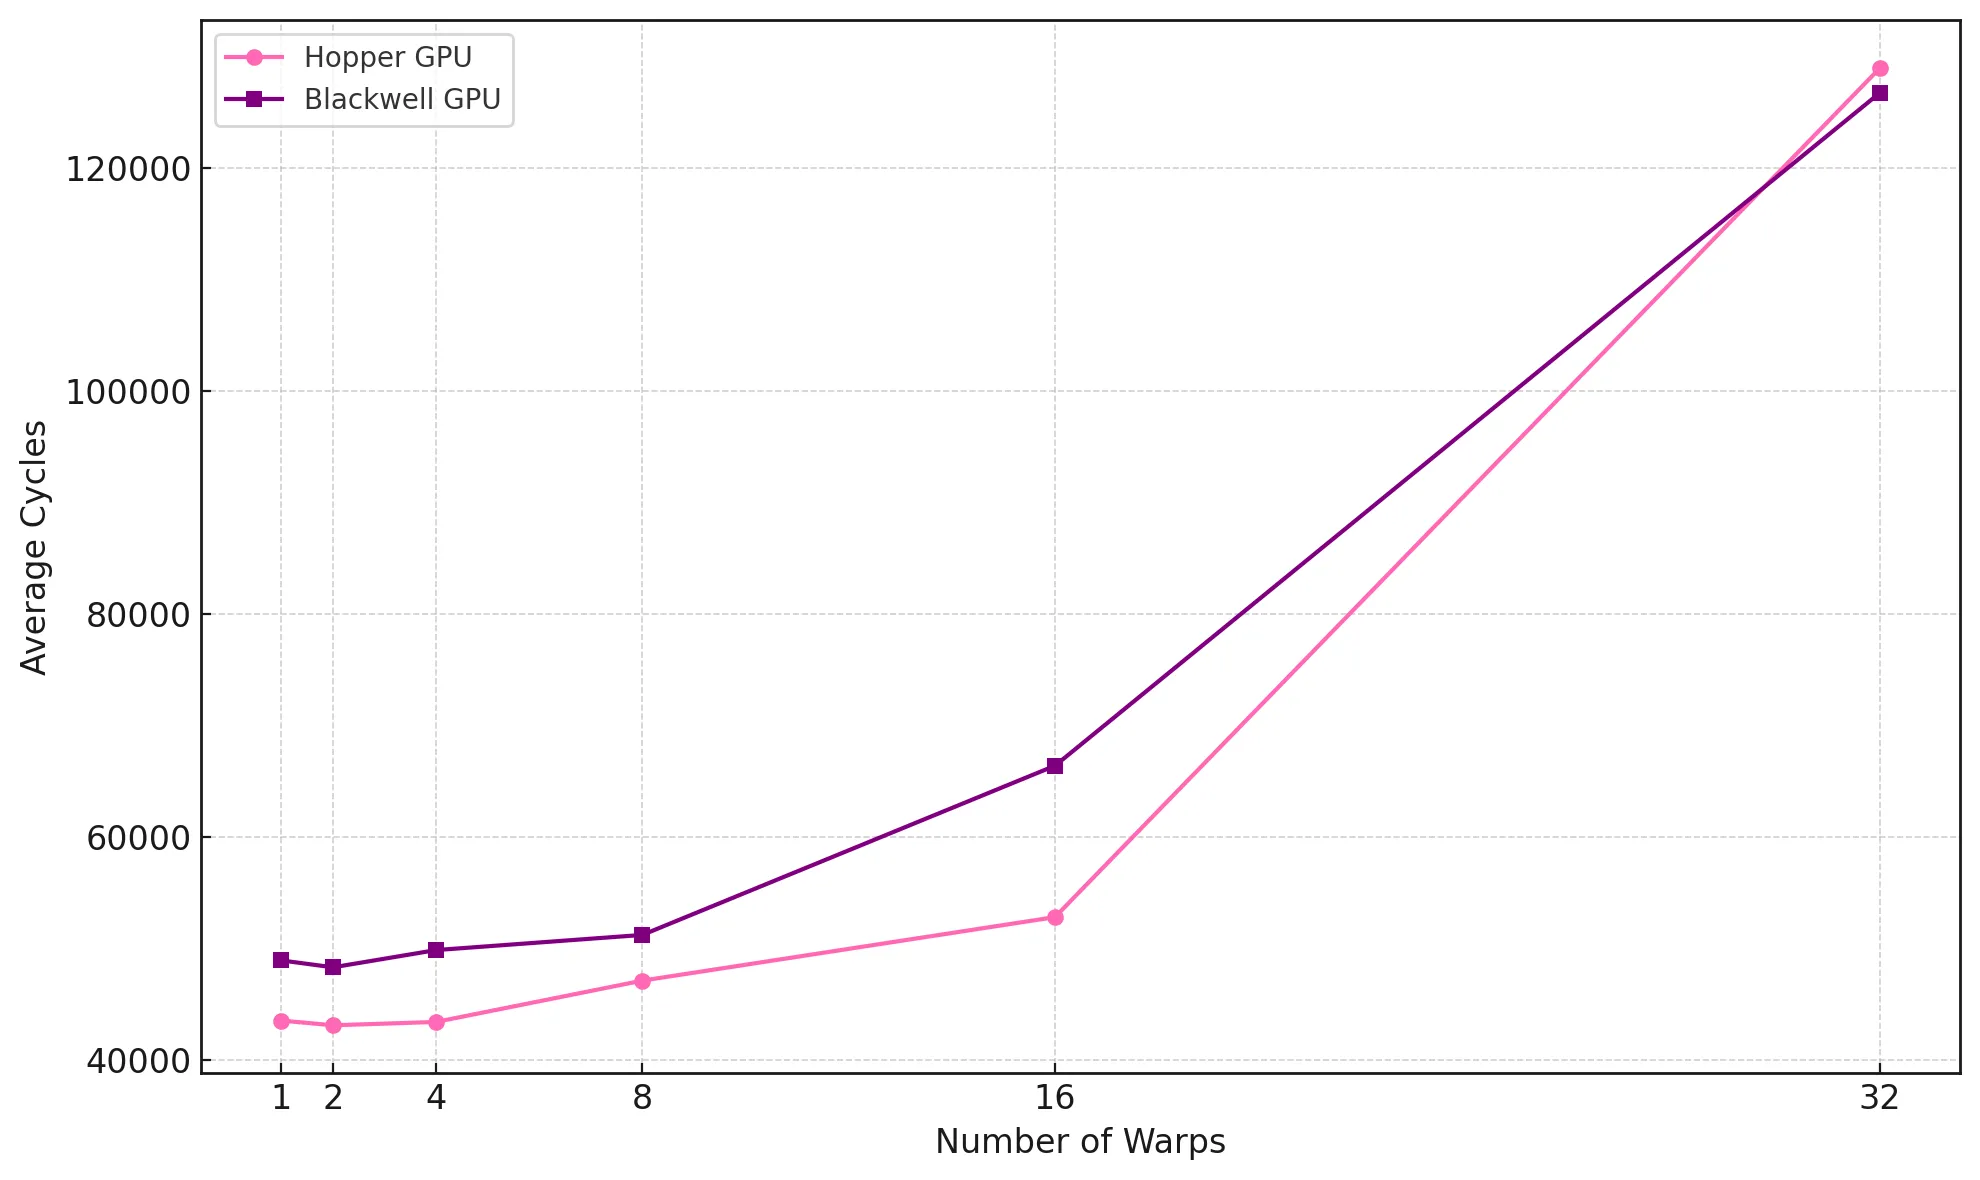
两种设计:GH100 分为两个独立分区(各服务部分 GPC,利于局部性与并行);GB203 为单块统一 L2(简化路由与一致性,利于小型/图形负载,但多 SM 同时流式访问时易争用)。
- 固定 L2 命中延迟:GB203 ≈358 周期,GH100 ≈273 周期(分区设计降争用)。GH100 两分区饱和时(31–45MB)升至 ≈508 周期;GB203 因更大总容量(65MB vs 50MB)在更大足迹内维持基线延迟。
- warp 缩放(Fig.9):低 warp(1–4)GH100 更优(≈43.5k vs GB203 49k 周期/warp);8–16 warp GH100 保持优势,GB203 开始饱和(16 warp ≈66k,单 L2 接口成瓶颈);16–32 warp GB203 追平并在 20 warp 略超;32 warp GB203 ≈128.4k vs GH100 ≈128.9k(GB203 更高聚合带宽)。
- 结论:GH100 分区 L2 适合高并发、计算密集的服务器负载;GB203 统一 L2 适合满负载的带宽受限应用(如深度学习推理、密集矩阵)。
6.4 Global Memory
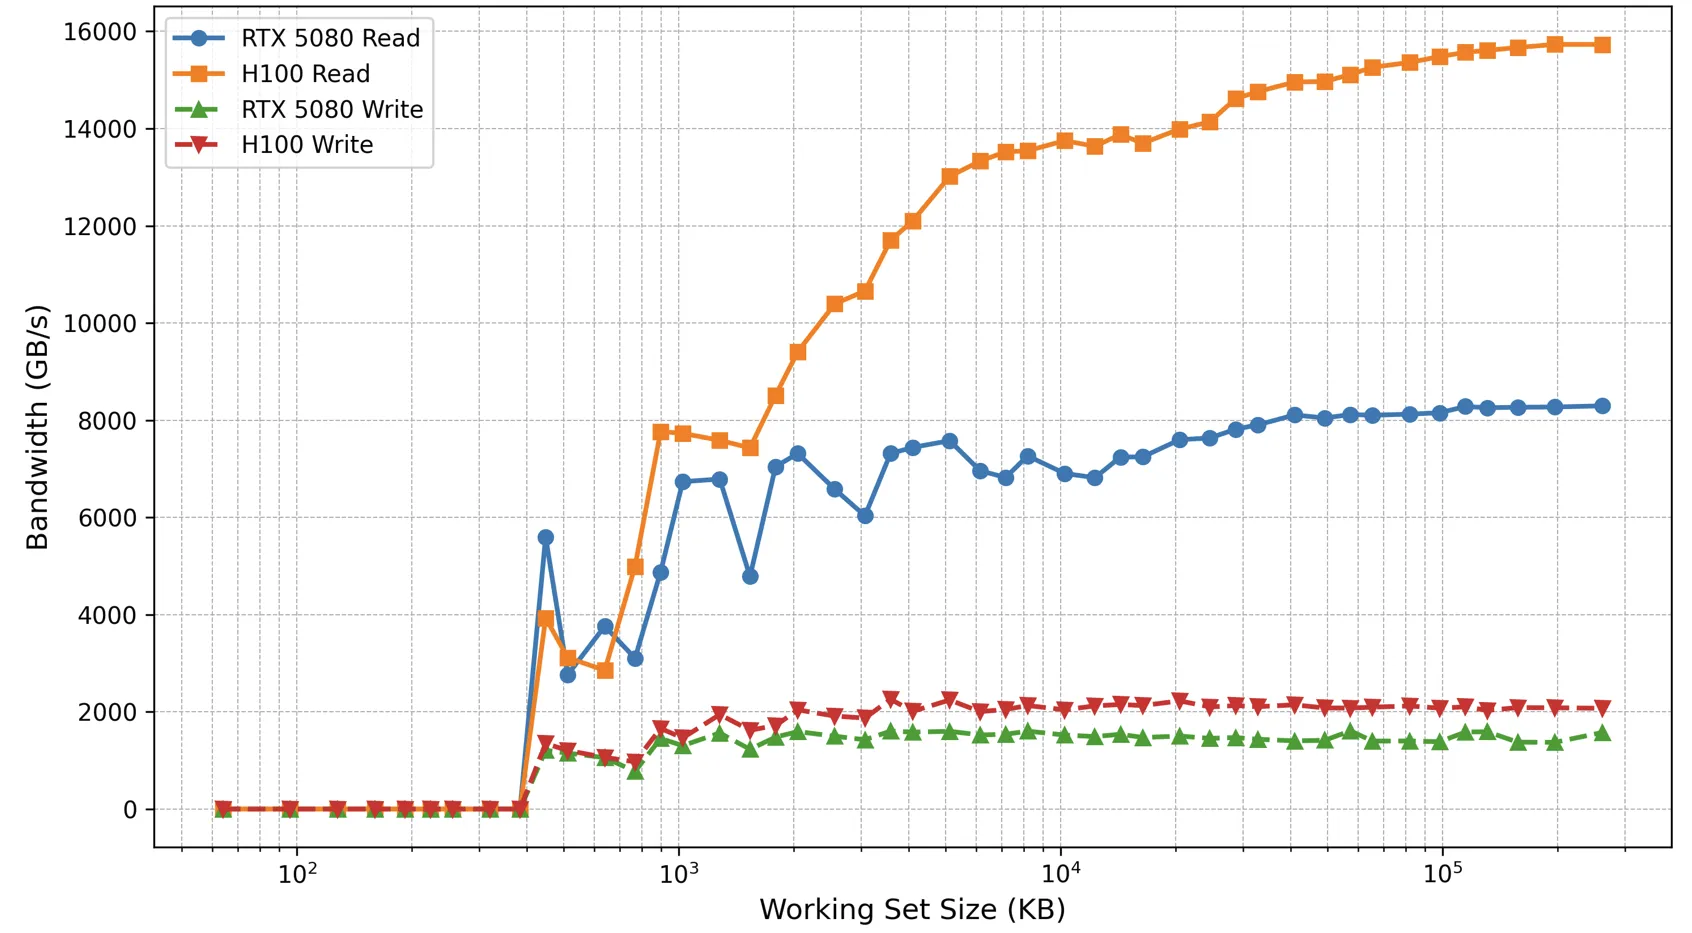
- 读带宽:GH100 峰值 15.8 TB/s,GB203 8.2 TB/s。
- 写带宽:GH100 2.2 TB/s vs GB203 1.6 TB/s(两卡均偏读,写回路径窄/写合并弱)。
- Global 访问起点/延迟:GB203 >71MB、≈876.7 周期;GH100 >55MB、≈658.7 周期(HBM2e 优于 GDDR7)。
七、微基准案例研究(Case Studies)
7.1 密集 GEMM(Dense GEMM,FP8)
用 cuBLASLt + __nv_fp8_e4m3,计算 (A/B 为 FP8,C 为 bfloat16,D 存 FP8),32MB workspace,各配置跑 100 次取平均,尺寸 1024/2048/4096/8192。
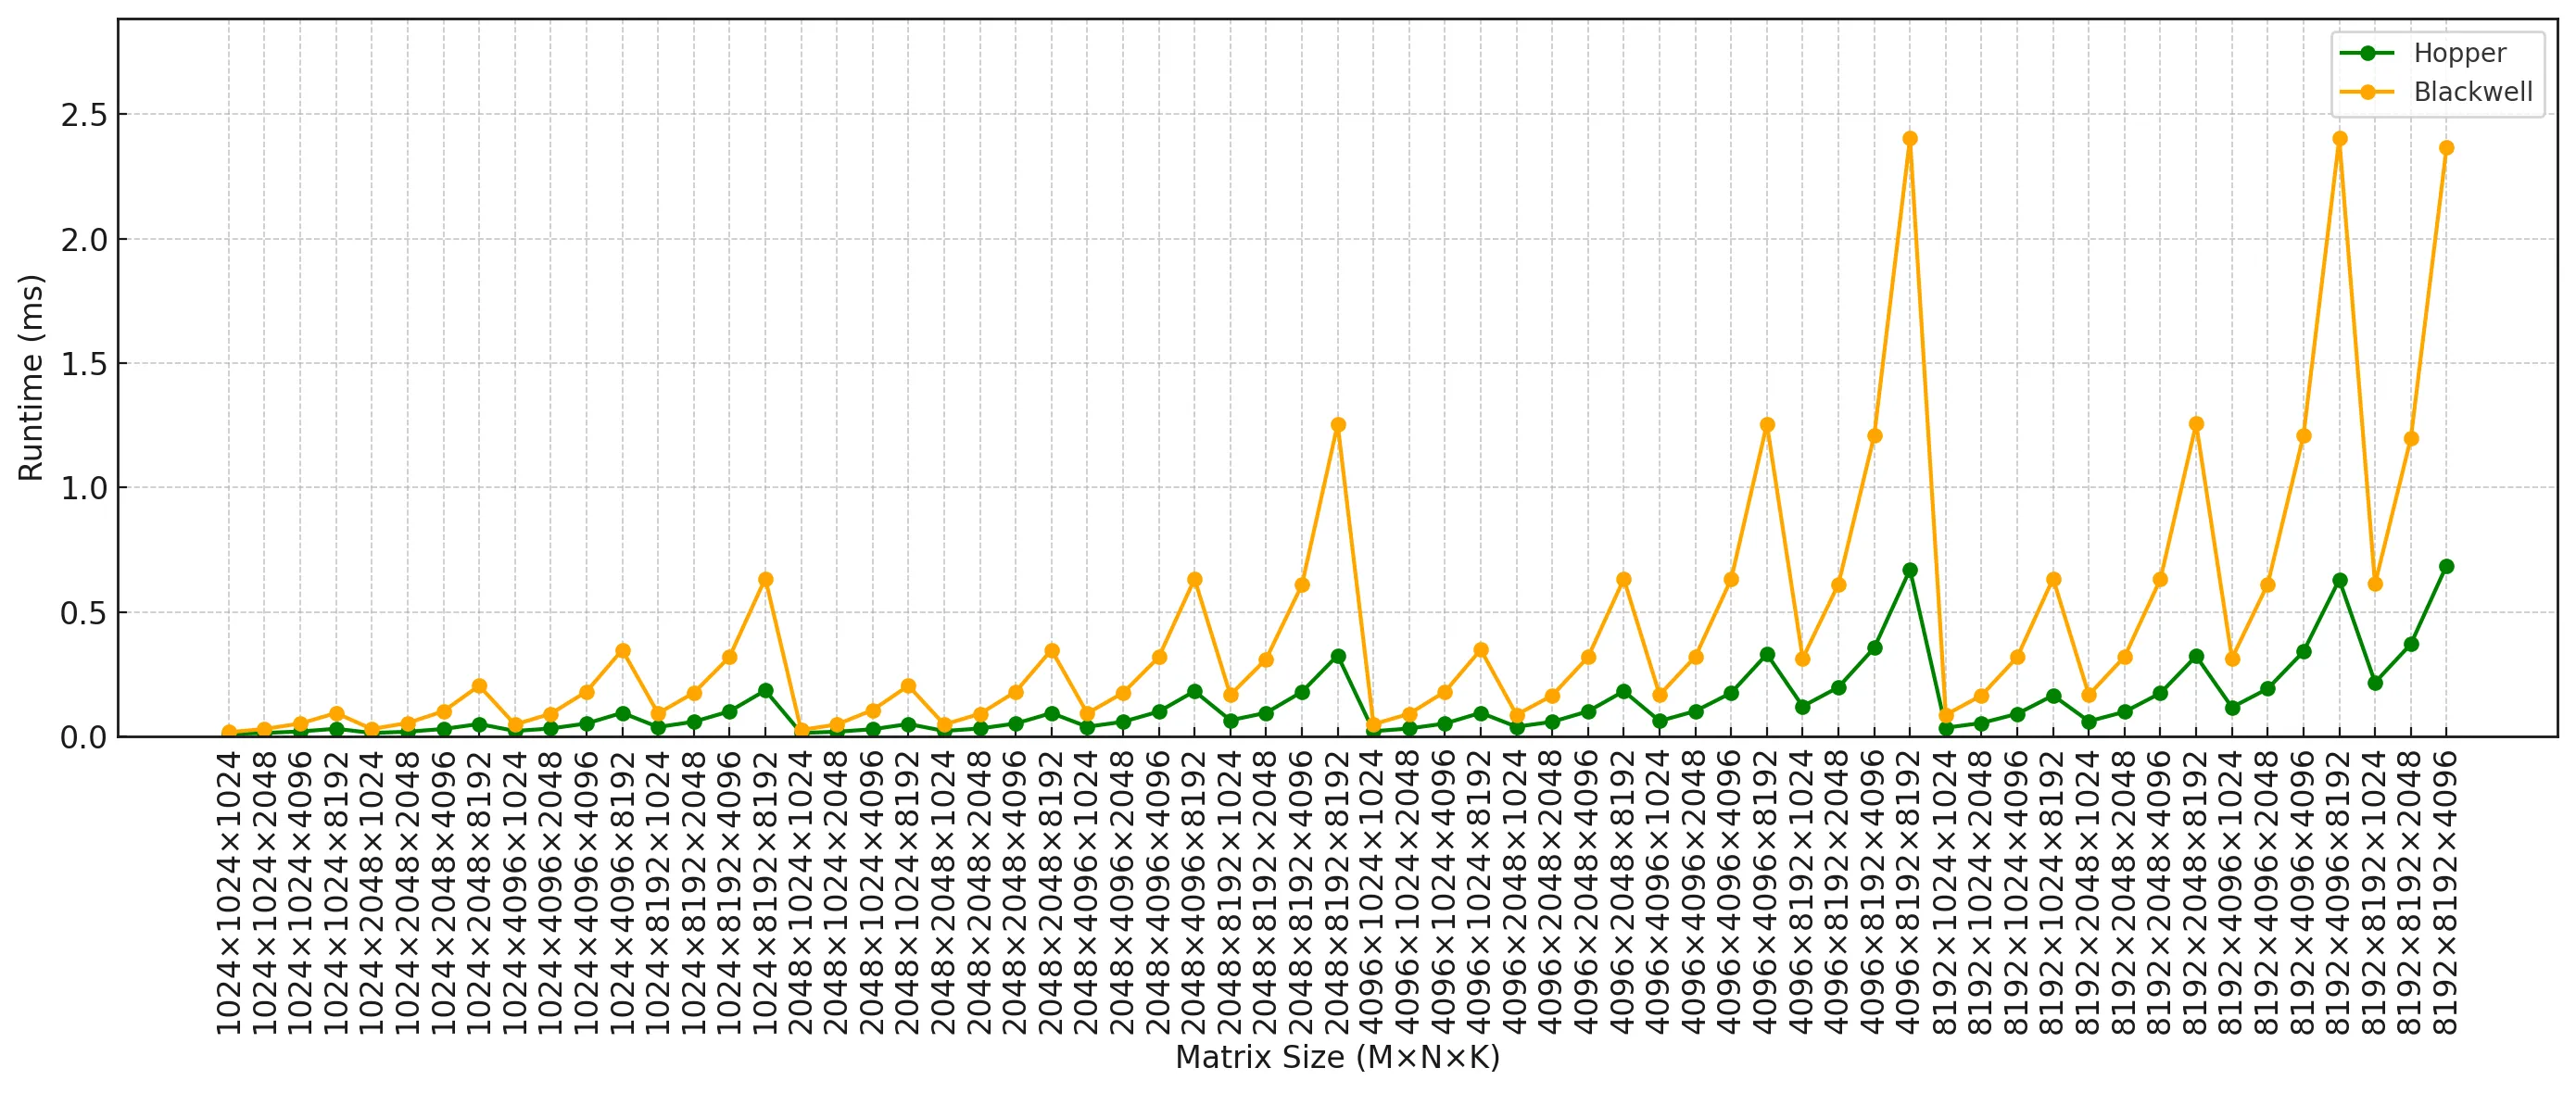
Table VII — D-GEMM 吞吐(TFLOP/s,):
| 矩阵尺寸 | Hopper (TFLOP/s) | Blackwell (TFLOP/s) |
|---|---|---|
| 8192³ | 0.887 | 0.233 |
| 2048³ | 0.554 | 0.191 |
| 2048×2048×4096 | 0.674 | 0.192 |
| 2048×4096×8192 | 0.759 | 0.217 |
| 1024³ | 0.239 | 0.134 |
- Hopper 全面领先,8192³ 时吞吐近 4× Blackwell。Blackwell 大尺寸下运行时出现尖峰(8192³ 达 4.71ms),暗示 FP8 GEMM 的内核选择/调度不稳定。
- Hopper 受益于更成熟的编译器启发式与大规模稳定调度。
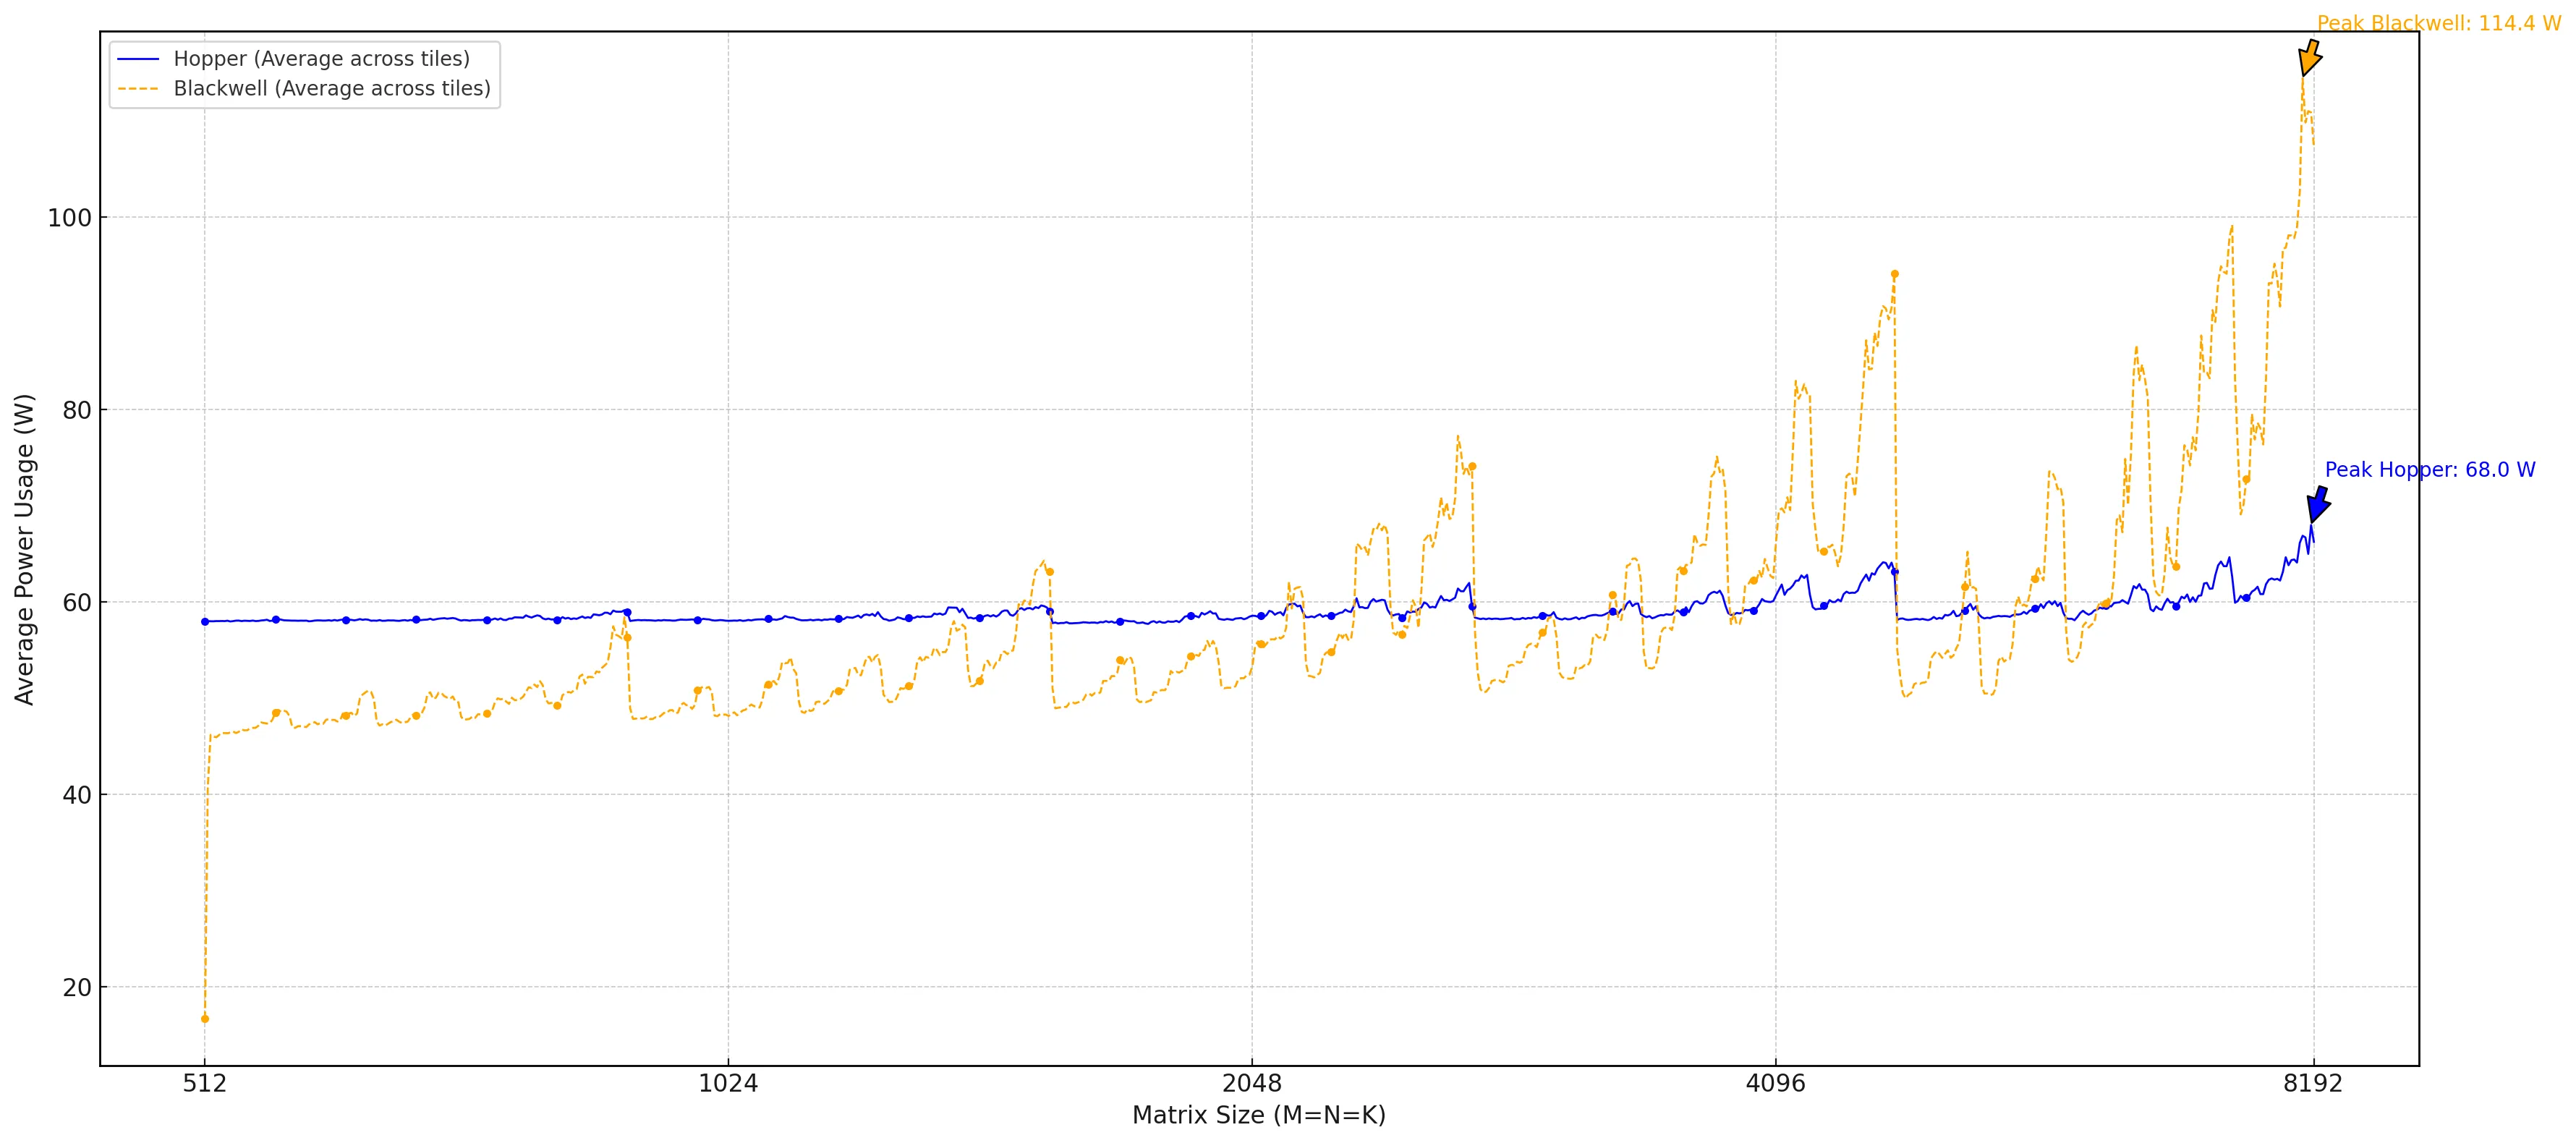
- 功耗(Fig.12):Hopper 平稳 58–60W(最大 8192³ 峰值 68W);Blackwell 变化大、曲线更陡,平均超 80W、峰值 114.4W。512³ 时 Blackwell 反而比 Hopper 省电。
- 高功耗 + 低吞吐 → GB203 多数配置下性能功耗比更差。
- 结论:当前软件与内核实现下,密集 GEMM 的真实能效仍是 Hopper 更优。
7.2 Transformer 推理
用 TensorRT + GPT-NeoX(小、兼容 FP8/FP4 量化路径),变精度(best、normal、fp16、fp8),各跑 100 次平均。
Table VIII — 推理平均功耗(W):
| 精度 | Hopper | Blackwell |
|---|---|---|
| FP32 | 60.24 | 58.82 |
| FP16 | 57.64 | 47.78 |
| FP8 | 57.69 | 45.14 |
| Best | 60.15 | 61.03 |
- Hopper 各精度稳定在 57–60W(运行时效率稳定)。
- Blackwell 随精度降低功耗明显下降(58.8W → FP8 45.14W),低精度缩放更好。
- 但 “Best” 配置下 Blackwell 功耗反而升高(61.03W)。
- 结论:Hopper 各格式功耗更稳;Blackwell 可针对推理调优获得更好的低精度能效。
八、核心创新与发现总结
| 维度 | 发现 | 依据 |
|---|---|---|
| 统一 INT32/FP32 核 | 混合负载延迟优于 Hopper(15.96 vs 31.62) | Table III |
| FP64 大幅精简 | GB203 仅 2 单元/SM,靠 FP32/TC 模拟;纯 FP64 真实延迟 63.57 vs Hopper 8.04 | Table III |
| 第五代张量核心 | 新增 FP4/FP6;FP4 应用 OMMA 实测回退 QMMA;ILP=6@25warps,完成延迟 1.21 vs 1.66 周期 | Table IV/V |
| 低精度能效 | FP4 仅 16.75W,FP8 46W(Hopper 55W) | Table VI |
| 内存层次取舍 | L1 128KB<256KB;L2 65MB 统一 vs 50MB 分区(358 vs 273 周期);读带宽 8.2<15.8 TB/s | Table II、Fig.6/9/10 |
| 性能回退 | D-GEMM 消费卡软件不成熟,吞吐反低 4×、功耗更高 | Table VII、Fig.11/12 |
九、性能指南(面向开发者)
- 混合 INT/FP 负载:偏好 GB203 的统一核,可减少空闲周期。
- FP64 科学计算:避免在消费级 Blackwell 上跑纯 FP64;改用 FP32/张量核心模拟或选数据中心卡。
- 低精度推理:Blackwell 在 FP4/FP6/FP8 下能效显著(FP4 16.75W),适合功耗受限推理。
- 高并发 / 大工作集训练:Hopper 的大 L1/HBM/分区 L2 更优。
- 高 ILP、干净控制流内核:适配 Blackwell warp 调度(少 warp、多独立指令)。
- 注意软件成熟度:消费级 Blackwell 的 FP8 GEMM 内核选择/调度尚不稳定,实际吞吐可能低于理论。
十、总结
核心贡献
- 首个消费级 Blackwell(GB203/RTX 5080)微基准解剖,并与 Hopper(GH100/H100 PCIe)逐子系统对比。
- 深入分析内存层次与 SM 子单元(统一 INT32/FP32、精简 FP64、第五代张量核心)。
- 量化 FP4/FP6 低精度的行为与功耗-性能权衡。
- 给出面向开发者/编译器/性能工程师的可操作指南。
技术影响
- 揭示消费级 Blackwell 是能效导向、低精度推理优化的设计,代价是 FP64、L1、HBM 带宽的削减。
- 记录了代际改进与回退并存:统一核与低精度能效是进步,但 FP64 精简、软件栈不成熟导致部分负载回退。
- 为在 Blackwell 平台优化 AI/HPC 负载提供微架构级依据。
局限性
tcgen05在 GB203(sm_120a)尚未支持,未能测试完整第五代 warp-group 路径。- 消费级软件栈不成熟,D-GEMM 等结果可能随驱动/编译器更新改善。
- 仅测设备级内存访问,不含 host-device 传输(PCIe/NVLink)。
- 代码因盲审政策暂未开源(计划审后开放)。
十一、参考资源
- 论文:arXiv:2507.10789
- PDF:arXiv PDF
- HTML:arXiv HTML
- 姊妹论文:Microbenchmarking NVIDIA’s Blackwell Architecture (B200 vs H200)
- 综述:Blackwell GPU 架构综述(整合两篇微基准论文的统一架构画像)
- 相关:Dissecting Volta (1804.06826)、Dissecting Turing T4 (1903.07486)、Dissecting Hopper (2501.12084)
- 引用:Jarmusch, A., Graddon, N., & Chandrasekaran, S. (2025). Dissecting the NVIDIA Blackwell Architecture with Microbenchmarks. arXiv:2507.10789.
附录:论文图表索引
| 图 | 文件 | 说明 |
|---|---|---|
| Figure 2 | cycles-vs-iterations.png | 总周期 vs 迭代(INT32/FP32/FP64) |
| Figure 3 | throughput-vs-iterations.png | 吞吐 vs 迭代 |
| Figure 4 | tensor-core-throughput.png | 张量核心吞吐(各精度/warp) |
| Figure 5 | tensor-core-latency.png | 张量核心延迟(各精度/warp) |
| Figure 6 | memory-hierarchy-latency.png | 内存层次延迟 |
| Figure 7 | shared-memory-latency.png | Shared Memory 延迟 |
| Figure 8 | l1-cache-latency.png | L1 Cache 延迟 |
| Figure 9 | l2-warp-scaling.png | L2 Cache warp 缩放 |
| Figure 10 | memory-throughput.png | 内存层次吞吐(读/写带宽) |
| Figure 11 | gemm-runtime.png | D-GEMM 运行时间 |
| Figure 12 | gemm-power.png | D-GEMM 功耗 |


