Demystifying NCCL: An In-depth Analysis of GPU Communication Protocols and Algorithms
A systematic analysis of NVIDIA NCCL's internal architecture covering API, protocols, transports, and collective algorithms
Demystifying NCCL: An In-depth Analysis of GPU Communication Protocols and Algorithms
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Demystifying NCCL: An In-depth Analysis of GPU Communication Protocols and Algorithms |
| 作者 | Zhiyi Hu, Siyuan Shen, Tommaso Bonato (ETH Zurich), Sylvain Jeaugey, James Dinan, Eric Hammond (NVIDIA), Cedell Alexander, Eric Spada (Broadcom) |
| 机构 | ETH Zurich, NVIDIA Corporation, Broadcom Inc. |
| 论文 | https://arxiv.org/abs/2507.04786 |
| 代码 | https://github.com/NVIDIA/nccl |
| 发布 | 2025-07-23 (v2, 原提交 2025-07-07) |
| 许可 | Creative Commons BY-SA 4.0 |
二、核心思想
问题定义
NCCL (NVIDIA Collective Communications Library) 是大模型分布式训练的核心通信库,几乎所有多 GPU/多节点训练都依赖它。然而,NCCL 的内部架构长期处于”黑盒”状态——系统研究者、网络架构师和性能工程师难以深入理解其协议选择、传输机制和算法实现,导致无法针对性优化。
解决方案概述
本文对 NCCL v2.19.1 进行了首次全面的系统性内部分析,覆盖四个层面:
- API 结构与通信通道管理
- 三种通信协议(Simple、LL、LL128)的权衡分析
- 数据传输模型(节点内/节点间)
- 集合通信算法的迭代执行模型
分析洞察已被集成到 ATLAHS——一个应用追踪驱动的网络模拟器,用于在大规模 AI 训练中复现 NCCL 通信模式。ATLAHS 的模拟误差低于 5%,优于 AstraSim 在大尺度多 GPU 训练中的运行时预测能力。
三、技术架构
整体框架图
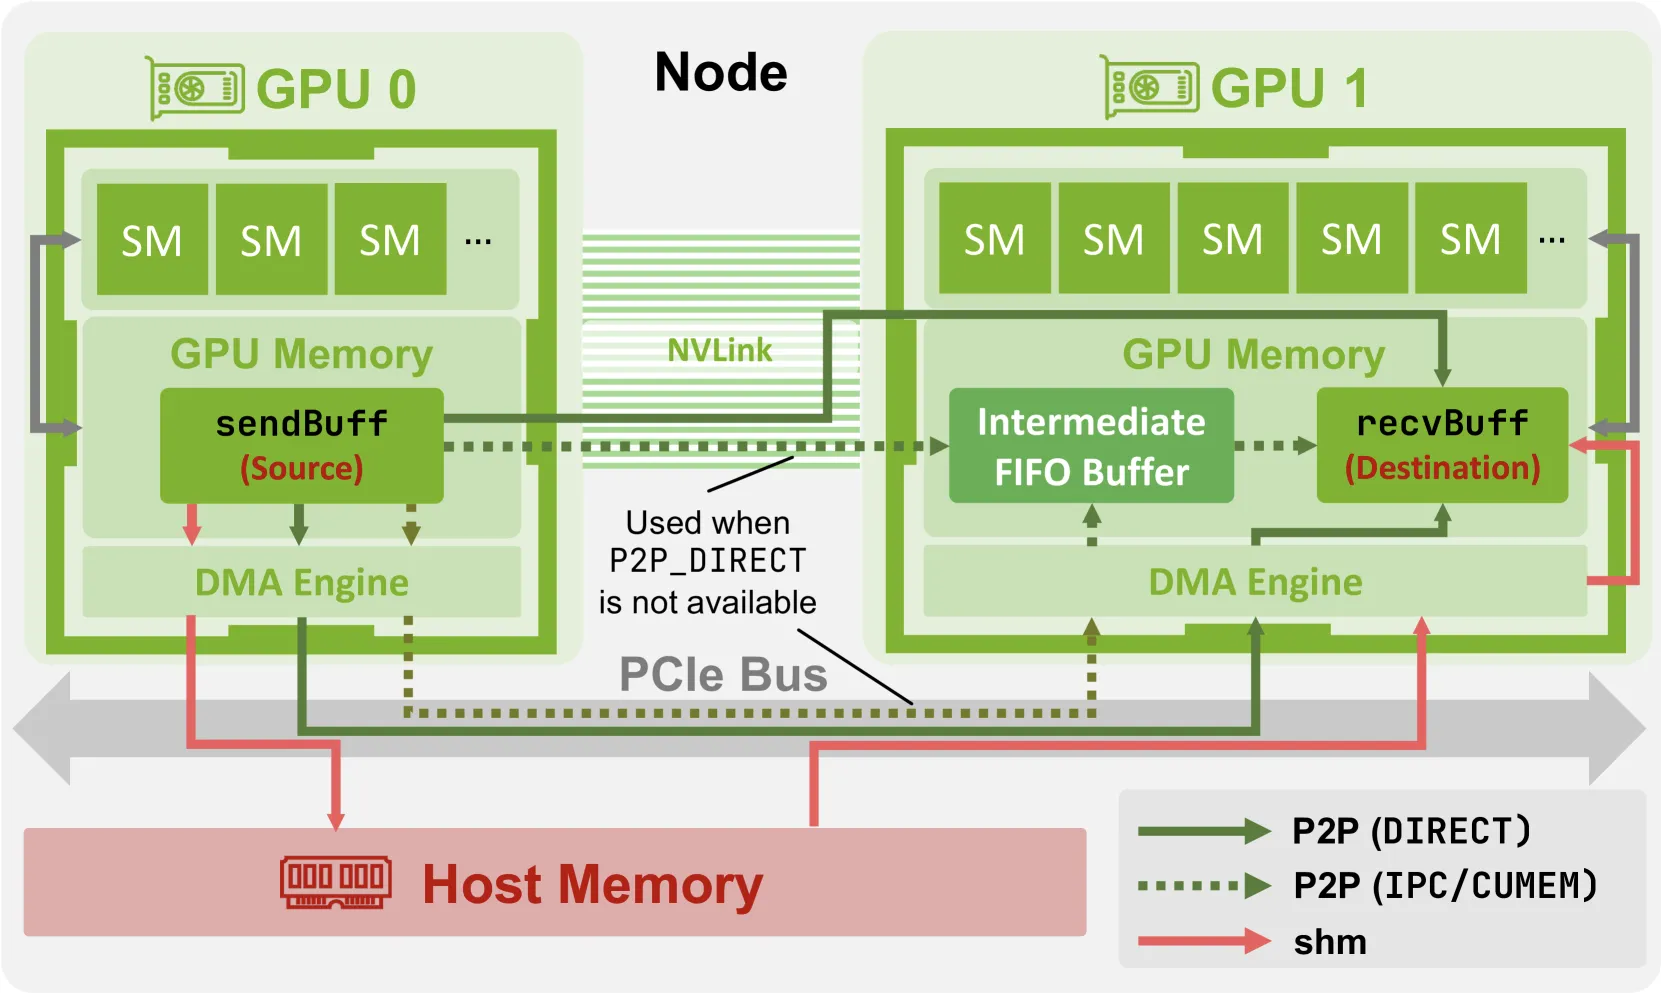
NCCL 的整体架构分为四层:
┌──────────────────────────────────────────────────────┐
│  API Layer                                            │
│  ncclAllReduce / ncclBroadcast / ncclReduceScatter... │
├──────────────────────────────────────────────────────┤
│  Collective Algorithms                                │
│  Ring | Tree | CollNet Direct/Chain | NVLS | NVLS Tree│
├──────────────────────────────────────────────────────┤
│  Communication Protocols                              │
│  Simple (高带宽) | LL (低延迟) | LL128 (低延迟+高带宽) │
├──────────────────────────────────────────────────────┤
│  Data-Transfer Transports                             │
│  Intra-Node: P2P | SHM | NVLS                         │
│  Inter-Node: IB Verbs (GDRDMA) | Socket | CollNet     │
├──────────────────────────────────────────────────────┤
│  Physical Interconnect                                │
│  NVLink | PCIe | InfiniBand | RoCE | TCP/IP          │
└──────────────────────────────────────────────────────┘
核心协议对比
表 I: NCCL 三种通信协议对比
| 方面 | Simple | LL (Low Latency) | LL128 |
|---|---|---|---|
| 设计目标 | 高带宽 | 低延迟 | 低延迟 + 高带宽 |
| 同步机制 | 内存屏障 (memory fences) | 标志位同步 (flag-based) | 标志位同步 (flag-based) |
| 载荷大小 | 数据块 (chunk-based) | 4B 数据 + 4B 标志 | 120B 数据 + 8B 标志 |
| 带宽利用率 | 接近峰值 | 峰值的 25~50% | 峰值的 ~95% |
| 每跳延迟 | ~6 μs | ~1 μs | ~2 μs |
关键权衡:
- Simple: 用大内存块传输,靠 memory fence 保证一致性。适合大消息,但小消息时同步开销主导
- LL: 用 8B 原子操作发送 4B 数据 + 4B 标志。延迟极低 (~1μs),但强制中间缓冲区在主机内存中,阻止了 GPUDirect RDMA,带宽利用率仅 25-50%
- LL128: 用 128B 单位传输(120B 数据 + 8B 标志)。带宽利用率 ~95%,延迟 ~2μs。但需要硬件支持 128B 原子写入,在 PCIe 限制下可能被禁用
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 通信通道 (Channels) | NCCL 将集合操作分解为多个通道,每个通道是独立的 CUDA block | 通道数启发式减少用于小消息;512 KiB FIFO 缓冲 |
| 协议选择 | 运行时动态选择 Simple/LL/LL128 | NCCL_PROTO 环境变量可强制指定 |
| 节点内传输 | P2P (NVLink/PCIe) → SHM → NVLS | P2P_DIRECT 模式在同进程时绕过 IPC handle |
| 节点间传输 | IB Verbs (GDRDMA) → Socket | 每 peer 2 个逻辑通道 (NCHANNELS_PER_NET_PEER) |
| 算法选择 | Ring/Tree/CollNet/NVLS | 基于消息大小、拓扑、硬件能力自动选择 |
传输层详解
节点内 (Intra-Node) 传输路径:
| 传输方式 | 文件 | 适用场景 |
|---|---|---|
| P2P | p2p.cc | NVLink 优先,PCIe 回退 |
| SHM | shm.cc | P2P 不可用或跨 socket 时 |
| NVLS | nvls.cc | 支持 NVLink Scale 的 GPU (如 H100) |
节点间 (Inter-Node) 传输路径:
| 传输方式 | 文件 | 适用场景 |
|---|---|---|
| IB Verbs | net_ib.cc | InfiniBand / RoCE |
| Socket | net_socket.cc | TCP/IP 网络 |
| CollNet | coll_net.cc | IB 集体网络优化 |
关键优化技术:
- GPUDirect P2P: GPU 直接访问对方显存,不经 CPU
- P2P_DIRECT: 同进程 GPU 间直接用指针,消除中间 FIFO 拷贝
- GPUDirect RDMA (GDRDMA): NIC 直接访问 GPU 显存,需 NIC 和 GPU 共享同一 PCIe switch
迭代执行模型
NCCL 将数据划分为 channels,每个 channel 有独立的 workOffset 和 channelCount。数据被分成 buffer 大小的段进行外循环迭代。
通道缓冲区大小(表 IV):
| 协议 | 总缓冲区 | 槽容量 (Slot) | 每槽有效数据 |
|---|---|---|---|
| Simple | 4 MiB | 512 KiB | 512 KiB |
| LL | 256 KiB | 32 KiB | 16 KiB |
| LL128 | ~4800 KiB | 600 KiB | 562.5 KiB |
CUDA 层级映射:
Grid: (nChannels, 1, 1)          ← 每个通道一个 CUDA block
Block: NCCL_MIN_NTHREADS ~ NCCL_MAX_NTHREADS  ← 自动调优
  Warp 0: 加载 ncclDevComm
  Warp 1: 加载 ncclDevChannel
  Warp 2+: 执行通信
  nccl_steps: 环形槽式流水线 (默认 8 步)
数据分区策略
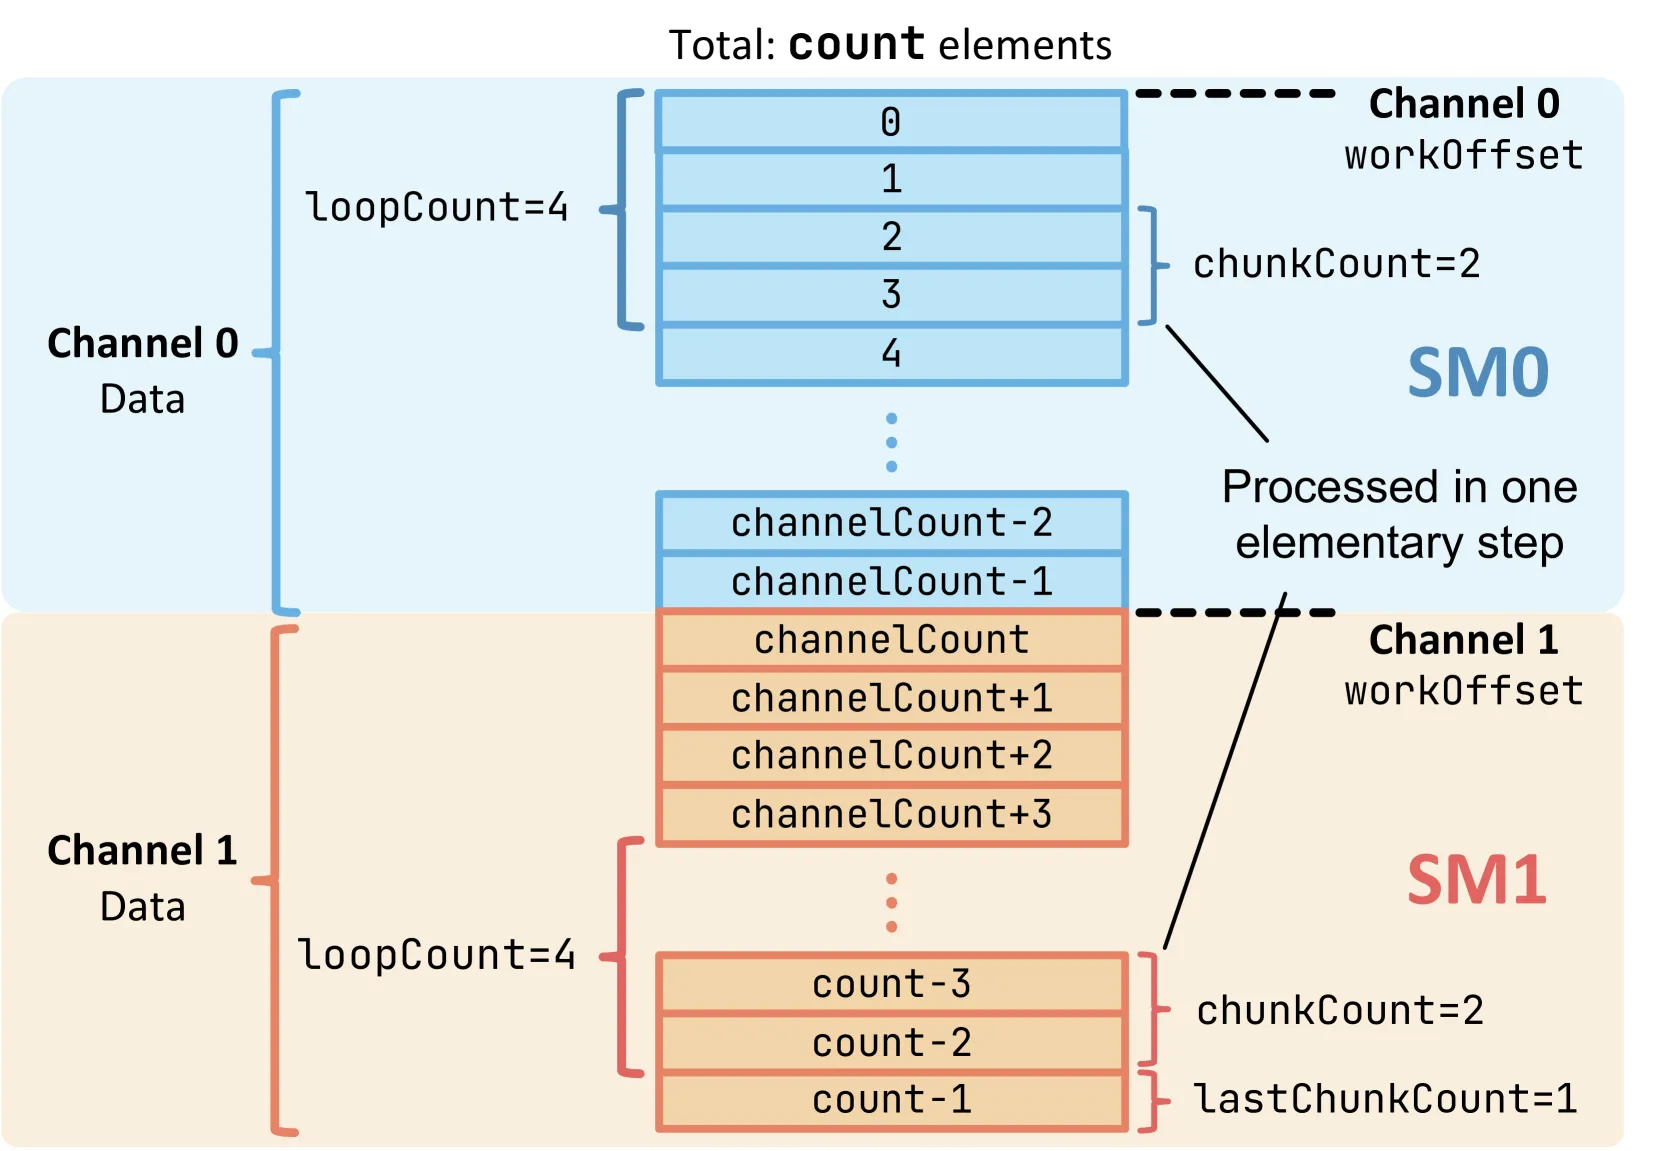
NCCL 的数据分区是多层次的:数据首先按通道划分,每个通道内再按槽位划分,形成多层并行(channels × slots × warps)。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首个 NCCL 全面内部分析 | 覆盖 API、协议、传输、算法四个层面 | 基于 NCCL v2.19.1 源码的系统性逆向分析 |
| 三协议权衡框架 | 详细分析 Simple/LL/LL128 的带宽-延迟权衡 | 实验数据:LL128 在 NVLink 上仅比 Simple 慢 5% |
| 传输分类学 | 完整的节点内/节点间传输机制映射 | 涵盖 P2P、SHM、NVLS、Socket、IB、GDRDMA |
| 迭代执行模型分解 | 10 张表格覆盖所有集合操作的逐步分解 | Ring/Tree × AllReduce/AllGather/ReduceScatter/Broadcast/Reduce |
| CUDA 层级映射 | 从 Grid/Block 到 Warp/Slot/Thread 的完整映射 | 揭示 NCCL 的多级并行机制 |
| 实证基准测试 | 在 CSCS Alps (16 GH200 节点) 上实测 | 150 GB/s 节点内,25 GB/s 节点间 |
| ATLAHS 集成 | 模拟误差 <5%,优于 AstraSim | 应用于大规模 AI 训练网络仿真 |
五、代码实现分析
NCCL 源码组织(基于 GitHub https://github.com/NVIDIA/nccl):
关键目录结构:
src/
├── transport/
│   ├── p2p.cc          ← 节点内 P2P 传输
│   ├── shm.cc          ← 共享内存传输
│   ├── nvls.cc         ← NVLink Scale 传输
│   ├── net_ib.cc       ← InfiniBand 传输
│   └── net_socket.cc   ← Socket 传输
├── device/             ← 设备端算法实现
├── core/               ← 核心基础设施
└── include/ ← API 头文件核心优化技术:
- Forward QP: 处理 bulk 数据 (RDMA_WRITE + RDMA_WRITE_WITH_IMM)
- Reverse QP: 仅处理 tiny CTS 控制消息,避免队头阻塞
- Local Flush: 通过自连接 flush QP 的 RDMA_READ 确保 PCIe 写入完成
- Round-robin 负载均衡: 多通道间轮询分发流量
六、实验结果
协议运行时比较
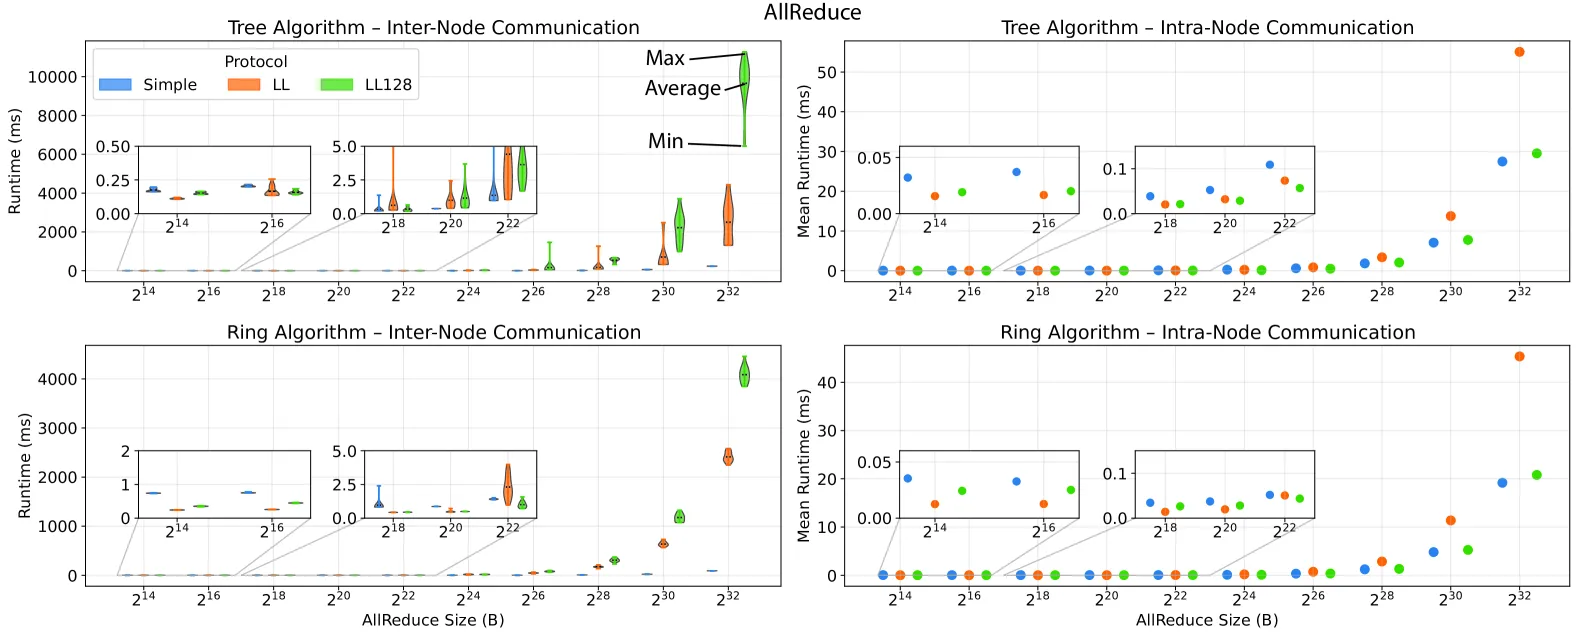
节点间 (Inter-node) 发现:
- LL 和 LL128 在 <64 KiB 小消息时最优
- Simple 在 GB 级别占主导(同步事件更少)
- LL128 在大消息时可能落后于 LL(每操作成本放大)
节点内 (Intra-node) 发现:
- LL128 在 NVLink 上全尺寸范围表现优异(大消息仅比 Simple 慢 5%)
- Ring 拓扑在大消息时占优
- Tree 拓扑在小消息时占优
算法-协议支持矩阵
| 算法 | Simple | LL | LL128 | 支持的操作 |
|---|---|---|---|---|
| Ring | ✓ | ✓ | ✓ | AllReduce, Broadcast, Reduce, ReduceScatter, AllGather |
| Tree | ✓ | ✓ | ✓ | AllReduce, Broadcast, Reduce, ReduceScatter, AllGather |
| CollNet Direct | ✓ | ✗ | ✗ | AllReduce |
| CollNet Chain | ✓ | ✗ | ✗ | Reduce, AllGather, Broadcast |
| NVLS | ✓ | ✗ | ✗ | AllReduce |
| NVLS Tree | ✓ | ✗ | ✗ | AllReduce, ReduceScatter, AllGather |
各集合操作的迭代步骤分解
Ring AllReduce (2k-1 steps per loop):
- Phase 1 (ReduceScatter): Step 0=send, Steps 1
k-2=recvReduceSend, Step k-1=recvReduceCopySend, Steps k2k-3=recvCopySend, Step 2k-2=recv
Ring AllGather (k-1 steps):
- Step 0=send(in-place)/copySend, Steps 1~k-2=recvCopySend, Step k-1=recv
Ring ReduceScatter (k-1 steps):
- Step 0=send, Steps 1~k-2=recvReduceSend, Step k-1=recvReduceCopy
ATLAHS 仿真精度
基于 CSCS Alps 超算(16 个 Grace Hopper 节点,GH200)的实证评估:
- 节点内带宽: 150 GB/s
- 节点间带宽: 25 GB/s/方向
- ATLAHS 模拟误差: < 5%
- 优于 AstraSim 在大尺度多 GPU 训练中的运行时预测
七、相关工作
- Lee & Lee (2024): 实证比较显示 NCCL 在节点内有优势,但在虚拟化/容器化下性能下降
- Weingram et al.: 集合库调查(NCCL, RCCL, oneCCL, Gloo)—— NCCL 是 GPU 领域的黄金标准
- Blink (Wang et al. 2019): 动态多树构造,在异构集群中优于 NCCL
- SCCL (Cai et al. 2020): 针对特定硬件自动综合/调优集合算法
- AstraSim 2.0 (Won et al.): 系统级网络仿真器
八、总结
核心贡献
- NCCL 首个全面内部分析:系统性覆盖 API、协议、传输、算法四个层面,为系统研究者、网络架构师和性能工程师提供参考
- 三协议权衡分析:揭示 Simple/LL/LL128 的设计动机、同步机制差异和运行时表现
- 传输分类学:完整映射节点内(P2P/SHM/NVLS)和节点间(IB/Socket/CollNet)传输机制及优化技术
- 迭代执行模型:逐步分解每种集合算法的通信原语序列
- ATLAHS 实践验证:<5% 模拟误差证明分析洞察的工程价值
技术影响
- NCCL 作为 AI 分布式训练的事实标准,其内部机制的透明化有助于:
- 系统研究者针对性优化通信瓶颈
- 网络架构师设计更适合 AI 训练的互联拓扑
- 性能工程师选择正确的协议/算法/传输组合
- 分析结果可直接用于新硬件平台上的 NCCL 调优
局限性
- 分析基于 NCCL v2.19.1,后续版本(如 2.23 引入的 PAT 算法)可能有变化
- 竞争库(Blink、SCCL)未纳入同等深度的分析
- 未来方向:自动算法选择、容错机制、与入网计算和智能 NIC 的集成
九、参考资源
- arXiv: https://arxiv.org/abs/2507.04786
- GitHub: https://github.com/NVIDIA/nccl
- License: CC BY-SA 4.0
- 评估硬件: CSCS Alps 超算 (16 GH200 Grace Hopper 节点)
- 相关工具: ATLAHS 网络模拟器, AstraSim 2.0
关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 节点内数据传输路径 | intra-node-transfer.png |
| Figure 3 | 数据分区策略 | data-partitioning.png |
| Figure 4 | Ring AllReduce 算法流程 | ring-allreduce.png |
| Figure 5 | Tree AllReduce 算法流程 | tree-allreduce.png |
| Figure 6 | 协议运行时比较 | protocol-runtime.png |