A Survey on Vision-Language-Action Models: An Action Tokenization Perspective
从动作 tokenization 视角统一审视 VLA 模型的综述。提出 VLA 模块 + 动作 token 的统一框架,将现有 VLA 模型归为 8 种动作 token 类型(语言描述/代码/可供性/轨迹/目标状态/隐表示/原始动作/推理),逐一分析每种类型的优势、局限与未来方向,并提出分层架构趋势与从 VLA 模型到 VLA 智能体的演进路径。
A Survey on Vision-Language-Action Models: An Action Tokenization Perspective
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | A Survey on Vision-Language-Action Models: An Action Tokenization Perspective |
| 作者 | Yifan Zhong, Fengshuo Bai, Shaofei Cai, Xiaowei Zhang, Yuanpei Chen, Yaodong Yang 等(北京大学等) |
| 机构 | 北京大学、鹏城实验室等 |
| 论文 | arXiv 2507.01925(v1) |
| 代码 | 无(综述论文) |
| 发布 | 2025-07-02 |
| 学科 | Robotics (cs.RO) |
| 定位 | 首个以动作 tokenization 为统一视角的 VLA 综述 |
二、核心思想
问题定义
VLA 模型种类繁多(RT-1/2、OpenVLA、π₀、GR00T N1 等),各自采用不同的架构和训练策略,导致领域缺乏统一的认知框架来理解它们的共性与差异。研究者难以回答的核心问题是:不同 VLA 模型的本质区别是什么?各种设计选择之间的 trade-off 如何?
解决方案概述
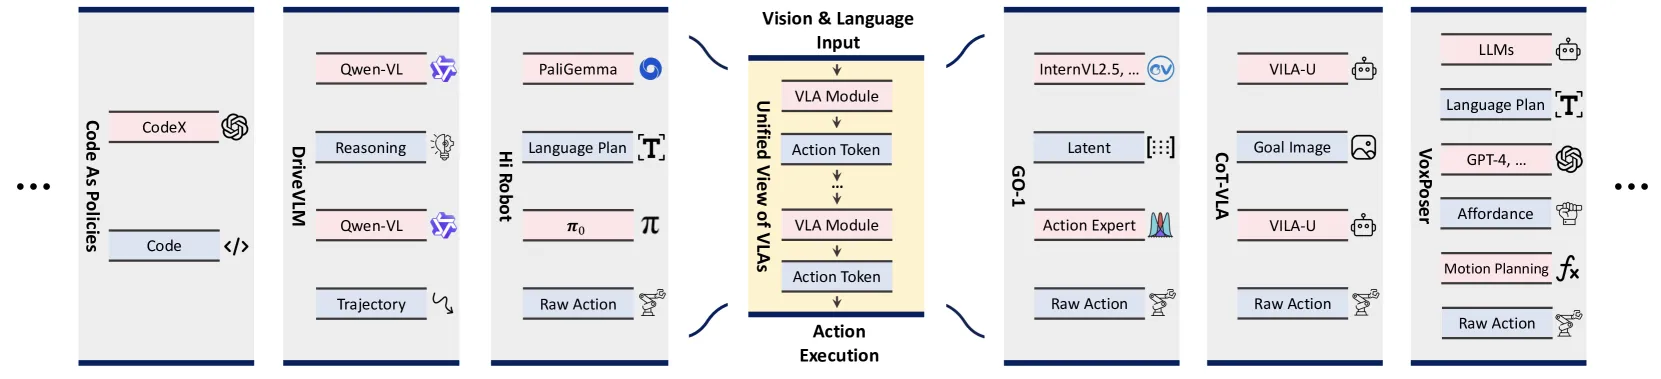
本文提出一个统一框架:所有 VLA 模型都可以抽象为一系列 VLA 模块(最大可微子网络或非可微功能单元)的迭代处理链,每个模块的输出即为动作 token(action token)。动作 token 是 VLA 中语言 token 的泛化对应物——它将视觉和语言输入逐步编码为更具 grounding 和行动导向的信息,最终生成可执行的动作。
VLA 模块定义为:VLA 模型中支持端到端梯度流动的最大可微子网络,或非可微功能单元(如运动规划器)。若多个神经网络组件相互连接且联合优化,则视为同一模块的一部分。
8 种动作 token 类型
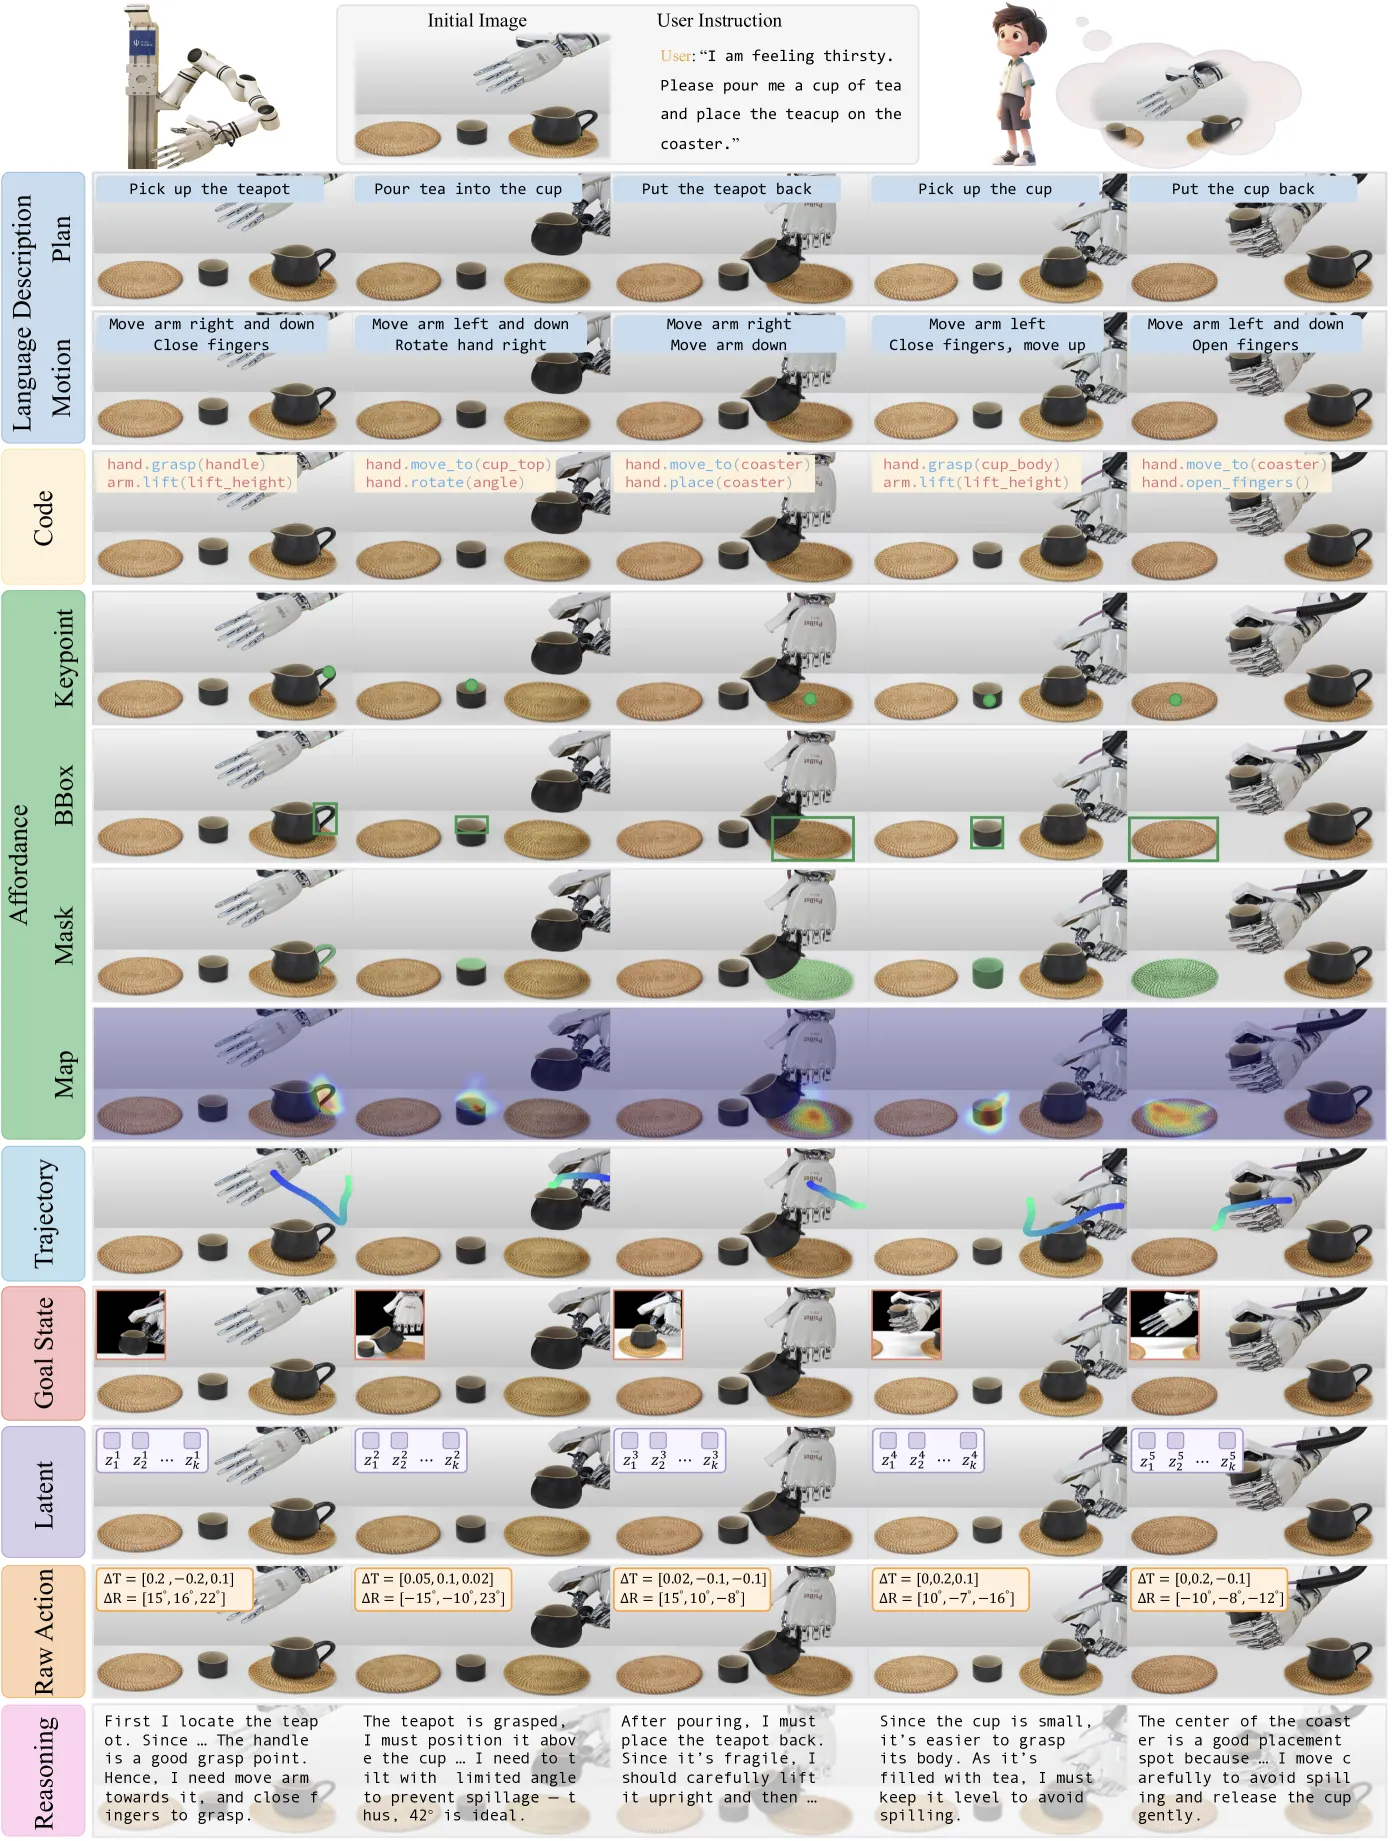
通过统一框架分析,本文发现 VLA 模型的主要区别在于动作 token 的表述方式,可归纳为 8 种类型:
| 类型 | 定义 | 形式 |
|---|---|---|
| (1) 语言描述 | 描述预期动作序列的自然语言表达 | 高层语言计划 → 低层语言动作 |
| (2) 代码 | 可执行代码片段或伪代码 | Python 程序、有限状态机 |
| (3) 可供性 | 捕捉任务相关交互属性的空间化表征 | 关键点、边界框、分割掩码、可供性图 |
| (4) 轨迹 | 时空有序的状态序列 | 末端执行器/物体运动轨迹 |
| (5) 目标状态 | 预测的未来观测 | 单帧图像、点云、视频片段 |
| (6) 隐表示 | 专门预训练的隐向量序列 | 从大规模数据集提取的动作相关隐变量 |
| (7) 原始动作 | 可直接由机器人执行的低层控制指令 | 7-DoF 位姿、关节角度、速度 |
| (8) 推理 | 描述导致特定动作 token 的决策过程 | 自然语言推理链(增强其他所有 token) |
三、基础模型演进(§2)
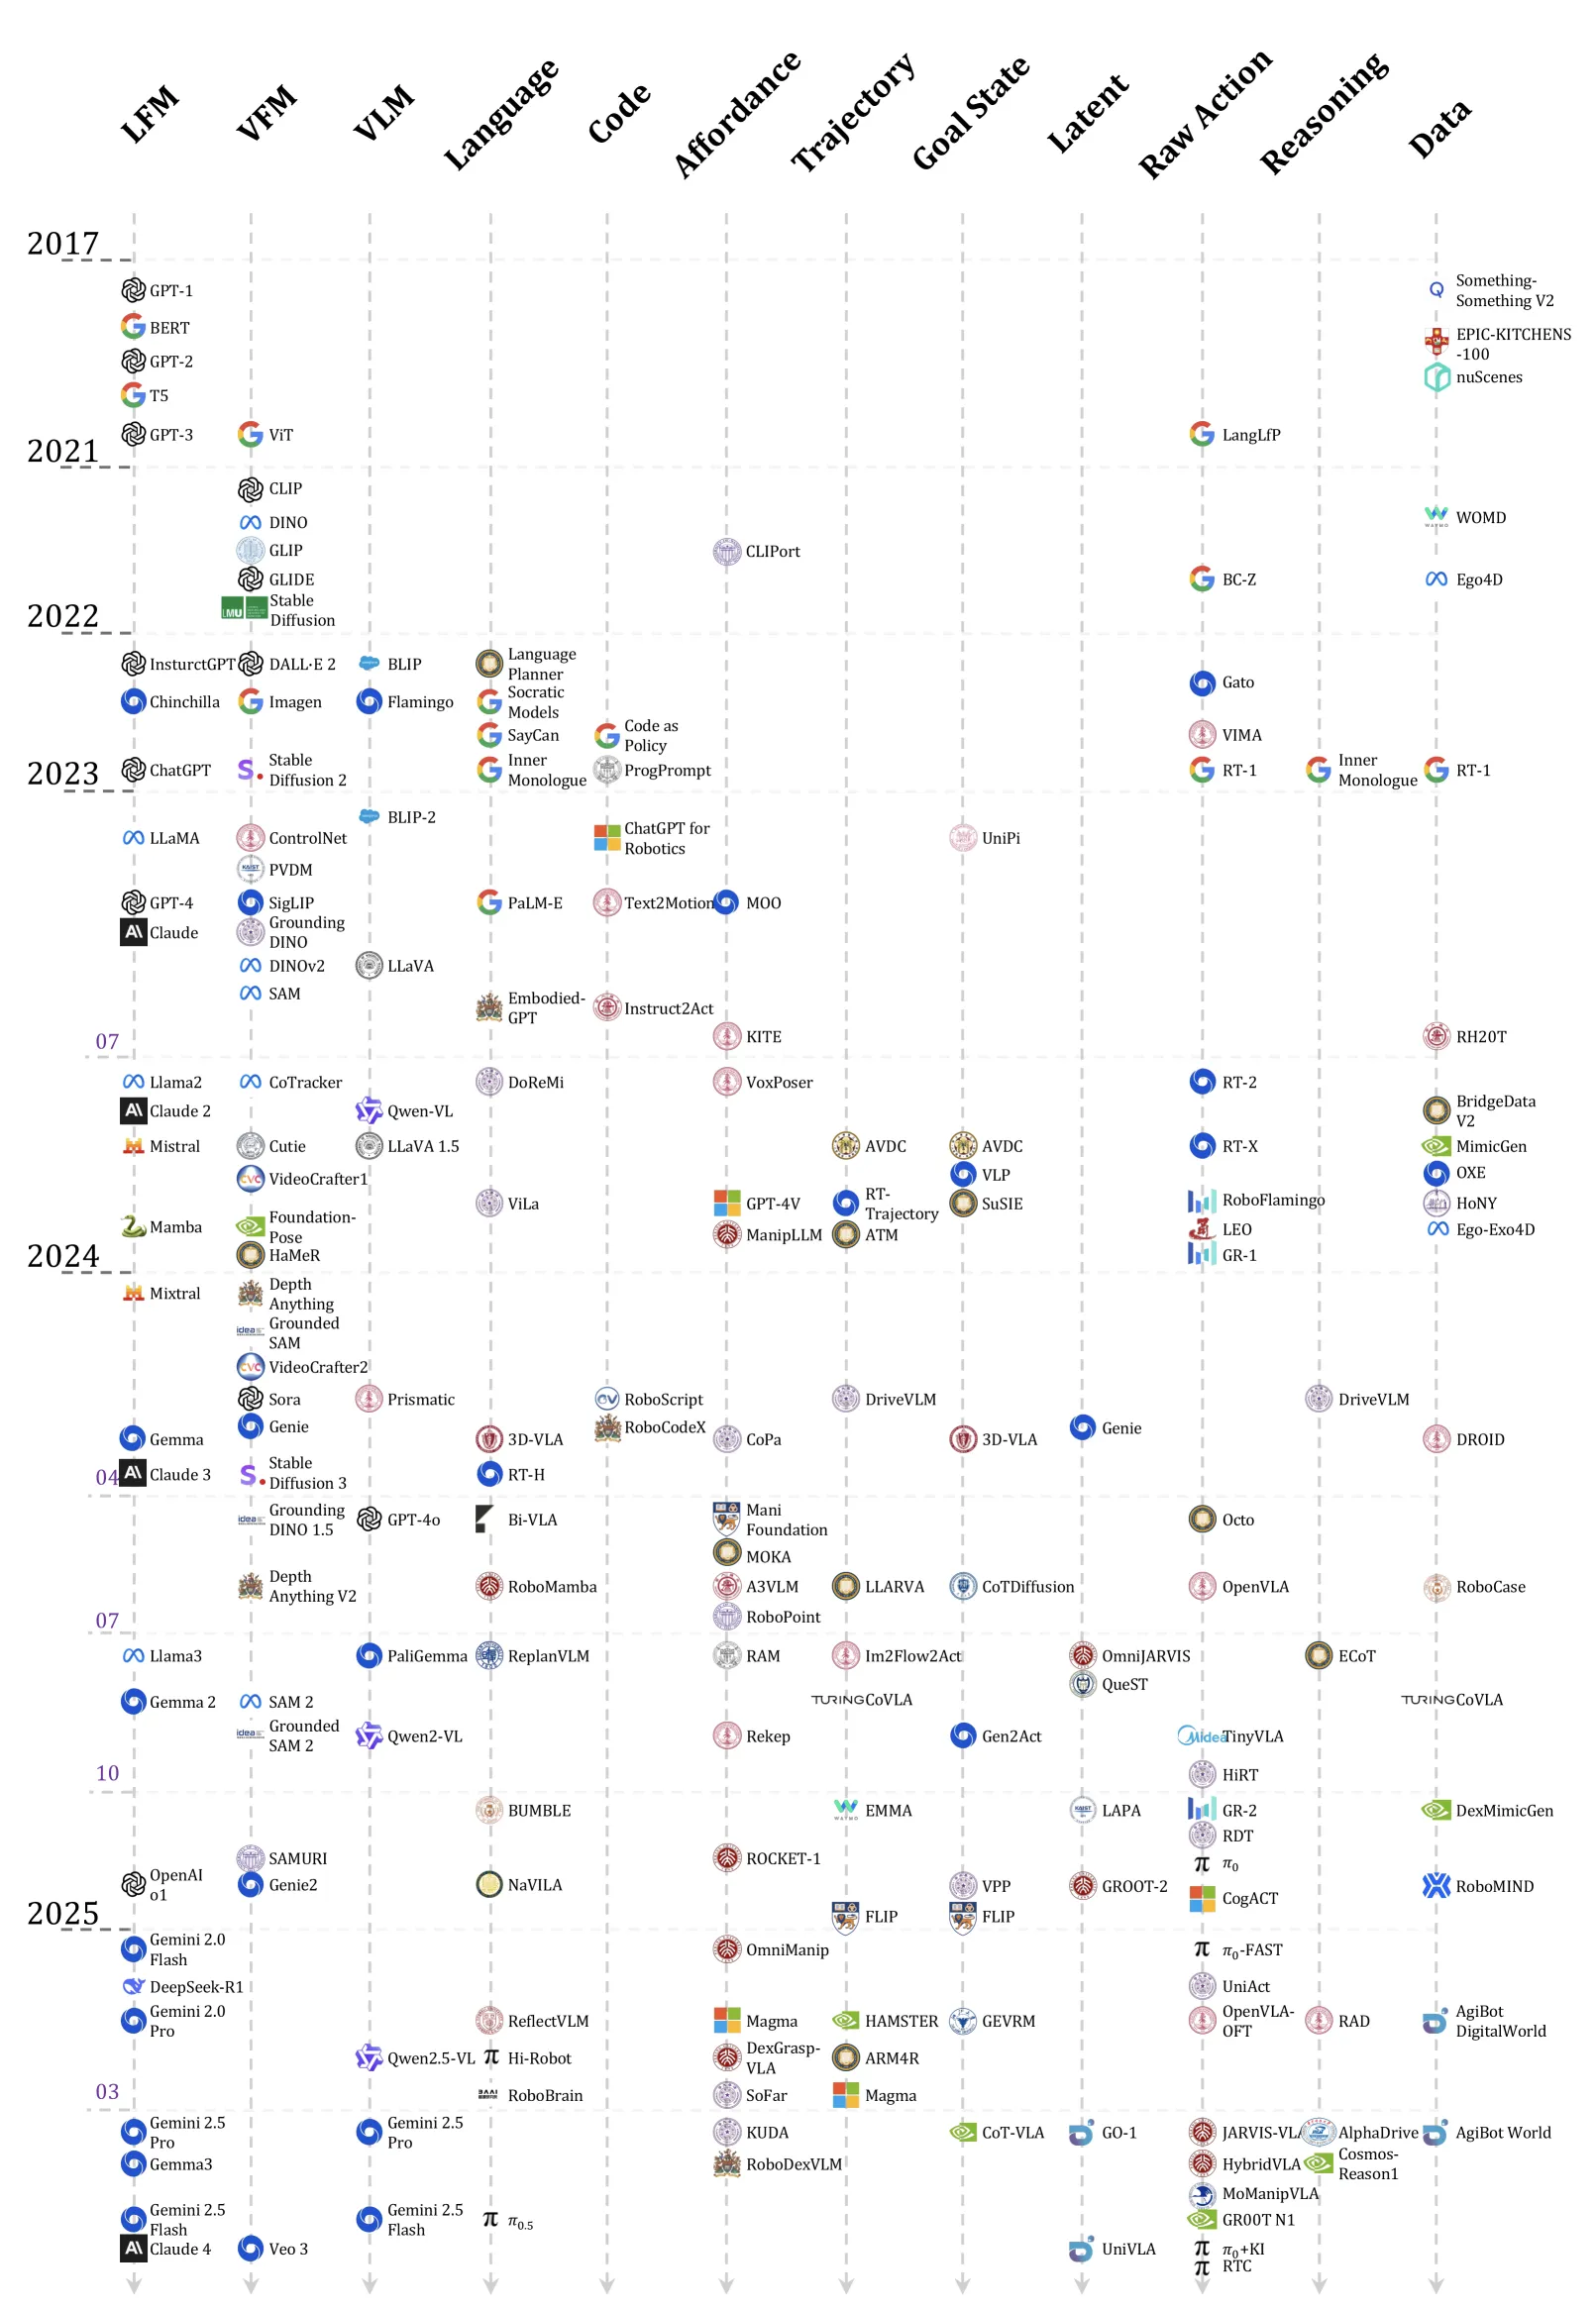
VLA 的发展建立在 LFM/VFM/VLM 的持续进步之上,呈现 U 型曲线——VLA 的繁荣由基础模型和数据双轮驱动。
语言基础模型 (LFM)
- Encoder: BERT(MLM + NSP)、T5(text-to-text)
- Decoder-only: GPT 系列(next-token prediction → in-context learning → 175B 规模涌现能力)
- Scaling Laws: 模型大小/数据量/算力与预训练损失的预测关系
- 对齐: InstructGPT(SFT + RLHF)开启了人类偏好对齐时代
- 开源: Llama/Gemma/Mistral(2B-70B)+ PEFT(LoRA)
- MoE: Switch Transformer / Mixtral(激活子集专家,大容量低推理成本)
- 线性注意力: Mamba(选择性状态空间,替代 Transformer 二次复杂度)
- 推理增强: o1 / DeepSeek-R1(扩展测试时计算,GRPO 强化学习)
视觉基础模型 (VFM)
- ViT: 图像作为视觉 token 序列,与文本联合处理
- CLIP/SigLIP: 4 亿图文对的对比学习 → 零样本迁移
- DINO: 自监督学习 → 细粒度下游任务(分割/深度估计)
- SAM/SAM 2: 提示式图像/视频分割
- Grounding DINO: 开放词汇检测与定位
- 扩散模型: Stable Diffusion / Sora(流匹配 + 物理先验)
- 世界模型: Genie/Genie 2(条件动作序列的未来视觉模拟)
视觉-语言模型 (VLM)
- BLIP-2: Q-Former 连接器 + 两阶段训练(冻结 VFM + 冻结 LLM)
- LLaVA: CLIP 视觉编码器 → MLP → Vicuna(视觉指令微调)
- Qwen2.5-VL: 2D RoPE + M-RoPE 时空编码,动态分辨率视频理解
- Prismatic: 单阶段训练 + 融合 DINOv2/SigLIP 视觉骨干
- PaliGemma: SigLIP + Gemma → π₀ 系列 VLA 骨干
- GPT-4o / Gemini 2.5 Pro: 领先闭源模型
四、8 种动作 token 类型详解
4.1 语言描述(§4)
进展与代表工作:
- 早期: Language Planner、Socratic Models(LLM 分解子目标)、SayCan(LLM 计划 + VLM 可行性加权)
- 反馈循环: Inner Monologue(成功检测/场景描述/人类反馈的多轮推理)、DoReMi(LLM 生成计划 + 执行约束)
- VLM 直接规划: PaLM-E(视觉+语言+机器人状态统一编码)、EmbodiedGPT(轻量 VLM + EgoCOT 数据集)
- 记忆与反思: BUMBLE、ReflectVLM
- 分层架构: Hi Robot(PaliGemma 高层 VLM → π₀ 风格低层策略)、π₀.₅(单一模型统一:高层语义子任务 + 低层连续动作,web-scale 异构数据训练)
- 语言动作(fine-grained): RT-H(VLM 预测”拉餐巾”→ 低层动作)、NaVILA(导航:生成”前进 75cm”)
优势:
- 与 LLM/VLM 无缝集成,开箱即用的零样本规划
- 丰富的共训练数据(网络语料转移世界知识)
- 长时序规划近乎必需
- 可解释性支持人类监督与干预
局限:
- 表达能力不足(模糊、难以描述精细操作)
- 大模型推理延迟高
4.2 代码(§5)
核心思路: 用可执行代码片段或伪代码替代离散信号/语言命令,天然支持条件/循环等控制结构,通过机器人 API 直接执行。
进展:
- Code as Policies: Codex → Python 代码 → 调用机器人 API + NumPy 空间推理
- ProgPrompt: 有限状态机框架(import 声明 + 自然语言注释 + 断言验证)
- Instruct2Act: 多模态基础模型辅助精确目标分割 + 开放词汇分类
- RoboCodeX: 思维树框架融合视觉/语言/物理线索
- RoboScript: 统一代码生成管线
优势: 逻辑清晰、可利用丰富第三方库、透明可验证
局限: 过度依赖预定义 API 库、运行时脆弱(符号接地问题)、动态环境适应性差
4.3 可供性(§6)
可供性(Affordance)= 环境相对于智能体提供的「动作可能性」。4 种子类型:
| 子类型 | 说明 | 代表 |
|---|---|---|
| 关键点 | 精确交互锚点 | ReKep(倒茶) |
| 边界框 | 实例级定位 | DexGraspVLA(杂 cluttered 场景精细抓取) |
| 分割掩码 | 细粒度轮廓/功能区 | ROCKET-1(开放世界决策) |
| 可供性图 | 密集、交互为中心的全场景 | ManiFoundation(可变形物体操作) |
优势: 空间 grounding 强、与视觉感知天然对齐 局限: 3D 空间结构建模不足、缺乏时序演化建模、对视觉噪声(遮挡/运动伪影)敏感
4.4 轨迹(§7)
定义: 时空有序的空间状态序列,捕捉物体/末端执行器/场景的动态演化。
代表: RT-Trajectory(用板擦清洁桌子)
优势: 可从离线人类视频中训练、跨任务泛化 局限: 3D 表达能力有限、VLM 支持不足、语义 grounding 不充分
4.5 目标状态(§8)
定义: 预测的未来观测——图像、点云或视频片段,表示预期动作结果。
子类型:
- 单帧图像: 静态目标状态
- 多帧视频: 动态目标状态(VPP:移液管液体转移)
优势: 基础模型强力支持、通过 hindsight relabeling 和数据利用实现高可扩展性、任务特异性强 局限: 高质量一致的目标状态生成困难、推理延迟高
4.6 隐表示(§9)
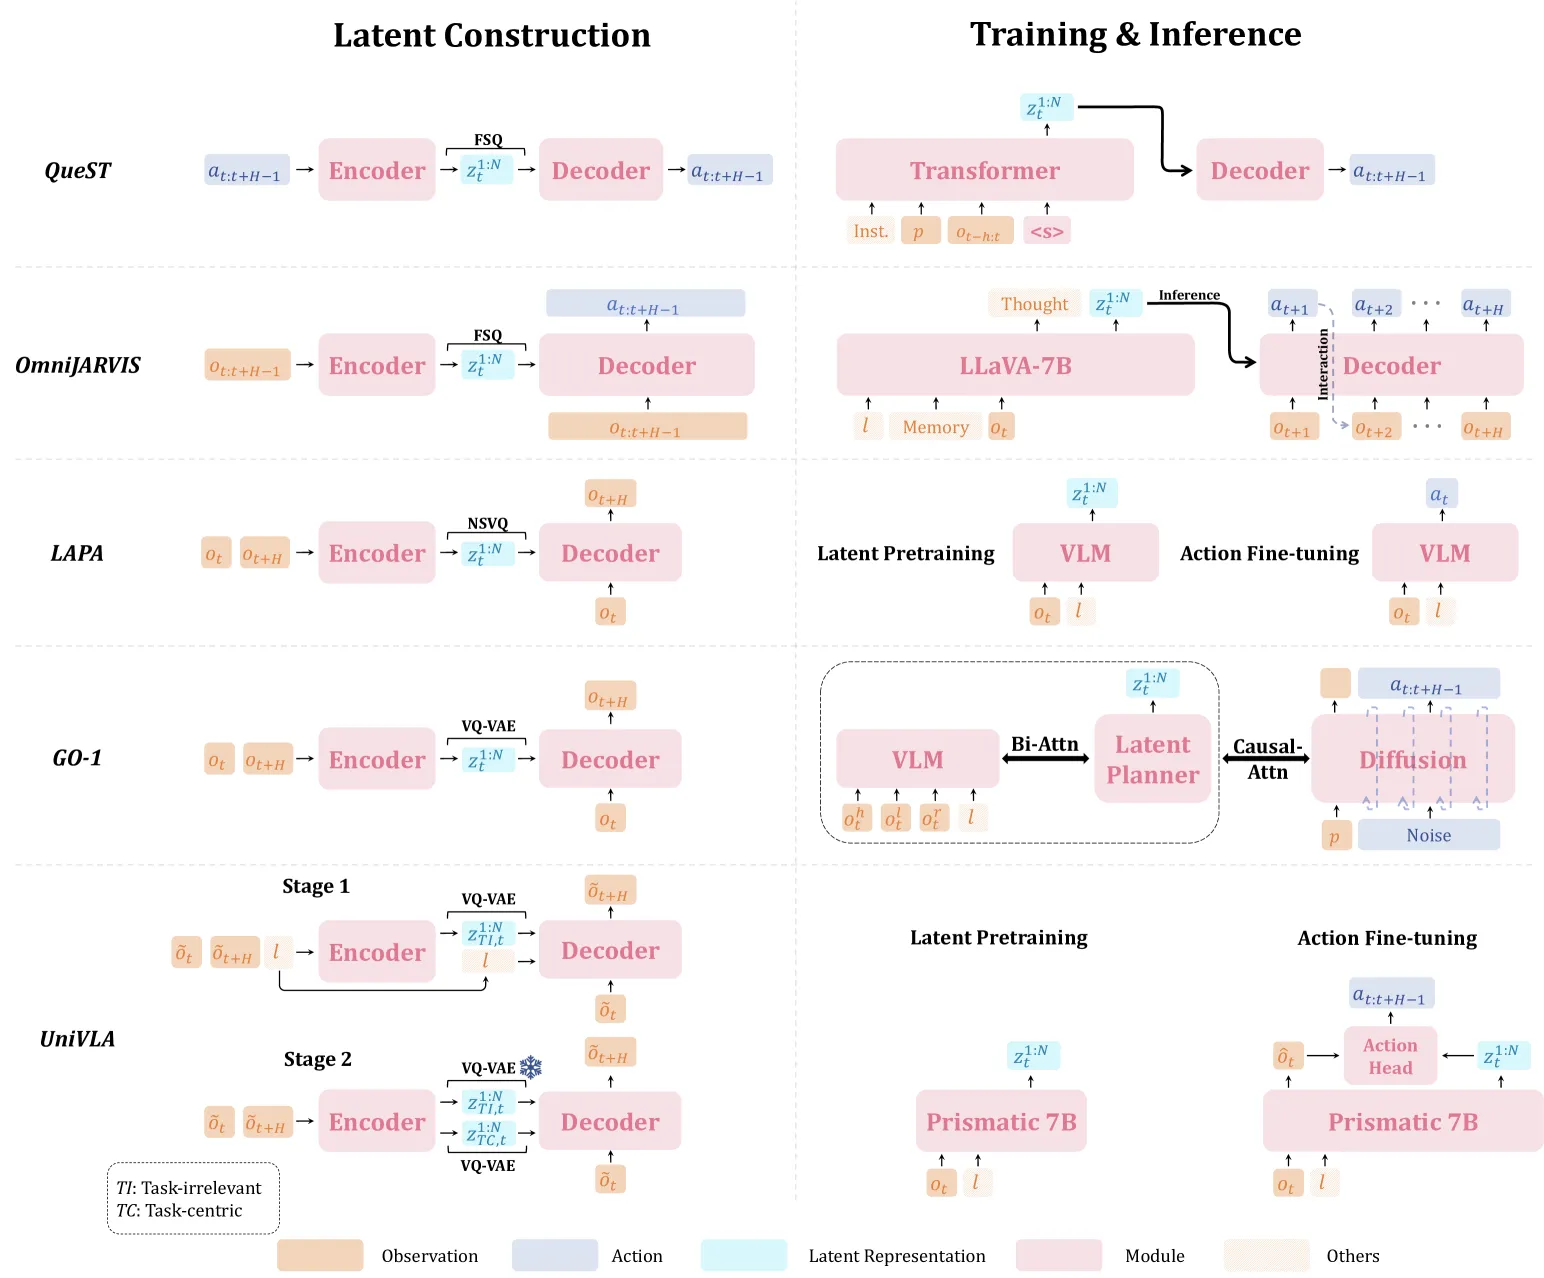
定义: 专门预训练的隐向量序列,编码时间区间内的动作相关信息。
子类型:
- 视觉基: 从图像对学隐动作(LAPA、UniVLA)
- 动作基: 从动作序列学表征
- 目标基: 从目标状态学表征
代表: GO-1(叠短裤)、OmniJARVIS(Minecraft 挖矿)
优势: 高数据可扩展性(利用无动作标签的人类视频和跨具身数据)、表达力强(紧凑结构、隐式语义、多模态融合) 局限: 不可解释;需改进粒度、全面性和任务中心对齐
4.7 原始动作(§10)
定义: 可直接由机器人执行的一个或多个低层控制指令。
六大技术方向:
- 视觉-语言特征融合: FiLM 条件、交叉注意力
- Transformer 通用模型: Gato、RT-1(TokenLearner + 非自回归解码)
- 自回归机器人 VLA: RT-2、OpenVLA(VLM 骨干 + 离散动作 token)
- 视频预训练 + 机器人数据微调: π₀(PaliGemma + flow matching,50Hz 并行输出)
- 扩散动作分块: Octo、Diffusion-VLA(DDPM/DDIM 去噪)
- 异构数据集 + 统一动作空间: OXE(22 台机器人 100 万 episode)、UniAct(Universal Action Space 离散码本)
优势: 最小人工知识、最小 token 标注、训练策略与 VLM 相似具备扩展潜力、高效微调 局限: 数据稀缺、采集困难、推理延迟高、跨具身泛化差
4.8 推理(§11)
定义: 自然语言表达,明确描述导致特定动作 token 的决策过程。
演进: 纯语言推理 → 基于动作 token 的推理(用动作 token 而非语言 token 构建推理链)
代表: DriveVLM(自动驾驶)、ECoT(自回归预测中间表征)
优势: 增强目标动作 token 的生成、解决复杂问题 局限: 高延迟;需开发灵活的推理范式(自适应测试时计算)
五、Table 1 汇总:8 种 token 类型一览
| 动作 token 类型 | 优势 | 局限 | 代表性实证成果 |
|---|---|---|---|
| 语言计划 | LLM/VLM 原生支持、丰富共训练数据、长时序规划必需 | 表达能力不足(模糊/难描述精细操作)、高延迟 | π₀.₅ 铺床、Hi Robot 做三明治 |
| 语言动作 | 多任务数据共享 | — | RT-H 拉餐巾 |
| 代码 | LLM 原生支持、逻辑清晰、丰富第三方库 | 依赖预定义 API、运行时脆弱 | Instruct2Act 整理房间 |
| 关键点 | 精确交互目标 | 3D 结构建模不足、缺时序建模、对视觉噪声敏感 | ReKep 倒茶 |
| 边界框 | VLM 支持充分、实例级定位高效 | — | DexGraspVLA 精细抓取 |
| 分割掩码 | 细粒度轮廓/功能区 grounding | — | ROCKET-1 开放世界决策 |
| 可供性图 | 密集、交互为中心、全场景 | — | ManiFoundation 可变形物体操作 |
| 轨迹 | 可从离线人类视频训练、跨任务泛化 | 3D 表达有限、VLM 支持不足、语义 grounding 弱 | RT-Trajectory 清洁桌面 |
| 目标状态 | 基础模型支持、hindsight relabeling 可扩展、任务特异性 | 高质量生成困难、高延迟 | VPP 移液管转移液体 |
| 隐表示 | 高数据可扩展性(利用人类视频/跨具身数据)、表达力强 | 不可解释;需改进粒度/全面性/任务对齐 | GO-1 叠短裤、OmniJARVIS 挖矿 |
| 原始动作 | 最小人工知识/标注、扩展潜力大、高效微调 | 数据稀缺、采集困难、高延迟、跨具身泛化差 | π₀ 洗衣折叠、Real-Time Chunking 点火 |
| 推理 | 增强目标 token 生成、解决复杂问题 | 高延迟;需灵活推理范式 | DriveVLM 自动驾驶 |
六、可扩展数据来源(§12)
三层金字塔结构:
        ┌─────────────────────┐
        │  Top: 真实机器人数据  │  ← 最高保真度,直接物理监督
        │  OXE / DROID / RT-1  │
        ├─────────────────────┤
        │  Middle: 合成/仿真数据 │  ← 低成本可扩展,composition skills
        │  MimicGen / RoboCasa │
        ├─────────────────────┤
        │  Bottom: 网络数据/人类视频 │  ← 最大规模,世界知识
        │  Ego4D / EPIC-KITCHENS│
        └─────────────────────┘
Bottom: 网络数据与人类视频
- 数据集: Ego4D(3000+ 小时,800+ 人,9 国 74 城)、EPIC-KITCHENS-100、Something-Something V2
- 作用: 提取轨迹(Magma Set-of-Mark)、推断隐状态转换、生成隐动作
- 弱监督: Frame-level captioning + temporal alignment 间接监督轨迹/目标 token
Middle: 合成与仿真数据
- 合成数据集生成: MimicGen(空间变换 + 场景重组)、DexMimicGen(双臂运动学重定向)、RoboCasa(100K+ 轨迹)、GR00T N1(双臂装配)
- 交互式仿真平台: robosuite、Habitat、Isaac Gym/Lab、AgiBot Digital World
- 数据生成范式: 遥操作 / 算法求解器(运动规划器)/ 学习策略(RL)
- 程序化内容生成: 随机化物体/纹理/光照
- 挑战: sim-to-real gap
Top: 真实机器人数据
- 多具身数据集: OXE(100 万 episode,22 台机器人)、RoboMIND(含 5K 失败轨迹 + 因果标注)、RH20T(多模态含力矩/音频)
- 单具身/任务特定: RT-1(13 万轨迹,13 台 Google Robot)、DROID(13 机构统一 Franka Panda)、AgiBot World(100 万轨迹,Genie-1)
- 长时序: BridgeData V2(6 万厨房任务演示)
- 野外环境: HoNY(非结构化家庭环境)
- 自动驾驶: nuScenes、Waymo Open Dataset-Motion
- 主流范式: 大规模仿真/网络数据预训练 → 小规模高质量真实数据微调
七、VLA 发展趋势与未来方向(§13)
7.1 动作 token 与 VLA 架构趋势
核心观点: 未来 VLA 不是单一主导 token,而是战略性组合,推动分层架构:
┌─────────────────────────────────────────┐
│  顶层: 语言计划 + 代码                     │  ← 长时序规划 + 逻辑控制
│  (LLM/VLM 原生支持,不可替代)              │
├─────────────────────────────────────────┤
│  中层: 3D 可供性 + 轨迹流建模 + 目标视频预测  │  ← 精确可解释的运动表征
│  (世界模型支持视觉目标状态的生成)            │
├─────────────────────────────────────────┤
│  底层: 原始动作                            │  ← 端到端映射
│  (短期由中层 token 映射,长期直接 subtask→raw)│
└─────────────────────────────────────────┘- 语言动作和基于 API 的代码相对表达能力较弱,可被 3D 可供性/轨迹/目标视频替代
- 隐表示潜力巨大但目前训练挑战大(粒度/全面性/任务对齐),短期偏好更显式的 token
- 推理应贯穿整个 VLA 层次,从语言推理进化为基于动作 token 的推理(利用多模态反馈和自适应测试时计算)
7.2 从 VLA 模型到 VLA 智能体(§13.2)
- 当前 VLA 缺乏历史机制(仅几帧或简单语言规划)
- 需要结构化记忆、规划、反思组件
- 架构应从线性链进化为双向/图拓扑(自适应调用模块和 token)
- 多智能体系统与人类-智能体共存
7.3 从模仿学习到强化学习(§13.3)
- IL 上限受演示者能力限制,人类演示常次优(疲劳/设备限制)
- RL 可实现类人的试错和自主探索
- 挑战:真实世界重置成本高、交互效率低、安全风险
- 方向:上下文强化学习(in-context RL)、VLM 自动生成稠密奖励函数
7.4 从受限硬件到全灵巧与多模态(§13.4)
- 当前多用简单夹爪,需向灵巧手演进
- 整合音频、触觉等新模态
7.5 从能力中心到安全感知(§13.5)
- 当前研究偏重能力,需加强安全与人类对齐
7.6 从数据稀缺到数据可扩展性(§13.6)
- 模型、数据、硬件三者协同进化(triad of progress)
- 当前受限于受限平台和稀缺数据,多数研究仍停留在简化实验室环境
八、与另一篇 VLA 综述的对比
| 维度 | 本文(动作 tokenization 视角) | 之前的 VLA 综述 (2510.07077) |
|---|---|---|
| 核心视角 | 动作 token 的类型学与统一框架 | 全栈(软件+硬件)综合审查 |
| 分类方式 | 8 种动作 token 类型 | 3 类架构(sensorimotor/world model/affordance) |
| 独特贡献 | VLA 模块定义、Table 1 对比、分层组合趋势 | 7 种 sensorimotor 变体、机器人平台/数据集详表 |
| 共同结论 | 分层架构 + 多种 token 组合 + 推理贯穿 | 分层架构 + 世界模型 + RL + 持续学习 |
九、总结
核心贡献
- 统一框架: 提出 VLA 模块 + 动作 token 概念,将所有 VLA 模型统一到同一分析框架下
- 8 型分类法: 首次系统性地将动作 token 分为 8 种类型,逐一分析动机/代表工作/优势/局限/未来方向
- Table 1 全景对比: 汇总每种 token 类型的优势、局限和实证成就
- 分层架构趋势: 论证未来 VLA 不是单一 token 主导,而是语言计划+可供性/轨迹/目标状态+原始动作的分层组合
- 数据三层金字塔: 从人类视频→仿真合成→真实机器人数据的可扩展数据策略
- 从模型到智能体: 呼吁引入记忆/规划/反思,从线性架构进化为图拓扑
技术影响
- 为 VLA 研究提供了统一的认知语言(VLA 模块 + 动作 token)
- 揭示了看似不同的 VLA 架构背后的共性
- 为未来 VLA 系统设计提供了可操作的路线图
局限性
- 部分 token 类型(尤其是隐表示)仍处于早期探索阶段
- 真实世界 RL 训练的效率和安全挑战尚未解决
- 硬件(灵巧手/多模态传感器)仍是瓶颈
十、参考资源
- arXiv 论文: https://arxiv.org/abs/2507.01925
- 图片索引:
figures/2507.01925-vla-action-tokenization-survey/README.md