PPFlow: 金字塔分块化流的高效视觉生成
PPFlow 用金字塔分块化(高噪声时间步用大 patch、低噪声时间步用小 patch)替换 DiT 固定 patch size,仅切换 Patchify/Unpatchify 线性投影而共享 DiT blocks,实现 1.6–2.0× 去噪加速且质量不降,从预训练模型适配仅需 +8.9% 训练 FLOPs。
Pyramidal Patchification Flow for Visual Generation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Pyramidal Patchification Flow for Visual Generation |
| 机构 | 复旦大学 Fudan Generative Vision |
| 论文 | https://arxiv.org/abs/2506.23543 (v3, 2026-03-12) |
| 发布 | 2025-06-30(v1),2026-03-12(v3) |
| 分类 | cs.CV (Computer Vision and Pattern Recognition) |
| 代码 | https://github.com/fudan-generative-vision/PPFlow |
摘要
Diffusion Transformer (DiT) 通常在所有时间步使用相同的 patch size 进行 patchify,导致跨时间步的 token 预算恒定。本文提出 Pyramidal Patchification Flow (PPFlow):为高噪声时间步减少 token 数以提升采样效率。核心思想极简——高噪声时间步用更大的 patch,低噪声时间步用更小的 patch。实现也简单——跨时间步共享 DiT transformer blocks,仅为 Patchify 与 Unpatchify 中的不同 patch size 学习独立的线性投影。
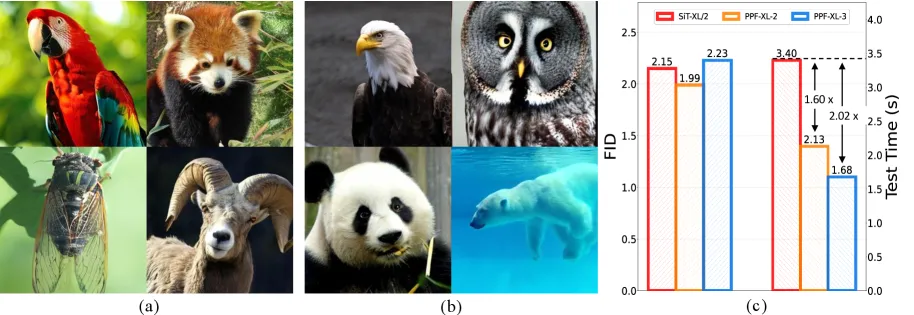
与在金字塔表示上操作的 Pyramidal Flow 不同,PPFlow 在全分辨率潜表示上操作,消除了轨迹跳变点(jump points),从而无需采样时的 re-noising 技巧。从预训练 SiT-XL/2 训练仅需 +8.9% 额外训练 FLOPs,即可在保持生成质量的前提下获得 2.02× 去噪加速;从头训练也能取得可比加速(如 SiT-B 上 2.04×)。从文生图模型 FLUX.1 训练,PPFlow 在 512 到 2048 分辨率上实现 1.61–1.86× 加速且质量可比。
二、核心思想
问题定义
扩散/流模型在视觉生成上达到 SOTA,但去噪轨迹通常需要大量昂贵的网络评估。已有降本工作沿三条主线:
- 减少函数评估次数:DDIM、蒸馏、一致性模型、单步扩散
- 降低单次评估成本:量化、剪枝、以粗表示/级联设计减少 token 数
- 其他:移除或摊销 classifier-free guidance
其中”随时间变化空间分辨率”的方法(金字塔/级联生成)在早期噪声大的时间步减少 token,但会引入分辨率**“跳变”**,使训练/推理复杂化并破坏轨迹连续性。
解决方案概述
PPFlow 聚焦于减少输入 DiT blocks 的 token 数量。DiT 用 patchify 操作控制 token 数与计算复杂度,通常对所有时间步用固定 patch。PPFlow 引入简单修改:
- 采用金字塔分块方案:高噪声时间步 patch 更大(如两级示例 与 )
- 每级有自己的 Patchify/Unpatchify 线性投影参数
- 所有级共享同一套 DiT blocks 参数
与 Pyramidal Flow / PixelFlow 的区别
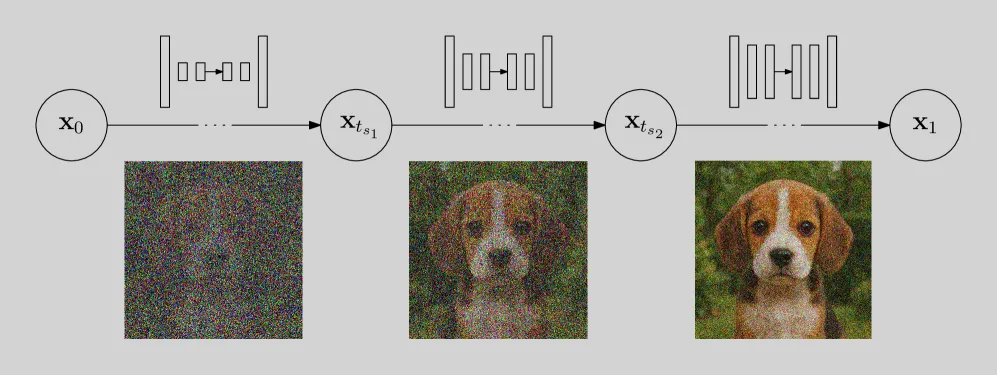
相似点:高噪声时间步 token 数更少。关键区别:
| 维度 | PPFlow(本文) | Pyramidal Flow / PixelFlow |
|---|---|---|
| 表示 | 全分辨率潜表示 | 金字塔(多分辨率)表示 |
| 连续性方程 | 满足 Continuity Equation | 不满足(分辨率沿轨迹变化) |
| 跳变点 | 无 jump points,推理同普通 DiT | 需精心设计的 re-noising 技巧 |
三、技术架构
3.1 预备知识:Flow Matching 与 DiT patchification
Flow Matching:构造从 到 的连续序列,线性插值 ,速度场 。网络学习时间相关速度 。推理时数值积分 从噪声得到干净样本。
DiT patchification:DiT 由三部分组成 。
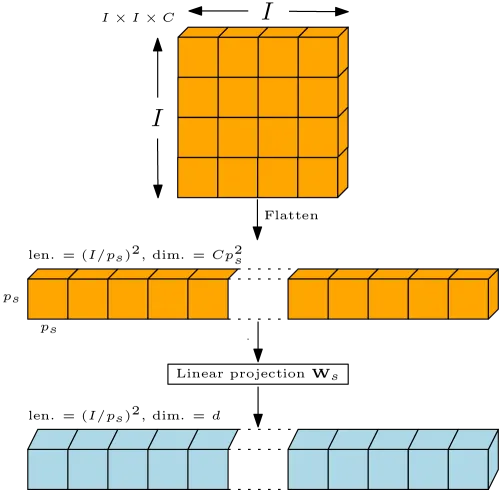
- Patchify:将空间输入(噪声潜码)转为 个 token,每个 token 由 的 patch 表示线性投影为 维向量。token 数 , 为输入潜码空间尺寸
- Unpatchify:逆过程,将 DiT blocks 输出的 维表示映射回 的噪声潜空间(用于速度估计)
- patch size 直接决定 token 数与计算复杂度;DiT 选 平衡性能与效率
3.2 金字塔分块化 (Pyramidal Patchification)
PPFlow 将时间步划分为多个 stage。以三级为例,时间步分为 ,对应大、中、小三种 patch size 、、(最后一级设为 ,与普通 DiT 相同)。
独立线性投影:每个 patch 是维度 的向量。token 表示维度 对所有 stage 保持相同。三级的 Patchify 投影矩阵尺寸不同:
每个 stage 有自己的 Patchify 和 Unpatchify 投影矩阵。
复杂度分析:
- patch size 改变不影响 token 表示维度、DiT blocks 结构与参数 → 所有 stage 共享 DiT blocks 参数
- Patchify/Unpatchify 线性投影成本与 patch size 无关(三级相同)
- DiT blocks 成本依赖 token 数:线性投影与 MLP 随 token 数线性,self-attention 二次
- DiT-XL/2(, 层)约 99.8% 的 FLOPs 在 DiT blocks
- 两级/三级 PPFlow 在 256×256 图像生成上分别降低 FLOPs 37.8% 与 50.6%
3.3 训练与推理
训练目标:flow-matching 目标与 stage schedule(时间分区 + patch size)在训练中固定。推荐从预训练 DiT 初始化(保持性能且训练成本有限)。
① 从头训练 (From Scratch):像普通 DiT 一样初始化并用标准设置训练 Patchify/Unpatchify 线性投影和共享 DiT blocks。每个 patch size 的线性投影仅用其对应时间步的噪声潜码训练。
② 从预训练 DiT 训练 (From Pretrained DiT):
- DiT blocks 权重直接从普通 DiT 复制
- Patchify 投影用平均初始化:设普通 DiT patch size 为 ,PPFlow 第二级为 ,则 ( 来自 )—— 直觉上是把四个 patch 平均后映射为 维 token
- Unpatchify 投影用复制初始化: —— 直觉上四个 patch 的输出初始相同
推理:采样过程几乎与普通 DiT 相同——从噪声 逐步生成 ()直到干净样本 。唯一区别:不同 stage 使用与其时间步对应的 patch size 和线性投影。无需 re-noising 技巧(因潜表示空间尺寸不变)。
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 金字塔分块化 | 高噪声时间步用大 patch、低噪声用小 patch,减少 token 数 | FLOPs 降 37.8%/50.6% |
| 共享 blocks + 独立投影 | 仅切换 Patchify/Unpatchify 线性投影,DiT blocks 全共享 | 实现极简 |
| 全分辨率潜表示 | 消除轨迹跳变点,推理同普通 DiT,无需 re-noising | 满足连续性方程 |
| 训练-测试一致性 | 每个 patch size 仅训练其对应时间步范围 | 优于 FlexiDiT/Lumina-Video |
| 低成本适配 | 预训练模型平均/复制初始化,仅 +8.9%/7.1% 训练 FLOPs | 表 2 |
| stage-wise CFG | 每 stage 用不同 CFG 强度 | 消融:FID 4.30→4.22 |
与并发工作 FlexiDiT / Lumina-Video 的区别:后者对每个 patch size 在所有噪声度的时间步上训练(Lumina-Video 用 shift-sampling 偏向),导致训练-测试不一致。PPFlow 让每个 patch size 只训练其对应时间步范围,使该 patch size 的模型能更好处理特定噪声度——实验证实此优势。
五、实验结果
5.1 实验设置
- 数据:ImageNet 类条件生成(256/512px),Stable Diffusion VAE 潜空间;文生图用 LAION、JourneyDB、BLIP3o-60k 及 FLUX.1 生成的 1M 图
- 基线:SiT(主基线与起点),另与 DiT-XL/2 对比
- 训练:AdamW,lr ,无 weight decay,batch 256,EMA decay 0.9999
- stage 划分:
- 两级: patch 用于 ; 用于
- 三级: 用于 ; 用于 ; 用于
- 用 stage-wise CFG 与 Patch n’ Pack(变长序列打包,降低单次迭代训练 FLOPs)
- 指标:类条件用 FID-50K / IS / sFID / Precision-Recall;文生图用 GenEval / DPG-bench / T2I-CompBench
5.2 从头训练
训练 PPF-B-2 与 PPF-B-3 共 11M 步,均在显著更低的测试 FLOPs 下取得与 SiT-B/2 相当或更优的 FID-50K,且 IS 一致提升:
| 模型 | FID-50K↓ | 加速 |
|---|---|---|
| SiT-B/2(基线) | 4.46 | 1× |
| PPF-B-2(两级) | 3.83 | 1.61× |
| PPF-B-3(三级) | 4.43 | 2.04× |
- stage-wise CFG schedule:PPF-B-2 用 ,PPF-B-3 用
- 相同噪声输入的视觉对比显示金字塔分块保持图像质量同时提升计算效率
5.3 从预训练 DiT 训练
从预训练 SiT 训练,仅需 ≤10% 的预训练 FLOPs,在降低测试 FLOPs 下评估:
- 多模型配置(B、XL)、多分辨率(256、512)下,两级节省 37.4–41.3% 测试 FLOPs,三级节省 50.6–54.6%,FID 可比、IS 更好
- 从 SiT-XL/2 训练:两级/三级分别仅需 +8.9% / +7.1% 额外训练 FLOPs,获得 1.60× / 2.02× 推理加速
- stage-wise CFG:PPF-XL-2 用 ,PPF-XL-3 用
5.4 文生图(集成 FLUX.1-dev)
将两级 PPFlow 集成进预训练 FLUX.1-dev,渐进式训练 512→1024→2048 分辨率(90k 迭代,lr )。以微调后的 FLUX.1-ft 为基线:
- GenEval、DPG Bench、T2I-CompBench 结果与 FLUX.1-ft 可比
- 测试 FLOPs 随输入分辨率增大而渐进降低,验证可扩展到高分辨率
- 512–2048 分辨率上 1.61–1.86× 加速,质量保持
5.5 消融实验
① Patch-Level embedding 与 stage-wise CFG(PPF-B-2 从 SiT-B/2 训练 1M 步):
| 配置 | FID↓ |
|---|---|
| 基础 | 4.44 |
| + 学习式 patch-level (stage) embedding | 4.30 |
| + stage-wise CFG | 4.22(IS 大幅提升) |
② stage 数目:从 2 增到 5,测试 FLOPs 持续降低;配合额外训练可在显著更低 FLOPs 下恢复两级质量——体现 stage 数与训练预算的权衡。
③ 时间步分段:不同时间分段的测试 FLOPs 不同,需不同训练步数维持与 SiT-B 可比性能;FLOPs 越低需训练越多。
④ 对比金字塔表示(Pyramidal Flow):两级变体从头训 1M 步,PPFlow 在 FID、sFID、IS、Precision/Recall 全部最优。仅用金字塔表示产生模糊、块状伪影图像,re-noising 技巧只能部分缓解。
⑤ 对比变 patch size 训练(Lumina-Video / FlexiDiT):
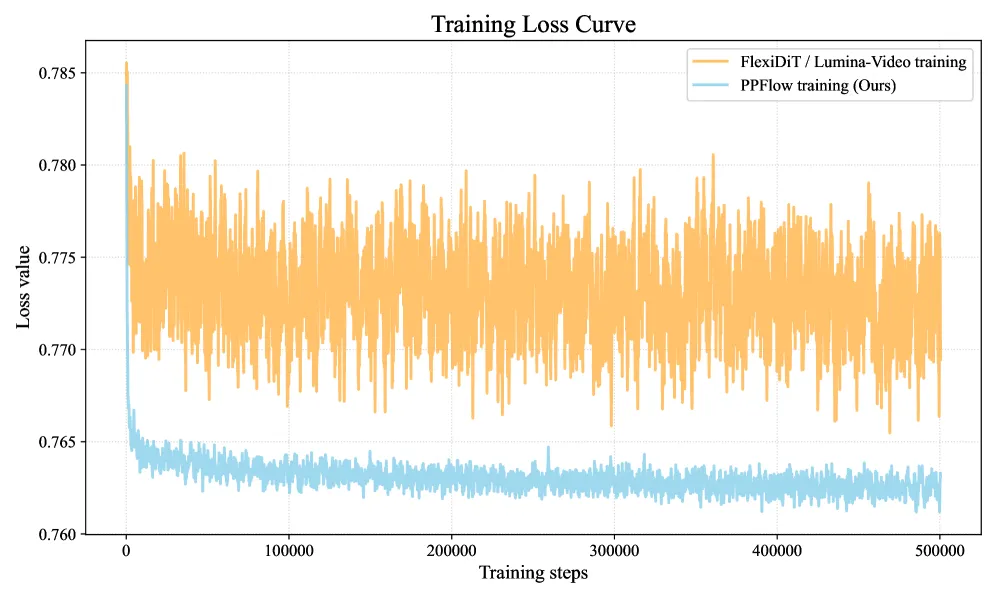
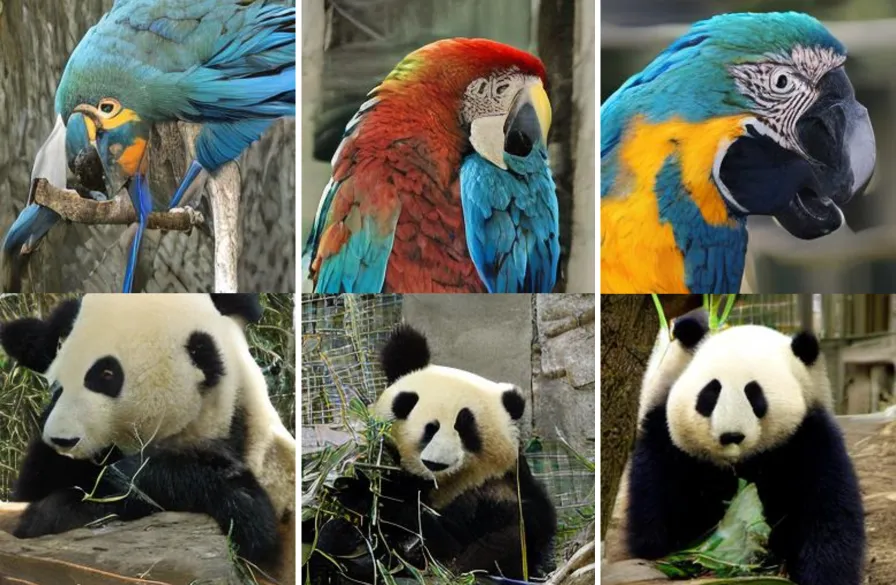
- Lumina-Video 对每 patch size 在所有时间步训练(shift-sampling),导致训练-测试不一致;PPFlow 只训练对应时间步范围,1M 迭代即取得更优结果
- 对比 FlexiDiT(应用于 DiT):约 63% FLOPs 预算下 PPFlow FID 2.15 优于 FlexiDiT 2.25;约 50% FLOPs 下 PPFlow FID 2.31 显著优于 FlexiDiT 2.64
⑥ sFID 讨论:PPFlow 的 sFID 略差于基线(与 sFID 评估的空间敏感性相关)。三点观察:(1) 继续训练至 11M 步 sFID 降至 5.03,接近基线 4.87;(2) 可视化仅有主物体位置/尺寸的轻微空间差异;(3) PPF-FLUX.1 的 GenEval position 指标 (0.20) 与 FLUX.1-ft/FLUX.1 相同,证明不影响位置关系生成质量。
六、总结
核心贡献
- PPFlow:金字塔分块方案,自适应减少高噪声时间步 token 数,同时保持潜表示分辨率跨时间步不变
- 推理与标准 DiT 完全一致:避免 re-noising 与分辨率跳变
- 从头/预训练两种训练机制:均达 1.6×–2.0× 去噪加速且质量可比或更优
- 文生图验证:集成 FLUX.1,近 50% 采样成本降低且质量保持
- 方法简单易实现:仅切换 Patchify/Unpatchify 线性投影
技术影响
- 提供了一个正交于步数削减/蒸馏/压缩的新效率维度(减少每步 token 数),且不破坏轨迹连续性
- 从预训练模型低成本适配的特性对实际部署友好
局限性
- 评估限于类条件与文生图,采用固定手工设计的 stage schedule 与离散 patch size
- 尚未在视频等其他视觉域及不同噪声/solver 设置上验证
- 未来方向:(i) 端到端联合学习 stage 边界与 patch size;(ii) 引入 stage-aware 条件或选择性解耦跨 stage 参数;(iii) 与步数削减/蒸馏/压缩技术结合
七、参考资源
- arXiv: https://arxiv.org/abs/2506.23543
- 代码: https://github.com/fudan-generative-vision/PPFlow
- 关键依赖: SiT / DiT、Flow Matching、FLUX.1-dev、Stable Diffusion VAE
- 对比方法: Pyramidal Flow、PixelFlow、FlexiDiT、Lumina-Video、FlexiViT
图表索引
| 图号 | 描述 | 文件名 |
|---|---|---|
| Figure 1 | PPFlow 效果展示(质量与加速) | figure-1-teaser.png |
| Figure 2 | 概念对比(PPFlow vs 金字塔表示) | figure-2-conceptual-comparison.png |
| Figure 3 | Patchify 操作示意 | figure-3-patchify.png |
| Figure 4 | 金字塔表示+renoising / Lumina-Video / PPF-B 可视化对比 | figure-4-renoising-comparison.png |
| Figure 9 | PPFlow vs FlexiDiT 训练损失对比 | figure-9-training-loss.png |
分析日期: 2026-07-07 分析师: AI Paper Analyzer