LeoAM: Breaking the Boundaries of Long-Context LLM Inference with Adaptive KV Management
面向单个消费级GPU的高效长上下文LLM推理系统,通过自适应分层KV管理实现3.46倍加速
LeoAM: Breaking the Boundaries of Long-Context LLM Inference with Adaptive KV Management
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Breaking the Boundaries of Long-Context LLM Inference: Adaptive KV Management on a Single Commodity GPU |
| 作者 | He Sun, Li Li, Mingjun Xiao, Chengzhong Xu |
| 论文 | arXiv:2506.20187 |
| 发布 | 2025-06-25 (v1), 2025-07-02 (v2) |
| 主题 | cs.OS (Operating Systems); cs.CR (Cryptography and Security) |
| 评论 | Under review |
| 代码 | 基于FlexGen构建,1000+行额外代码 |
二、核心思想
问题定义
长上下文LLM推理在消费级GPU(如PC)上面临严重挑战:
- 内存瓶颈:KV缓存随上下文长度线性增长。例如,使用LLaMA-7B推理64K上下文需要约47GB内存(含33.5GB KV缓存),远超消费级GPU和CPU的容量
- 磁盘I/O瓶颈:当KV数据需要卸载到磁盘时,磁盘的低带宽成为关键瓶颈
- Token重要性评估开销:现有系统需要频繁评估token重要性,计算和传输开销大
关键观察(Figure 2):
- 32K上下文时,Llama-2-7B的KV缓存已超过RTX 4090的GPU内存限制
- 64K上下文时,内存需求超过RTX 4060的GPU+CPU总容量
- 150K上下文时,Llama-2-13B推理需要的内存超过RTX 4090 + 120GB CPU RAM的总容量
解决方案概述
LeoAM是首个面向单个消费级GPU的高效重要性感知长上下文LLM推理系统,采用自适应分层GPU-CPU-Disk KV管理:
- 自适应KV管理(IAKM):基于注意力权重的偏斜分布,将KV数据划分为可变大小的chunk,减少计算和传输开销
- 轻量级KV摘要(LKA):在磁盘上存储和提取每个chunk的KV摘要,而非完整KV数据,最小化传输延迟
- 动态三级流水线(DTP):利用动态压缩和流水线技术进一步加速推理
三、技术架构
整体框架图
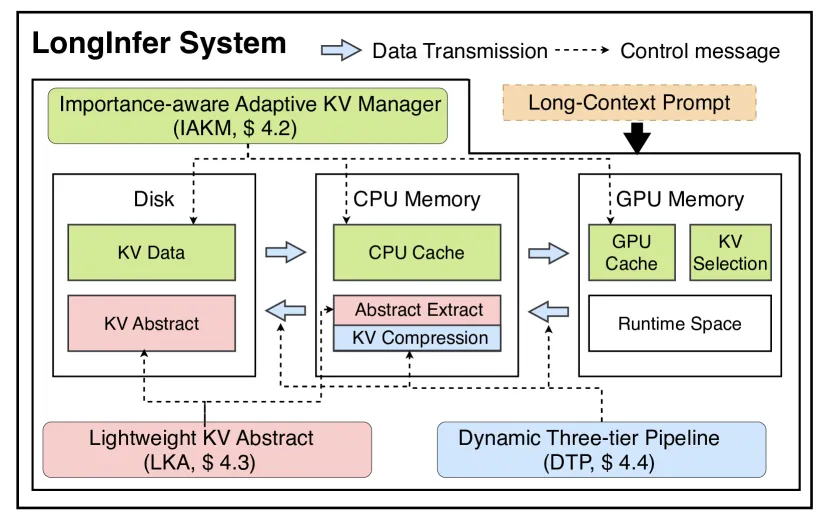
Figure 9: LeoAM系统概述。KV数据分布在GPU缓存、CPU缓存和磁盘三级存储中。
核心挑战
Challenge 1: Token稀疏性
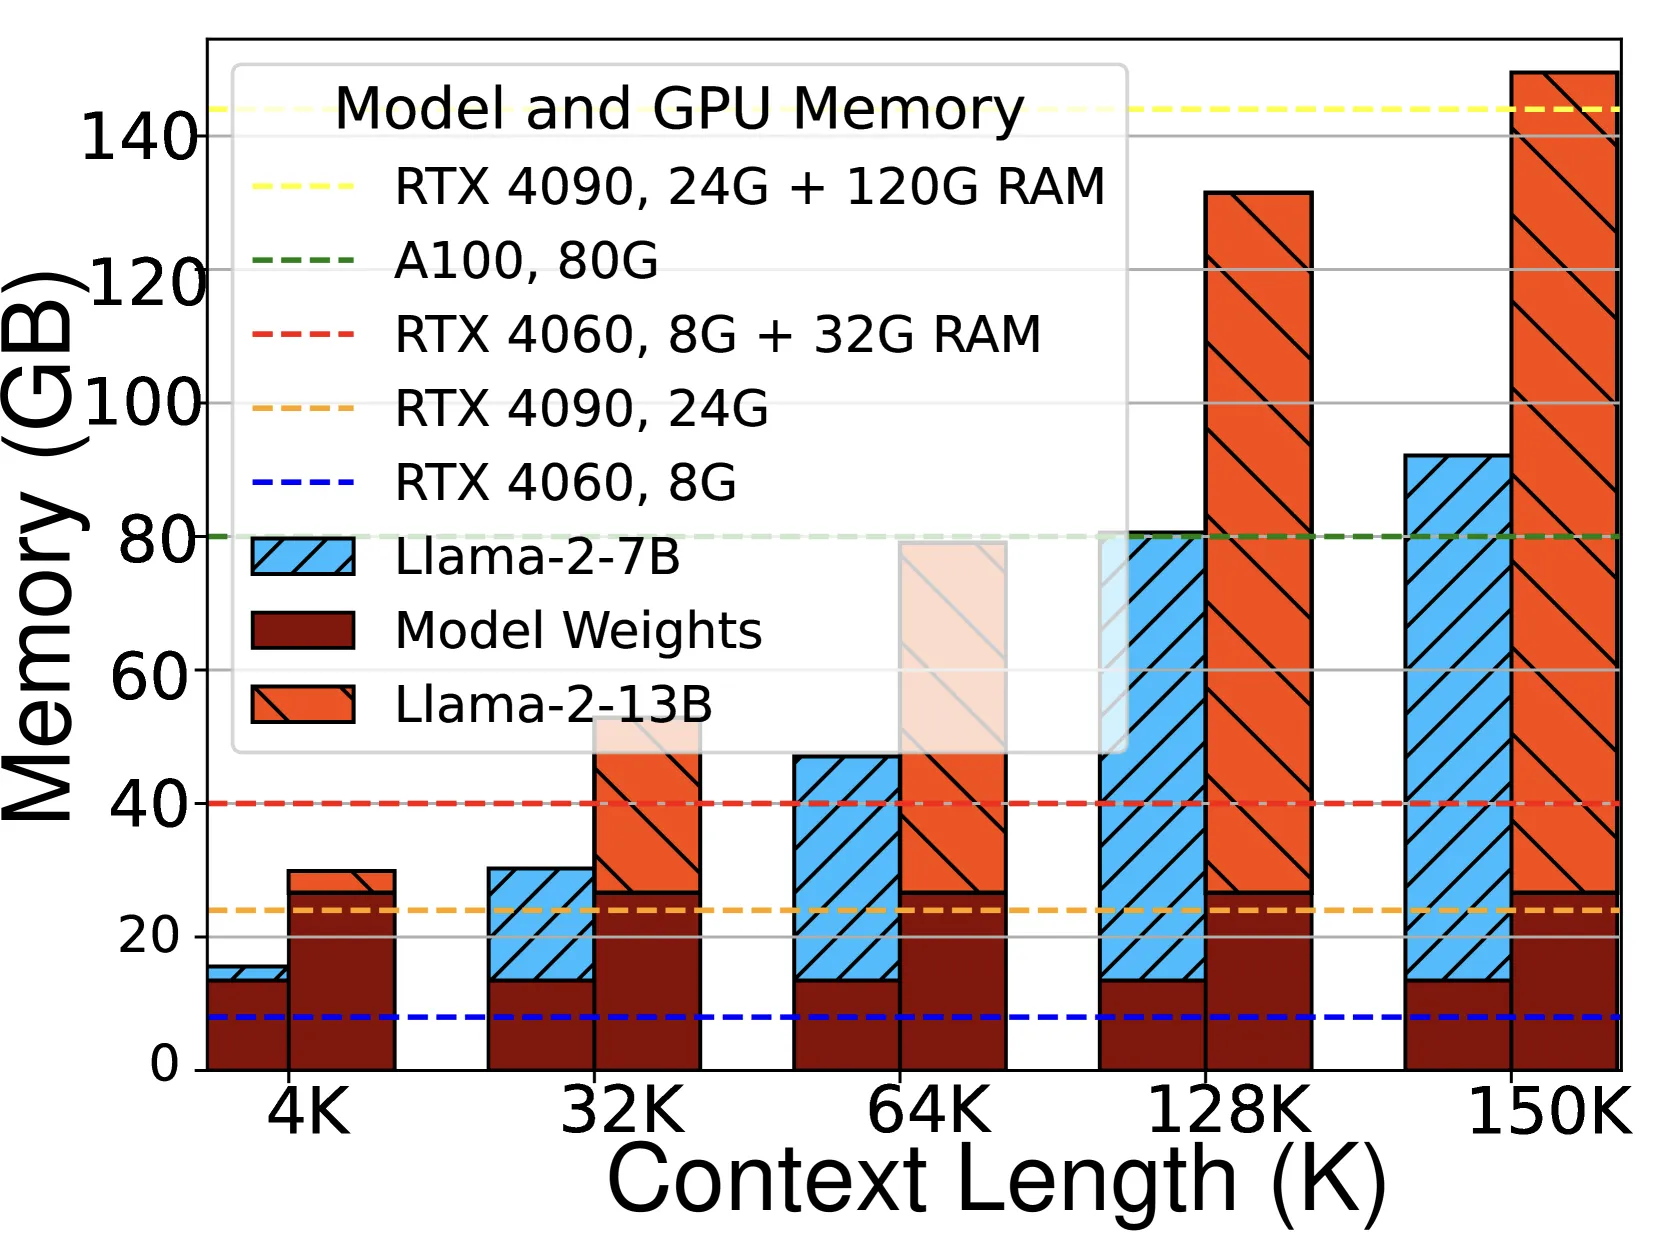
Figure 3: Token属性。左图显示仅20%的KV张量在注意力计算中起主导作用。右图显示不同token在不同解码轮次中的注意力权重。
Challenge 2: Token评估开销
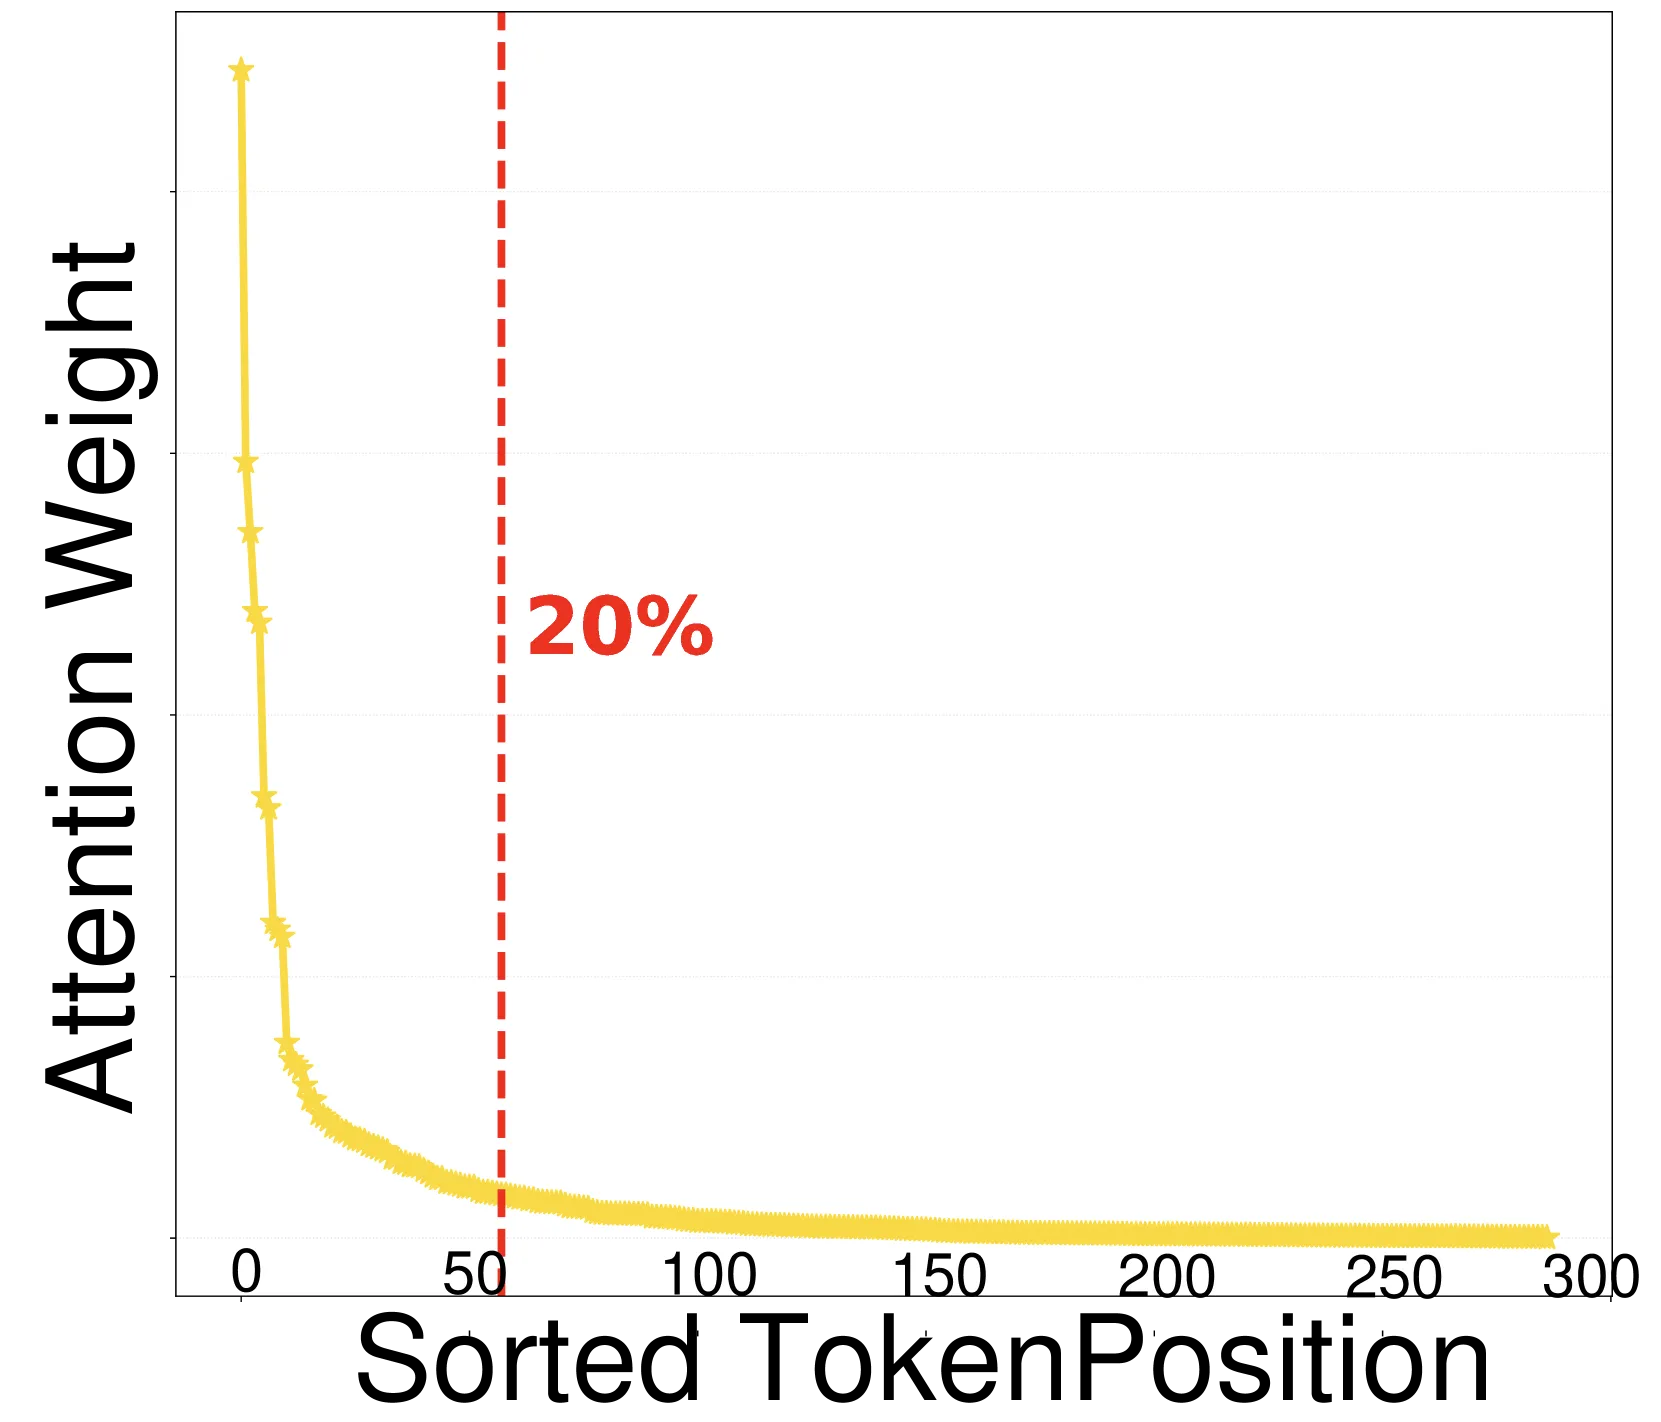
Figure 4: Token级别的评估开销。使用OPT-2.7b在LongBench上评估token重要性评估的延迟开销和计算延迟。
Challenge 3: Chunk/Page中重要Token比例
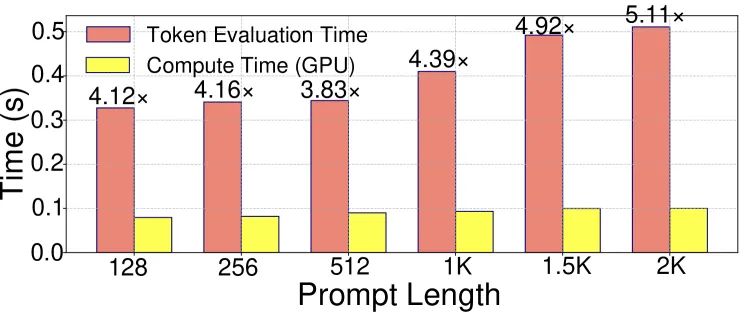
Figure 5: 每个Chunk/Page中Top 20% Token的比例。红色部分代表正确识别的重要KV;灰色部分代表冗余但被识别为重要的KV。
Challenge 4: I/O瓶颈
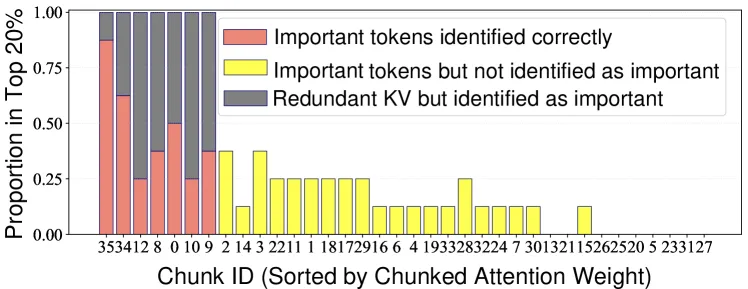
Figure 6: GPU-CPU-Disk卸载中数据传输的I/O瓶颈。
Challenge 5: 注意力沙漠现象
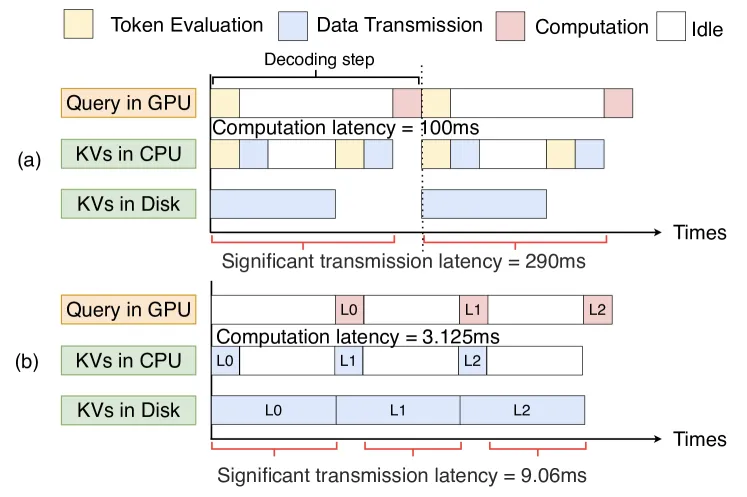
Figure 7: 跨解码步骤的注意力沙漠率。
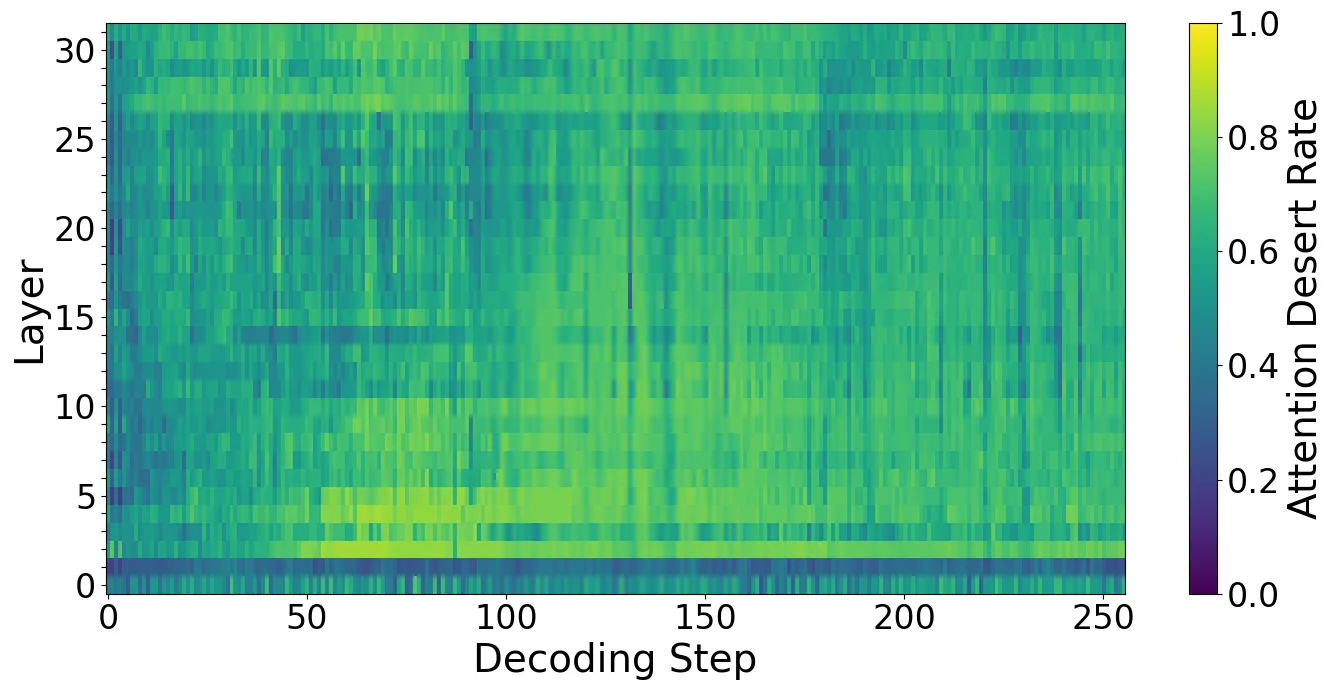
Figure 8: 跨层和解码步骤的注意力沙漠率热力图。
核心组件
组件1: 重要性感知自适应KV管理器(IAKM)
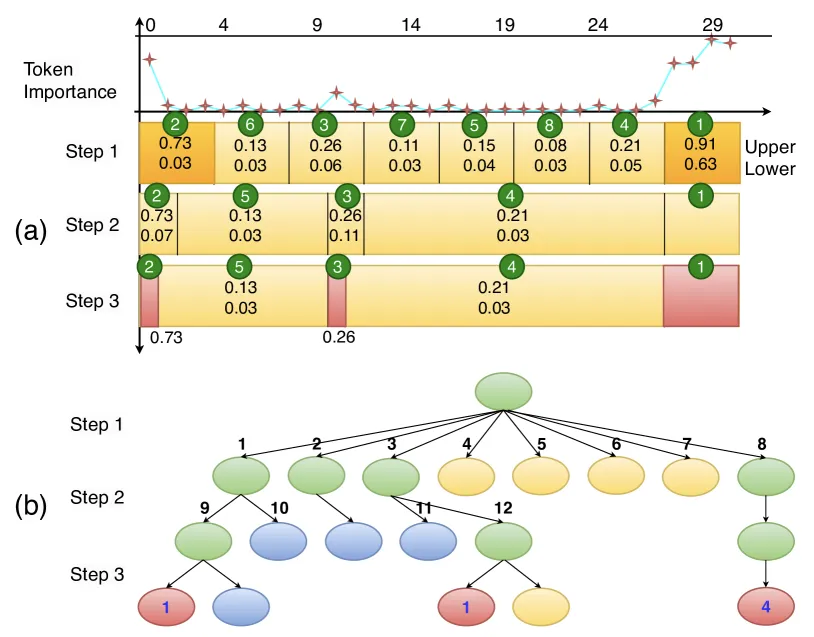
Figure 10: 树状结构KV chunk管理:(a) 橙色和红色chunk表示识别出的重要chunk(无/有此方法)。(b) chunk合并和分裂操作的树状形式。
设计要点:
- 基于注意力权重偏斜分布,自适应调整KV chunk大小
- 使用chunk级别的token重要性上界代表整体chunk重要性
- 初始chunk大小为64 tokens,在早期两层和解码步骤中调整为8 tokens
组件2: 轻量级KV摘要(LKA)
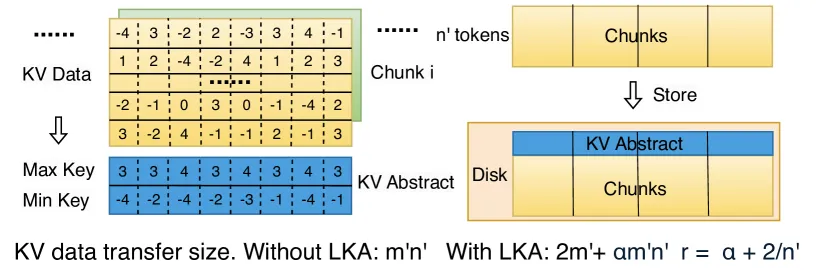
Figure 11: 轻量级KV摘要:假设磁盘上有m’个chunk,每个chunk包含n’个token的KV数据。LKA存储每个chunk的KV摘要而非完整KV数据。
设计要点:
- 在磁盘上存储KV摘要而非完整KV数据
- 传输摘要数据进行重要性评估,减少传输量
- 摘要数据量远小于原始KV数据
KV管理流程
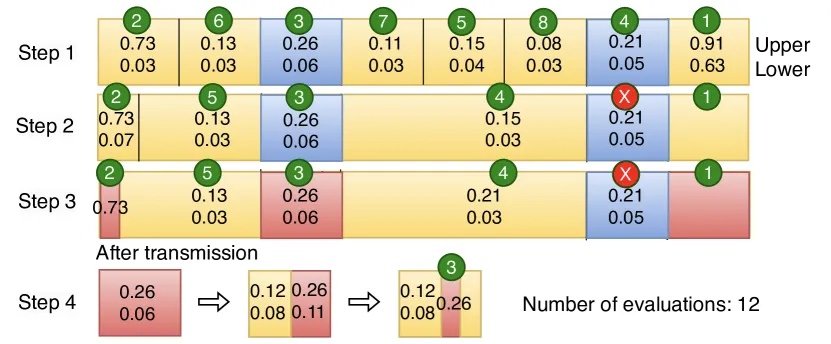
Figure 12: LKA下的KV管理。黄色和蓝色chunk分别代表CPU/GPU中存储的KV数据和磁盘上的KV摘要。
组件3: 动态三级流水线(DTP)
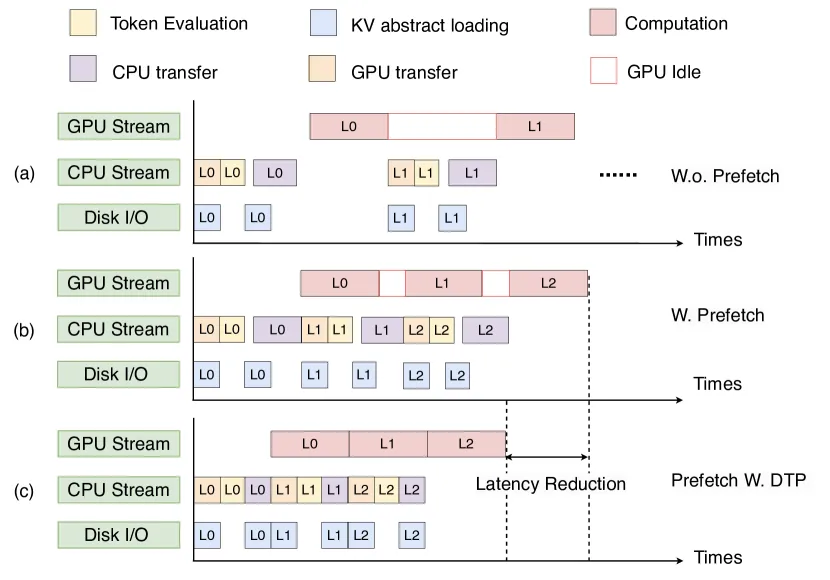
Figure 13: 无预取和有预取+DTP技术的解码阶段延迟(3层)。L_x表示第x层。
设计要点:
- 流式压缩和传输数据,减少通信延迟
- 根据三级缓存层次特性,流水线化传输和计算
- 动态控制KV压缩以最小化整体推理延迟
工作流程
Prefilling阶段:
- 完成计算,将本地需要的KV数据存储在GPU和CPU中
- 剩余KV数据按初始chunk大小分区存储在磁盘上
- LKA对磁盘上的KV数据生成摘要并存储
Decoding阶段:
- IAKM自适应分区GPU和CPU中的KV数据,执行重要性评估
- LKA提取KV摘要,CPU基于摘要评估磁盘上KV数据的重要性
- 聚合评估结果用于KV选择,执行后续解码计算
- DTP执行流式压缩和传输,流水线化传输和计算
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 自适应KV Chunk管理 | 基于注意力权重偏斜分布,动态调整chunk大小 | 减少评估开销和传输量 |
| 轻量级KV摘要 | 存储chunk摘要而非完整KV数据 | 最小化磁盘到CPU的传输延迟 |
| 动态三级流水线 | 流式压缩+传输+计算重叠 | 隐藏I/O延迟 |
| 注意力沙漠检测 | 识别不再需要的KV数据 | 减少不必要的数据传输 |
五、实验结果
实验设置
- 硬件:
- RTX 4090 GPU (24GB)
- Intel Core i7-14700K CPU
- 120GB主机内存
- 800GB Intel SSD (读取吞吐量约7GB/s)
- PCIe 4.0接口
- 模型:
- longchat-7B-v1.5-32k
- yarn-llama-2-13B-128k
- OPT-6.7B
- KV缓存:FP16存储,INT4压缩
- 基线:
- H2O-like(token级别评估)
- H2O-like-chunked(chunk级别评估)
- Prefetch-based(类似InfiniGen)
- 数据集:OpenBookQA, PIQA, RTE, COPA, PG-19, LongBench
模型精度
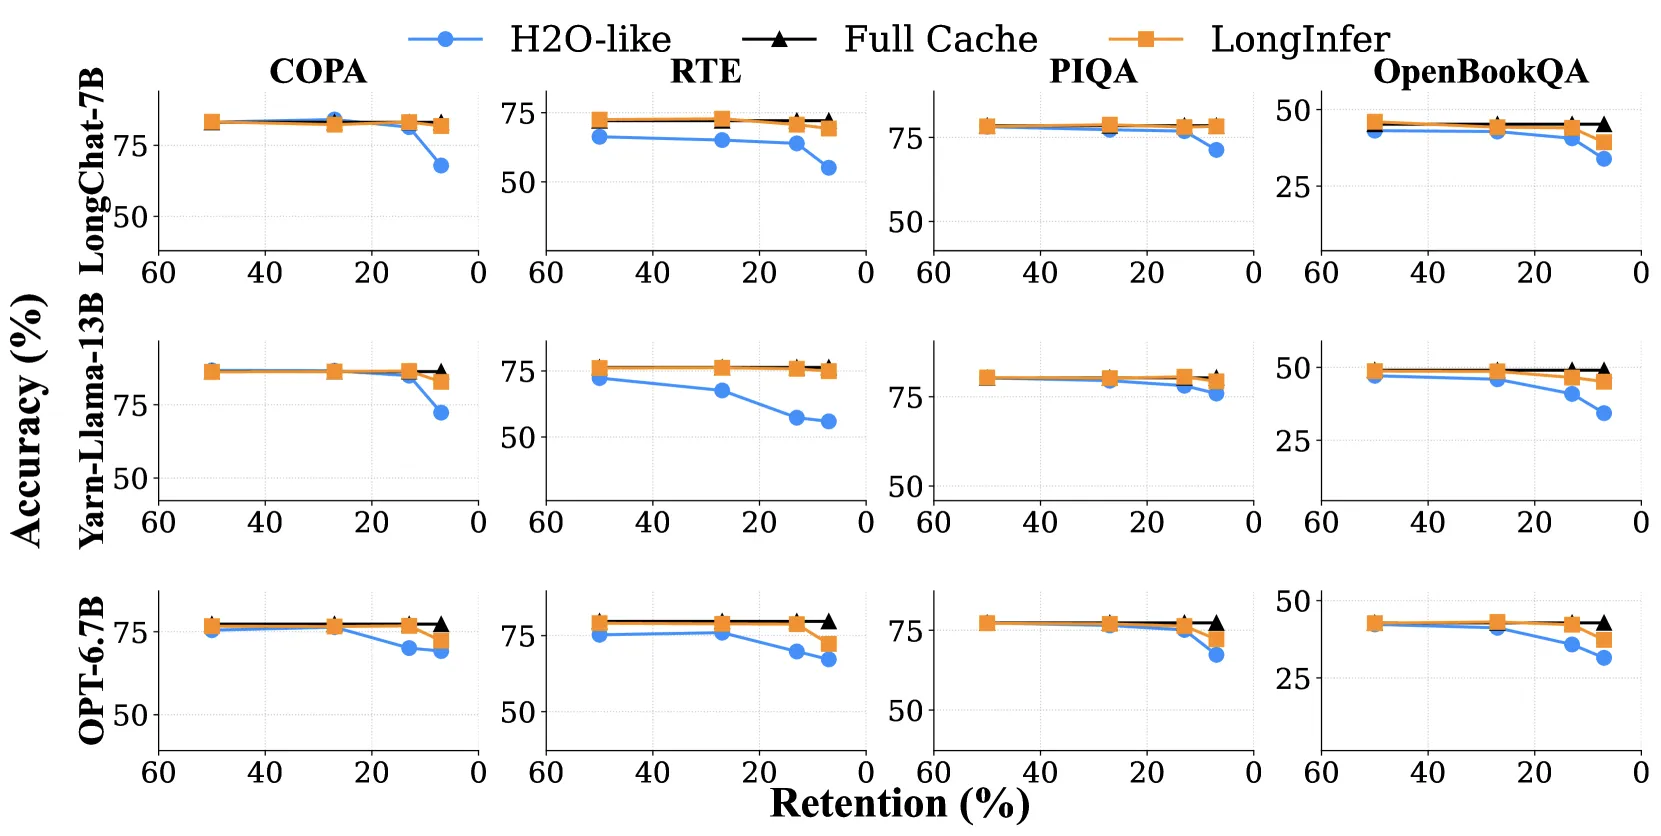
Figure 14: 不同系统在四个数据集和三个模型上,在不同相对KV缓存大小下的精度。
关键发现:
- LeoAM相比基线精度损失不超过1%
- 较小的相对KV缓存大小会导致更大的精度下降
- 需要确定合适的KV缓存比例
推理延迟
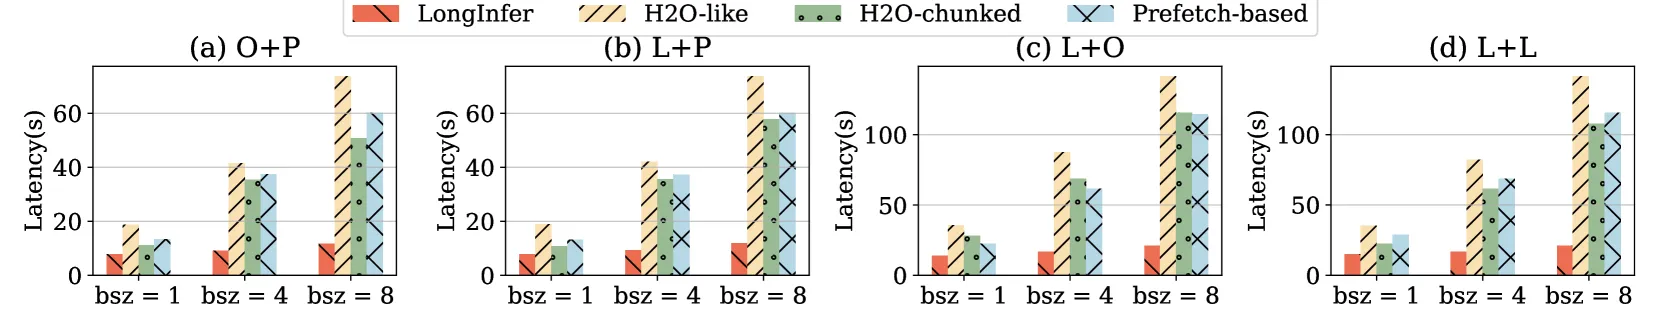
Figure 15: 不同系统在两个数据集和三个batch size下的推理延迟对比。O: OPT-6.7B, L: LongChat-7B, P: PG-19, L: LongBench。
关键结果:
- 平均推理延迟加速3.46倍
- Batch size=8时,加速5.47倍
- 随batch size增加,KV数据量增大,加速效果更明显
技术分解
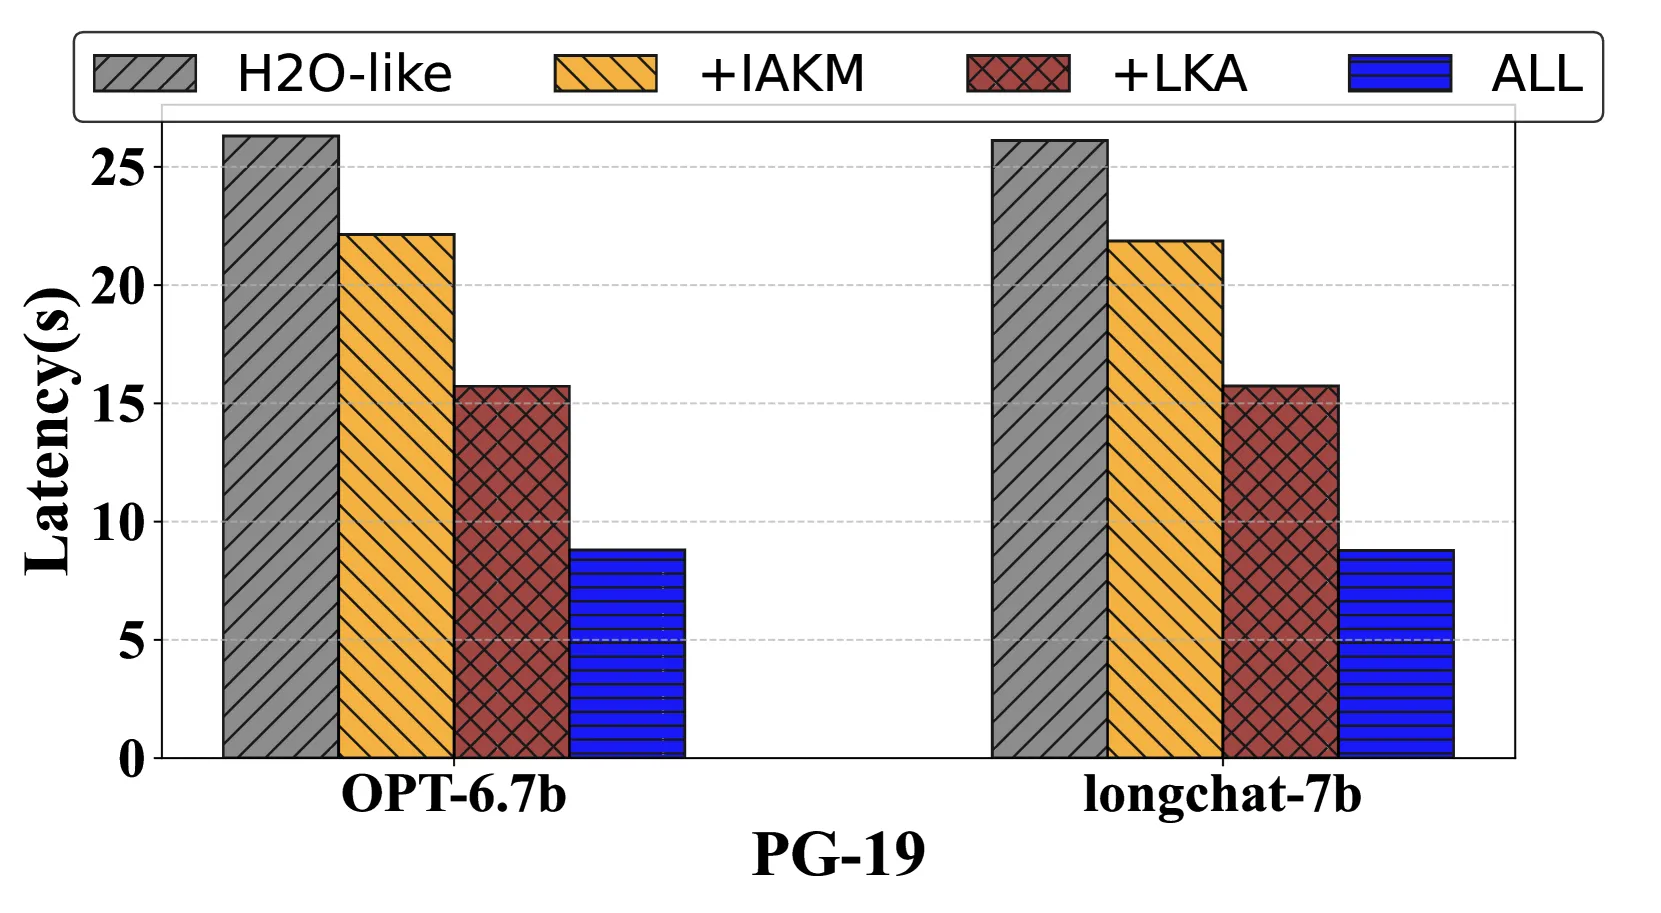
Figure 16: 各技术的延迟性能分解。
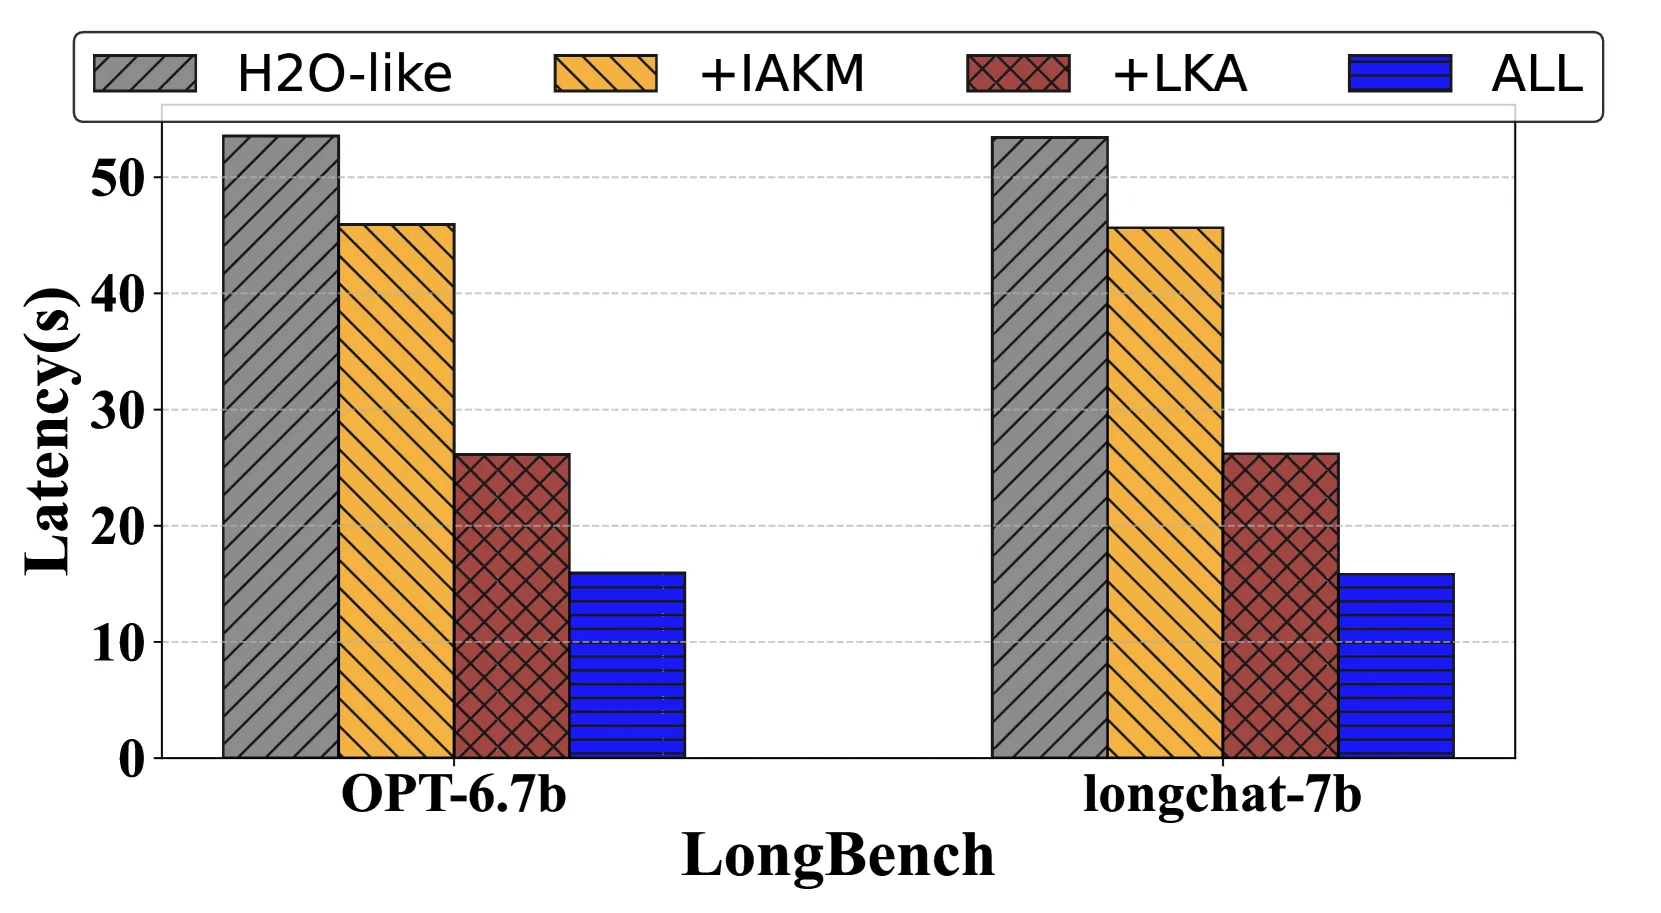
Figure 17: 各技术的吞吐量性能分解。
关键发现(PG-19和LongBench数据集):
- IAKM:延迟改善15.8%和14%
- LKA:延迟改善40%和51.2%
- ALL(完整LeoAM):延迟改善66%和70%
吞吐量
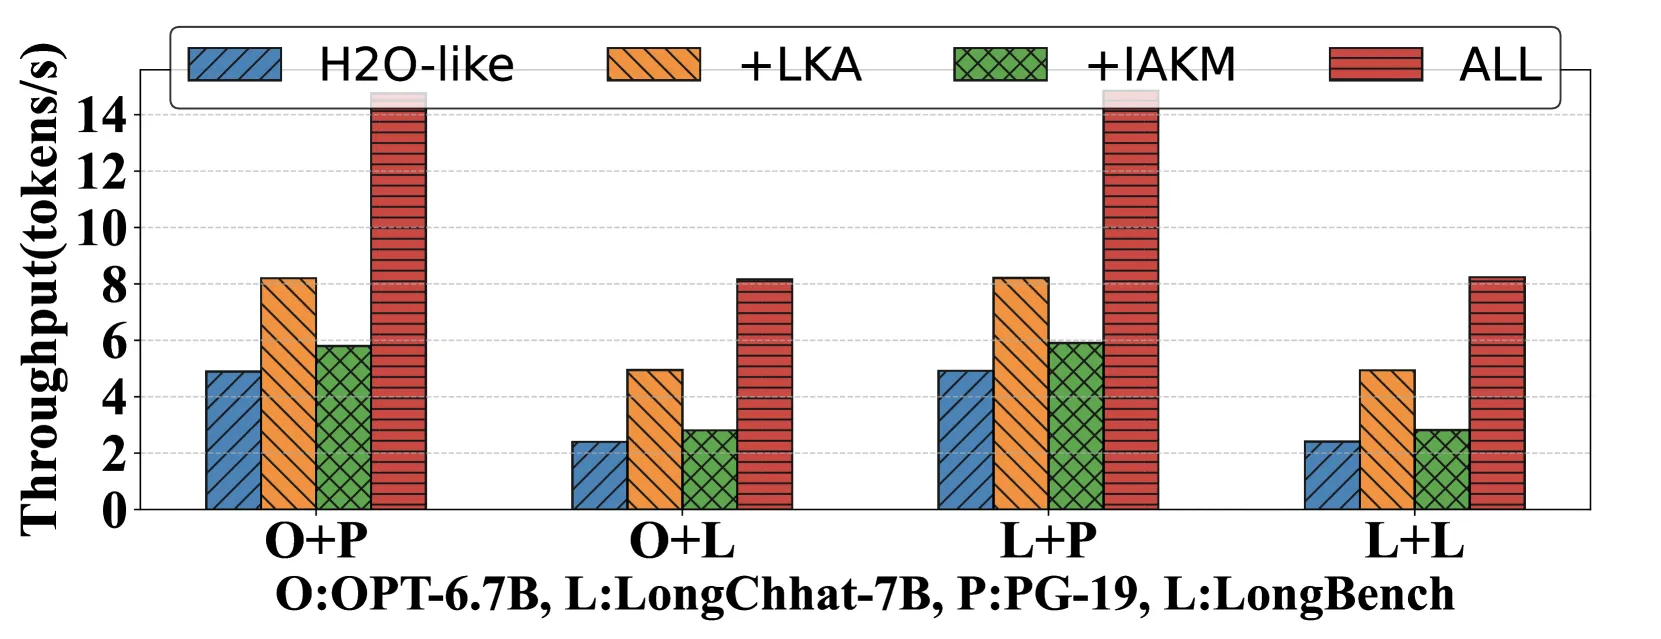
Figure 17: 不同模型和数据集下的吞吐量。
Chunk大小敏感性
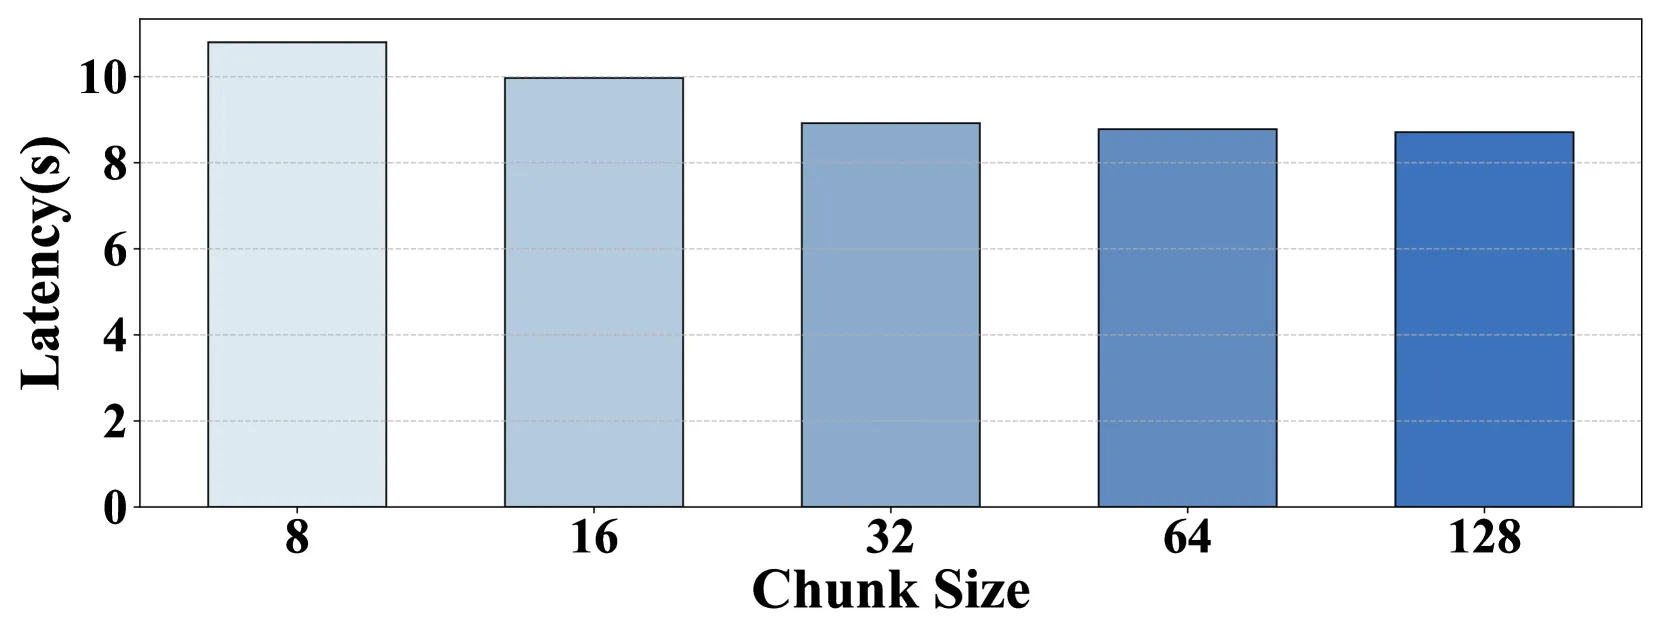
Figure 18: 不同chunk大小下的延迟性能。
Batch大小影响
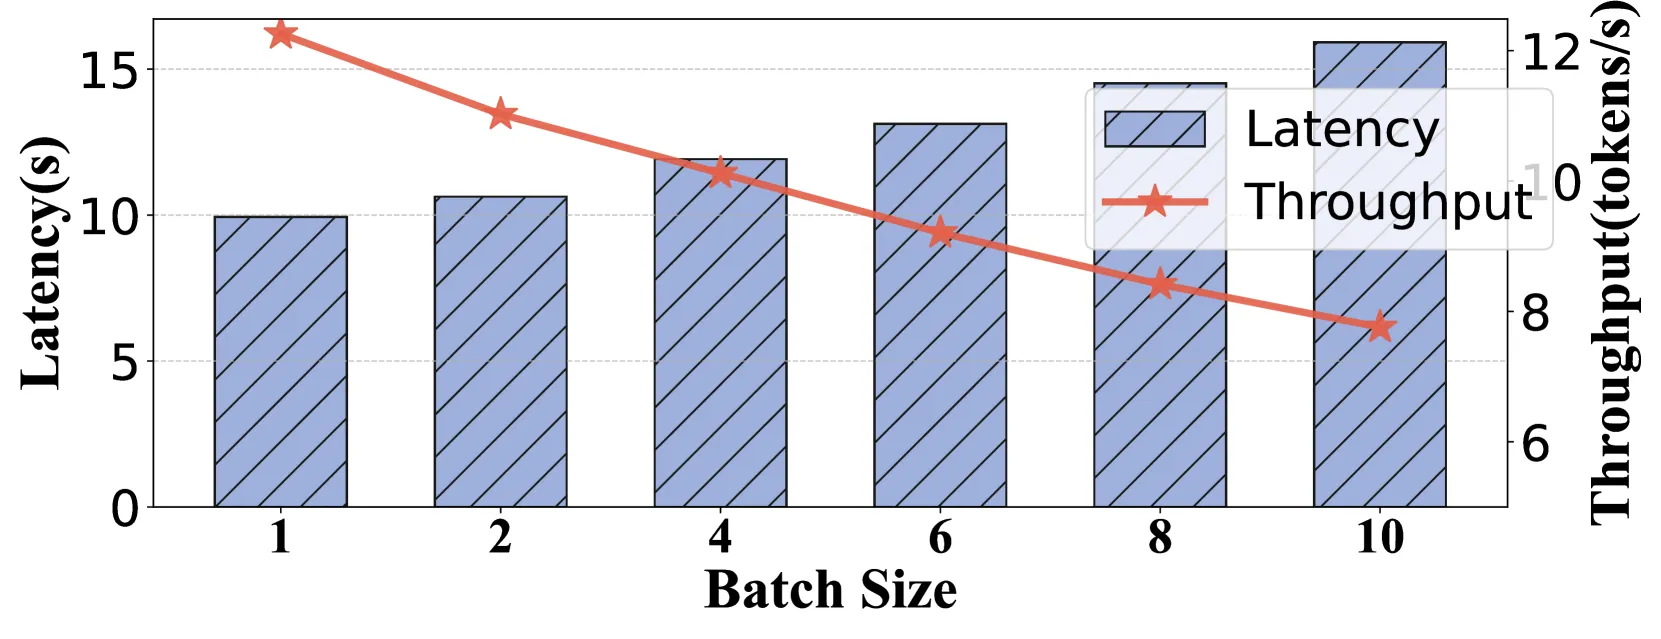
Figure 19: 不同batch大小下的延迟和吞吐量性能。
六、相关工作
| 方法 | 特点 | LeoAM优势 |
|---|---|---|
| H2O | Token级别重要性评估 | Chunk级别评估,开销更低 |
| InfiniGen | Prefetch优化 | LKA减少传输量 |
| FlexGen | KV数据卸载框架 | 自适应chunk管理+LKA |
| StreamingLLM | 注意力流式处理 | 支持完整长上下文 |
七、总结
核心贡献
- 首个面向消费级GPU的长上下文LLM推理系统:支持在单个RTX 4090上进行长上下文推理
- 自适应KV Chunk管理:基于注意力权重偏斜分布动态调整chunk大小,减少评估开销
- 轻量级KV摘要:存储chunk摘要而非完整KV数据,最小化传输延迟
- 动态三级流水线:流式压缩+传输+计算重叠,隐藏I/O延迟
性能总结
| 指标 | 提升 |
|---|---|
| 平均推理延迟 | 3.46倍加速 |
| Batch size=8推理延迟 | 5.47倍加速 |
| 精度损失 | <1% |
| LKA延迟改善 | 40-51.2% |
| 完整系统延迟改善 | 66-70% |
技术影响
LeoAM展示了分层KV管理对消费级硬件上长上下文LLM推理的重要性:
- 内存管理:需要根据token重要性动态分配KV存储
- 传输优化:KV摘要比完整数据传输更高效
- 流水线化:传输和计算重叠可以隐藏I/O延迟
实现细节
- 基于FlexGen框架构建,增加1000+行代码
- 支持大多数开源模型(Llama, LongChat, LongLora等)
- 初始chunk大小64 tokens,早期层和解码步骤调整为8 tokens
- 默认加载10%最重要的KV数据,前两层加载50%
八、参考资源
- 论文: arXiv:2506.20187
- 相关框架: