Chelsea: Efficient Long-Context LLM Inference via KV Cache Clustering
基于分块软匹配的在线KV缓存聚类框架,实现80%内存节省和3.19倍解码加速
Chelsea: Efficient Long-Context LLM Inference via KV Cache Clustering
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Efficient Long-Context LLM Inference via KV Cache Clustering |
| 作者 | Yingfa Chen, Yijun Liu, Zhen Leng Thai, Xu Han, Zhiyuan Liu, Maosong Sun |
| 论文 | arXiv:2506.11418 |
| 发布 | 2025-06-12 (v1), 2025-06-16 (v3) |
| 主题 | cs.CL (Computation and Language) |
二、核心思想
问题定义
长上下文LLM推理面临KV缓存的双重挑战:
- 内存瓶颈:KV缓存随上下文长度线性增长,成为内存瓶颈
- 延迟瓶颈:自回归生成需要访问整个KV缓存,成为推理延迟瓶颈
关键观察
观察1:Key状态在序列维度上呈现高相似性
- Token之间存在高余弦相似度
- 相似token倾向于聚集在局部区域
观察2:Token距离与相似度呈凸单调递减
- 随着token距离增加,余弦相似度单调递减
- 这种关系呈凸函数形状
观察3:不同层和头的行为不均匀
- 初始层相似度较低
- 某些注意力头对聚类更敏感(outlier heads)
解决方案概述
Chelsea是一个简单有效的在线KV缓存聚类框架,核心创新是分块软匹配(Chunked Soft Matching)算法:
- 将序列分块,保留attention sinks和recent tokens
- 在每个chunk内使用交替分区策略
- 跨chunk识别高相似token对形成聚类
- 将聚类内的key和value合并为单一中心
三、技术架构
整体框架图
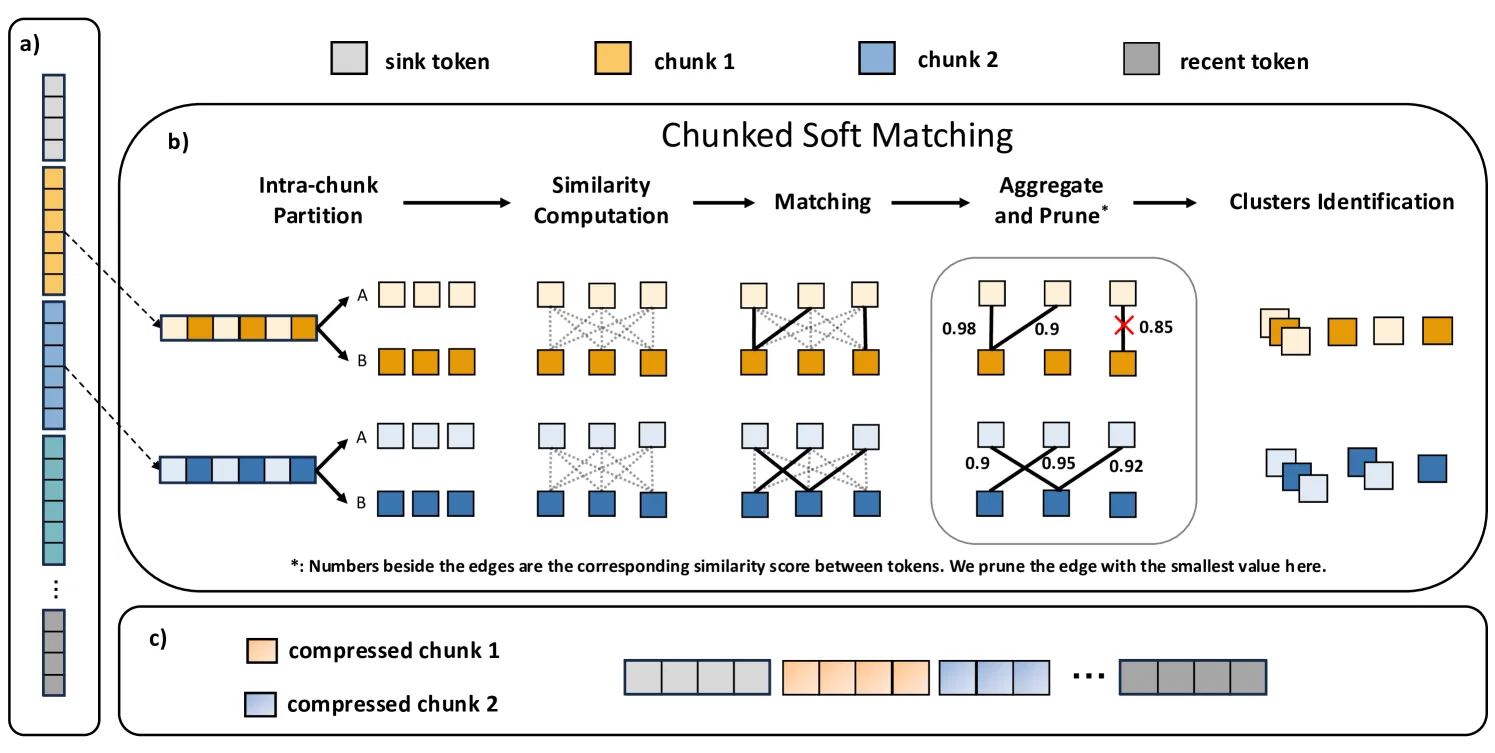
Figure 1: Chelsea概述:a) 将序列分块;b) 分块软匹配识别聚类;c) 聚类后KV缓存压缩。
核心观察
观察1:Key状态相似性
Figure 2: 不同层和头的key状态余弦相似度图。
观察2:距离-相似度关系
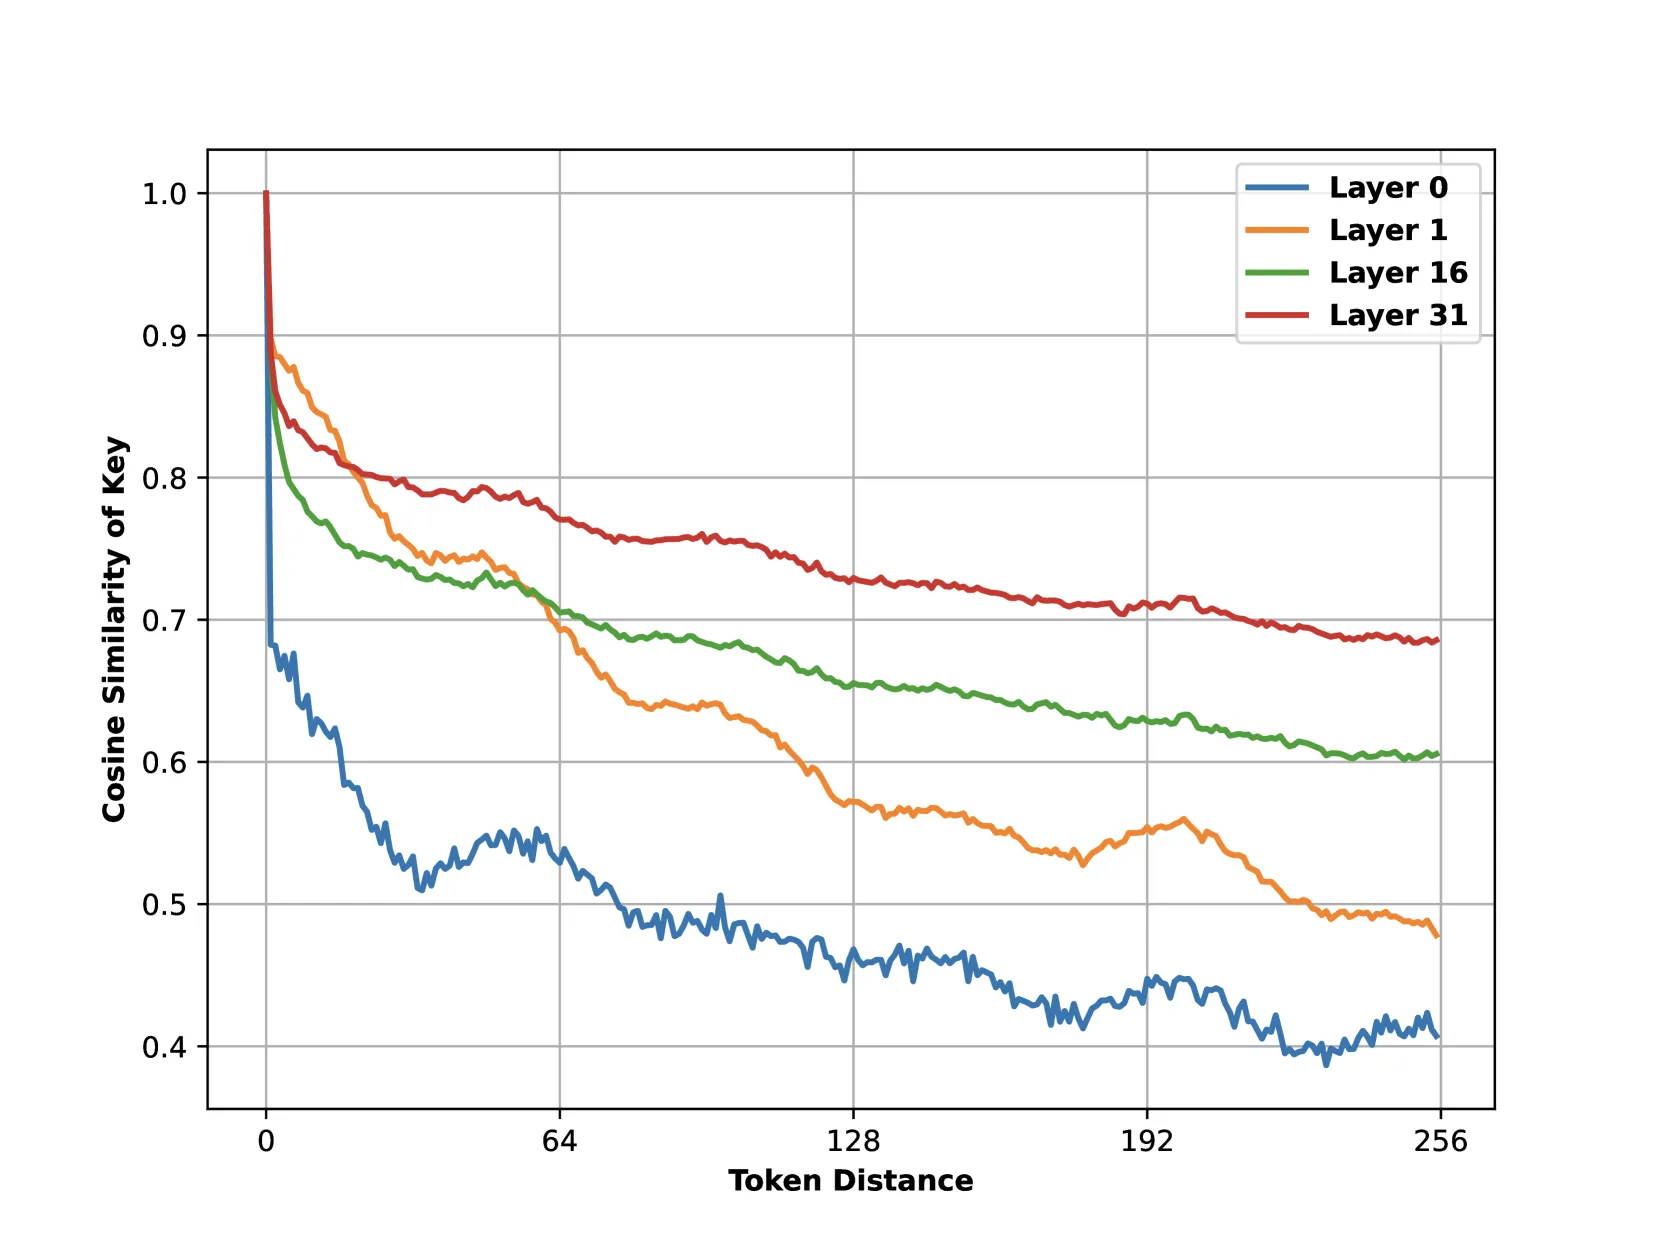
Figure 3: Token距离与key状态余弦相似度的相关性。
核心公式
注意力计算(原始):
聚类后注意力近似:
其中:
- :聚类中心
- :聚类度(每个聚类的token数)
- :聚类数量
带聚类度的注意力:
算法流程
Algorithm 1: Chelsea推理管线
输入: 缓存比例R, 压缩比r, 最大解码长度Γ, attention sink n1, recent预算n2, 步长g, chunk大小c

预填充: Q,K,V ∈ R^{n×d}
初始化: 缓存长度s=n, 聚类度N=[1]·n, 缓存预算B=R·(n+Γ)

输出: O = FlashAttn(Q,K,V)

如果 s ≥ B+g:
    K,V,N,s = Chelsea(K,V,N,s,n1,n2,r,c)

对于 i=1...Γ-1:
    解码状态 q,k,v ∈ R^{1×d}
    更新: K=[K,k], V=[V,v], N=[N,1], s=s+1
    输出: O = Softmax(qK^T/√d + log N)V

    如果 s ≥ B+g:
        K,V,N,s = Chelsea(K,V,N,s,n1,n2,r,c)
分块软匹配算法
步骤1:序列分块
- 将序列分为大小为c的chunk
- 保留attention sinks(前n1个token)和recent tokens(后n2个token)
步骤2:交替分区
- 每个chunk内按交替方式分为集合A和B
- 理论证明:对于凸单调递减的相似度函数,交替分区是最优的
步骤3:软匹配
- 在集合A和B之间找到最高相似度的token对
- 形成聚类集合
步骤4:合并
- 将聚类内的key和value合并为单一中心
- 聚类度n_t记录每个聚类的token数
理论分析
定理6.1:定义分区集 。如果函数 满足 ,则:
计算复杂度:
| 方法 | 距离矩阵复杂度 |
|---|---|
| K-Means | O(nkd · i) |
| KVMerger | O(n²d) |
| Chelsea | O(nd) |
其中n是序列长度,d是隐藏维度,k是聚类中心数,i是迭代次数。
Outlier Heads处理
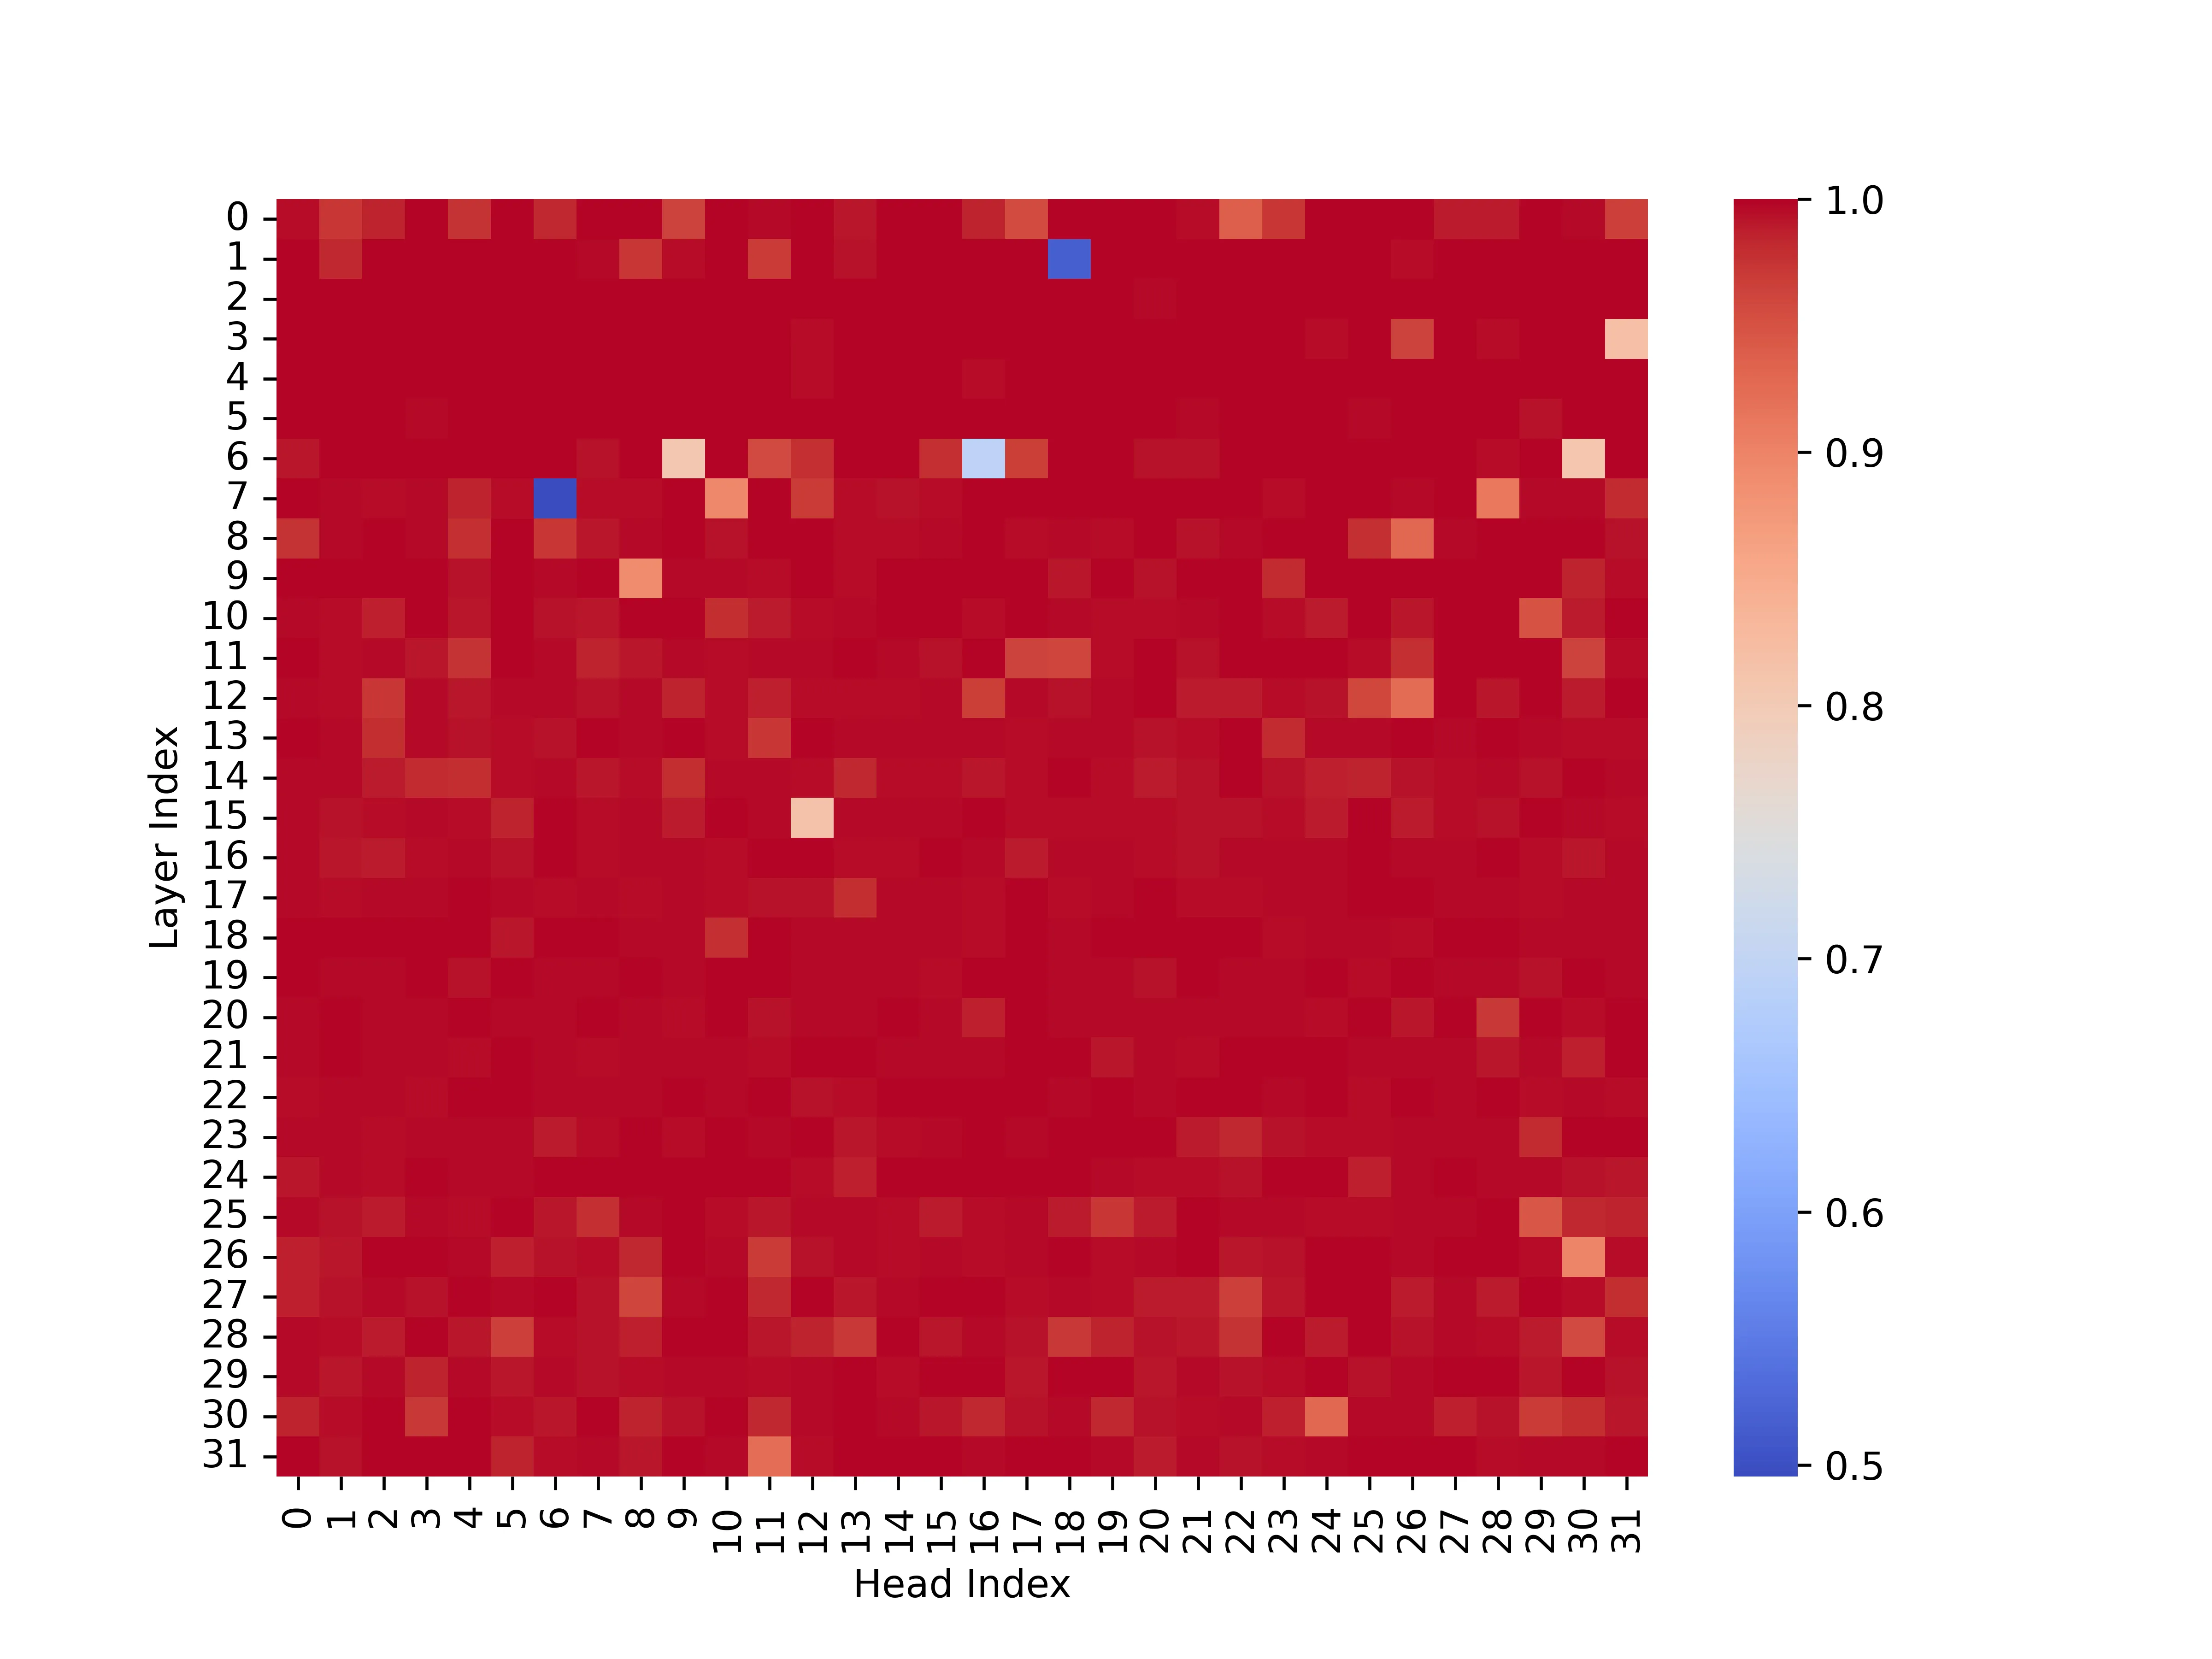
Figure 6: Llama2-7b-32K的outlier heads。
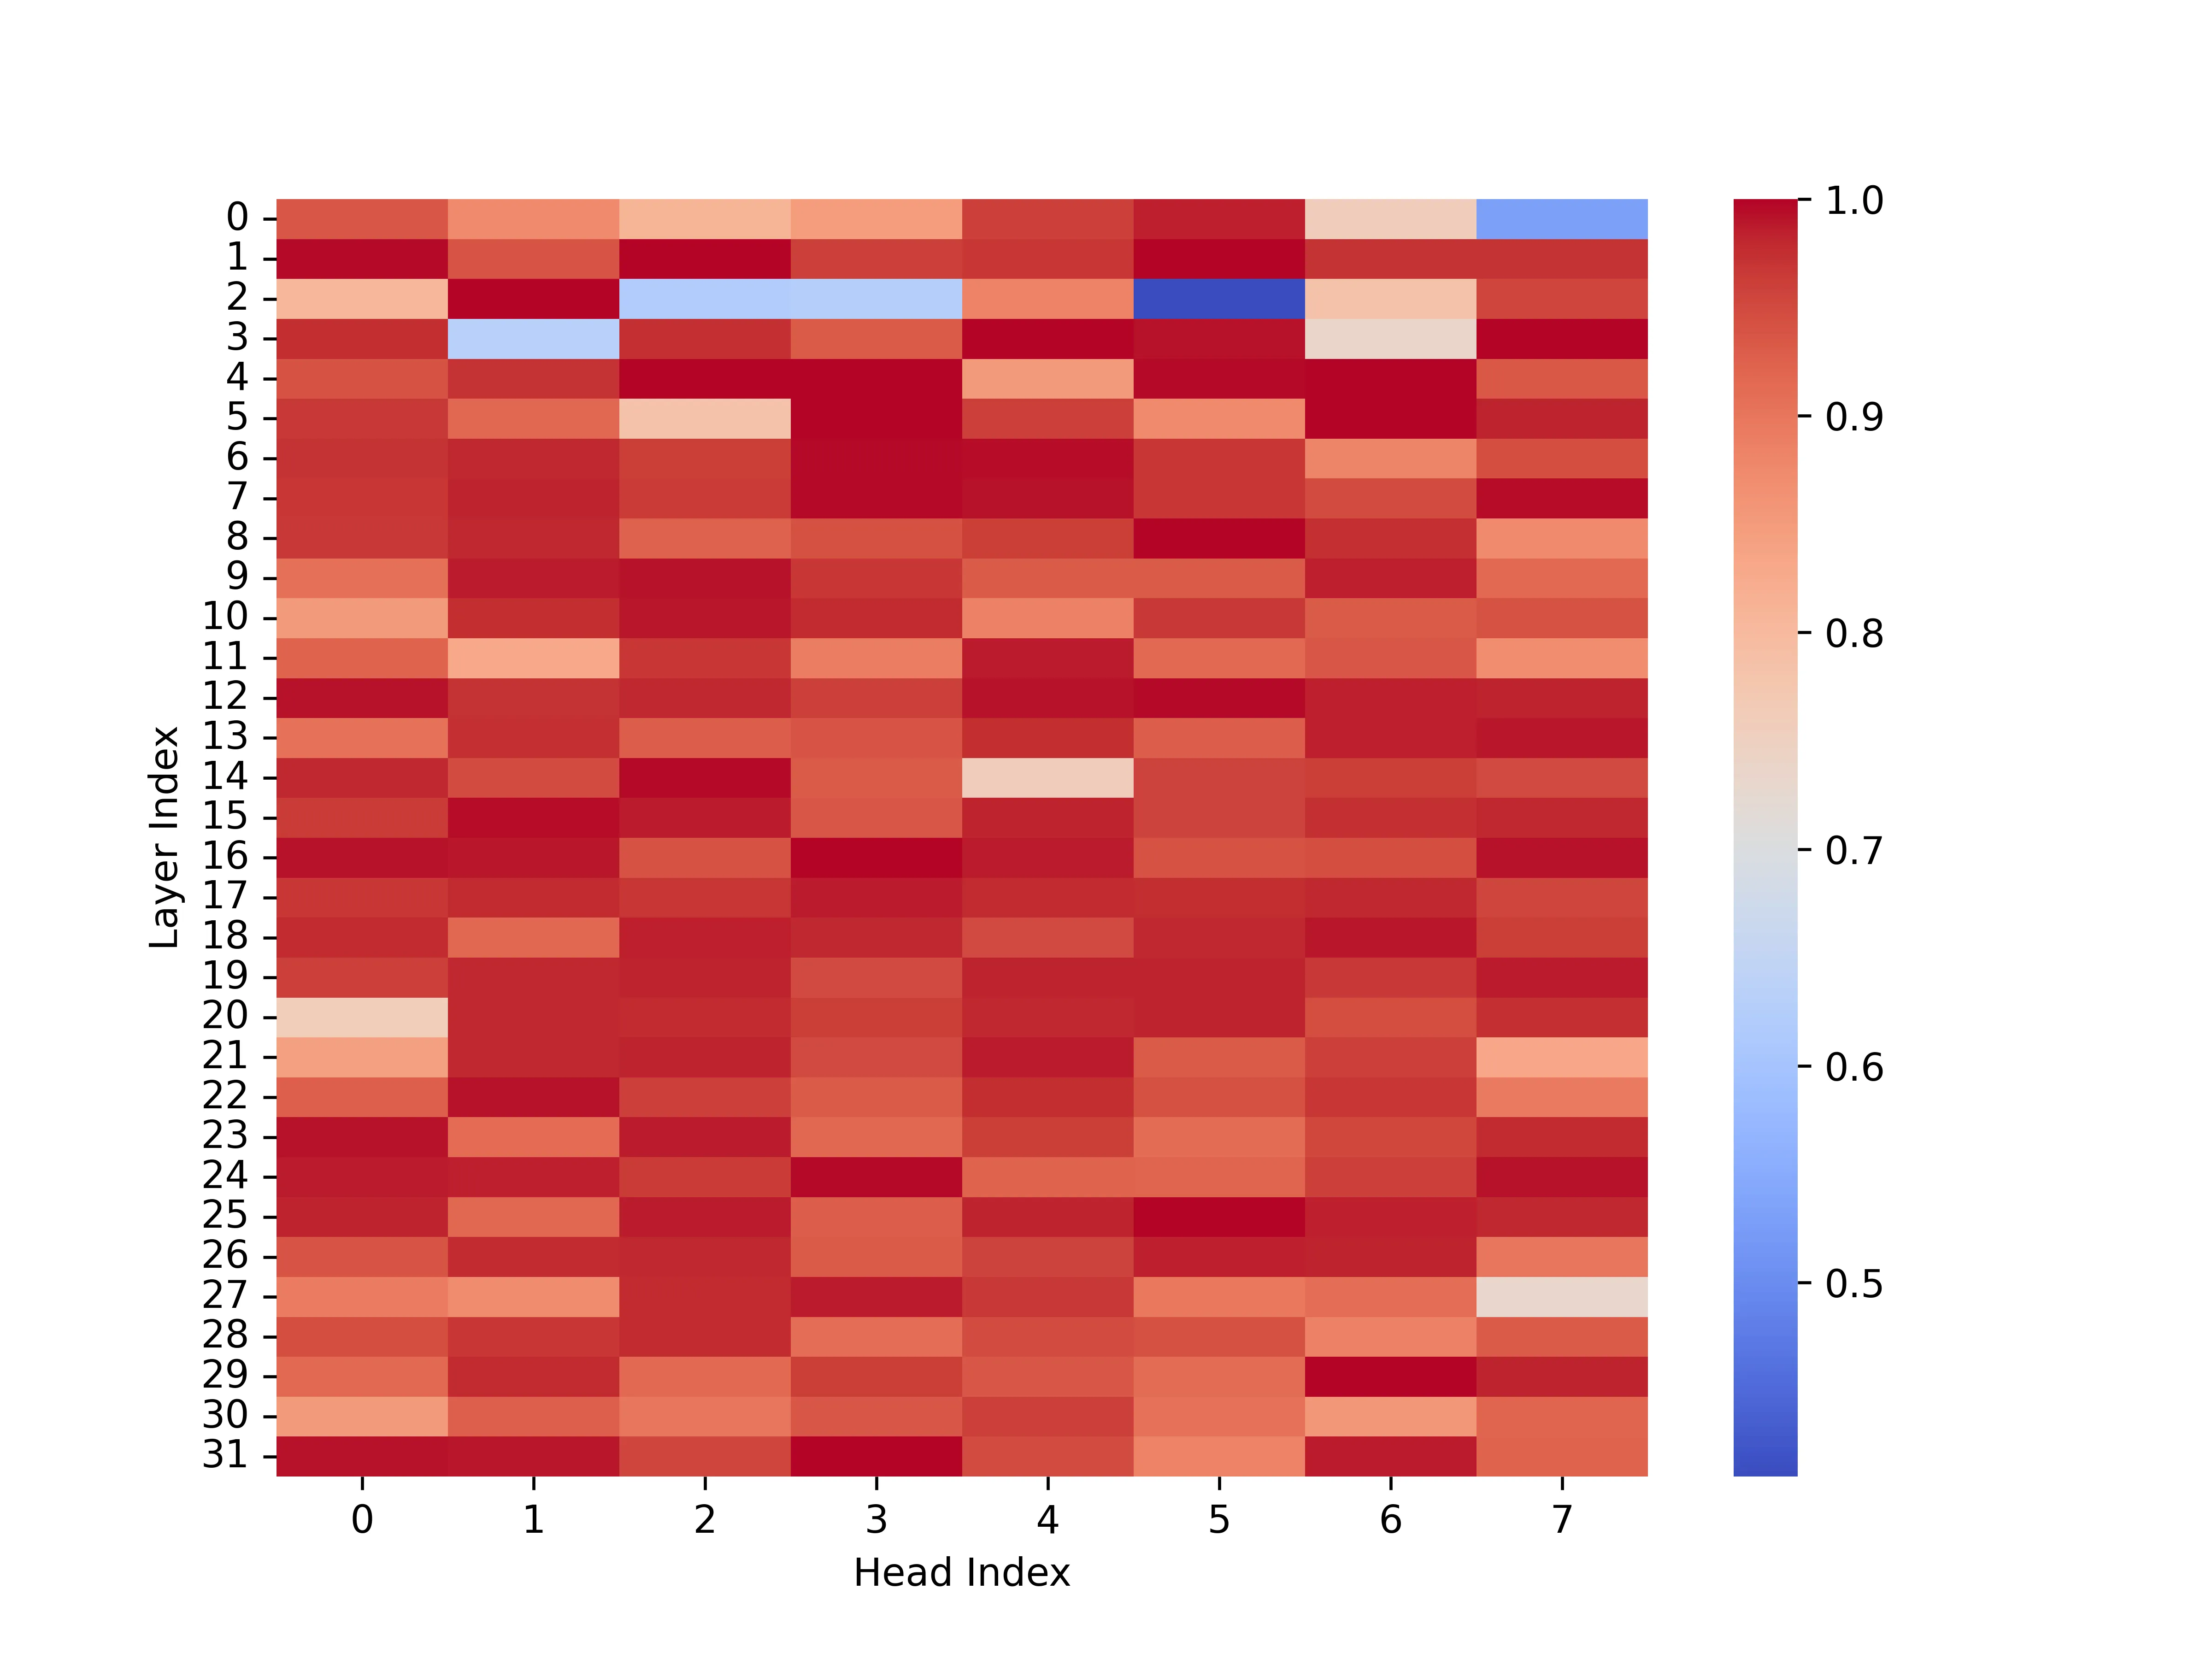
Figure 7: Llama3.1-8b-Instruct的outlier heads。
关键发现:
- 不同层和头对聚类的敏感度不同
- Outlier heads需要特殊处理以保持性能
- 仅4%的头被识别为outlier heads
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 分块软匹配算法 | 首次将Bipartite Soft Matching应用于KV缓存聚类 | 计算复杂度O(nd),远低于K-Means |
| 交替分区策略 | 理论证明最优性 | 定理6.1证明凸函数下的最优性 |
| Outlier Heads识别 | 动态识别敏感注意力头 | 仅4%的头需要特殊处理 |
| 轻量级设计 | 即插即用,最小计算开销 | 不影响预填充阶段 |
五、实验结果
实验设置
- 模型:
- Llama-2-7B-32K
- Llama-3.1-8B-Instruct
- Qwen2-7B-Instruct
- 基准:LongBench(21个数据集)、Needle-in-a-Haystack
- 基线:StreamingLLM、SnapKV、CaM、H2O
- 默认配置:
- Attention sinks: 16 tokens
- Recent tokens: 64
- Chunk大小: 256
- Outlier heads比例: 4%
- 数值格式: BFloat16
精度对比(20% KV缓存预算)
Llama-2-7B-32K:
| 方法 | NrtvQA | Qasper | HotpotQA | MultiNews | TriviaQA | Avg |
|---|---|---|---|---|---|---|
| Full | 20.53 | 34.95 | 49.11 | 21.62 | 87.79 | 36.79 |
| StreamingLLM | 16.72 | 18.67 | 41.6 | 4.33 | 84.66 | 27.55 |
| SnapKV | 21.78 | 24.63 | 45.72 | 2.6 | 85.46 | 29.27 |
| CaM | 18.04 | 18.78 | 41.25 | 4.4 | 84.66 | 27.68 |
| Chelsea | 22.74 | 31.2 | 46.51 | 16.23 | 87.37 | 35.12 |
Llama-3.1-8B-Instruct:
| 方法 | NrtvQA | Qasper | HotpotQA | MultiNews | TriviaQA | Avg |
|---|---|---|---|---|---|---|
| Full | 31.69 | 26.25 | 17.01 | 26.91 | 91.65 | 39.43 |
| StreamingLLM | 26.62 | 13.49 | 12.36 | 22.31 | 89.74 | 33.90 |
| SnapKV | 31.51 | 18.21 | 15.42 | 23.02 | 90.53 | 36.38 |
| CaM | 27.05 | 13.76 | 12.62 | 22.29 | 89.79 | 33.91 |
| Chelsea | 31.61 | 20.37 | 16.52 | 24.33 | 91.25 | 37.87 |
Qwen2-7B-Instruct:
| 方法 | NrtvQA | Qasper | HotpotQA | MultiNews | TriviaQA | Avg |
|---|---|---|---|---|---|---|
| Full | 25.42 | 45.92 | 42.89 | 26.13 | 84.09 | 41.44 |
| StreamingLLM | 22.82 | 31.67 | 34.25 | 20.74 | 83.43 | 32.10 |
| SnapKV | 25.92 | 37.91 | 41.15 | 21.98 | 83.74 | 38.21 |
| CaM | 22.63 | 31.91 | 34.33 | 21.05 | 83.5 | 32.04 |
| Chelsea | 24.8 | 43.6 | 41.39 | 22.57 | 84.56 | 39.94 |
LongBench性能对比
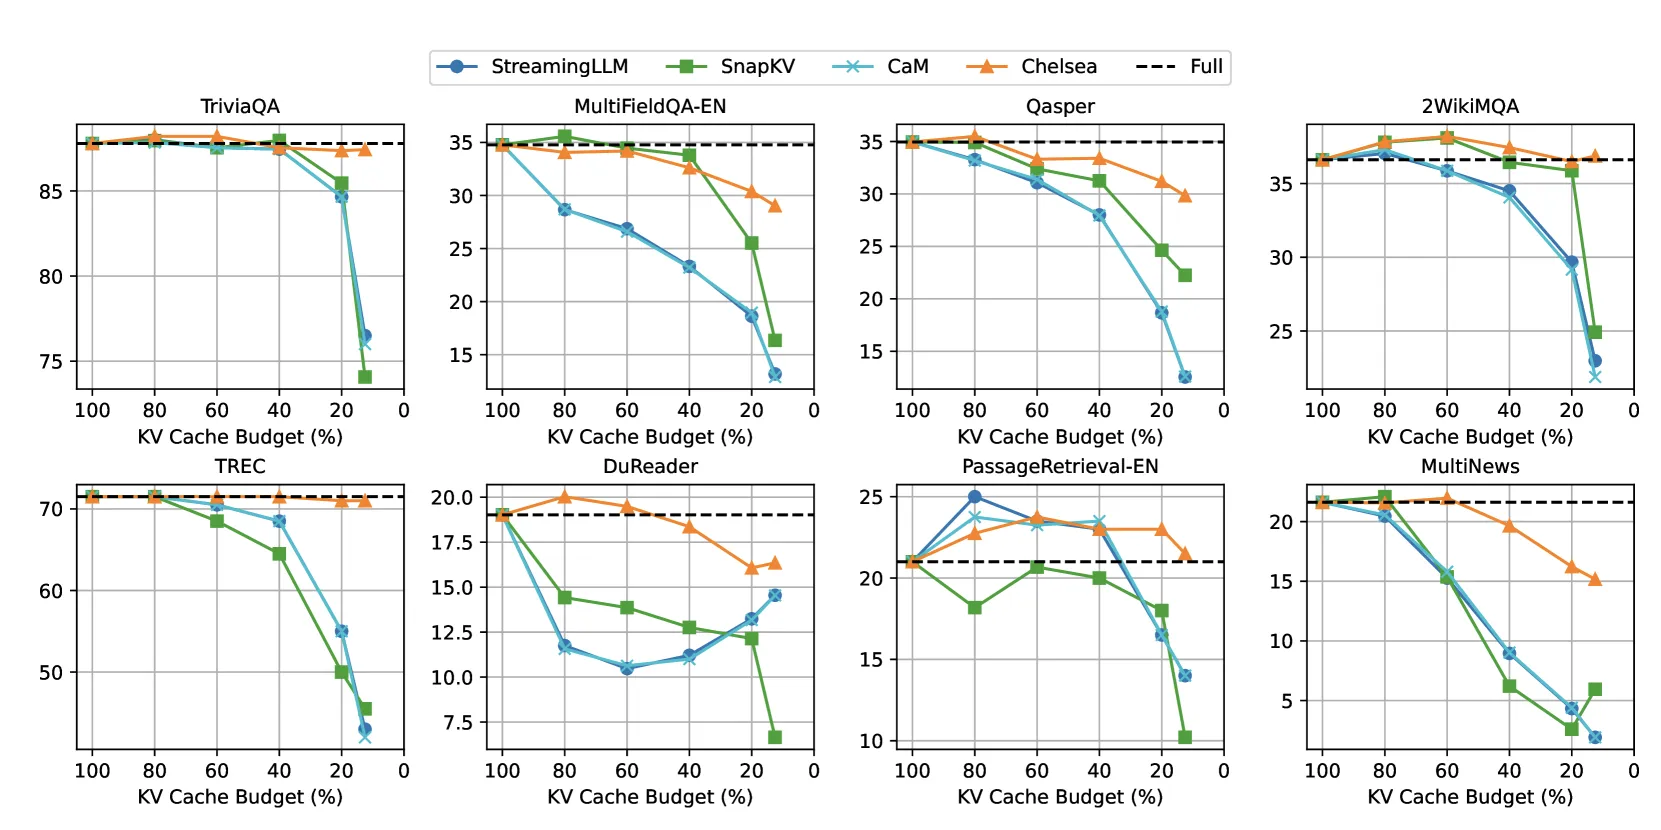
Figure 4: Llama-2-7B-32K在LongBench数据集上的性能对比。
解码延迟和GPU内存使用
Llama-3.1-8B-Instruct:
| 上下文长度 | 方法 | TTFT(s) | TPOT(s) | 内存(GB) |
|---|---|---|---|---|
| 16K | Full | 1.784 | 0.043 | 19.38 |
| 16K | CaM | 1.781 | 0.068 | 25.55 |
| 16K | Chelsea | 1.814 | 0.035 (1.23×) | 15.86 |
| 32K | Full | 4.212 | 0.071 | 23.53 |
| 32K | CaM | 4.201 | 0.106 | 35.50 |
| 32K | Chelsea | 4.306 | 0.036 (1.97×) | 16.69 |
| 64K | Full | 11.421 | 0.137 | 31.83 |
| 64K | CaM | 11.435 | 0.180 | 55.40 |
| 64K | Chelsea | 11.500 | 0.043 (3.19×) | 18.36 |
关键结果:
- 解码阶段加速最高3.19倍(64K上下文)
- GPU内存使用降低最高42%(从31.83GB到18.36GB)
- 端到端延迟降低最高2.72倍
端到端延迟
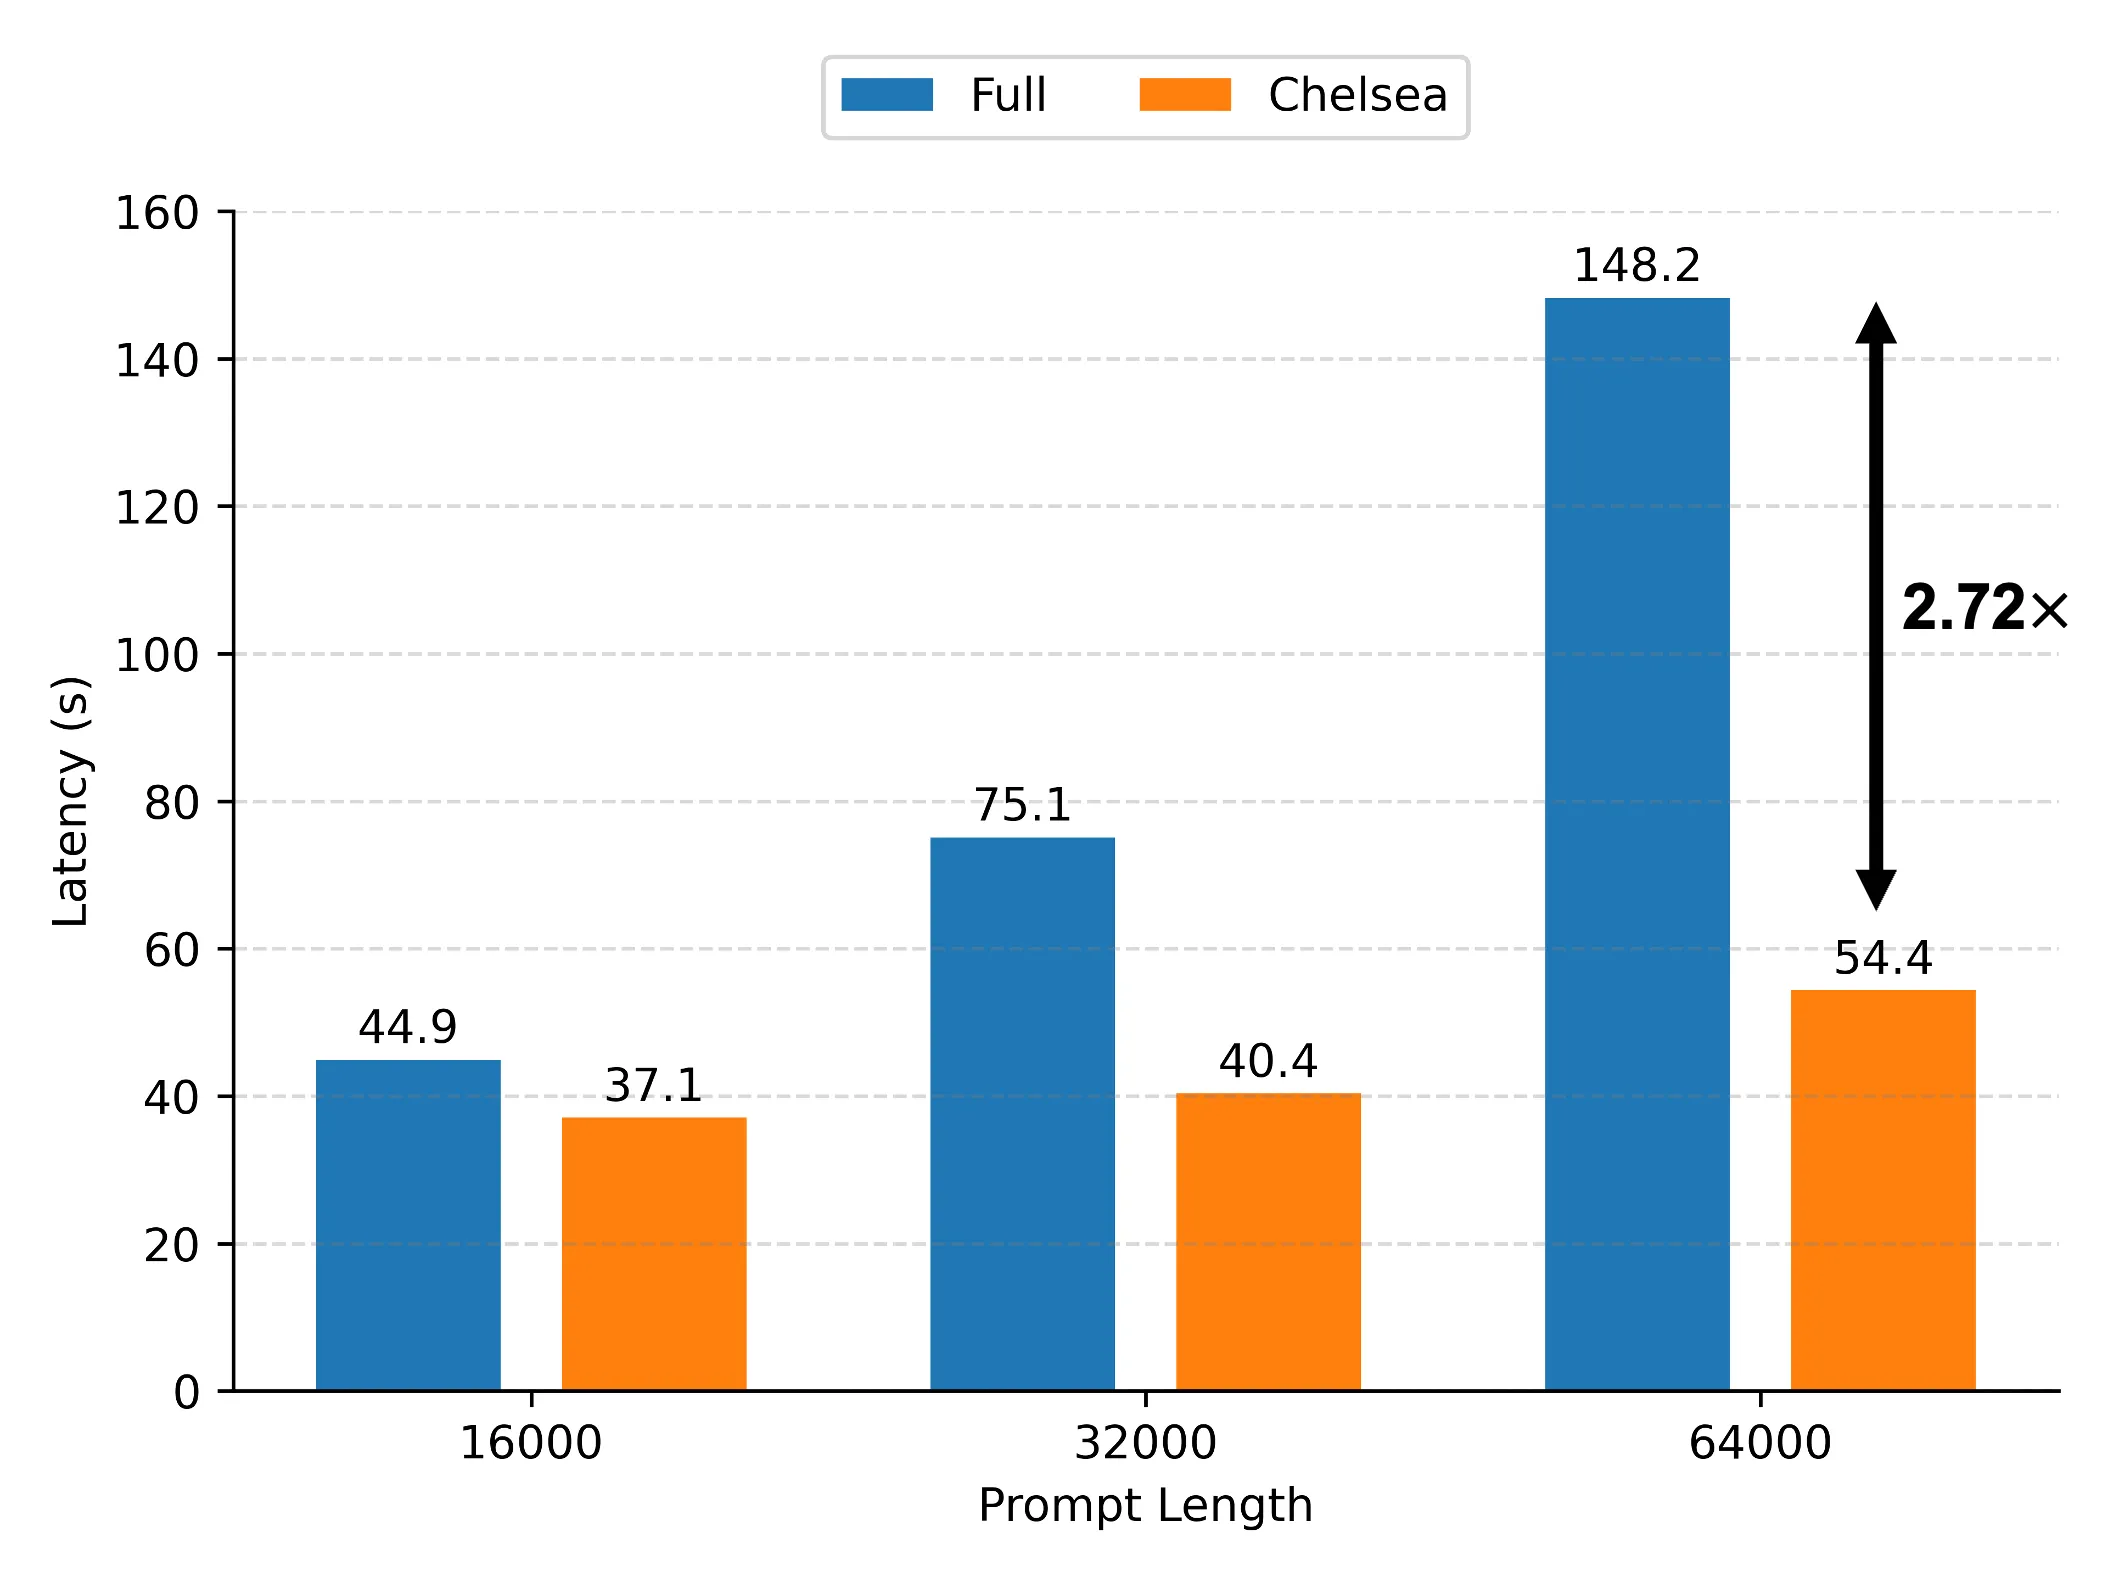
Figure 5: Llama-3.1-8B-Instruct上1000 token解码的端到端延迟。
Needle-in-a-Haystack测试
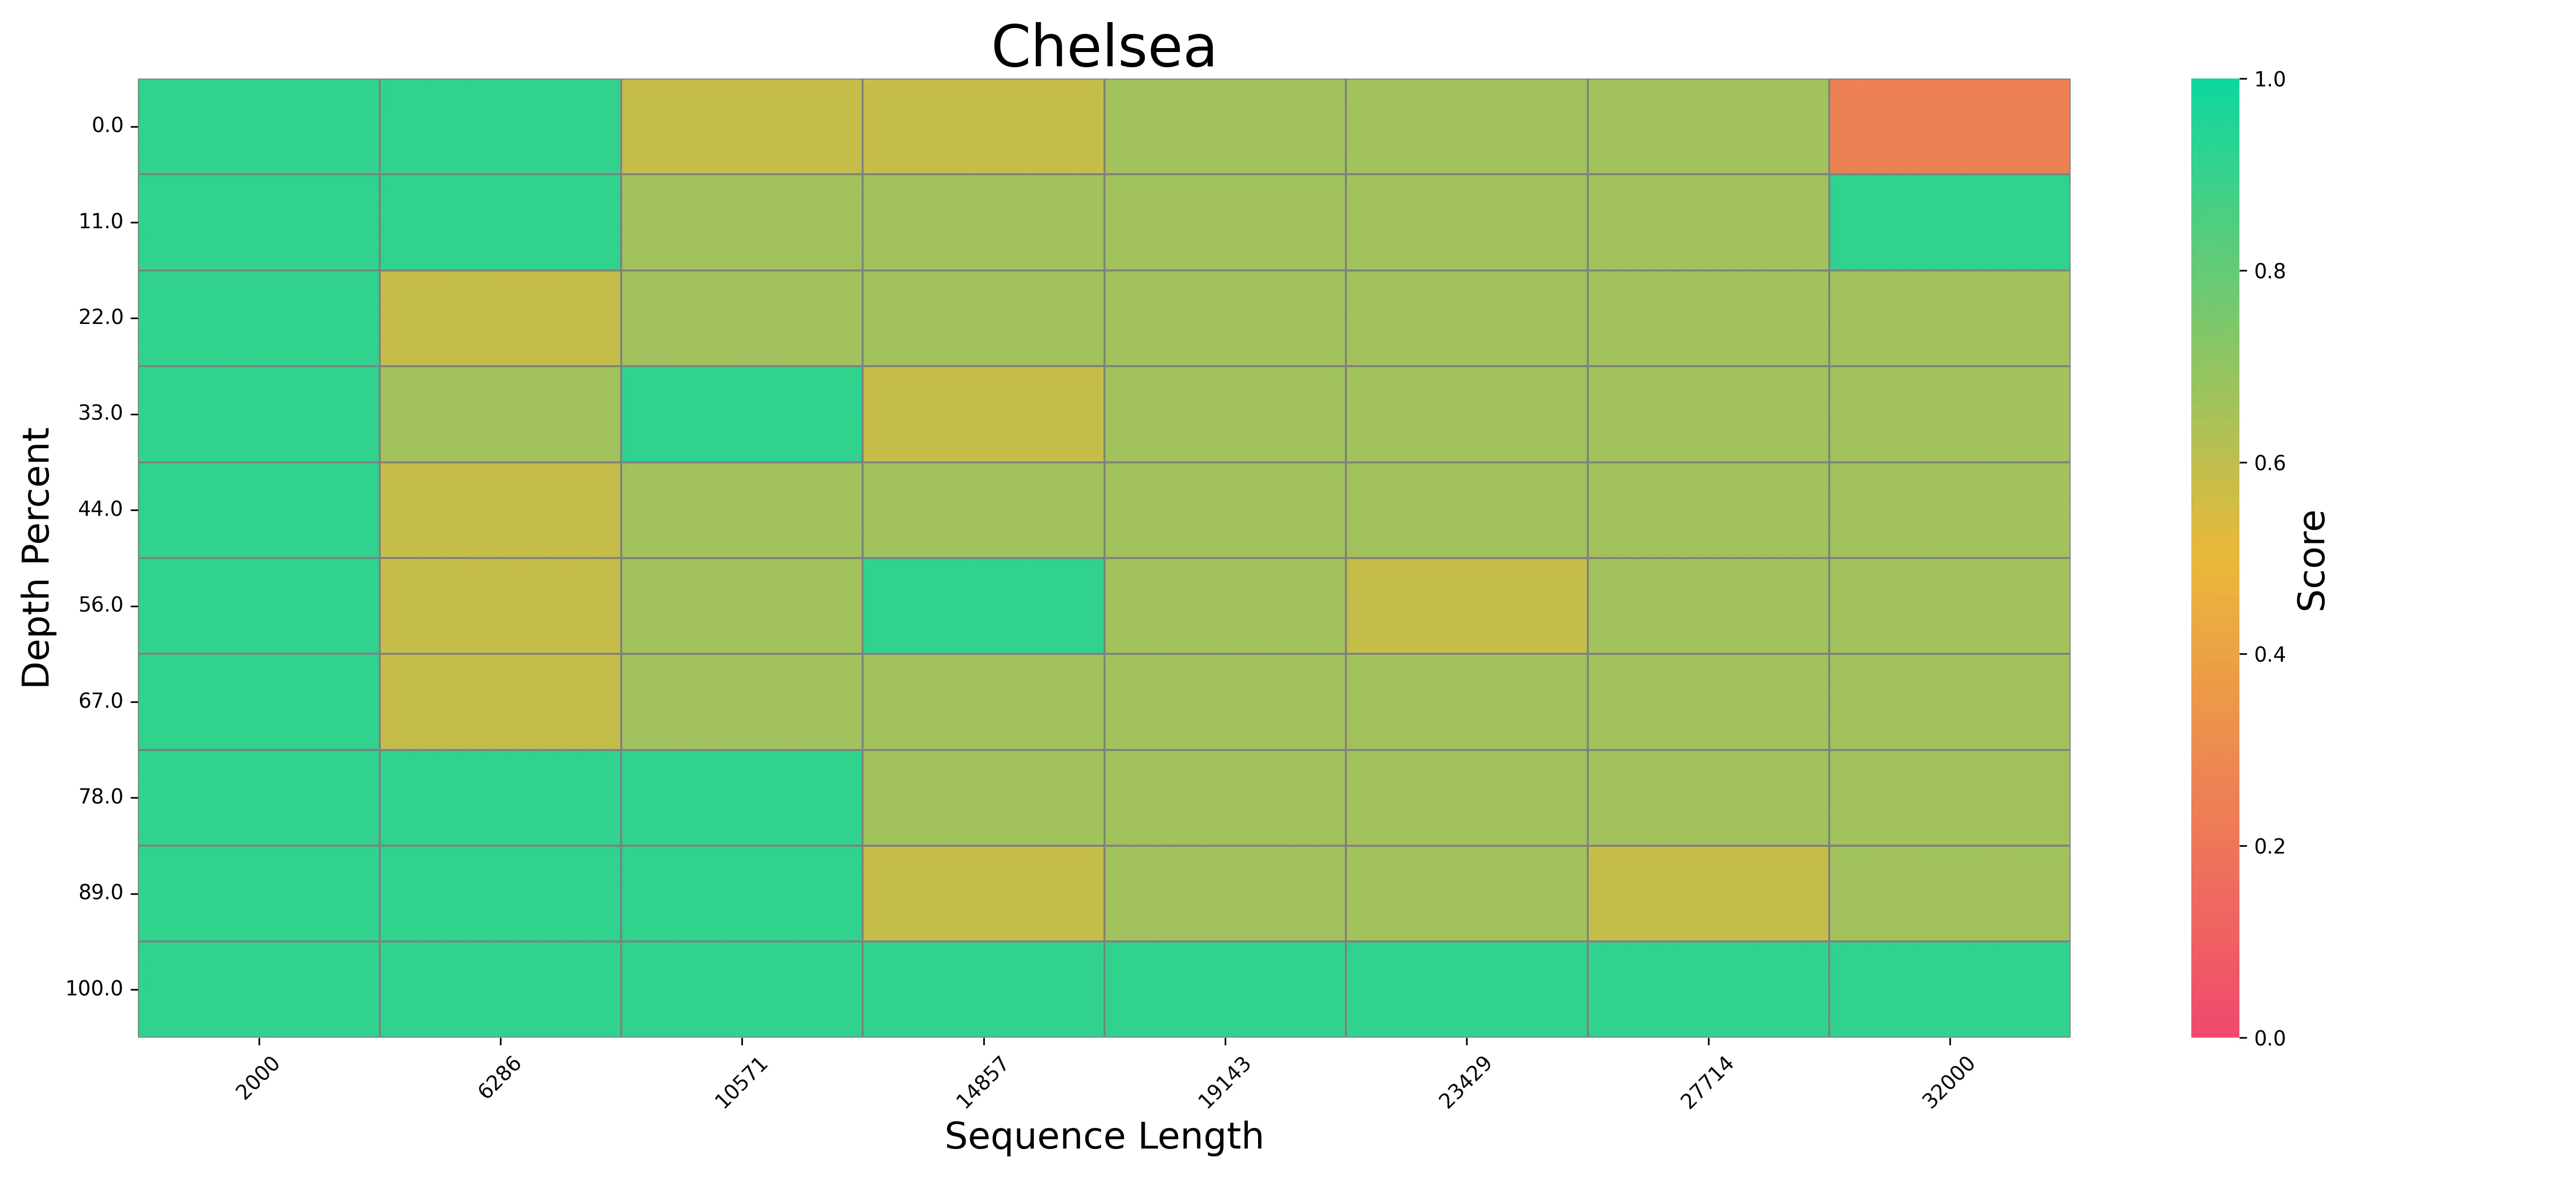
Figure 8: Llama-2-7b-32K在Needle-in-a-Haystack基准上的表现(25% KV缓存预算)。
关键发现:
- Chelsea在长上下文场景下保持高准确率
- 相比StreamingLLM和SnapKV,Chelsea在所有位置都能正确检索
Outlier Heads消融实验
| 配置 | 性能 |
|---|---|
| 无Outlier Heads处理 | 性能下降 |
| 有Outlier Heads处理 | 最优性能 |
关键发现:Outlier heads识别对模型性能至关重要。
六、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 分块软匹配算法 | 首次将BSM应用于KV缓存聚类 | 计算复杂度O(nd),实际加速3.19× |
| 交替分区最优性 | 理论证明凸函数下的最优性 | 定理6.1 |
| Outlier Heads | 动态识别敏感注意力头 | 仅4%的头需要特殊处理 |
| 聚类度感知注意力 | 带log N修正的注意力计算 | 保持聚类后精度 |
七、相关工作对比
| 方法 | 特点 | Chelsea优势 |
|---|---|---|
| H2O | 基于注意力分数的驱逐 | 不丢失被驱逐token的信息 |
| StreamingLLM | 保留sink+recent tokens | 保留更多上下文信息 |
| SnapKV | 基于观察窗口选择重要token | 动态聚类,信息保留更完整 |
| CaM | 合并被驱逐的value状态 | 同时合并key和value |
| KVMerger | 基于token相似度合并 | 计算复杂度更低,非连续约束 |
| K-Means聚类 | 离线聚类 | 在线聚类,计算开销低 |
八、总结
核心贡献
- 首个在线KV缓存聚类框架:Chelsea通过分块软匹配实现高效聚类
- 理论保证:证明交替分区策略在凸函数下的最优性
- 轻量级设计:即插即用,计算复杂度O(nd)
- 显著性能提升:80%内存节省,3.19倍解码加速
性能总结
| 指标 | 提升 |
|---|---|
| KV缓存内存节省 | 最高80% |
| 解码阶段加速 | 最高3.19倍 |
| 端到端延迟降低 | 最高2.72倍 |
| 精度保持(20%预算) | 接近Full Cache性能 |
技术影响
Chelsea展示了在线KV缓存聚类的可行性:
- 聚类比驱逐更优:保留被压缩token的信息
- 在线比离线更实用:无需预计算,支持动态推理
- 轻量级设计:即插即用,兼容现有推理框架
局限性
- 依赖于key状态的相似性假设
- Outlier heads需要额外识别开销
- 压缩比受Bipartite Soft Matching机制限制(最多压缩一半)