A Performance Model for Warp Specialization Kernels
A performance model using differential equations to accurately predict execution time of warp specialization kernels, enabling optimal tile configuration search via Z3 SMT solver
A Performance Model for Warp Specialization Kernels
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | A Performance Model for Warp Specialization Kernels |
| 作者 | Zhengyang Liu (University of Utah), Vinod Grover (NVIDIA) |
| 机构 | University of Utah / NVIDIA (first author did this work while at NVIDIA) |
| 论文 | https://arxiv.org/abs/2506.11209 |
| 代码 | 未公开 |
| 发布 | arXiv:2506.11209, June 12, 2025 (v2 revised June 16, 2025) |
| 许可 | - |
| 类别 | cs.PL (Programming Languages) |
二、核心思想
问题定义
Warp Specialization (WS) 是一种 GPU 内核优化技术,通过将不同线程束(warp)专门化为数据加载(DMA)和计算(MATH)任务,实现计算与内存访问的并行重叠。然而,WS 内核的性能受到多个复杂参数的影响:warp 大小、tile 大小、输入矩阵大小、内存带宽、线程发散等。现有的性能预测方法难以准确建模这种细粒度同步和循环缓冲区约束下的流水线行为。
解决方案概述
本文提出了一个针对 WS 内核的解析性能模型,使用微分方程(实际为耦合递推关系)来精确描述 DMA warp 和 MATH warp 之间的调度依赖。模型通过硬件参数估计(吞吐量 + 启动延迟)和三个耦合的最大函数递推方程,能够准确预测任意 tile 配置下的执行时间。基于此模型,使用 Z3 SMT 求解器自动搜索最优 tile 配置。
模型在 NVIDIA A6000 GPU 上验证了 2048 种配置的预测精度,平均绝对误差仅 4.5%,最大误差 21.5%。
三、技术架构
GeMM 与 Tiling
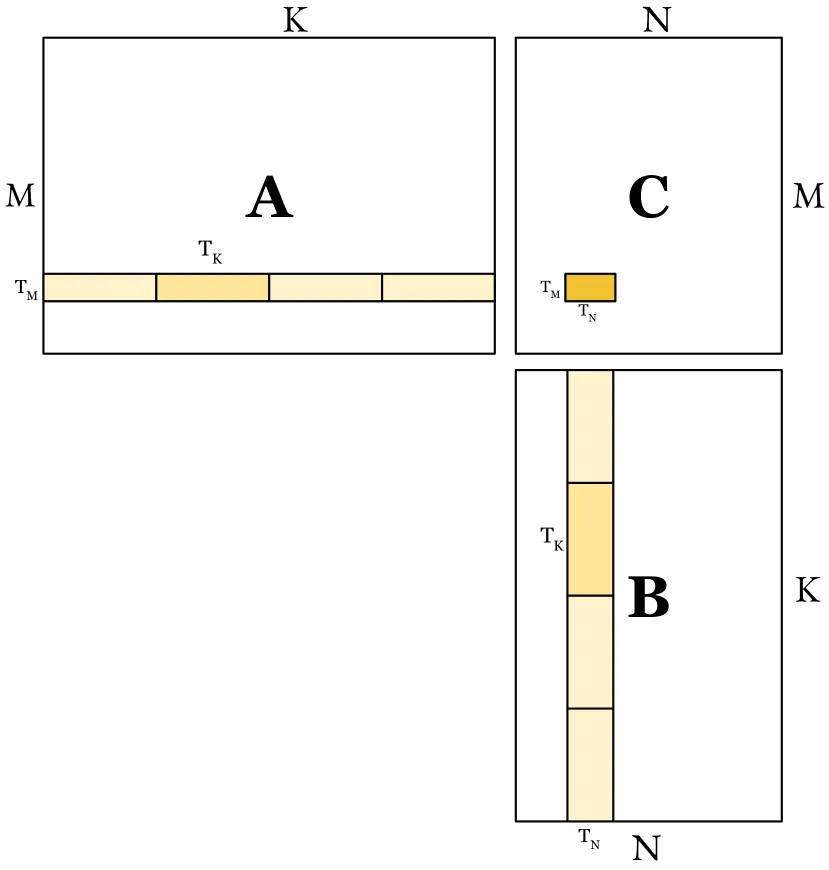
通用矩阵乘法 C = A × B:
- A: M × K, B: K × N, C: M × N
- Tile 配置 (T_M, T_N, T_K)
Warp Specialization 内核结构
CUTLASS GeMM-WS 内核包含两类专用 warp:
- DMA warps:从全局内存加载输入 tiles 到共享内存
- MATH warps:从共享内存加载到寄存器,执行 GeMM 计算,写回结果
共享内存中的循环缓冲区:
- DMA warps 加载时 push tiles
- MATH warps 计算完成后 pop tiles
- 缓冲区满 → DMA wait;缓冲区空 → MATH wait
两种同步机制:
- Wait-signal semaphore 强制执行先后关系
- 任一时刻最多一个 active MATH warp
算法伪代码 (Algorithm 1)
initialize()
for k <- 1 to ceil(K/T_K) do
    if current warp is a DMA warp then
        wait()
        lhs <- load_input_tiles(i, k)
        rhs <- load_input_tiles(k, j)
        signal()
    else if current warp is a MATH warp then
        wait()
        result <- compute(lhs, rhs)
        signal()
        write_output_tile(result)
    end if
end for
四、核心公式
基本参数
Wave 数量:
每 wave 的 stage 数:
总体执行时间:
三种基本时序原语(线性模型)
三个核心微分方程(耦合递推关系)
方程 (1) — DMA 加载 A:
解释:第一个 tile 在时间 0 加载。否则必须等待:① 上一 stage 的 B tile 加载完成 ② MATH warp 释放循环缓冲区空间(容量 M tiles)。
方程 (2) — DMA 加载 B:
解释:必须等待 A 加载完成或缓冲区释放。
方程 (3) — MATH 计算:
解释:MATH warp 必须等待 B 数据就绪且上一 stage 完成。
关键洞察:max() 算子编码了资源依赖(wait-signal 信号量)和循环缓冲区约束(M-tile 容量)。如果调度时间超过资源释放时间,则等待;否则立即执行。
参数估计(两点校准法)
Load Throughput:
Compute Throughput:
Z3 优化目标
目标 1 — 最小化总体执行时间:
目标 2 — 最小化 MATH warp 总等待时间:
其中 Wait(i) = (i=1), (i>1)。
五、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首个 WS 内核性能模型 | 用三个耦合递推方程精确建模 DMA/MATH warp 调度 | 2048 配置验证,平均误差 4.5% |
| 硬件参数两点校准法 | 仅需两次测量即可估计吞吐量和启动延迟 | 在 A6000 上实测 DMA 152.96 MB/s, ALU 24.61 GB/s |
| Z3 SMT 求解器配置优化 | 将性能模型编码为 SMT 约束自动搜索最优 tile 配置 | 求解时间 0.21-0.56 秒 |
| Python 模拟器 | 基于递推方程的事件时间戳模拟,M=N=K=1024 在 <1 秒内完成 | 与 Z3 求解结果完全一致 |
六、实验结果
硬件参数测量(NVIDIA A6000)
| 参数 | 值 | 标准差 |
|---|---|---|
| Kernel launch time (T_INIT) | 1.68 us | 0.027 us |
| Epilogue time (T_EPILOGUE) | 1.543 us | 0.174 us |
| DMA throughput | ~152.96 MB/s | - |
| DMA startup latency | 0.770 us | - |
| ALU compute throughput | ~24.61 GB/s | - |
| ALU startup latency | negligible | - |
Z3 求解时间
| M | N | K | T_M | T_N | T_K | 求解时间 |
|---|---|---|---|---|---|---|
| 1024 | 1024 | 1024 | 128 | 128 | 128 | 0.374 s |
| 1024 | 512 | 1024 | 128 | 64 | 128 | 0.556 s |
| 1024 | 1024 | 512 | 128 | 128 | 128 | 0.315 s |
| 1024 | 512 | 512 | 128 | 64 | 128 | 0.324 s |
| 512 | 512 | 512 | 64 | 64 | 128 | 0.210 s |
求解时间在 0.21-0.56 秒之间,非常快速。
预测精度(2048 种配置)
测试空间:M, N, K ∈ {256, 512, 1024}(128 的倍数),T_M, T_N, T_K ∈ {64, 128},共 2048 种配置。
摘要统计:
- 平均误差:4.5%
- 最大误差:21.5%
- 典型误差范围:大多数配置在 -2% 到 +14% 之间
误差模式:
- T_N = 128(N 维度较大 tile)时误差偏高,尤其对小 K 值(最高 17.47%)
- T_N = 64 且 T_K = 128 时误差通常极低(< 1%)
- 大 problem size (1024³) 配合 T_K=128, T_N=64 达到近乎完美预测(0.14% 误差)
- 小 K (256) 总是产生更高误差 — pipeline 重叠效果减弱,模型假设略有偏差
代表性结果(部分配置)
| M | N | K | T_M | T_N | T_K | 预测 (us) | 实测 (us) | 误差 |
|---|---|---|---|---|---|---|---|---|
| 1024 | 1024 | 1024 | 128 | 64 | 64 | 41.87 | 41.82 | 0.14% |
| 1024 | 1024 | 1024 | 128 | 128 | 64 | 25.15 | 21.75 | 13.53% |
| 512 | 1024 | 1024 | 128 | 64 | 64 | 22.27 | 21.75 | 2.33% |
| 256 | 256 | 512 | 128 | 64 | 64 | 12.65 | 12.71 | -0.46% |
七、相关工作
| 工作 | 关系 |
|---|---|
| Singe (PPoPP’14) | 提出 warp specialization 概念,本文在其基础上建立性能模型 |
| CUTLASS | 实现 GeMM-WS 的生产级库,本文为其提供性能建模工具 |
| LIMINAL (arXiv:2507.14397) | 系统级 LLM decode 性能模型,本文聚焦 kernel 级 WS 调度 |
| ACTA (GPGPU’25) | TMA 配置自动化,本文聚焦 warp 级调度建模 |
| Twill (arXiv:2512.18134) | 自动 warp specialization 编译器,本文提供性能评估基础 |
| Tawa (CGO’2026) | 异步引用的自动 warp specialization,本文可为其提供性能预测 |
八、总结
核心贡献
- 首个 WS 内核性能模型:三个耦合递推方程精确描述 DMA/MATH warp 调度依赖
- 硬件参数自动估计:两点校准法从测量数据推断吞吐量和启动延迟
- Z3 SMT 配置优化器:将模型编码为 SMT 约束,自动搜索最优 tile 配置
- 全面验证:2048 种配置在 A6000 上验证,平均误差 4.5%
- 实用价值:为编译器优化、kernel 参数调优和算法设计提供理论基础
技术影响
- CUTLASS 性能调优:为 GeMM-WS 内核的 tile 配置选择提供自动化指导
- 编译器优化:性能模型可集成到编译器中自动搜索最优配置
- 算法设计:理解 WS 内核中计算与内存访问的权衡关系
局限性
- 仅针对 GeMM-WS 内核,未覆盖其他 WS 应用模式
- 假设 semaphore 查询开销恒定,未考虑实际系统中的波动
- 存储回写时间假设为零(被重叠),在极端情况下可能不准确
- 仅在单 GPU(A6000)上验证,未跨平台验证
- 小 K 值(< 512)时预测误差较高,pipeline 重叠不足导致模型偏差
九、参考资源
- arXiv: https://arxiv.org/abs/2506.11209
- HTML: https://arxiv.org/html/2506.11209v2
- PDF: https://arxiv.org/pdf/2506.11209
- Source: https://arxiv.org/src/2506.11209
- 相关库: CUTLASS - https://github.com/NVIDIA/cutlass/
- 基础工作: Singe (Bauer et al., PPoPP 2014) - “Leveraging Warp Specialization for High Performance on GPUs”