EfficientVLA: Training-Free Acceleration and Compression for Vision-Language-Action Models
一种无需训练的结构化推理加速框架,用于加速扩散式视觉-语言-动作模型
EfficientVLA: Training-Free Acceleration and Compression for Vision-Language-Action Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | EfficientVLA: Training-Free Acceleration and Compression for Vision-Language-Action Models |
| 作者 | Yantai Yang, Yuhao Wang, Zichen Wen, Luo Zhongwei, Chang Zou, Zhipeng Zhang, Chuan Wen*, Linfeng Zhang* |
| 机构 | 上海交通大学人工智能学院、哈尔滨工业大学、西安交通大学、电子科技大学 |
| 论文 | arXiv:2506.10100 |
| 代码 | 未公开 |
| 发布 | 2025年6月11日 |
| 许可 | arXiv非独占分发许可 |
| 领域 | 计算机视觉与模式识别 (cs.CV) |
二、核心思想
问题定义
视觉-语言-动作(Vision-Language-Action, VLA)模型,特别是基于扩散的架构,在具身智能领域展现出变革性潜力,但受到高计算和内存需求的严重制约。这些需求来源于模型本身的冗余性和推理时的冗余性。
现有的VLA模型(如CogACT、OpenVLA、pi0、RT-2)通常由三个主要模块组成:
- 视觉模块:使用DINOv2和SigLIP等编码器提取视觉特征
- 语言模块:大型语言模型(如Llama2-7B)进行多模态推理
- 动作模块:扩散式动作解码器通过多步去噪生成动作序列
这种模块化设计虽然支撑了强大的能力,但也导致了巨大的计算和内存开销。
解决方案概述
EfficientVLA提出了一种结构化的、无需训练的推理加速框架,通过协同利用多维度冗余来系统性地消除这些障碍。框架整合了三个针对性策略:
- 语言模块层剪枝:通过分析层间冗余,剪枝功能上不重要的层
- 视觉Token优化:通过任务感知策略选择紧凑、多样化的视觉Token集合,平衡任务关键性和信息覆盖度
- 动作头缓存机制:通过战略性地缓存和重用关键中间特征,缓解迭代扩散动作头中的时间计算冗余
三、技术架构
整体框架图
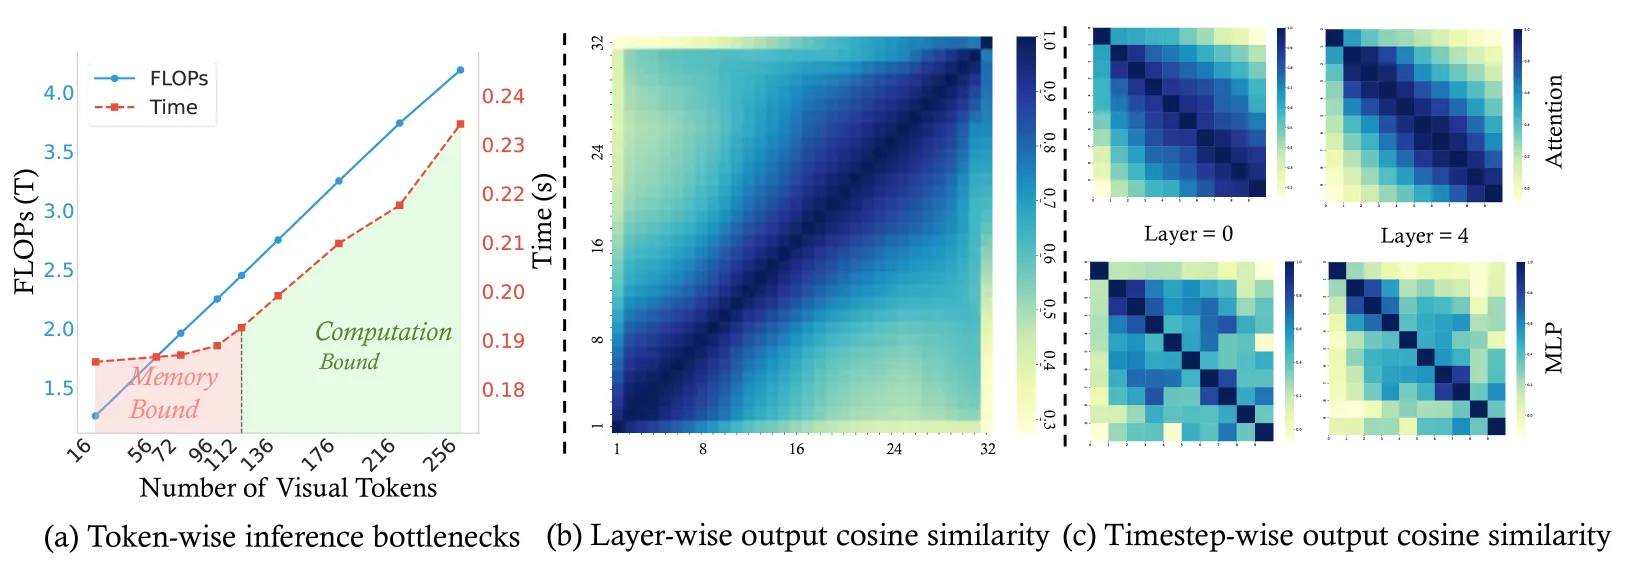
图2:EfficientVLA框架概览,采用无需训练的结构化方法加速扩散式VLA模型,包括:(1) 剪枝冗余的语言模块层;(2) VLA任务感知的视觉Token选择,平衡任务相关性和信息多样性;(3) 扩散动作头中中间特征的时间缓存。
模块化分析
表1:基线VLA模型(CogACT)与EfficientVLA的模块化推理特性对比
| 指标 | 基线模型 | EfficientVLA | ||||
|---|---|---|---|---|---|---|
| 视觉模块 | 语言模块 | 动作模块 | 视觉模块 | 语言模块 | 动作模块 | |
| 参数量 (M) | 802.3 | 6738.9 | 89.0 | 802.3 | 3971.1 (↓41%) | 89.0 |
| 视觉Token数 | 256 | 256 | - | 256 | 56 (↓78%) | - |
| 去噪步数 | - | - | 10 | - | - | 2 (↓80%) |
| 推理时间 (ms) | 24.9 | 134.5 | 51.5 | 24.9 | 58.9 (↓56%) | 26.2 (↓49%) |
| FLOPs (G) | 405.50 | 3726.55 | 57.96 | 405.50 | 792.58 (↓78%) | 11.72 (↓80%) |
核心公式
3.1 视觉-语言-动作模型基础
VLA模型的初始阶段使用视觉模块将原始视觉输入 转换为丰富的特征嵌入 :
视觉特征 与tokenized语言指令一起输入语言模型骨干网络,进行多模态融合和上下文推理,得到任务导向的表示 :
最终,扩散动作头以从 提取的认知特征作为输入,预测7自由度夹爪的最终动作空间。
3.2 语言模型层剪枝 - 层冗余分析
语言模块中的每一层 通过残差变换更新其输入隐藏状态 :
其中 是具有参数 的层特定函数, 是隐藏维度, 是序列长度。
重要性评分公式:层 的重要性评分 基于以下原则定义——对隐藏状态表示产生显著变化的层比输出与输入高度相似的层更为关键:
其中 分别表示样本 在位置 处层 的输入和输出隐藏状态向量。高余弦相似度意味着层函数 的变换效果最小,导致低重要性评分 ,表明功能冗余。
非连续剪枝策略:对于包含 层的LLM,计算每层 的重要性评分 。将这些评分按升序排序,得到有序层索引列表 ,使得 。然后选择列表中的前 层 从模型中移除。
3.3 任务相关性和多样性驱动的视觉Token剪枝
量化任务相关性
通过利用选定VLM层的交叉注意力分数来量化每个初始视觉token 的任务相关性。设 表示视觉token 对第 个上下文token在第 个注意力头中的注意力。原始任务相关性分数 计算如下:
这些原始分数 随后通过min-max缩放归一化为标准化分数 。
关键任务相关Token选择
选择具有最高相关性的 个视觉token(经验设置为4到8之间)形成核心视觉token集 :
增强选择:平衡相关性和多样性
任务驱动增强:选择 个token从 中基于高任务相关性分数 进一步优先选择。
多样性驱动增强:剩余的 个token从更新后的 中选择,目标是最大化相对于已选关键token的特征多样性:
最终剪枝视觉Token集:
3.4 动作预测中的中间特征缓存
DiT块中的特征生成与时间一致性
在每个去噪时间步 的DiT块中,输入特征 依次通过自注意力模块和MLP模块处理:
静态N步缓存实现
在固定间隔 处周期性地重新计算并缓存关键的中间注意力和MLP输出,对中间时间步重用这些缓存值。
缓存更新(当 时):
缓存重用(当 时):
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 视觉编码器 | DINOv2 + SigLIP双编码器 | 参数量802.3M |
| 语言模块 | Llama2-7B骨干网络 | 原始6738.9M参数,剪枝后3971.1M |
| 扩散动作头 | Diffusion Transformer (DiT) | 参数量89M,原始10步去噪 |
| 视觉Token过滤器 | 任务感知Token选择 | 原始256个token,压缩至56个 |
| 特征缓存模块 | 静态N步缓存机制 | 缓存间隔N=5 |
训练流程
EfficientVLA是一个无需训练的推理加速框架,不需要额外的训练过程。其实施细节包括:
- LLM压缩:采用PruneNet配置对LLM进行压缩,对所有Transformer块的MLP层应用25%的稀疏性
- 视觉Token剪枝:从第2个Transformer层开始,比例 ,关键任务token数
- 缓存间隔:设置为5
- 实验环境:所有实验在NVIDIA A40 GPU上进行
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 系统性冗余分析 | 识别VLA模型中的关键计算和内存瓶颈,以及多维度冗余 | 图1展示了层间冗余(高余弦相似度)和时间冗余 |
| 重要性驱动的层剪枝 | 基于层对隐藏状态变换的影响进行非连续层剪枝 | 使用余弦相似度度量层的重要性,低重要性层被移除 |
| 任务感知的视觉Token选择 | 平衡任务相关性和特征多样性的双阶段Token选择策略 | 先选择高相关性token,再补充多样化token |
| 扩散动作头缓存机制 | 利用去噪步骤间的时间一致性,缓存中间注意力和MLP计算 | 观察到相邻去噪步骤间特征的高时间一致性 |
| 协同优化框架 | 三个策略协同工作,而非孤立优化 | 消融实验显示组合效果优于单独优化 |
冗余分析的关键发现
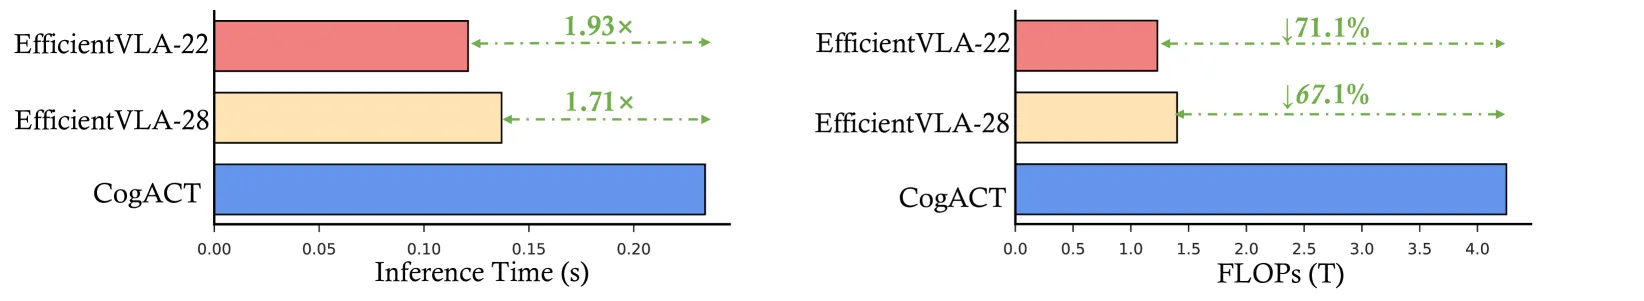
图1:VLA推理瓶颈和冗余分析:(a) 视觉token剪枝对FLOPs和推理时间的影响,揭示计算密集型和内存密集型区域;(b) LLM隐藏状态的高层间余弦相似度,表明深度冗余;(c) 扩散步骤中MLP/注意力特征的时间余弦相似度,显示计算冗余。
关键观察:
- 深度冗余:语言模块中许多层(特别是深层)的输入和输出隐藏状态具有高余弦相似度,表明这些层的有效变换很小
- 视觉冗余:视觉token流中存在两种主要冗余:与任务目标相关性低的token,以及由于视觉相似性导致信息重复的token
- 时间冗余:迭代扩散动作头在相邻去噪步骤间显示出显著的时间冗余,中间特征高度相似
五、实验结果
基准测试
实验环境:SIMPLER环境,一个用于桌面操作的仿真基准,支持Google Robot和WidowX机器人。
评估配置:
- Visual Matching (VM):优先考虑与真实世界外观的保真度
- Variant Aggregation (VA):引入背景、光照、干扰物和桌面纹理的变化
四个任务:
- Pick coke can(拾取可乐罐)
- Move near(靠近移动)
- Open/close drawer(开关抽屉)
- Open top drawer and place apple(打开顶层抽屉并放置苹果)
主要结果
表2:EfficientVLA在SIMPLER环境中的性能对比
| 设置 | 方法 | 无需训练 | PickCan | MoveNear | Drawer | DrawerApple | 平均 | FLOPs↓ | 加速↑ | 参数(B) |
|---|---|---|---|---|---|---|---|---|---|---|
| Visual Matching | CogACT | - | 91.3% | 85.0% | 71.8% | 50.9% | 74.8% | 100.0% | 1.00× | 7.63 |
| Random Dropping | ✓ | 9.7% | 20.4% | 53.5% | 0.0% | 20.9% | 58.5% | 1.20× | 7.63 | |
| FastV | ✓ | 92.6% | 81.4% | 69.8% | 52.4% | 74.1% | 42.0% | 1.21× | 7.63 | |
| VLA-Cache | ✓ | 92.0% | 83.3% | 70.5% | 51.6% | 74.4% | 80.1% | 1.38× | 7.63 | |
| EfficientVLA (L=28, T=112) | ✓ | 95.3% | 83.3% | 70.3% | 56.5% | 76.4% | 45.1% | 1.59× | 5.87 | |
| EfficientVLA (L=28, T=56) | ✓ | 94.7% | 82.4% | 69.8% | 55.4% | 75.5% | 32.9% | 1.71× | 5.87 | |
| EfficientVLA (L=22, T=112) | ✓ | 94.0% | 82.1% | 69.2% | 54.6% | 75.0% | 38.2% | 1.78× | 4.86 | |
| EfficientVLA (L=22, T=56) | ✓ | 93.3% | 81.3% | 68.2% | 53.8% | 74.2% | 28.9% | 1.93× | 4.86 | |
| Variant Aggregation | CogACT | - | 89.6% | 80.8% | 28.3% | 46.6% | 61.3% | 100.0% | 1.00× | 7.63 |
| FastV | ✓ | 91.4% | 78.6% | 27.6% | 50.6% | 62.1% | 42.0% | 1.19× | 7.63 | |
| VLA-Cache | ✓ | 91.7% | 79.3% | 32.5% | 45.8% | 62.3% | 82.6% | 1.37× | 7.63 | |
| EfficientVLA (L=28, T=112) | ✓ | 94.8% | 77.6% | 28.4% | 51.9% | 63.2% | 45.1% | 1.57× | 5.87 | |
| EfficientVLA (L=22, T=56) | ✓ | 93.2% | 75.8% | 26.9% | 49.2% | 61.2% | 28.9% | 1.91× | 4.86 |
效率分析
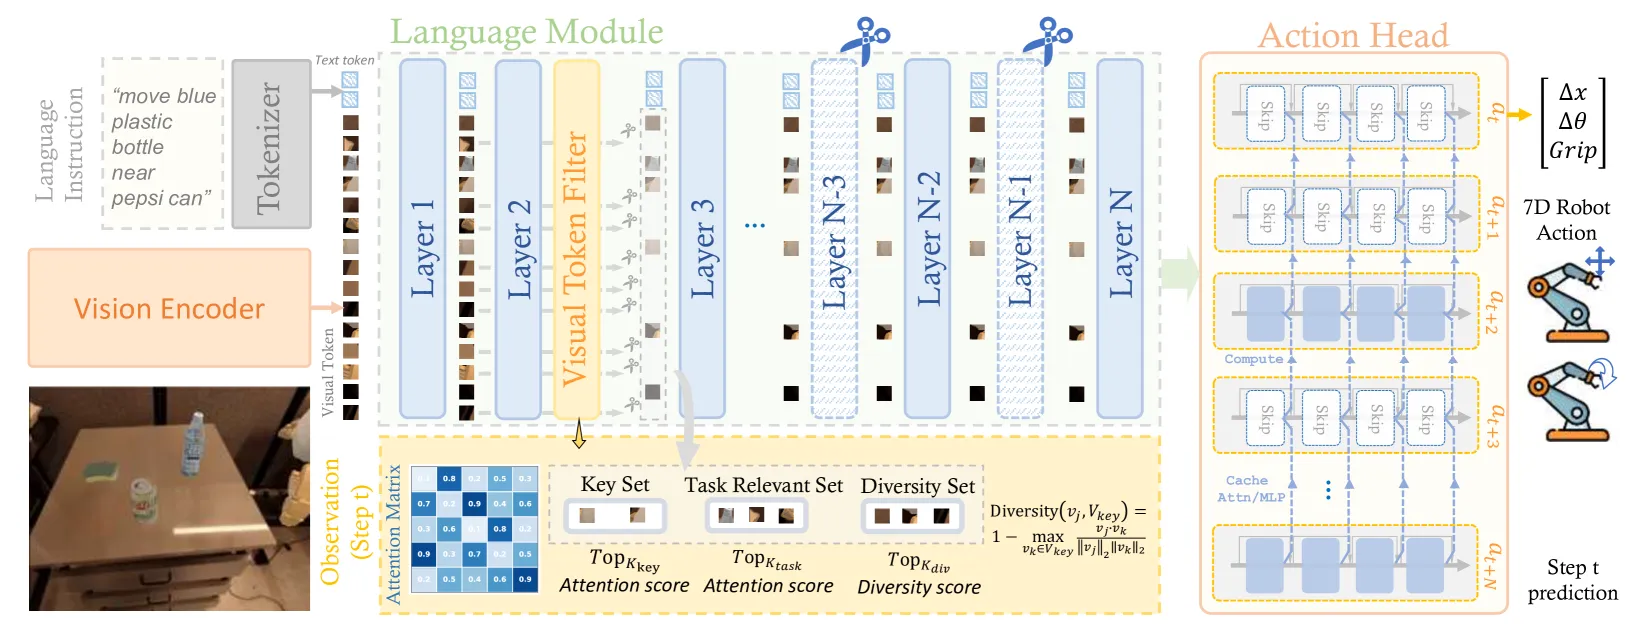
图3:仿真中的效率分析,比较EfficientVLA变体与原始模型骨干的FLOPs和推理时间。
关键结果:
- 1.93×推理加速:在L=22, T=56配置下实现
- FLOPs减少71.1%:从4.2T降至1.2T
- 参数减少36%:从7.63B降至4.86B
- 仅0.6%成功率下降:从74.8%降至74.2%
可扩展性分析
表3:不同模型规模的可扩展性分析
| 模型 | 动作模块参数 | 方法 | 平均成功率 | 推理时间(s) | 总参数(B) |
|---|---|---|---|---|---|
| CogACT-Small | 13M | CogACT | 73.3% | 0.2156 | 7.55 |
| EfficientVLA | 72.6% | 0.1173 | 4.78 | ||
| CogACT-Base | 89M | CogACT | 74.8% | 0.2342 | 7.63 |
| EfficientVLA | 74.2% | 0.1213 | 4.86 | ||
| CogACT-Large | 308M | CogACT | 76.7% | 0.2628 | 7.85 |
| EfficientVLA | 76.1% | 0.1312 | 5.08 |
发现:方法的有效性在更大规模的模型上更为显著。在CogACT-Large模型上,实现了2.0×的推理加速,而性能仅从76.7%微降至76.1%。
消融实验
表5:EfficientVLA组件消融研究
| 实验 | 层剪枝 | MLP压缩 | 视觉Token剪枝 | 动作缓存 | 成功率 | 推理时间(s) | 加速↑ |
|---|---|---|---|---|---|---|---|
| Ex0 | ✕ | ✕ | ✕ | ✕ | 91.3% | 0.2342 | 1.00× |
| Ex1 | ✕ | ✕ | √ | ✕ | 95.6% | 0.1866 | 1.25× |
| Ex2 | ✕ | ✕ | ✕ | √ | 93.7% | 0.1909 | 1.23× |
| Ex3 | √ | ✕ | √ | ✕ | 85.7% | 0.1604 | 1.46× |
| Ex4 | √ | √ | ✕ | ✕ | 92.3% | 0.1638 | 1.43× |
| Ex5 | √ | √ | ✕ | √ | 93.3% | 0.1387 | 1.69× |
| Ex6 | ✕ | ✕ | √ | √ | 95.3% | 0.1592 | 1.47× |
| Ex7 | √ | √ | √ | √ | 93.3% | 0.1213 | 1.93× |
关键发现:
- 单独优化视觉token仅带来1.25×加速,尽管成功率从91.3%提升至95.6%
- 模型压缩(层剪枝+MLP压缩)实现1.43×加速
- 所有组件集成后实现1.93×加速,且任务成功率提升2个百分点
Token减少比例和缓存间隔的影响
表4:视觉token减少比例(左)和扩散动作头缓存间隔(右)的影响
| Token比例 | 56 (77.8%) | 72 (71.8%) | 96 (62.5%) | 112 (56.2%) | 256 (100%) |
|---|---|---|---|---|---|
| 准确率 | 95.0% | 95.3% | 95.0% | 96.0% | 91.3% |
| 推理时间(s) | 0.1866 | 0.1870 | 0.1889 | 0.1956 | 0.2342 |
| FLOPs (T) | 1.76 | 1.96 | 2.25 | 2.45 | 4.19 |
| 缓存间隔 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 准确率 | 91.3% | 94.0% | 93.7% | 90.3% | 93.7% |
| 推理时间(s) | 0.2342 | 0.2031 | 0.1987 | 0.1953 | 0.1909 |
| FLOPs (T) | 4.190 | 4.161 | 4.155 | 4.150 | 4.144 |
六、总结
核心贡献
- 系统性分析:识别了当代扩散式VLA架构中的关键计算和内存瓶颈,以及多维度冗余
- 结构化加速框架:提出了EfficientVLA,一种无需训练的结构化推理加速框架,协同剪枝语言模块冗余层,并战略性选择紧凑、任务聚焦的视觉token子集
- 时间缓存机制:通过缓存扩散动作头中迭代去噪过程的中间注意力和MLP计算来增强效率
- 显著效果:在CogACT上实现1.93×推理加速,FLOPs降至28.9%,仅0.6%准确率下降
技术影响
- 机器人部署:使大规模VLA模型能够在资源受限的机器人平台上进行实时交互
- 效率提升:为VLA模型的实际部署提供了可行的加速方案
- 方法通用性:框架设计具有通用性,可应用于其他扩散式VLA架构
局限性
- 训练无关方法的上限:无需训练的方法可能无法达到训练感知方法所能实现的最大压缩或加速
- 固定缓存间隔:动作头中的固定缓存间隔N在加速和动作保真度之间引入了权衡
- 模型验证范围:由于开源扩散式VLA模型的可用性有限,当前演示主要在CogACT上进行
- 未来方向:探索自适应缓存策略,在更多模型和任务上验证可扩展性和有效性
七、参考资源
论文链接
相关工作
| 模型/方法 | 说明 | 与EfficientVLA的关系 |
|---|---|---|
| CogACT | 基础VLA模型,集成DINOv2、SigLIP和Llama2-7B | EfficientVLA的主要验证平台 |
| OpenVLA | 开源VLA模型 | 相关的VLA架构 |
| π0 | 视觉-语言-动作流模型 | 相关的扩散式VLA |
| RT-2 | 视觉-语言-动作模型 | VLA领域的开创性工作 |
| TinyVLA | 快速、数据高效的VLA模型 | 训练感知的加速方法 |
| DeeR-VLA | 动态推理的多模态LLM | 训练感知的加速方法 |
| Mole-VLA | 动态层跳跃VLA模型 | 需要重训练的层剪枝方法 |
| VLA-Cache | 自适应token缓存 | 仅缓存静态视觉token |
| FastV | 视觉token剪枝 | 仅优化视觉token |
| PruneNet | 无校准模型压缩 | 用于MLP层压缩 |
关键技术组件
| 组件 | 来源 | 说明 |
|---|---|---|
| DINOv2 | Meta | 自监督视觉特征学习 |
| SigLIP | Sigmoid损失的视觉-语言预训练 | |
| Llama2-7B | Meta | 大型语言模型骨干 |
| Diffusion Transformer (DiT) | - | 扩散动作头架构 |
| SIMPLER | - | 仿真评估环境 |
图片索引
所有关键图片位于 docs/figures/efficientvla/ 目录:
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 2 | EfficientVLA架构概览 | architecture-overview.png |
| Figure 3 | 效率分析对比(FLOPs和推理时间) | efficiency-comparison.png |
| Figure 1 | 冗余分析(层间/时间冗余) | redundancy-analysis.png |
| 补充 | 训练结果对比 | training-results.png |
原始数据位置
- MinerU提取输出:
docs/mineru_output/efficientvla/ - 完整Markdown:
docs/mineru_output/efficientvla/full.md - 内容列表:
docs/mineru_output/efficientvla/c2fca18f-7a7c-4f8b-ba9d-db912bfe1cef_content_list.json