V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning
Internet-scale JEPA video model pretrained on 1M+ hours of video, achieving SOTA understanding benchmarks and enabling zero-shot robotic planning via action-conditioned post-training with <62h robot data
V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning |
| 作者 | Mahmoud Assran, Adrien Bardes, David Fan, Quentin Garrido, Russell Howes, Mojtaba Komeili, Matthew Muckley, Ammar Rizvi, Claire Roberts, Koustuv Sinha, Artem Zholus, Sergio Arnaud, Abha Gejji, Ada Martin, Francois Robert Hogan, Daniel Dugas, Piotr Bojanowski, Vasil Khalidov, Patrick Labatut, Francisco Massa, Marc Szafraniec, Kapil Krishnakumar, Yong Li, Xiaodong Ma, Sarath Chandar, Franziska Meier, Yann LeCun, Michael Rabbat, Nicolas Ballas |
| 机构 | FAIR (Meta) / Mila – Quebec AI Institute & Polytechnique Montréal |
| 论文 | https://arxiv.org/abs/2506.09985 |
| 代码 | https://github.com/facebookresearch/vjepa2 |
| 发布 | arXiv:2506.09985v1 [cs.AI], Jun 11, 2025 |
| 博客 | https://ai.meta.com/blog/v-jepa-2-world-model-benchmarks |
二、核心思想
问题定义
现代 AI 的核心挑战之一是让智能体通过观察来理解世界并学会行动。现有方法面临以下局限:
- 交互数据稀缺:基于状态-动作序列的预测世界模型受限于真实世界交互数据的可获得性
- 视频生成计算昂贵:基于动作条件视频生成的方法在规划时计算开销巨大(逐像素生成)
- JEPA 缩放不足:已有 JEPA 方法在超大规模视频预训练和下游任务泛化上尚未充分探索
解决方案概述
本文提出 V-JEPA 2——一个分阶段训练的自监督框架:
阶段 1:无动作视频预训练
- 在超过 100 万小时的互联网视频和 100 万张图像上使用视觉掩码去噪目标预训练 V-JEPA 2 视频编码器(最高 1B 参数)
- 编码器学习在表示空间中预测视频片段的 masked tokens
阶段 2:动作条件后训练(可选)
- 冻结预训练的视频编码器,在少量机器人交互数据上训练动作条件预测器(V-JEPA 2-AC)
- 仅使用 <62 小时的 Droid 数据集未标注机器人视频
- 用于 MPC 循环中的零样本机器人规划
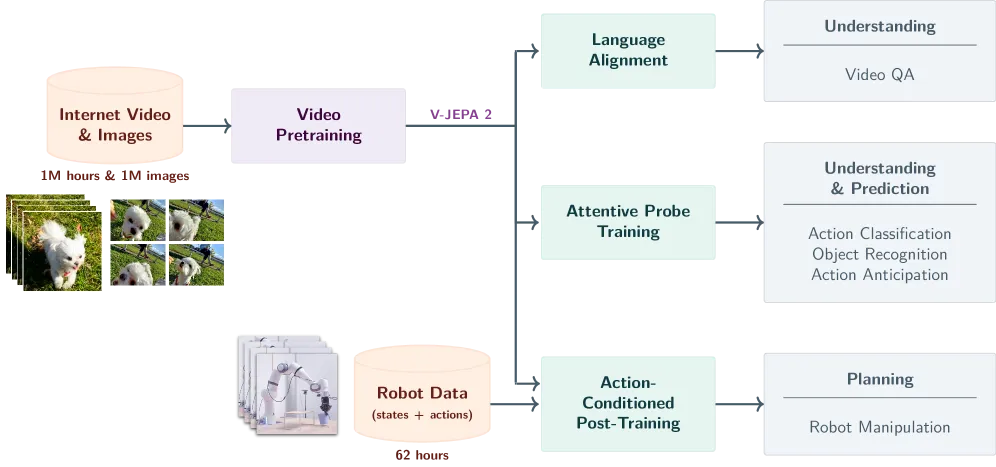
与视频生成方法不同,JEPA 专注于学习场景中可预测方面的表示(如运动物体的轨迹),而忽略不可预测的细节(如每片草叶的位置或树叶的形状)。这使 V-JEPA 2 在规划时更加高效。
三、技术架构
两阶段训练流程
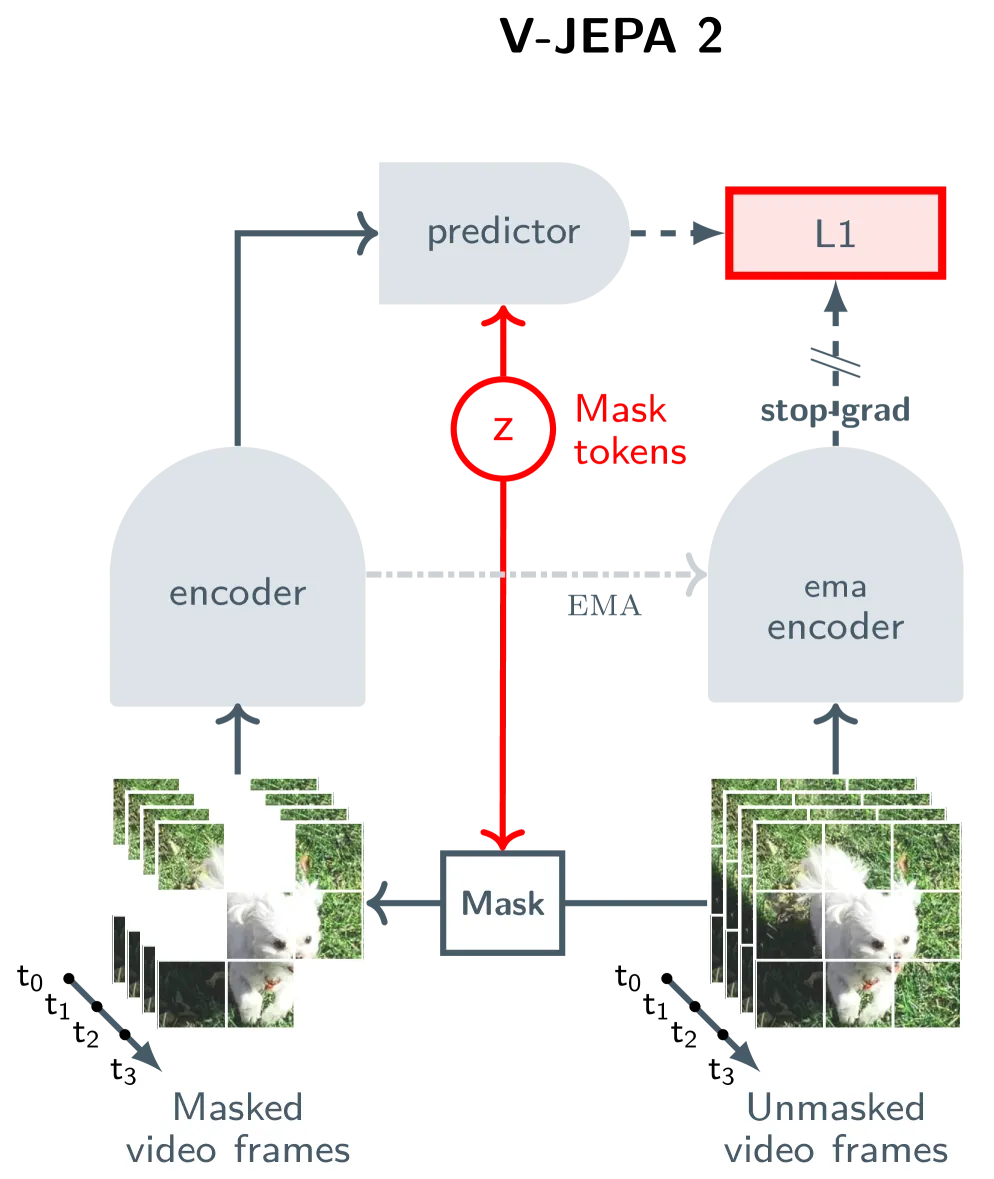
阶段 1:无动作视频预训练
数据:VideoMix22M 数据集(100 万+ 小时视频 + 100 万图像)
- 相比 VM2M 基线,性能提升 +1 点(外观类任务如 Kinetics-400、COIN、ImageNet 提升更显著)
- 基于 YT1B 的聚类筛选数据,平均性能再提升 +1.4 点
模型架构:
- Encoder:ViT(最高 1B 参数的 ViT-G)
- Predictor:Transformer,处理 masked 视频序列
- 使用 EMA encoder 生成预测目标
训练目标(Visual Mask Denoising):
其中:
- 是被 mask 片段的真实嵌入(由 EMA encoder 生成)
- 是 predictor 对 masked 输入的预测
- EMA encoder 权重是 encoder 权重的指数移动平均
训练细节:
- 渐进式分辨率训练:252K iterations @ 16 frames / 256×256 → 12K cooldown iterations @ 384×384
- 提供高达 8x 的训练加速
- Cooldown 阶段使用 64 帧(而非 16 帧),推理性能再提升 +0.7 点
阶段 2:动作条件后训练(V-JEPA 2-AC)
数据:<62 小时的 Droid 数据集未标注机器人视频
模型架构:
- 冻结 V-JEPA 2 视频编码器
- 新的动作条件预测器:300M 参数 Transformer
- 使用块因果注意力(block-causal attention)机制
- 自回归地预测下一帧表示,以当前动作和先前状态为条件
双重损失训练(Fig. 6):
-
Teacher Forcing Loss: 预测器以当前帧表示为输入,预测下一时间步表示
-
Rollout Loss: 将预测器的输出反馈作为输入,训练模型预测多步未来
总损失:
通过优化两种损失的组合,V-JEPA 2-AC 增强了减少 rollout 误差累积的能力。
动作条件预测器架构
Input: [patch_features_t, patch_features_{t-1}, ..., actions_t, actions_{t-1}, ..., end_effector_states]
                    ↓
        Block-Causal Attention Transformer (300M params)
                    ↓
Output: predicted patch features at t+1- 每个 patch feature 在给定时间步可以 attending 到当前和之前时间步的 patch features、actions 和 end-effector states
- 块因果模式确保不会”看到”未来信息
潜在空间规划
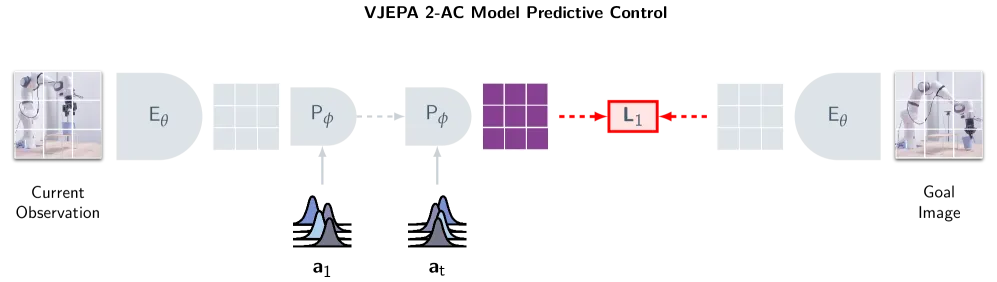
给定初始观测 和目标 :
代价函数(终端状态与目标嵌入的距离):
优化目标:
求解方法:Cross-Entropy Method (CEM)
- 在每个规划步骤中,从一系列高斯分布采样动作坐标(初始均值 0,方差 1)
- 使用 top-k 动作轨迹的统计量更新高斯分布的均值和方差
- 重复多次迭代后返回高斯序列的均值作为选定的动作轨迹
扩展效果
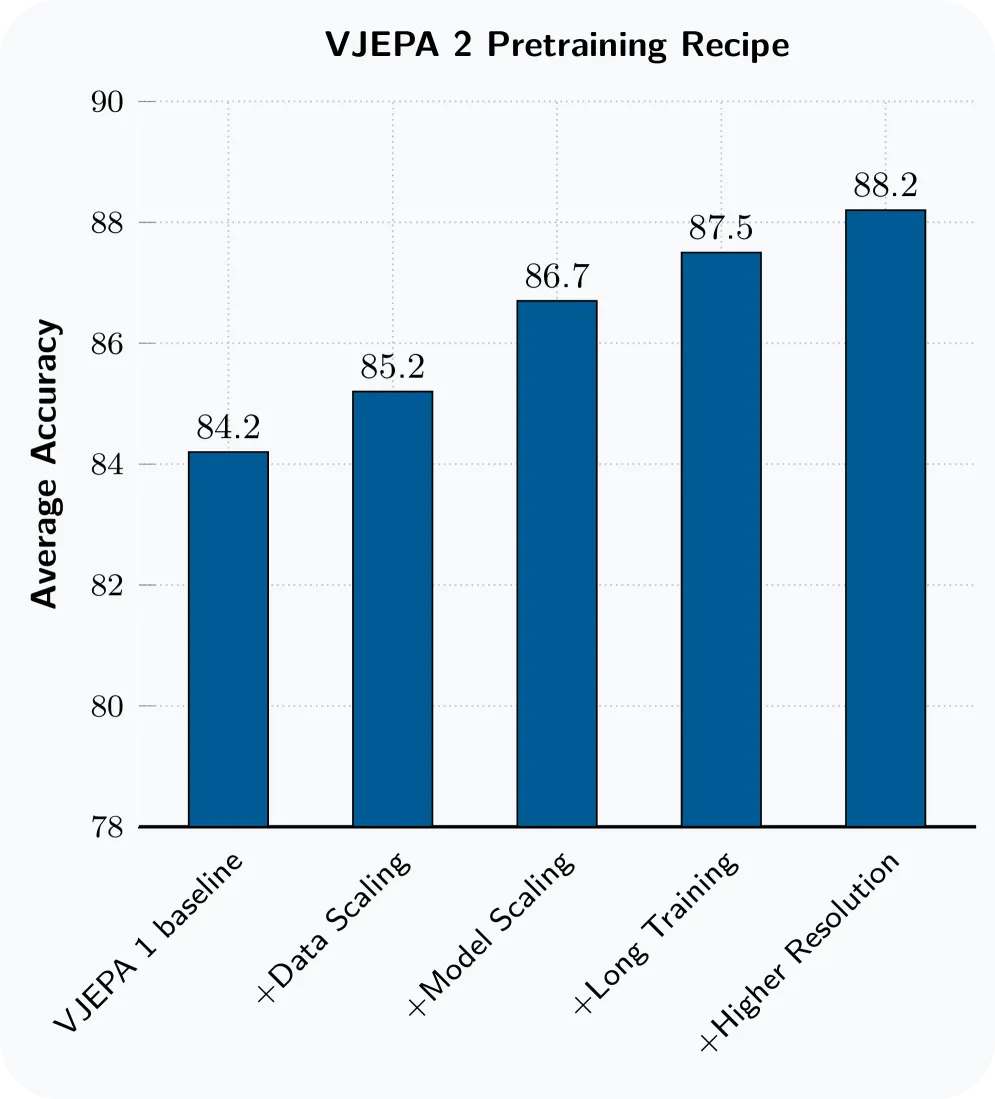
在 6 个图像和视频分类任务(SSv2, Diving-48, Jester, Kinetics, COIN, ImageNet)上评估:
- 数据规模:VM22M 相比 VM2M 提升 +1 点
- 数据筛选:Curated-YT1B 相比原始 YT1B 提升 +1.4 点
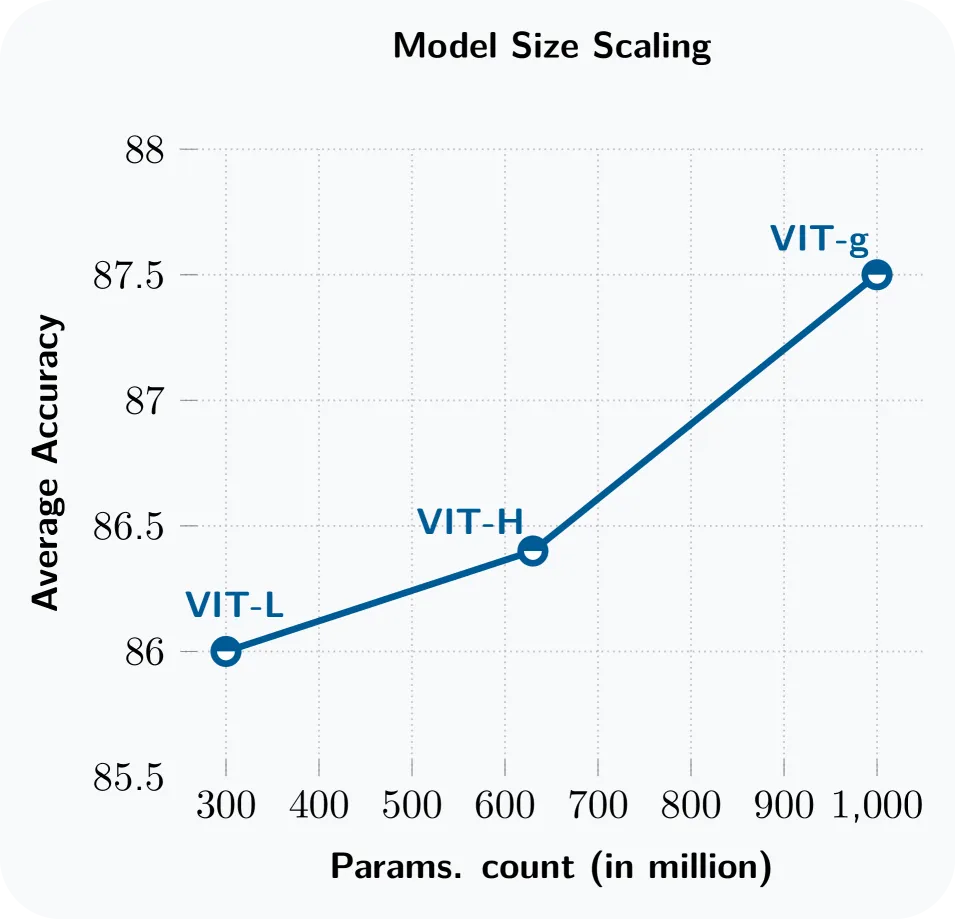
- 模型规模:300M → 1B 参数,平均性能提升 +1.7 点
- 渐进式分辨率训练:最高 8x 加速
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 百万小时级 JEPA 预训练 | 首个在 100 万+ 小时互联网视频上训练的 JEPA 模型 | 1B 参数 ViT-G,6 任务平均性能显著提升 |
| 数据筛选策略 | 基于聚类的视频筛选,去除低质量数据 | Curated-YT1B 比原始 YT1B 提升 +1.4 点;未清洗数据在 epoch 600 后开始退化 |
| 渐进式分辨率训练 | 先用 256×256 快速训练,再在 384×384 上 cooldown | 最高 8x 训练加速 |
| Action-Conditioned 后训练 | 冻结编码器,仅训练 300M AC 预测器 | <62 小时机器人数据即可实现零样本规划 |
| Teacher Forcing + Rollout 联合训练 | 同时优化单步和多步预测误差 | 减少 rollout 误差累积,提升规划质量 |
| 零样本机器人规划 | 无需目标环境收集数据,无需 task-specific training | 在两个实验室的 Franka 机械臂上成功完成 pick-&-place |
| LLM 对齐 | 将 V-JEPA 2 编码器与 LLM backbone 对齐 | 8B 参数规模下,PerceptionTest 84.0,TempCompass 76.9 |
五、实验结果
运动理解(Motion Understanding)
| 基准 | 指标 | V-JEPA 2 |
|---|---|---|
| Something-Something v2 | Top-1 Accuracy | 77.3 |
| Diving-48 | Top-1 Accuracy | SOTA |
| Jester | Top-1 Accuracy | SOTA |
| Kinetics-400 | Top-1 Accuracy | SOTA |
| COIN | Top-1 Accuracy | SOTA |
| ImageNet | Top-1 Accuracy | SOTA |
人类动作预判(Human Action Anticipation)
| 基准 | 指标 | V-JEPA 2 |
|---|---|---|
| Epic-Kitchens-100 | Recall@5 | 39.7(超越所有 prior 任务特定模型) |
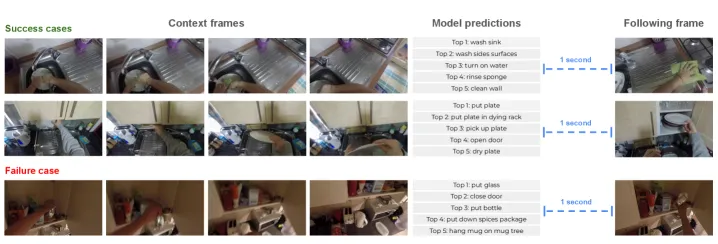
- 上下文帧数、帧率(fps)、空间分辨率均影响性能
- 更长 anticipation time(1s→3s)性能下降但依然优于 baseline
视频问答(Video Question Answering)
通过与 LLM backbone 对齐,在 8B 参数规模下达到 SOTA:
| 基准 | V-JEPA 2 |
|---|---|
| PerceptionTest | 84.0 |
| TempCompass | 76.9 |
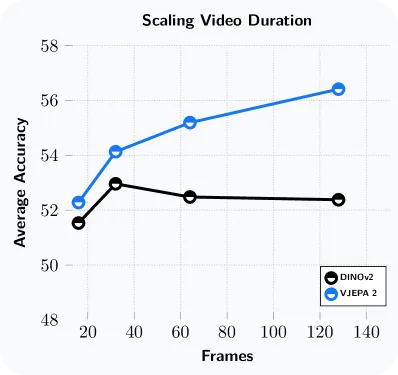
- 视觉指令微调中,随着推理帧数增加,V-JEPA 2 性能线性超过 DINOv2
- 证明 V-JEPA 2 能有效利用更多帧信息
数据筛选效果
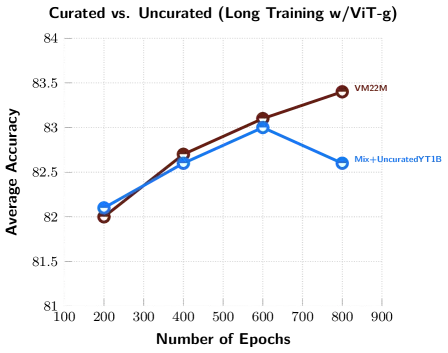
- 使用未筛选数据的模型在 epoch 600 后性能开始退化
- 数据筛选对大规模预训练至关重要
推理时长增益
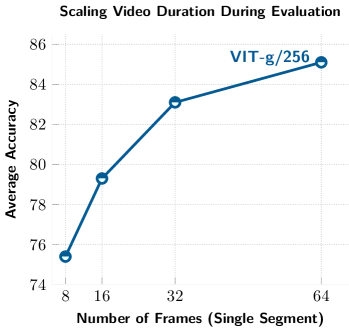
- 使用 ViT-g 模型在 256×256 分辨率上 annealed with 64 frames
- 推理时处理更多帧可将平均性能提升高达 +9.7 点
规划速度对比
- 编码观测的 token 数比 DINO-WM 少 ~200x
- 规划速度与 PLDM 相当
- 比 DINO-WM 快 ~50x
- 在固定 FLOPs 下,LeWM 在 Push-T 和 OGBench-Cube 上显著优于 DINO-WM
六、机器人与规划实验
Single-Goal Reaching
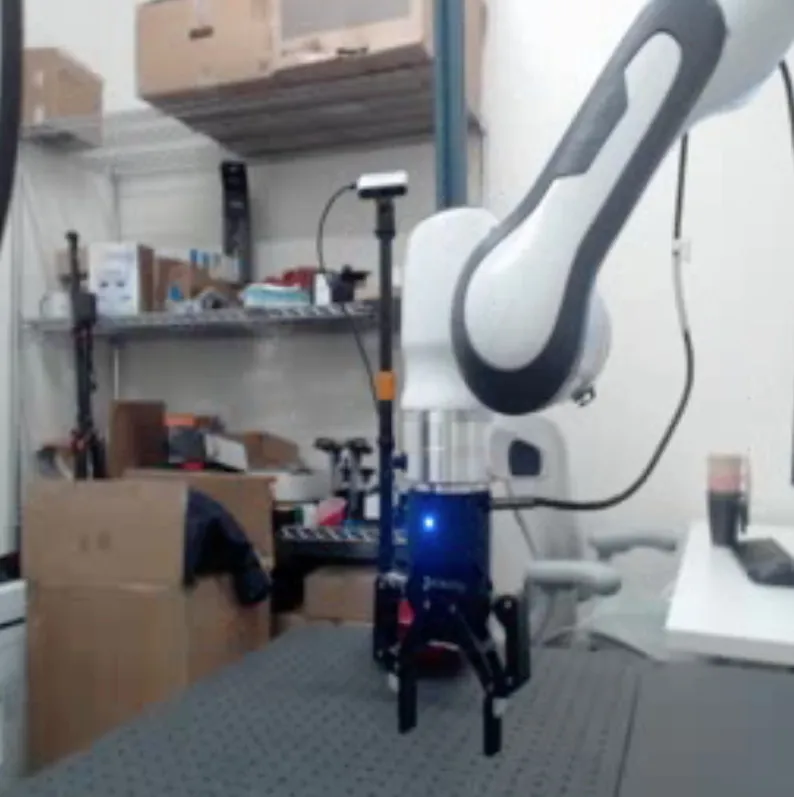
- 基于单目 RGB 相机的 3D 空间理解
- 每次规划时仅在 origin 为中心、半径 0.075 的 L1-Ball 内采样个体动作
- 单步最大笛卡尔距离减少 0.13(~13 cm)
- 执行第一个动作后重新规划(MPC 策略)
Energy Landscape
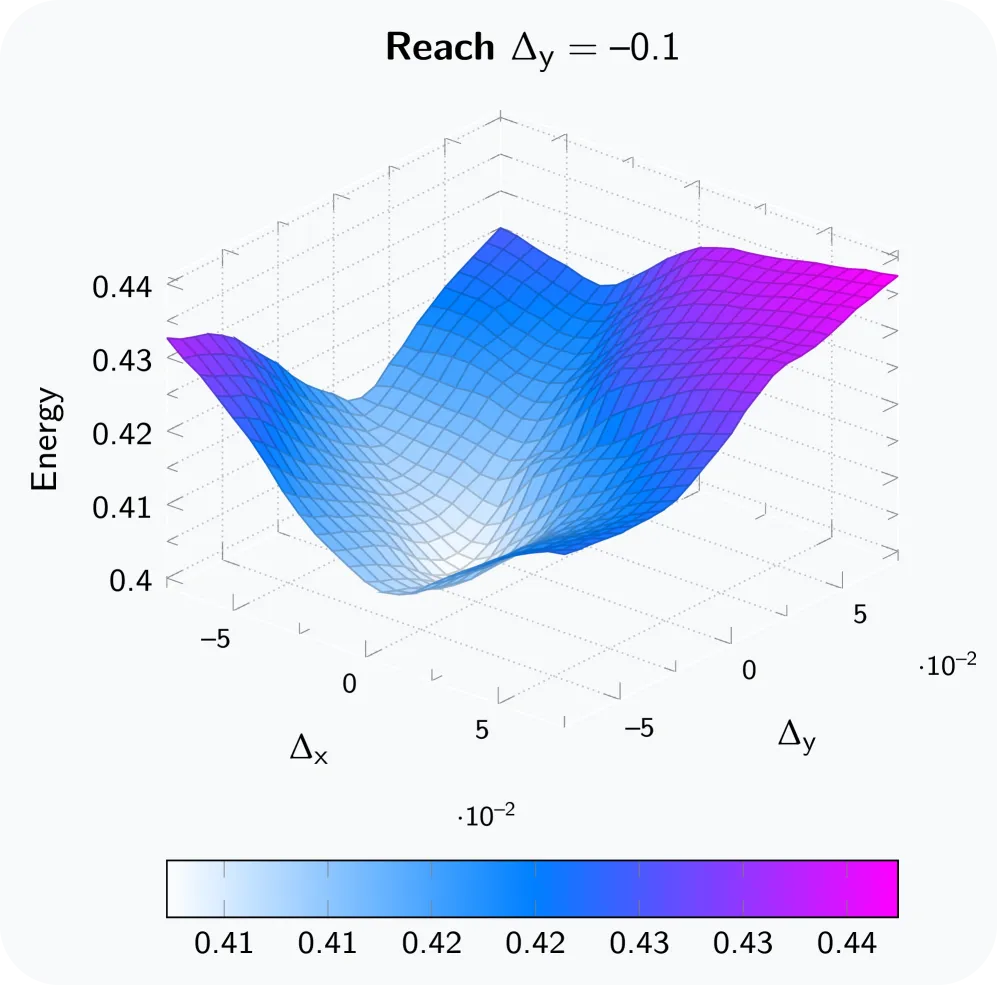
- 相对于末端执行器笛卡尔控制动作的能量景观
- 真实动作位于
- 能量函数最小值位于
- 表明模型学会了合理推断动作效果,无需精确感知
Pick-&-Place
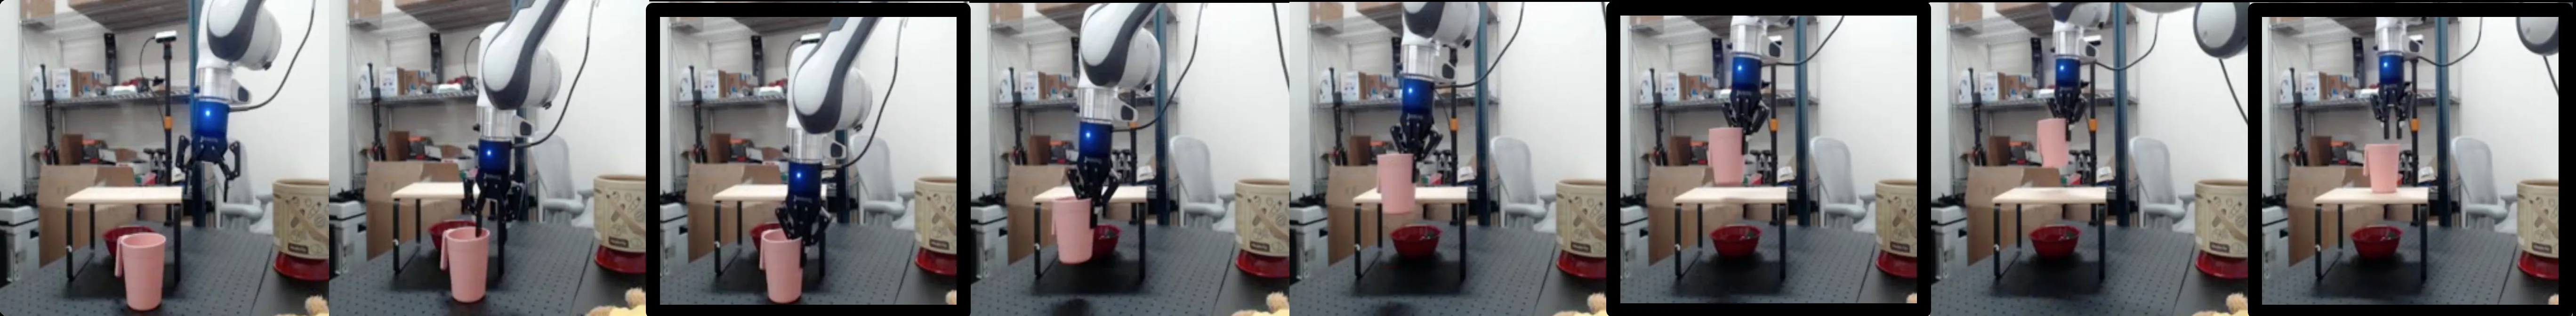
- 多目标 pick-&-place 任务的闭环机器人执行
- 模型自动切换到下一个子目标:
- 第 1 个子目标(抓取物体):4 个时间步
- 第 2 个子目标(移动到目标位置附近):10 个时间步
- 第 3 个子目标(放置物体):4 个时间步
- 零样本部署:在两个不同实验室的 Franka 机械臂上完成各种物体配置和杂乱环境
世界模型 Rollout 可视化
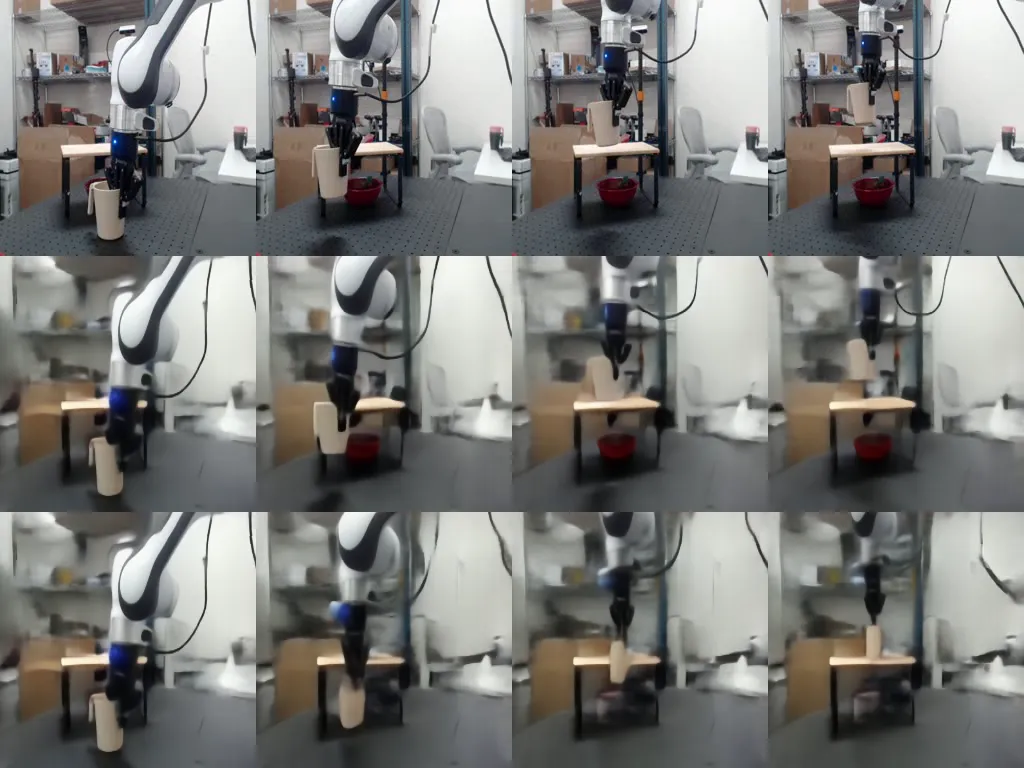
- Top Row:真实机器人轨迹视频帧
- Middle Row:V-JEPA 2 encoder 编码 + feedforward decoder 解码 → 捕获场景关键部分
- Bottom Row:V-JEPA 2-AC 自回归 rollout → 成功动画化机器人,同时保持背景和未交互对象不变
误差累积:最终帧中模型预测的杯子位置略低于真实轨迹。
直觉物理理解
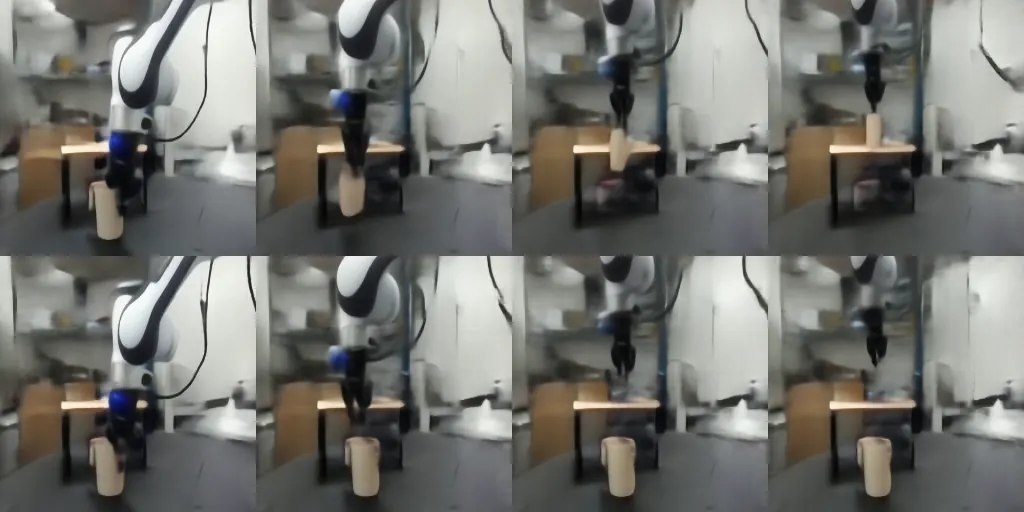
- 使用相同动作序列但不同夹爪状态(开/关)驱动世界模型
- 关闭夹爪:世界模型预测杯子位置随时间变化(正确)
- 打开夹爪:世界模型预测杯子位置不变(正确理解了抓握的物理约束)
- 表明模型学到了合理的直觉物理(物体恒常性、形状恒常性、重力)
相机位置敏感性
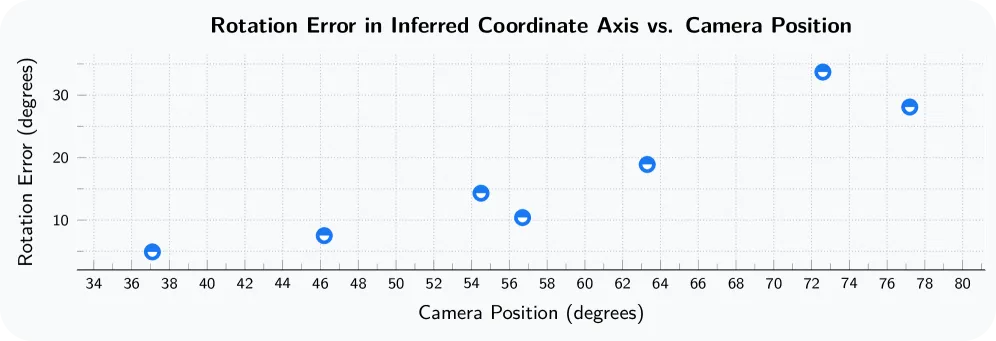
- 动作坐标轴的旋转误差(相对于相机位置)
- 0° = 相机位于机器人基座处,90° = 相机位于机器人基座左侧
- 模型推断的动作坐标轴对相机位置敏感(理想情况下应不变)
Action Anticipation 消融实验
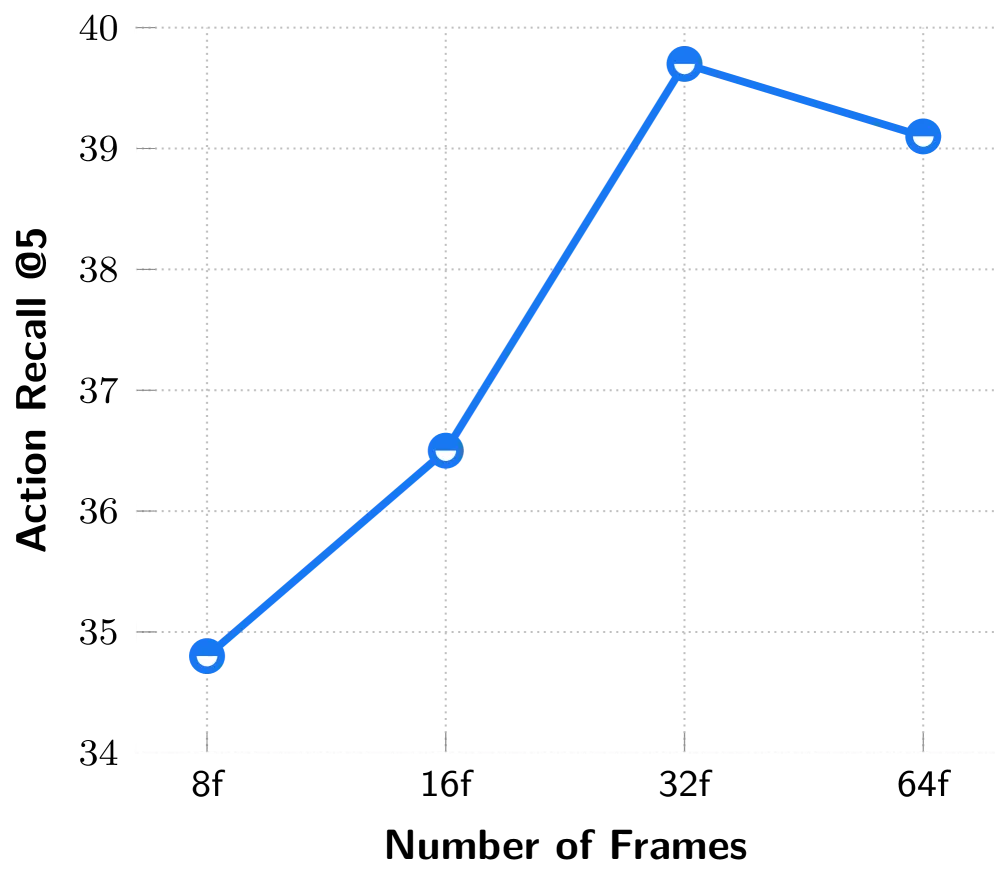
- 上下文帧数越多,性能越高(存在饱和点)
- 更高 fps 带来更好性能
- 更高空间分辨率提升性能
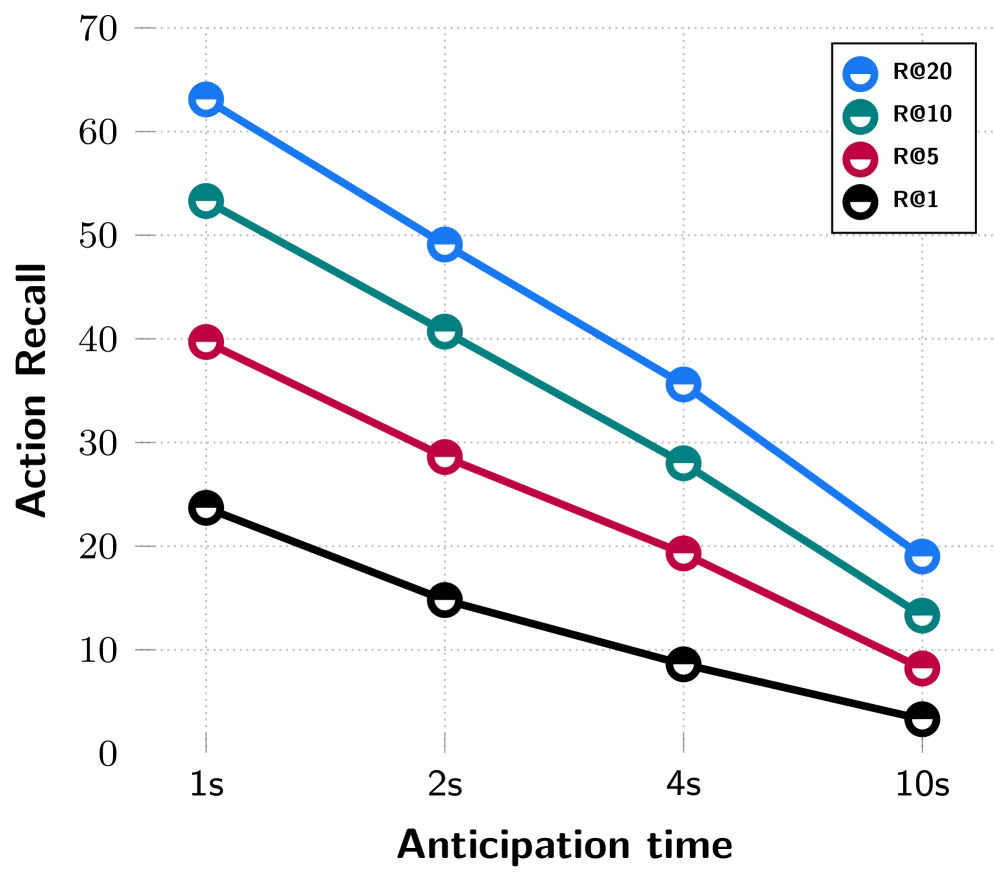
- EK100 动作预判在不同 anticipation time 下的 Recall
- 成功/失败案例分布分析
七、相关工作
| 工作 | 关系 |
|---|---|
| V-JEPA (原版) | 原始 V-JEPA,使用 stop-gradient + EMA target encoder |
| I-JEPA | 图像版本的 JEPA,同样使用 SG+EMA |
| Echo-JEPA / Brain-JEPA | 面向医疗数据的 JEPA 变体 |
| PLDM | 端到端 JEPA,使用 VICReg,但训练不稳定 |
| DINO-WM | 冻结 DINOv2 编码器,非端到端,规划慢 |
| DreamerV4 | 需要 reward 信号的生成式世界模型 |
| VideoGen / Genie | 基于视频生成的世界模型,规划计算成本高 |
| SIGReg | 用于 anti-collapse 的正则化方法(LeWorldModel 使用) |
八、总结
核心贡献
- V-JEPA 2 预训练:在 100 万+ 小时互联网视频上预训练的 JEPA 视频模型(最高 1B 参数),在运动理解任务上达到 SOTA
- 人类动作预判 SOTA:Epic-Kitchens-100 上 Recall@5 = 39.7,超越所有 prior 任务特定模型
- 视频问答 SOTA:与 LLM 对齐后,8B 参数规模下 PerceptionTest 84.0、TempCompass 76.9
- V-JEPA 2-AC 后训练:仅用 <62 小时机器人数据训练动作条件世界模型
- 零样本机器人规划:在两个实验室的 Franka 机械臂上成功完成 pick-&-place,无需目标环境数据收集或 task-specific training
- 直觉物理理解:世界模型展现出对抓握物理约束的理解(开/关夹爪的不同预测)
技术影响
- 证明了 JEPA 的可扩展性:从 300M 到 1B 参数,从 16 帧到 64 帧,性能持续提升
- 展示了自监督学习 + 少量交互数据的强大力量:100 万小时视频 + 62 小时机器人数据 ≈ 强大的世界模型
- 为 reward-free 机器人学习提供了新范式:无需人工设计奖励函数即可实现复杂操控任务
局限性
- 相机位置敏感性:动作坐标轴推断对相机位置敏感,缺乏视角不变性
- 误差累积:自回归 rollout 存在误差累积(杯子位置预测偏差)
- 仅 monocular RGB:深度信息从单目相机推断,精度受限
- 数据依赖:预训练数据来自互联网视频,可能包含大量非机器人相关场景
- 推理效率:虽然比视频生成快 50x,但 CEM 规划仍需要多次前向传播
- Feedforward Decoder 容量有限:背景生成模糊部分归因于低容量的前馈帧解码器
九、参考资源
- arXiv: https://arxiv.org/abs/2506.09985
- HTML: https://arxiv.org/html/2506.09985v1
- Code: https://github.com/facebookresearch/vjepa2
- Blogpost: https://ai.meta.com/blog/v-jepa-2-world-model-benchmarks
- V-JEPA 原版: LeCun (2022), “A Path Towards Autonomous Machine Intelligence”
- I-JEPA: Assran et al. (2023)
- SIGReg: Bardes et al. (2024)
- DROID Dataset: Khazatsky et al. (2024)