LiteVLM: A Low-Latency Vision-Language Model Inference Pipeline for Resource-Constrained Environments
针对资源受限环境的低延迟视觉语言模型推理流水线
LiteVLM: A Low-Latency Vision-Language Model Inference Pipeline for Resource-Constrained Environments
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LiteVLM: A Low-Latency Vision-Language Model Inference Pipeline for Resource-Constrained Environments |
| 作者 | Jin Huang, Yuchao Jin, Le An, Josh Park |
| 机构 | NVIDIA |
| 邮箱 | {jinhu, yuchaoj, lean, joshp}@nvidia.com |
| 论文 | arXiv:2506.07416 |
| 代码 | 未公开 |
| 发布 | 2025-06-09 (v1), 2025-10-31 (v2) |
| 许可 | CC BY 4.0 |
| 领域 | Machine Learning (cs.LG), Artificial Intelligence (cs.AI) |
二、核心思想
问题定义
多模态大语言模型(MLLMs),特别是视觉语言模型(VLMs),在视觉推理任务中展现了卓越的能力。然而,典型的VLM架构包含视觉Transformer(ViT)编码器、对齐模块(如MLP或Q-Former)和LLM解码器,计算量巨大。在资源受限的嵌入式平台(如自动驾驶车载计算平台)上实现实时部署面临严峻挑战:
- 视觉编码器瓶颈:ViT需要处理大量图像patch,计算密集
- LLM预填充阶段:视觉token构成输入序列的主体,导致prefill延迟高
- 自回归解码延迟:逐token生成导致decode阶段延迟累积
解决方案概述
LiteVLM提出了一种高效的VLM推理流水线,通过联合利用三种互补技术实现端到端延迟的大幅降低:
- Patch Selection Module(补丁选择模块):在图像编码前,根据文本查询动态选择相关的相机视角,从12个patch减少到平均3.5个,实现ViT编码器3.0倍加速
- Token Selection Module(视觉token选择模块):在LLM预填充前,基于注意力分数选择信息最丰富的视觉token,减少输入序列长度
- Speculative Decoding Head(投机解码头):基于Eagle-2方法,使用轻量级草稿模型加速token生成阶段
三种技术协同工作,在不损失任务精度的前提下实现端到端2.5倍延迟降低;结合FP8量化后进一步提升至3.2倍。
三、技术架构
整体框架图
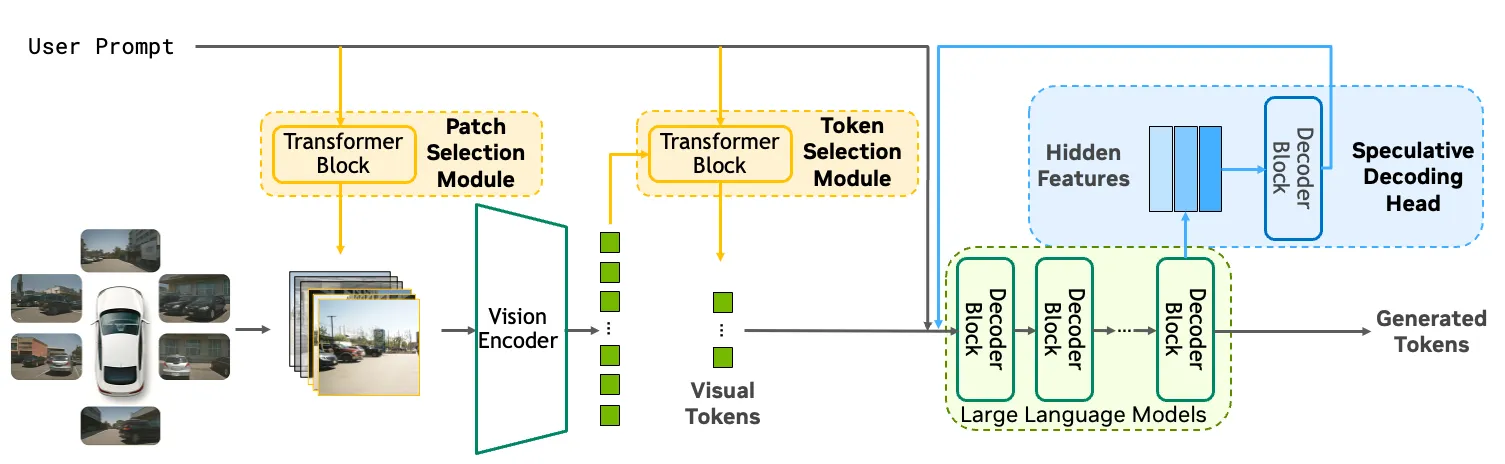
Figure 1: LiteVLM框架基于标准VLM,引入两个新模块(橙色高亮):Patch Selection Module和Token Selection Module,以及Speculative Decoding Head(蓝色高亮),共同实现实时应用的高效token生成。
核心模块详解
3.1 Patch Selection Module(补丁选择模块)
设计动机:当前VLM通常将视觉输入划分为固定网格的patch,这种与查询无关的方式效率低下——许多查询仅涉及特定相机视角,导致不相关视角的处理浪费计算资源。
核心思想:查询语义通常暗示空间焦点。模块在图像编码前,仅根据输入文本查询动态识别相关相机视角。
架构细节:
- 采用4层Transformer编码器
- 输入文本查询经tokenization后送入Transformer编码器
- 使用N个可学习的潜在查询向量(N为多视角感知设置中的相机数量,如自动驾驶场景中N=6)
- 潜在查询向量与文本编码进行交叉注意力
- 结果注意力分数通过MLP层映射为N个二分类结果
训练方式:
- 独立于VLM微调之前进行训练
- 使用Binary Cross-Entropy (BCE)损失函数,对N个视角的损失求和
- 标注生成采用混合策略:先通过关键词匹配将问题文本中的空间词汇映射到对应相机视角,再使用GPT-4增强标注
损失函数:
其中为第个视角的预测分数,为对应的真实标签。
推理过程:最终分数为词汇映射和模块logits的加权和,通过阈值决定选择哪些视角。
3.2 Token Selection Module(视觉token选择模块)
设计动机:经过Patch Selection后,送入LLM的视觉token序列仍然可能很长。
核心方法:
- 从微调后的LLM中提取第一层解码器,实例化为独立的选择模块
- 该模块对视觉token进行注意力计算,基于注意力分数选择最重要的token
- 使用合成真实标签进行训练——通过自注意力分析确定哪些token对最终输出最重要
关键优势:
- 独立设计,保持LLM执行图的完整性,便于部署优化
- 不需要修改原始LLM结构
- 训练信号通过DropoP方法生成
压缩比率:
- FP16部署:压缩比r=0.8(保留80%的视觉token)
- FP8部署:压缩比r=0.9(保留90%的视觉token)
对比基线FastV需要r=0.3(仅保留30%)才能达到类似token数量,但会因丢失重要视觉信息而降低精度。
3.3 Speculative Decoding Head(投机解码头)
设计动机:即使token压缩显著降低了prefill延迟,对生成(decode)阶段的加速有限——3倍输入token减少仅带来1.1倍的extend-one-token加速。
核心方法:
- 基于Eagle-2方法论
- 使用单层解码器作为轻量级草稿模型
- 生成时,草稿模型接收当前LLM隐藏状态和嵌入,预测候选token序列
- 目标LLM验证这些候选token,接受正确的预测
性能指标:
- 平均4倍投机长度,每轮迭代接受3.8个token
- 生成延迟从16.9ms降至9.0ms
- 平均extend-one延迟进一步降至7.7ms(FP16)和6.2ms(FP8)
核心公式
Patch Selection的交叉注意力:
其中为N个可学习的潜在查询向量,来自文本编码。
Token Selection的注意力分数:
其中为LLM第一层解码器的隐藏状态,为第个视觉token。
投机解码的验证机制:
- 草稿模型生成候选token序列
- 目标LLM并行验证所有候选token
- 接受最长的正确前缀,拒绝第一个错误token后重新采样
训练流程
基座模型:InternVL2.5 2B模型
- InternViT编码器:300M参数
- InternLM2.5解码器:1.8B参数
训练配置:
- 硬件:8 x NVIDIA A100 GPUs
- 训练步数:15,000步
- 每设备batch size:4
- 图像预处理:每张相机图像resize至448x448像素,拼接为2行3列的复合图像
训练阶段:
- Patch Selection Module预训练:使用混合标注策略(关键词匹配+GPT-4增强)训练视角选择能力
- VLM微调:在DriveLM数据集上微调InternVL2.5
- Token Selection Module训练:基于微调后的LLM第一层解码器,使用DropoP方法生成合成标签
- Speculative Decoding Head训练:训练单层草稿模型学习预测候选token
部署平台
- 硬件:NVIDIA DRIVE Thor平台
- 推理引擎:自定义TensorRT构建
- 模型优化:TensorRT Model Optimizer工具包
- 量化:FP8 post-training quantization
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Patch Selection Module | 根据文本查询动态选择相关相机视角,在ViT编码前过滤不相关输入 | 平均仅需3.5个patch(从12个减少),ViT延迟降低3.0倍 |
| Token Selection Module | 从LLM提取第一层解码器作为独立选择模块,基于注意力分数选择关键视觉token | 独立设计保持LLM执行图完整性,FP16下r=0.8即可达到与FastV(r=0.3)相当的token数 |
| 三种技术协同 | Patch选择+Token选择+投机解码联合优化,覆盖VLM推理全流程 | 端到端2.5倍延迟降低(FP16),3.2倍(FP8),精度损失极小 |
| 合成标签生成 | 使用DropoP方法为Token Selection Module生成训练信号,避免额外标注成本 | 无需人工标注即可训练有效的token选择能力 |
| 混合视角标注 | 关键词匹配+GPT-4增强的混合策略生成Patch Selection的真实标签 | 结合规则方法的精确性和LLM的泛化能力 |
五、实验结果
数据集
- DriveLM数据集:包含推理、感知、预测和规划能力的问答对
- 验证集:150个场景,每场景100个QA对,共15K QA对
- 训练集:约210K QA对
- 评估指标:
- GPT-4相关度分数
- 语言分数(BLEU, ROUGE-L, CIDEr)
- Match score
- 综合分数(0.0-1.0,加权平均)
核心结果(NVIDIA DRIVE Thor平台)
| 方法 | 平均Patch数 | ViT延迟(ms) | 平均输入Token数 | Prefill延迟(ms) | Extend-One延迟(ms) | Decode延迟(ms) | 选择模块延迟(ms) | 总延迟(ms) | 加速比 | 综合精度 |
|---|---|---|---|---|---|---|---|---|---|---|
| VLM 2B (基线) | 12 | 136.9 | 3214 | 163.2 | 16.9 | 229.6 | - | 529.7 | 1.0x | 0.6618 |
| VLM 2B + FastV (r=0.7) | 12 | 136.9 | 2292 | 117.9 | 16.4 | 222.8 | - | 477.6 | 1.1x | 0.6610 |
| VLM 2B + FastV (r=0.3) | 12 | 136.9 | 1063 | 59.5 | 15.9 | 216.1 | - | 412.5 | 1.3x | 0.6468 |
| VLM 2B + Eagle | 12 | 136.9 | 3214 | 163.2 | 9.0 | 121.4 | - | 421.5 | 1.3x | 0.6618 |
| LiteVLM | 3.5 | 45.1 | 858 | 54.2 | 7.7 | 104.1 | 10.2 | 213.6 | 2.5x | 0.6602 |
| LiteVLM (FP8) | 3.5 | 29.1 | 948 | 39.8 | 6.2 | 84.0 | 10.2 | 163.1 | 3.2x | 0.6450 |
延迟分析
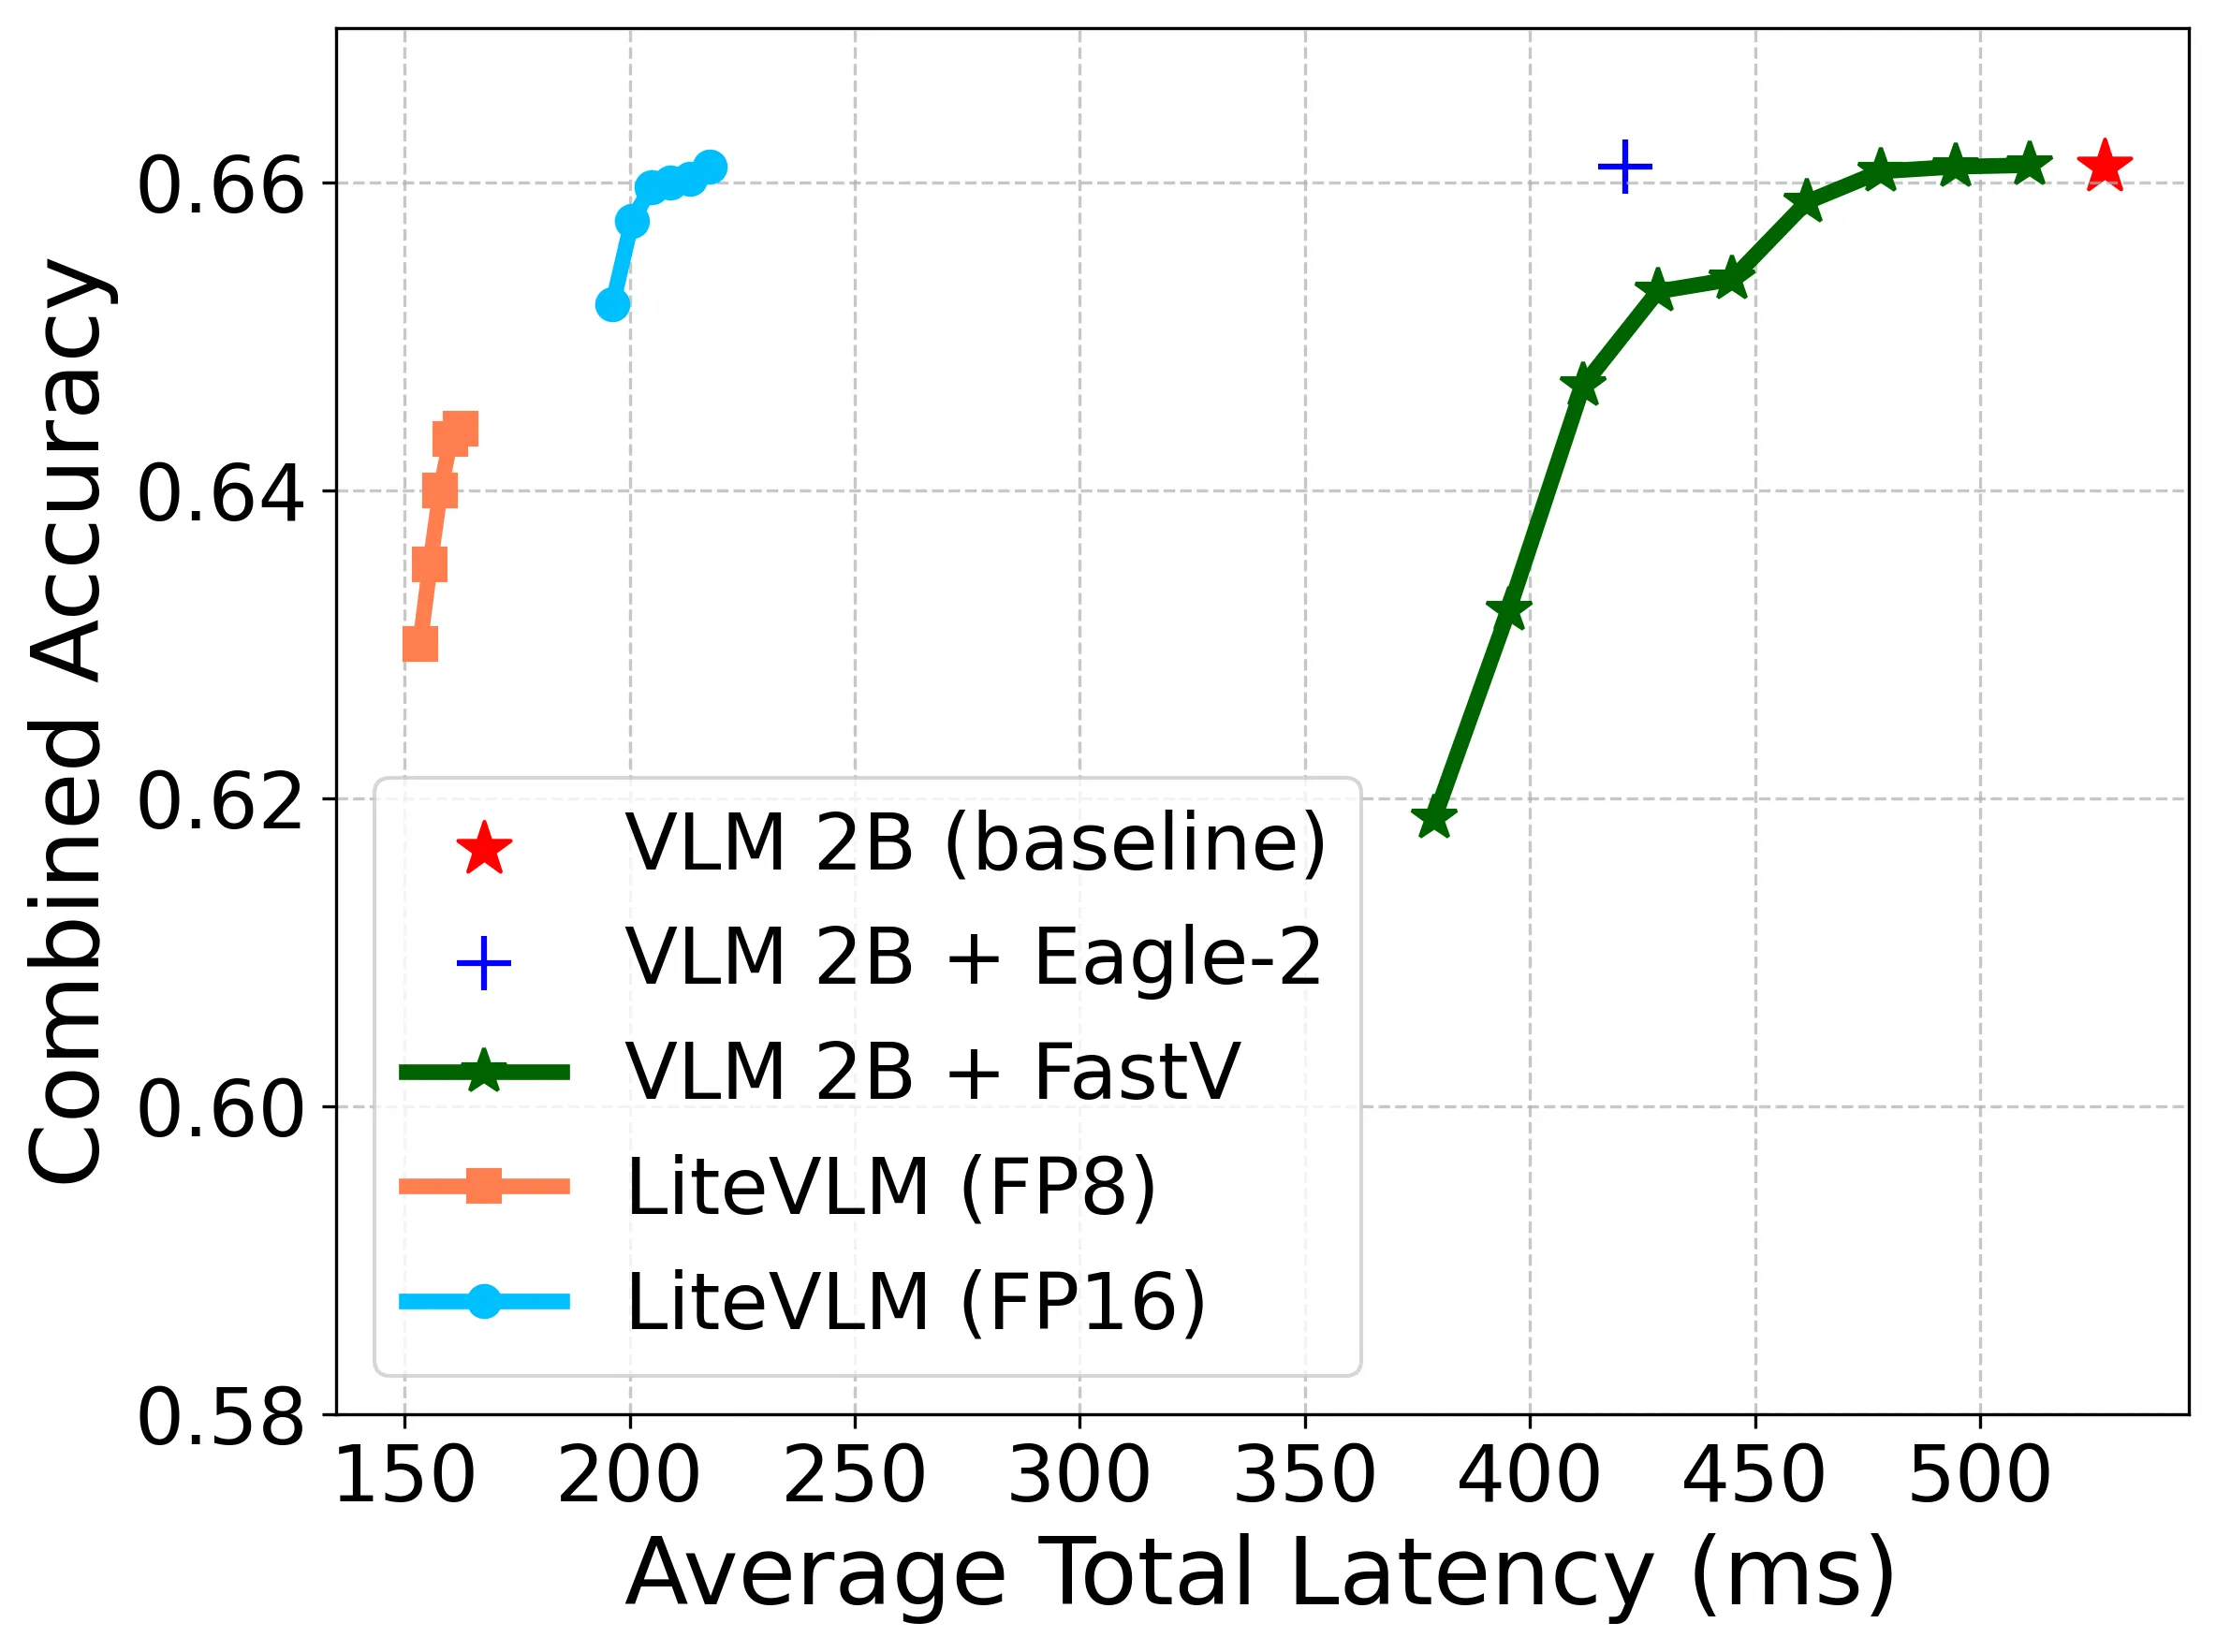
Figure 2: LiteVLM流水线与基线2B VLMs在不同配置下的平均端到端延迟对比。
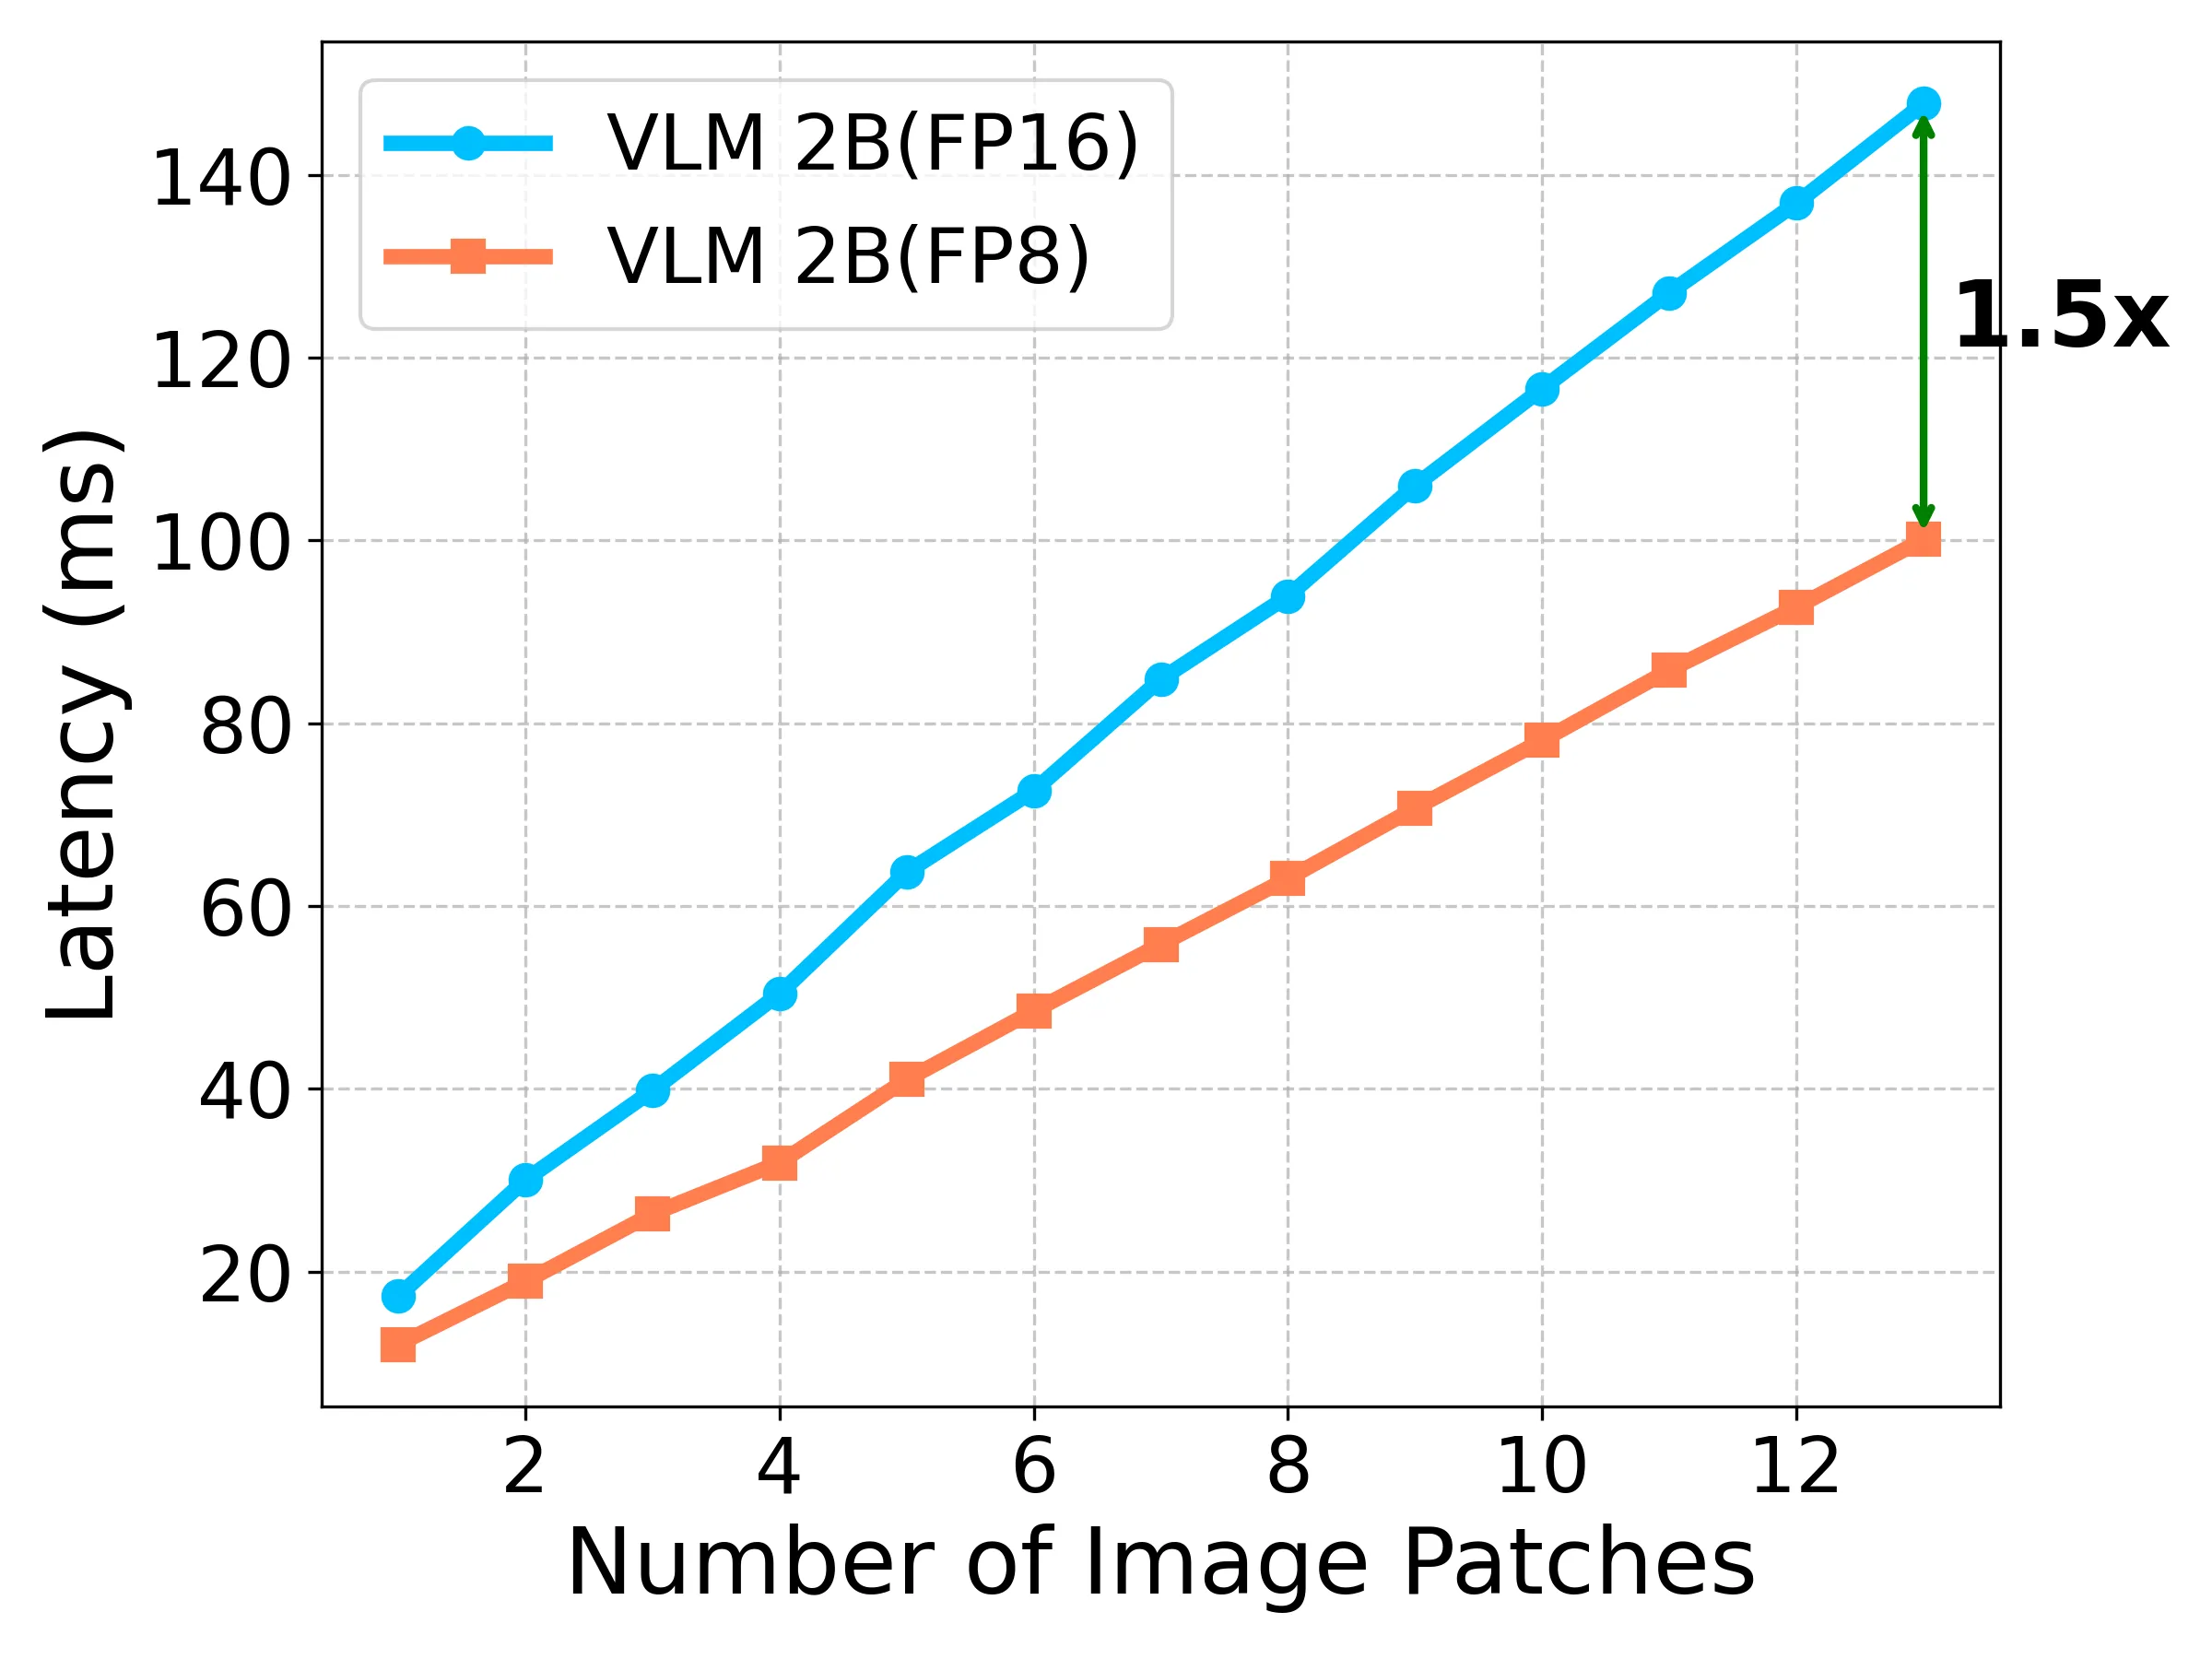
(a) Vision Encoder Latency: ViT延迟随输入patch数量近似线性变化。
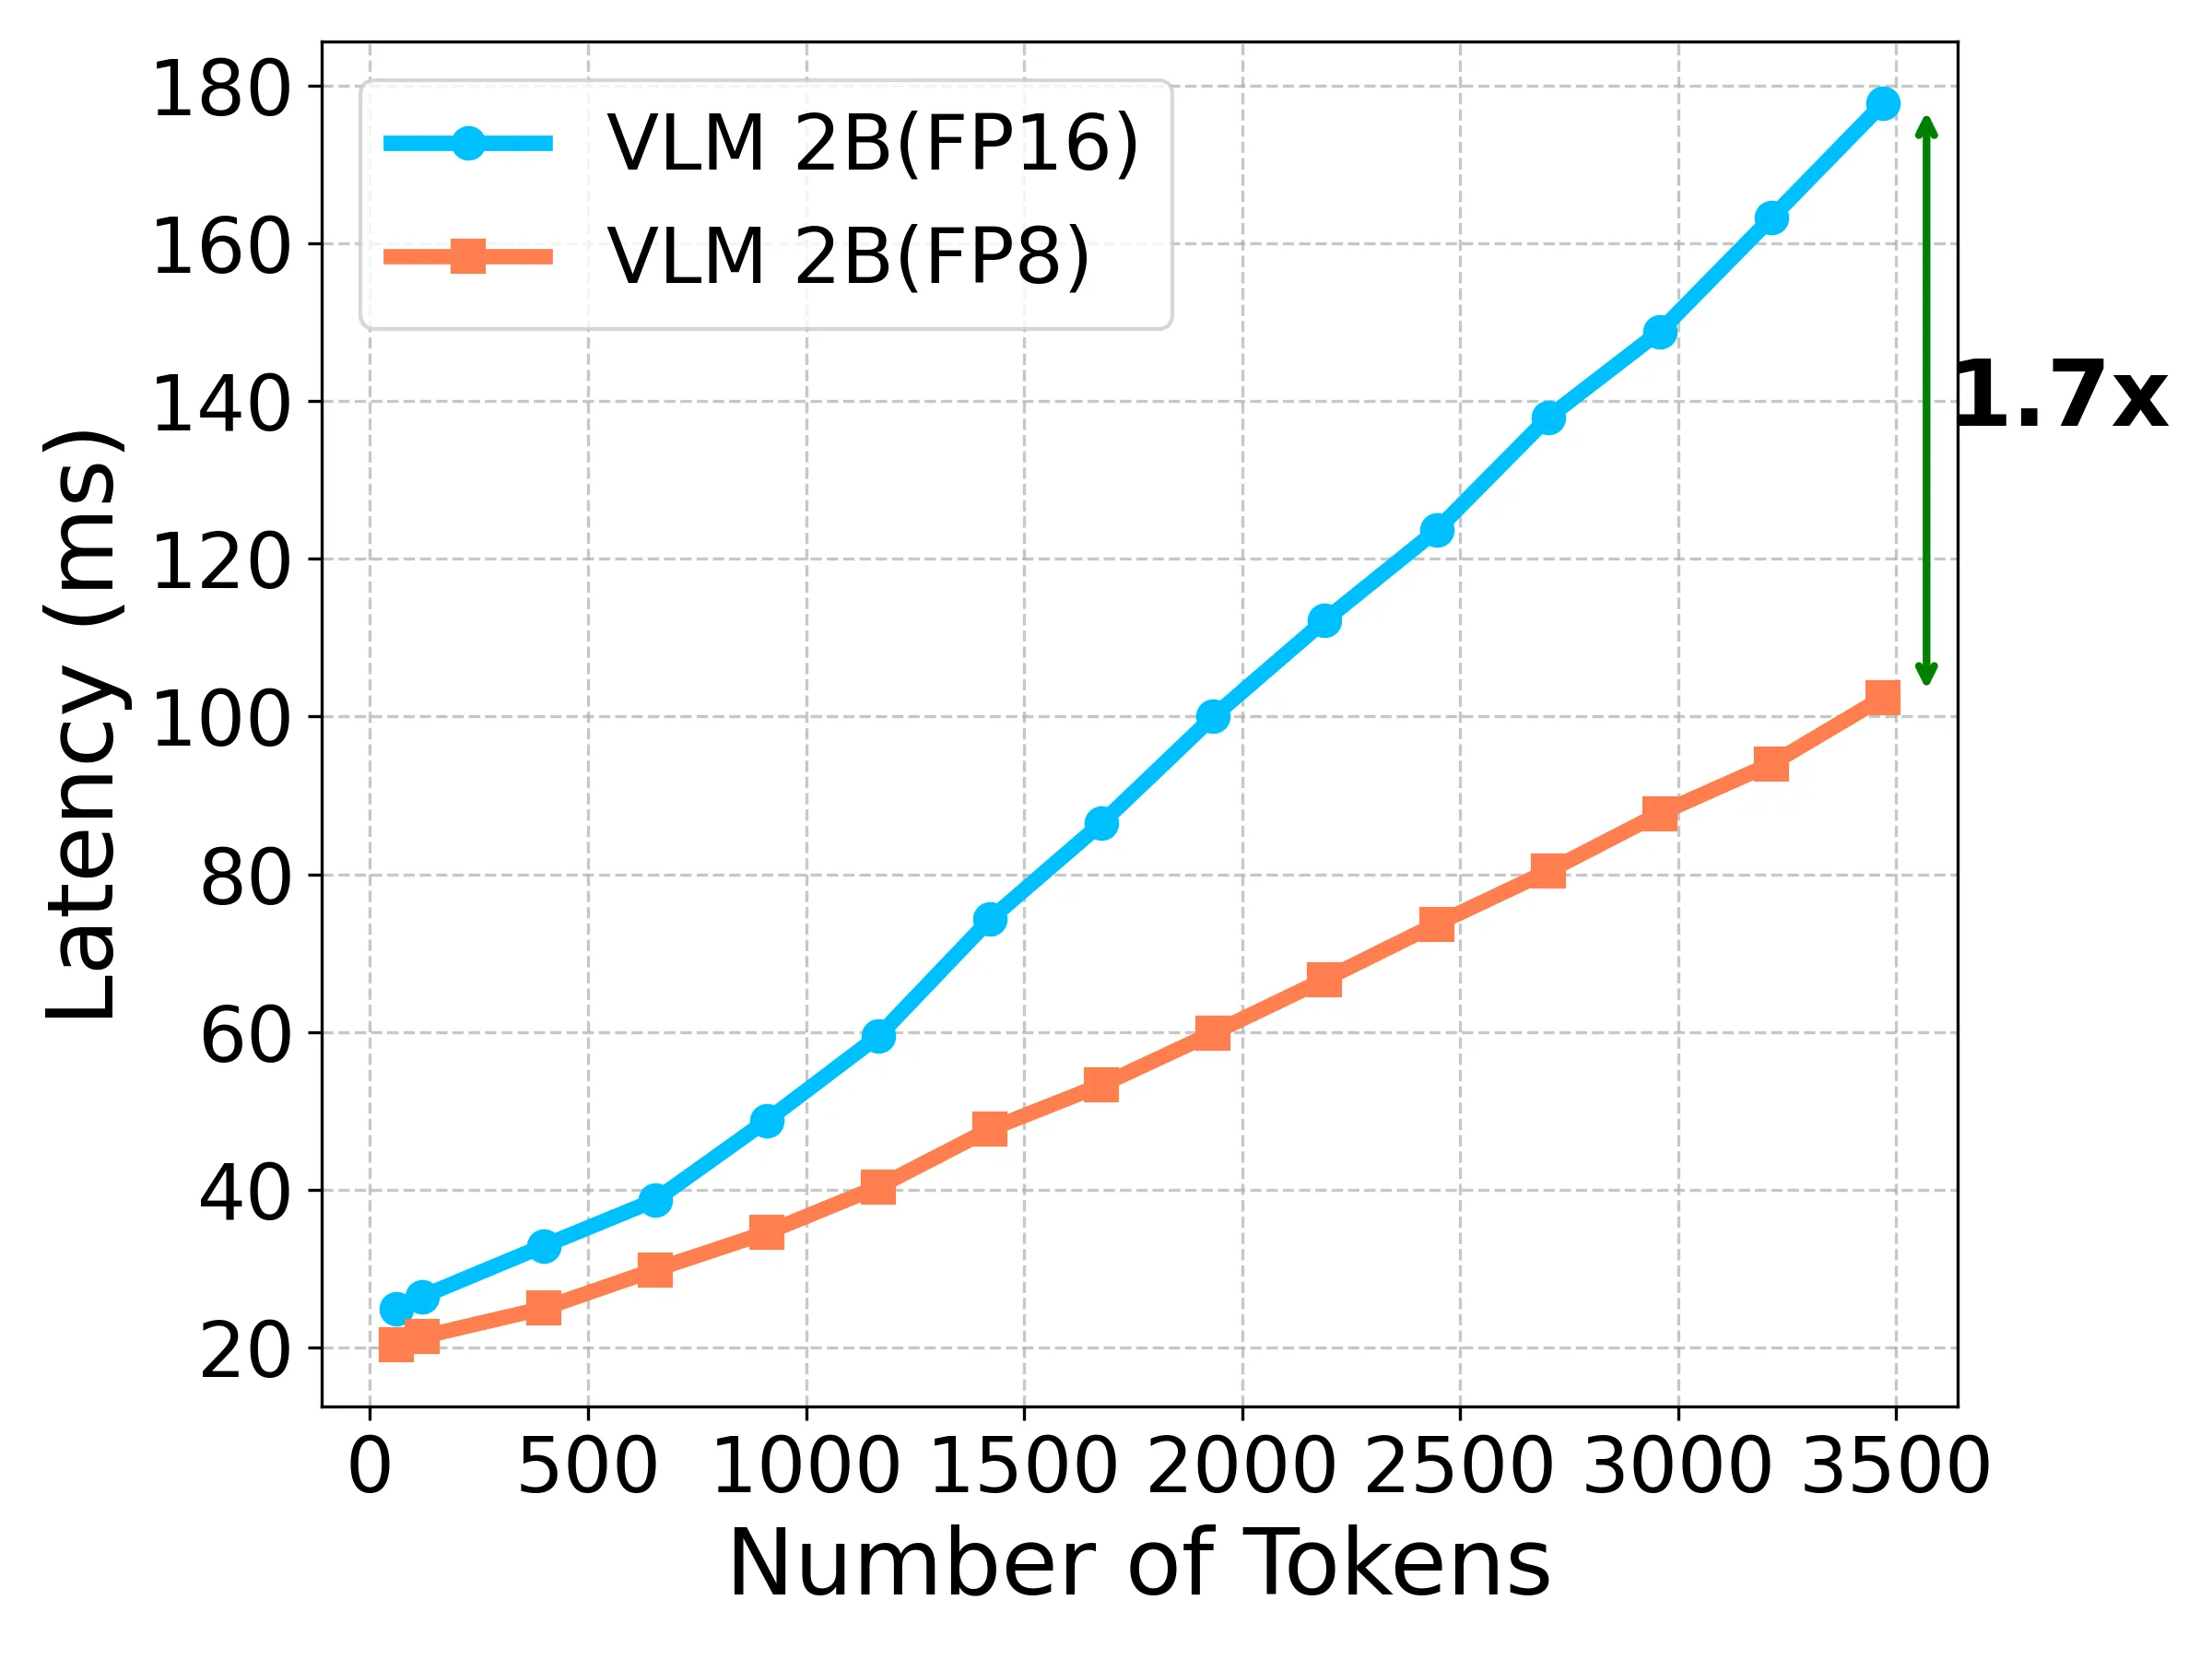
(b) LLM Prefill stage Latency: Token压缩显著降低prefill延迟。
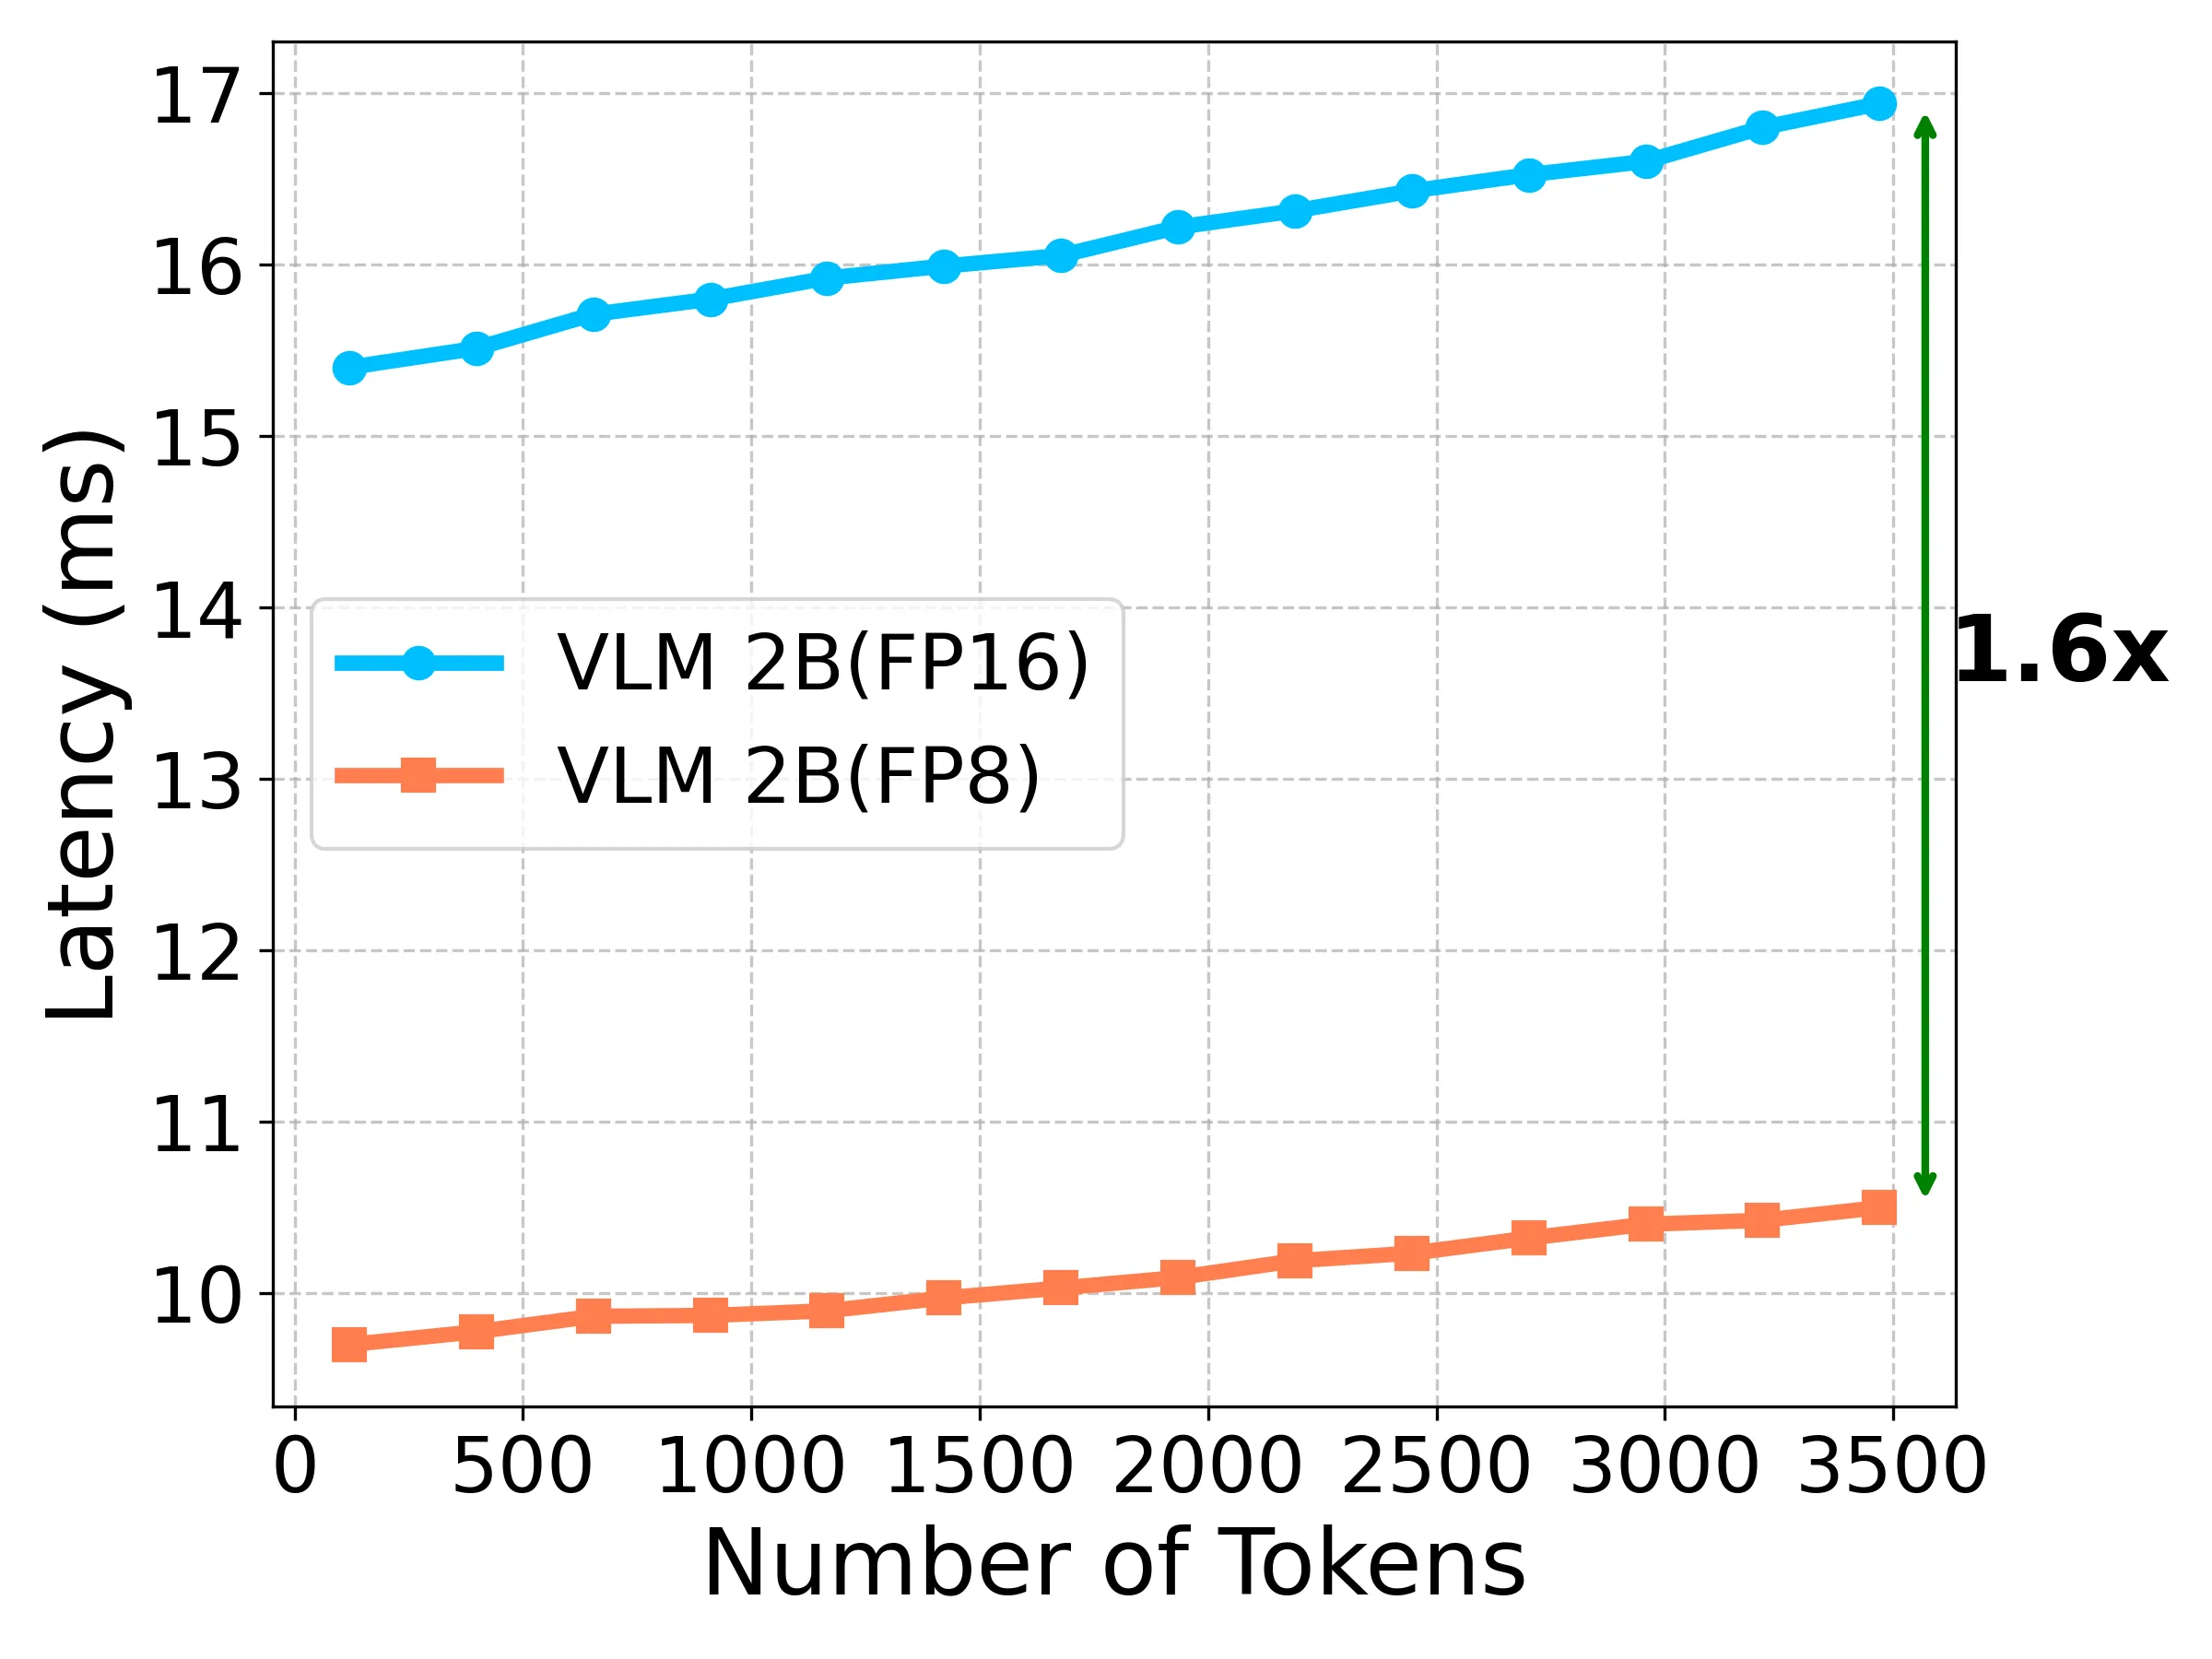
(c) LLM Extend-One-Token Latency: FP8量化在各阶段均带来额外加速。
各模块贡献分析
Patch Selection Module:
- 从12个patch减少到平均3.5个
- ViT延迟从136.9ms降至45.1ms,3.0倍加速
- 精度保持不变(仅过滤不相关视角)
Token Selection Module:
- FP16: 输入token从3214降至858(压缩比r=0.8)
- Prefill延迟从163.2ms降至54.2ms
- 对比FastV(r=0.3)仅需温和压缩即可达到类似token数
Speculative Decoding:
- 平均4倍投机长度,接受3.8个token/迭代
- 生成延迟从229.6ms降至104.1ms(含选择模块10.2ms)
- Extend-one延迟从16.9ms降至7.7ms(FP16)和6.2ms(FP8)
FP8量化:
- ViT延迟:1.5倍加速
- LLM Prefill:1.3-1.7倍加速(平均1.6倍)
- 整体额外加速从2.5倍提升至3.2倍
内存消耗
| 组件 | FP16内存 | 最大激活 |
|---|---|---|
| ViT引擎(1B/2B) | 588.80 MiB | 866 MiB |
| 0.5B Qwen2引擎 | 1.21 GiB | 162 MiB |
| 1.8B InternLM2.5引擎 | 3.62 GiB | 288 MiB |
| KV-Cache (1B模型) | 252 MiB | - |
| KV-Cache (2B模型) | 864 MiB | - |
FP8部署可将内存消耗减半。
六、总结
核心贡献
- 提出LiteVLM架构:通过联合利用patch选择、token选择和投机解码三种互补技术,构建高效的VLM推理流水线
- Patch Selection Module创新:首次在VLM中引入基于文本查询的动态视角选择,显著减少视觉编码计算量
- 独立Token Selection Module设计:从LLM提取第一层解码器作为独立模块,保持执行图完整性,便于部署优化
- 端到端优化验证:在NVIDIA DRIVE Thor平台上实现2.5倍(FP16)和3.2倍(FP8)延迟降低,综合精度仅下降0.16%(0.6618->0.6602)
- 自动驾驶应用验证:针对自动驾驶场景的多视角输入进行专门优化,证明方案在实际嵌入式平台的可行性
技术影响
- 边缘AI部署:为资源受限环境下的VLM部署提供了实用的加速方案
- 多模态推理优化:提出的三种技术可独立或组合使用,具有良好的通用性
- 自动驾驶智能化:使VLM在车载平台上的实时推理成为可能,推动自动驾驶感知与决策的智能化
局限性
- 任务特异性:Patch Selection Module主要针对多视角场景(如自动驾驶),通用VQA任务需要额外的空间推理适配
- 精度权衡:FP8量化带来约1.7%的精度下降(0.6618->0.6450),可能需要quantization-aware training来缓解
- 模型规模:实验基于2B参数模型,更大模型上的效果需要进一步验证
- 数据集局限:仅在DriveLM数据集上验证,其他VLM benchmark上的表现未知
七、参考资源
论文链接
- arXiv: https://arxiv.org/abs/2506.07416
- PDF: https://arxiv.org/pdf/2506.07416
- HTML: https://arxiv.org/html/2506.07416v2
相关工作
- InternVL2.5: arXiv:2412.05271 - 基座VLM模型
- FastV: 视觉token压缩基线方法
- Eagle/Eagle-2: arXiv:2401.15077 / EMNLP 2024 - 投机解码方法
- DriveLM: 自动驾驶VLM评估数据集
关键技术组件
- TensorRT: NVIDIA高性能推理引擎
- TensorRT Model Optimizer: https://github.com/NVIDIA/TensorRT-Model-Optimizer
- NVIDIA DRIVE Thor: 自动驾驶计算平台
相关论文引用
- [1] Arif et al. 2024. Hired: Attention-guided token dropping for efficient inference. arXiv:2408.10945
- [2] Bai et al. 2023. Qwen-VL: A versatile vision-language model. 2023.
- [6] Chen et al. 2024a. An image is worth 1/2 tokens after layer 2. ECCV 2024.
- [7] Chen et al. 2023. InternVL: Scaling up vision foundation models. CVPR 2024.
- [8] Chen et al. 2024b. InternVL2.5. arXiv:2412.05271.
- [9] Dosovitskiy et al. 2020. An image is worth 16x16 words: ViT. arXiv:2010.11929.
- [14] Li et al. 2023. BLIP-2: Bootstrapping language-image pre-training. ICML 2023.
- [16] Li et al. 2024b. Eagle-2: Faster inference with dynamic draft trees. EMNLP 2024.
- [17] Li et al. 2024c. Eagle: Speculative sampling requires rethinking feature uncertainty. arXiv:2401.15077
- [27] DriveLM: 自动驾驶VLM问答数据集