FlashMoE: Fast Distributed MoE in a Single Kernel
首个完全融合的分布式MoE算子,将专家计算和GPU间通信融合为单一持久化GPU内核
FlashMoE: Fast Distributed MoE in a Single Kernel
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FlashMoE: Fast Distributed MoE in a Single Kernel |
| 作者 | Osayamen Jonathan Aimuyo, Byungsoo Oh, Rachee Singh |
| 机构 | Cornell University |
| 论文 | arXiv:2506.04667 |
| 代码 | GitHub |
| 发布 | 2025-06-05 (v1), 2025-11-08 (v3) |
| 会议 | NeurIPS 2025 |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
现代大语言模型(LLM)广泛采用混合专家(MoE)架构,因其计算稀疏性使得计算成本随模型规模亚线性增长。然而,现有分布式MoE实现存在三个关键瓶颈:
- 通信开销:AlltoAll等同步集合通信操作占总运行时间高达68%,且对straggler延迟极度敏感
- 内核启动开销:单层前向传播需启动多达550个短生命周期内核,导致非确定性启动时间和不必要的同步点
- GPU利用率低:现有系统仅实现26%的tensor core利用率,GPU大部分时间处于空闲状态
解决方案概述
FlashMoE提出完全融合的分布式MoE算子,将专家计算和GPU间通信融合为单一持久化GPU内核。核心创新包括:
- Actor并发模型:将GPU线程块特化为Processor、Subscriber、Scheduler三种角色
- 细粒度流水线:在tile粒度上实现dispatch、compute、combine三阶段的流水线执行
- 设备发起的(R)DMA:用单边设备发起通信替代同步集合通信,消除straggler效应
- 负载均衡调度器:多线程、工作保持的调度器确保高GPU SM利用率
三、技术架构
整体框架图
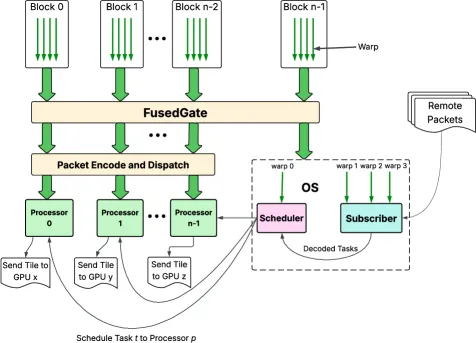
Figure 5: FlashMoE融合内核架构,展示三种Actor角色的协作关系。
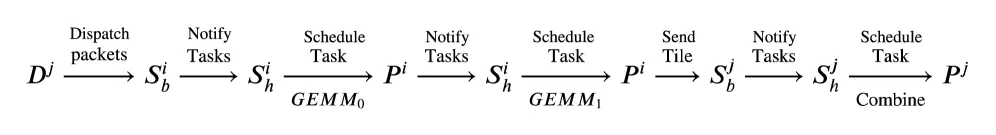
Figure 6: DMoE功能依赖关系,表示为Actor交互链。(Subscriber)、(Scheduler)和(Processor)之间的tile粒度任务依赖。
核心公式
输入定义:
- :输入/输出token矩阵
- :专家权重3D张量(E=本地专家数,H=嵌入维度,D=FFN中间维度,S=序列长度)
- :路由表,表示token i在slot c路由到专家e
- :门控网络产生的亲和度分数
Algorithm 1 - FlashMoE融合内核:
Input: A, O ∈ ℝ^(S×H), X ∈ ℝ^(E×H×D), N
1: begin
2:   T_φ, G_φ ← FusedGate(A)
3:   if blockId + 1 < N then
4:     Dispatch(T_φ, A)
5:     processor::start()
6:   else
7:     if warpID == 0 then
8:       scheduler::start()
9:     else
10:      subscriber::start(T_φ, G_φ, O, X)
11:    end if
12:  end if
13: end
Overlap Efficiency定义: 其中是在个GPU上的延迟,是在2个GPU上的延迟。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Processor | 执行计算(GEMM和元素操作)和tile通信 | N-1个线程块,使用CUTLASS和NVSHMEM |
| Scheduler | 多线程、工作保持的调度器,分配计算任务 | 1个warp,确保高SM利用率 |
| Subscriber | 解码来自远程GPU的tile包为任务描述符 | 3个warps |
| OS Block | 最后一个线程块,包含Scheduler和Subscriber | 管理任务调度和通信 |
| FusedGate | 融合的门控网络计算 | 产生路由表T_φ和亲和度G_φ |
训练/推理流程
FlashMoE的执行流程:
- FusedGate阶段:计算门控网络,生成路由表和亲和度分数
- Dispatch阶段:将token分发到对应的专家GPU,使用NVSHMEM进行设备发起的(R)DMA传输
- Compute阶段:Processor执行GEMM_0(上投影)和GEMM_1(下投影)计算
- Combine阶段:将专家输出聚合回原始token顺序
关键设计选择:
- Tile维度:(128, 64),经过参数扫描优化
- 通信粒度:tile级别的单边传输,而非批量集合通信
- 调度策略:工作保持调度,SM可乱序执行就绪任务
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 完全内核融合 | 首个将整个分布式MoE算子融合为单一持久化内核的方案 | 单次内核启动 vs 基线的550次启动 |
| Actor并发模型 | 将GPU线程块特化为三种角色,实现计算与通信的细粒度重叠 | 93.17% SM利用率 vs 基线的9.67%-59.11% |
| 设备发起通信 | 用NVSHMEM单边(R)DMA替代同步集合通信 | 消除straggler效应和同步开销 |
| Payload效率 | 消除稀疏激活层中的冗余网络负载 | FP32下仍优于FP16基线 |
| 负载均衡调度 | 多线程工作保持调度器 | 确保SM持续执行有效工作 |
五、代码实现分析
项目结构
FlashMoE/
├── src/
│   ├── include/           # 头文件
│   ├── kernel/            # CUDA内核实现
│   ├── benchmark/         # 性能基准测试
│   └── ...
├── CMakeLists.txt         # 构建配置
├── README.md
└── LICENSE
技术栈
- CUDA C++:核心实现语言,含内联PTX
- cuBLASDx:设备端高性能BLAS计算
- NVSHMEM:异步设备发起通信
- CCCL/CUTLASS:关键基础设施
- 要求:CUDA toolkit, C++20, ninja, CMake >= 3.28
硬件要求
- SM 70及以上GPU
- P2P GPU互连(NVLink、部分PCIe、GPUDirect RDMA)
- 支持:SM70+, NVLink, 多节点RDMA (EFA, IBGDA, libfabric)
- 精度支持:FP16, BF16, FP32 (TF32), FP64
六、实验结果
实验设置
- 硬件:8× NVIDIA H100 80G GPU,NVLink互连,125GB RAM,20 vCPUs
- 软件:PyTorch 2.6.0, CUDA 12.8, Ubuntu 22.04
- 模型配置:16注意力头,嵌入维度2048,FFN中间维度2048
- 路由:top-2路由,容量因子1.0
- 测量:32次warmup后的32次前向传播平均值
基准测试对比
| 指标 | FlashMoE | 最佳基线 | 加速比 |
|---|---|---|---|
| 前向延迟 (4 GPU) | 最优 | Megatron-TE | 4.6× @ 16K tokens |
| 前向延迟 (8 GPU) | 最优 | FasterMoE | 6.4× @ 16K tokens |
| SM利用率 | 93.17% | Comet 42.31% | 2.2× |
| 吞吐量 (8 GPU) | 17.7 MTokens/s | FasterMoE | 5.7× |
| 重叠效率 (8 GPU) | 最优 | Megatron-TE | 4× |
GPU利用率
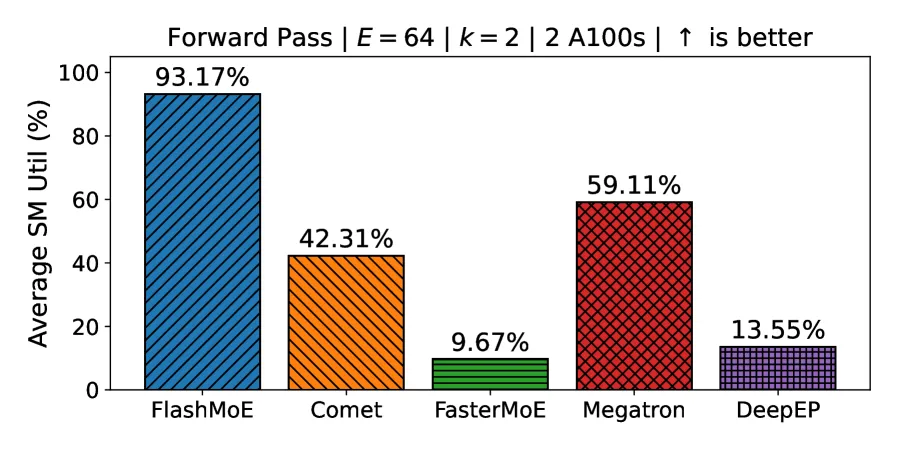
Figure 9: SM利用率对比。FlashMoE达到93.17%,比FasterMoE (9.67%)高9×,比DeepEP+Megatron-LM (13.55%)高6.8×,比Megatron-TE (59.11%)高4×,比Comet (42.31%)高2.2×。
前向延迟
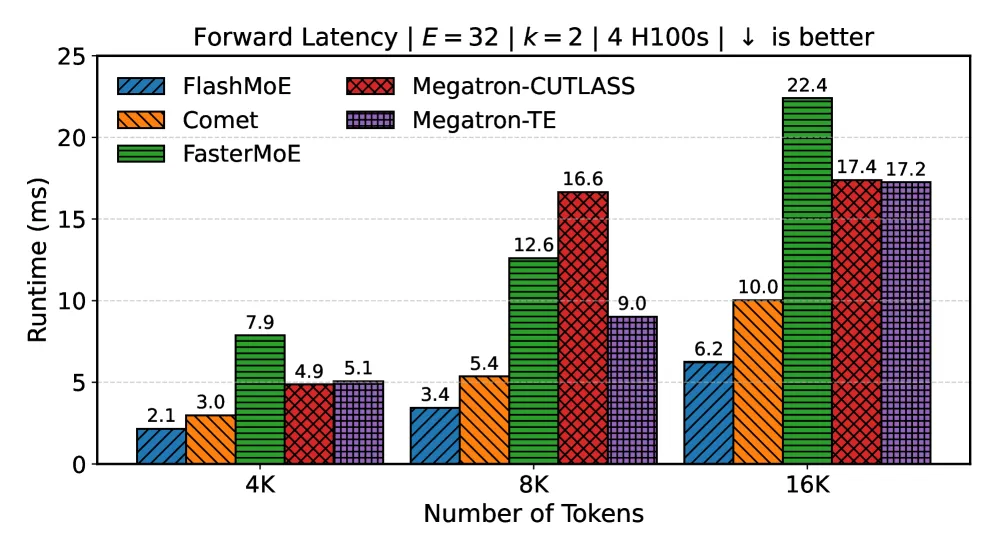
Figure 8(a): 4 H100 GPU上前向延迟随token数变化。
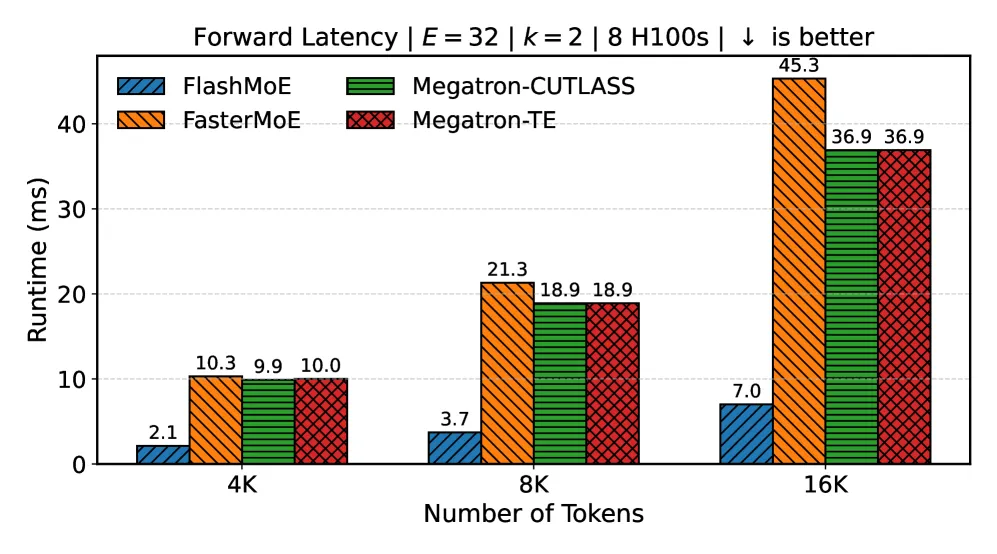
Figure 8(b): 8 H100 GPU上前向延迟随token数变化。
吞吐量扩展
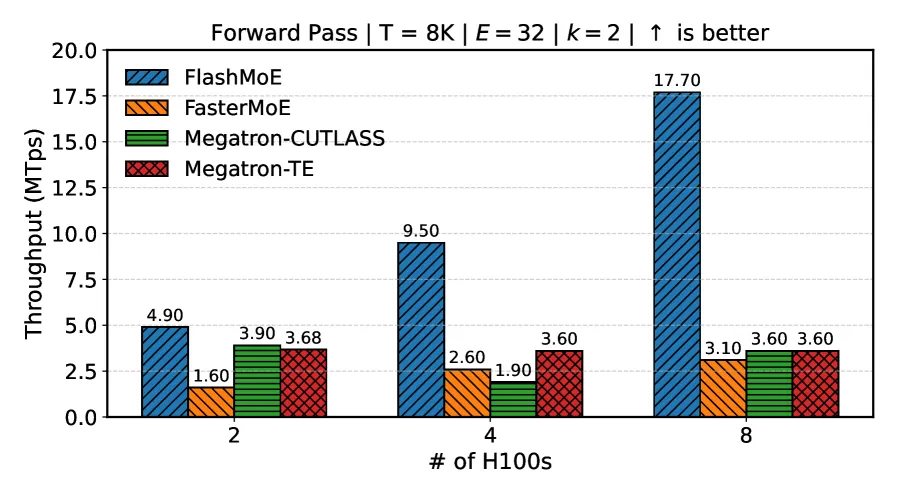
Figure 10: 吞吐量随GPU数量扩展。FlashMoE在8 GPU达到17.7 MTokens/s,线性扩展。
专家可扩展性
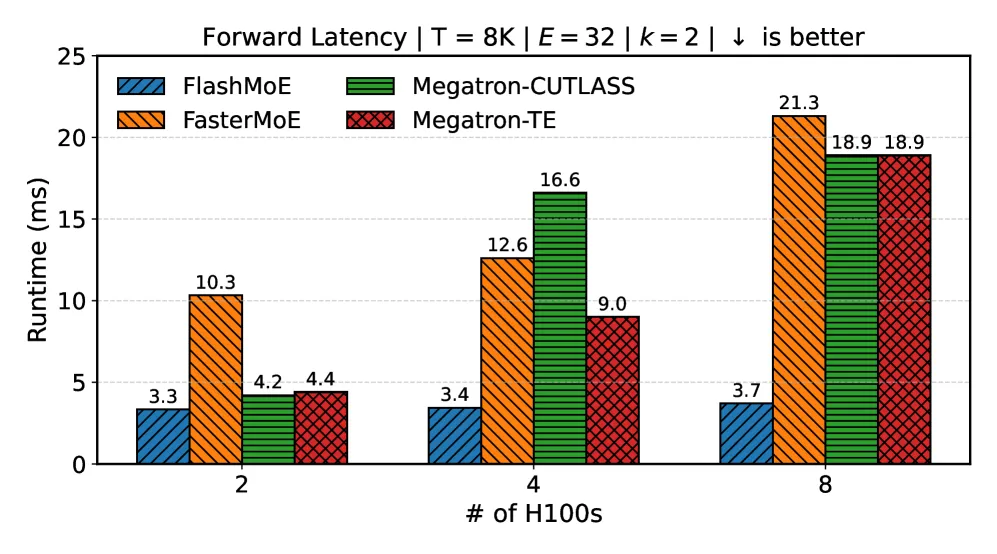
Figure 12: 前向延迟随专家数增加。FlashMoE保持低延迟,而基线呈超线性增长。
重叠效率
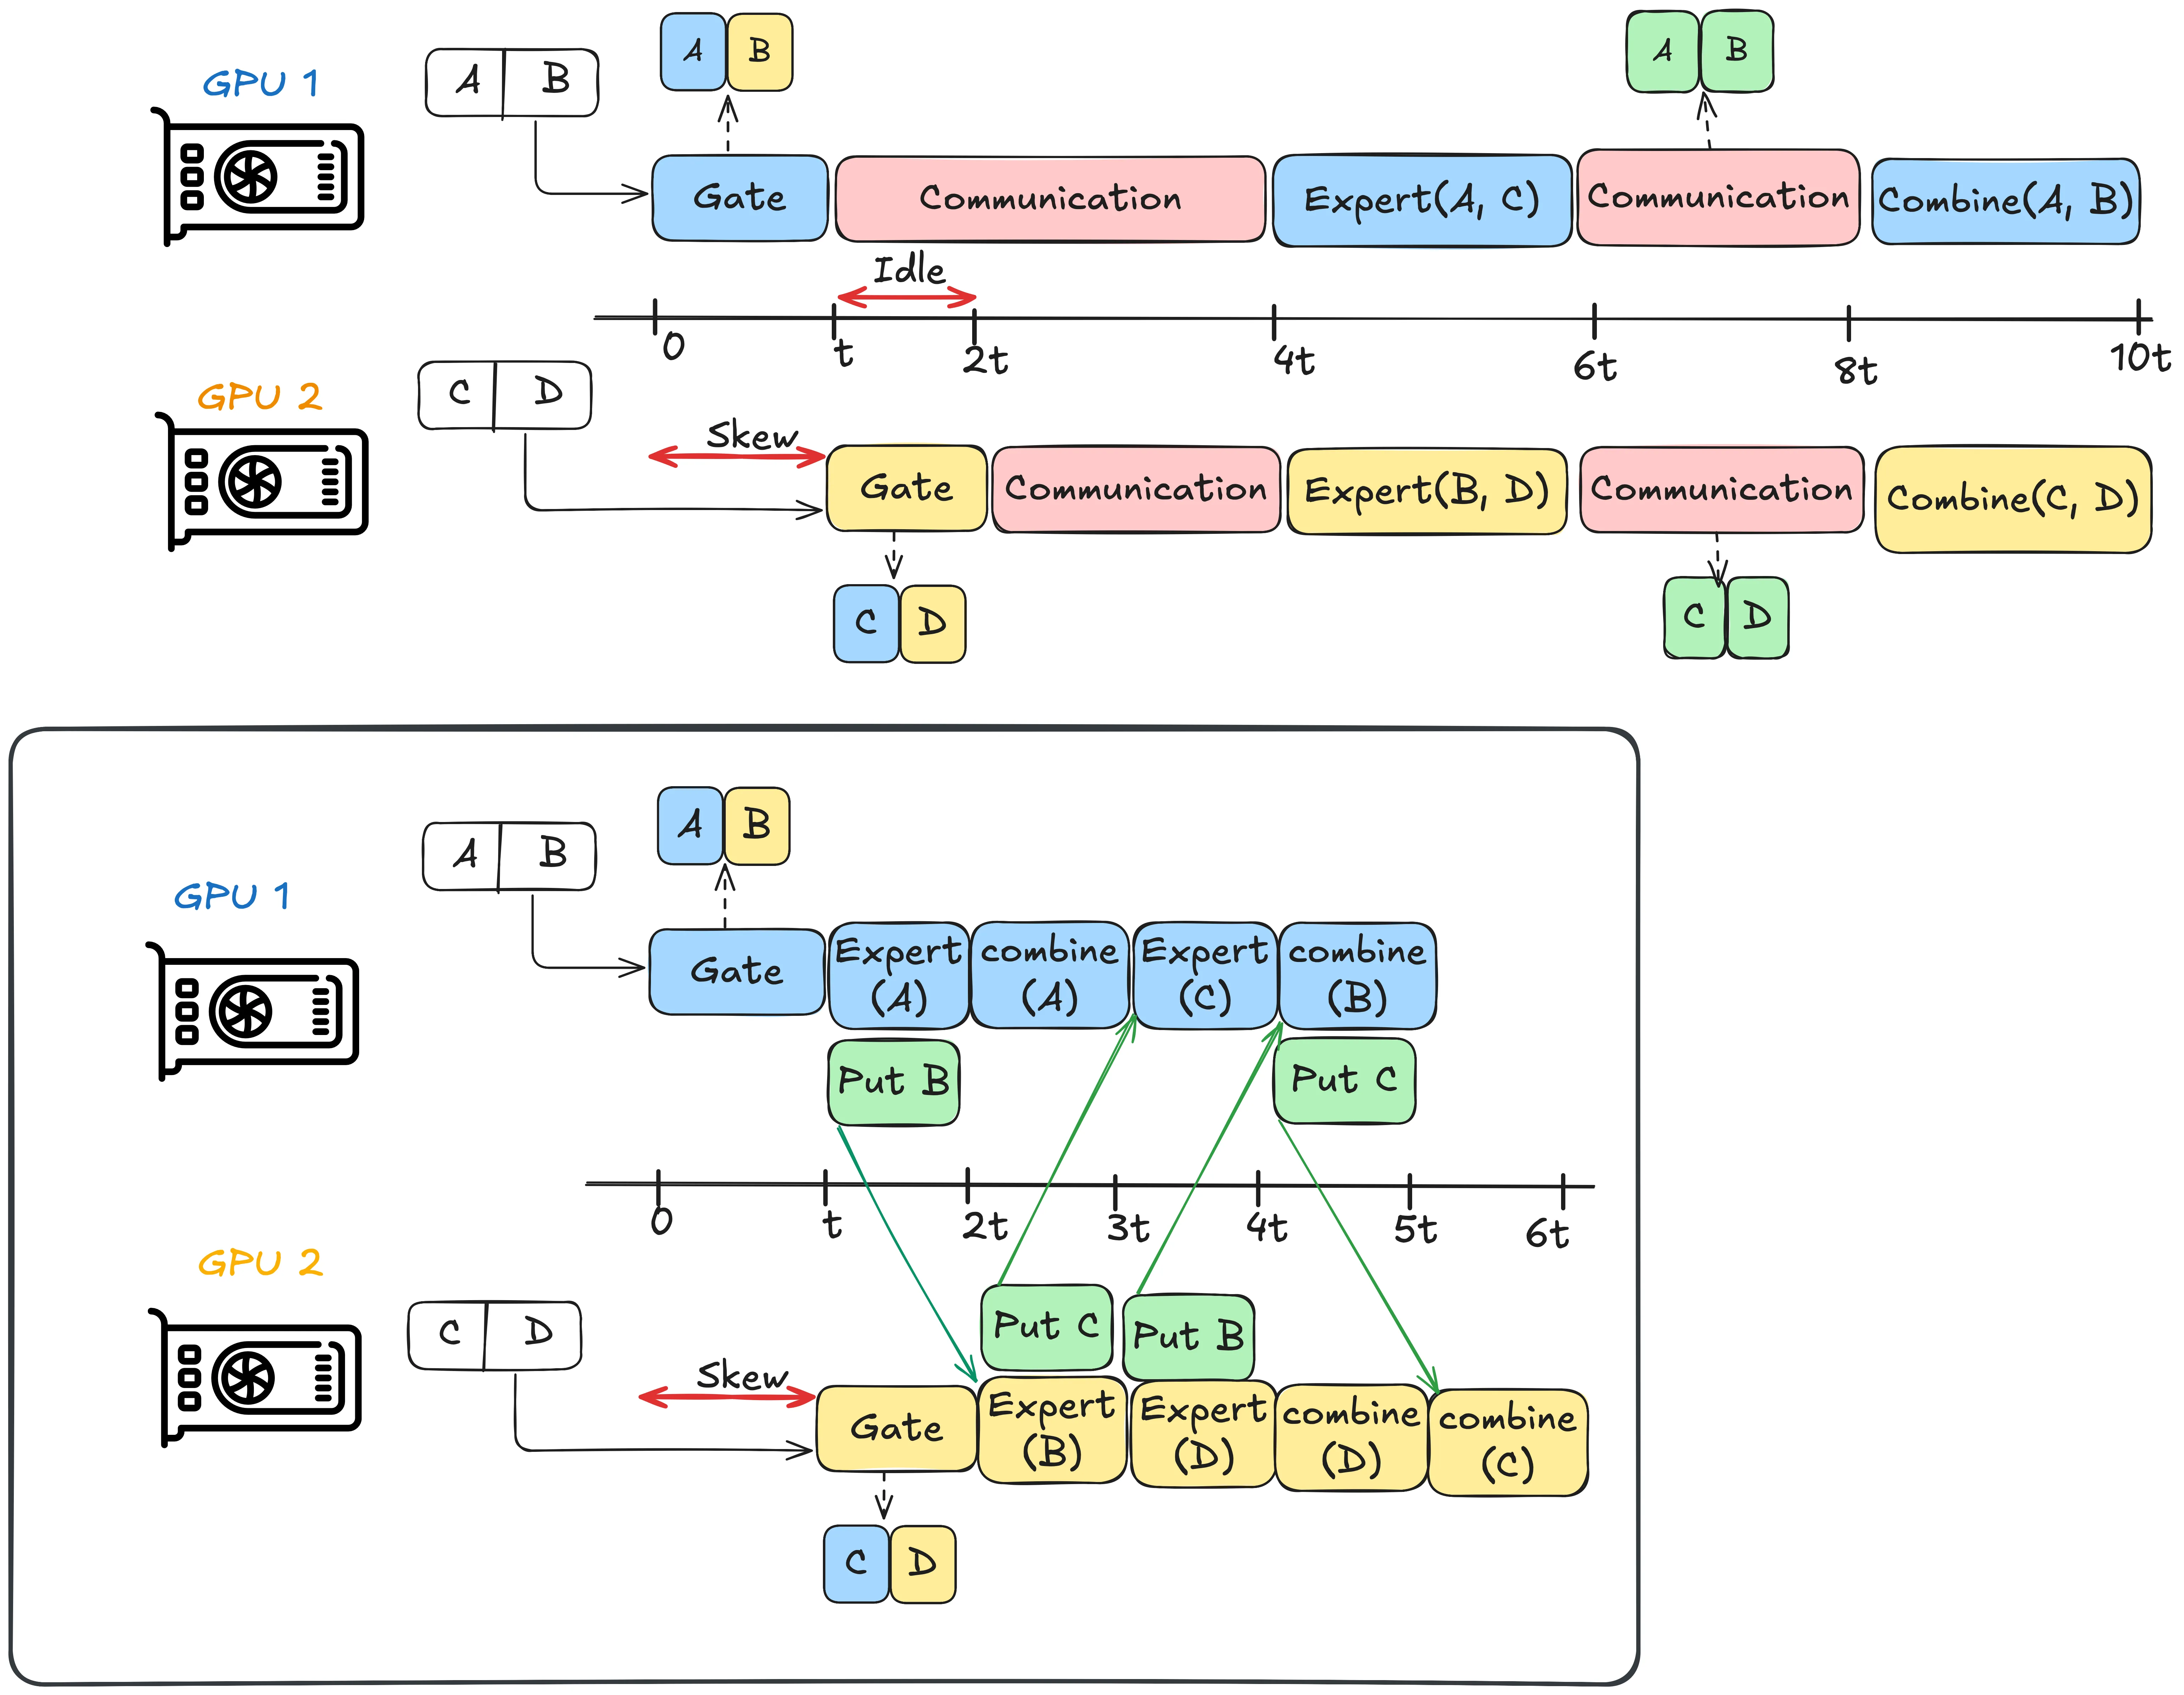
Figure 13: 重叠调度(底部)展示如何将顺序调度(顶部)的空闲时间用于计算。
关键结论
重要发现:FlashMoE使用FP32精度,而所有基线使用FP16。这意味着FlashMoE的通信量和计算工作量是基线的2倍,但仍能实现显著的性能优势,证明其设计消除了吞吐量瓶颈,而非依赖低精度。
七、相关工作
| 方法 | 特点 | FlashMoE优势 |
|---|---|---|
| Comet | cudaMemcpyPeerAsync通信 | 完全内核融合,消除启动开销 |
| FasterMoE | NCCL通信 | 设备发起通信,消除straggler |
| Megatron-CUTLASS | NCCL + CUTLASS | 单内核 vs 多内核 |
| Megatron-TE | Transformer Engine | Actor模型实现更高效重叠 |
| DeepEP | DeepSeek的EP优化 | 93.17% vs 13.55% SM利用率 |
八、总结
核心贡献
- 首个完全融合的分布式MoE内核:将整个DMoE算子(dispatch + compute + combine)融合为单一持久化GPU内核
- Actor并发计算模型:基于Actor模型的GPU线程块特化,实现计算与通信的细粒度重叠
- 设备发起通信:用NVSHMEM单边(R)DMA替代同步集合通信,消除straggler效应
- 显著性能提升:FP32下实现6×延迟降低、9× SM利用率提升、5.7×吞吐量提升
技术影响
FlashMoE展示了GPU内核-硬件协同设计是释放大规模分布式ML性能上限的关键。从CPU编排到完全自主的GPU原生流水线的转变,将对未来的MoE系统设计产生深远影响。
局限性
- 工程复杂度:完全融合的持久化内核需要深度GPU和分布式系统专业知识
- FP16效率:当前FP16路径因调优不足而表现不佳,计划使用cuBLASDx或CUTLASS builders解决
- 仅支持推理:当前工作仅针对推理,训练需要融合反向传播和梯度通信
未来方向
- 编译器/DSL抽象降低开发门槛
- 自动调优GEMM算子优化FP16性能
- 扩展到训练场景
- 支持FP8及更低精度类型
九、参考资源
- 论文: arXiv:2506.04667
- 代码: GitHub - FlashMoE
- CUTLASS: NVIDIA CUTLASS
- NVSHMEM: NVIDIA NVSHMEM
- cuBLASDx: NVIDIA cuBLASDx